


Python不适合做什么?厘清语言性能瓶颈与应用边界
深入剖析Python在底层运行机制上的三大性能瓶颈(动态类型、解释执行与GIL),系统厘清其在超高频低延迟交易、移动端、纯前端、纯CPU计算与受限嵌入式等五大领域的局限,并给出科学的工程选型与双层解耦架构决策方案。
一、底层机制透视:Python 的性能瓶颈究竟出在哪里?
许多开发者常将“Python 慢”归结为一句话,却很少深入分析这门语言在操作系统与 CPU 硬件层面上到底承受了哪些额外开销。在主流的 CPython 实现中,性能损耗主要源于三个相互交织的底层设计:
1. 动态类型与一切皆对象的内存膨胀
在 C 或 Rust 等静态编译型语言中,一个 32 位整型变量 int a = 42; 仅占用 4 个字节的栈内存,在数组中也是紧凑连续排列,能够完美适配现代 CPU 的一级/二级缓存行(Cache Line)。
然而在 Python 中,“一切皆对象”。即使是最基础的整数 42,底层也是一个完整的 PyLongObject(继承自 PyObject)。该结构体必须包含 8 字节的引用计数(ob_refcnt)、8 字节的类型对象指针(ob_type*),以及用于表示大整数长度和数字数组的额外元数据,最终单个整数至少占用 28 个字节。
更严重的是,这些对象通常离散分配在堆内存中。当执行一个包含大量对象的计算循环时,CPU 每次都需要进行指针间接寻址,无法命中缓存,产生大量的内存总线等待(Memory Stall),硬件层面的吞吐量断崖式下跌。
2. 字节码解释执行与调度循环
Python 代码在执行前会被编译为 .pyc 字节码,但它并不直接生成目标平台的机器码。CPython 依赖虚拟机核心函数 _PyEval_EvalFrameDefault(在 ceval.c 中)维护一个庞大的 switch-case 循环。
每执行一条简单的加法指令 BINARY_OP,虚拟机都要经历:获取指令、提取操作数、动态检查操作数类型、查找对应魔术方法(如 __add__)、分配新对象承载结果,最后递增指令指针。一条在 C 中只需 1 个 CPU 时钟周期的汇编指令,在 Python 解释器内往往需要耗费数十乃至上百条机器指令,且彻底破坏了 CPU 流水线的乱序执行与分支预测。
3. 全局解释器锁(GIL)与多核算力墙
CPython 依靠简单的引用计数机制管理内存回收。为了防止多线程并发操作引用计数导致数据竞争与内存破坏,解释器引入了全局解释器锁(Global Interpreter Lock,GIL)。
GIL 强制要求任何时刻只允许一个操作系统原生线程持有解释器并执行 Python 字节码。对于纯 CPU 密集型任务,盲目开启 threading 多线程不仅无法利用现代多核 CPU 的并行算力,反而会因为频繁的操作系统上下文切换与线程争锁产生负优化。尽管 Python 3.13 开启了无 GIL 自由线程(PEP 703)的实验性构建,但在生态库兼容、单线程性能回退及生产级验证方面仍需要相当长的演进周期。

二、明确不适用的五大工业场景与替代选型
厘清了底层运行机制后,我们就能脱离主观偏好,基于严谨的物理和生态约束,明确划分出 Python 绝不适合单独担当重任的五大场景。
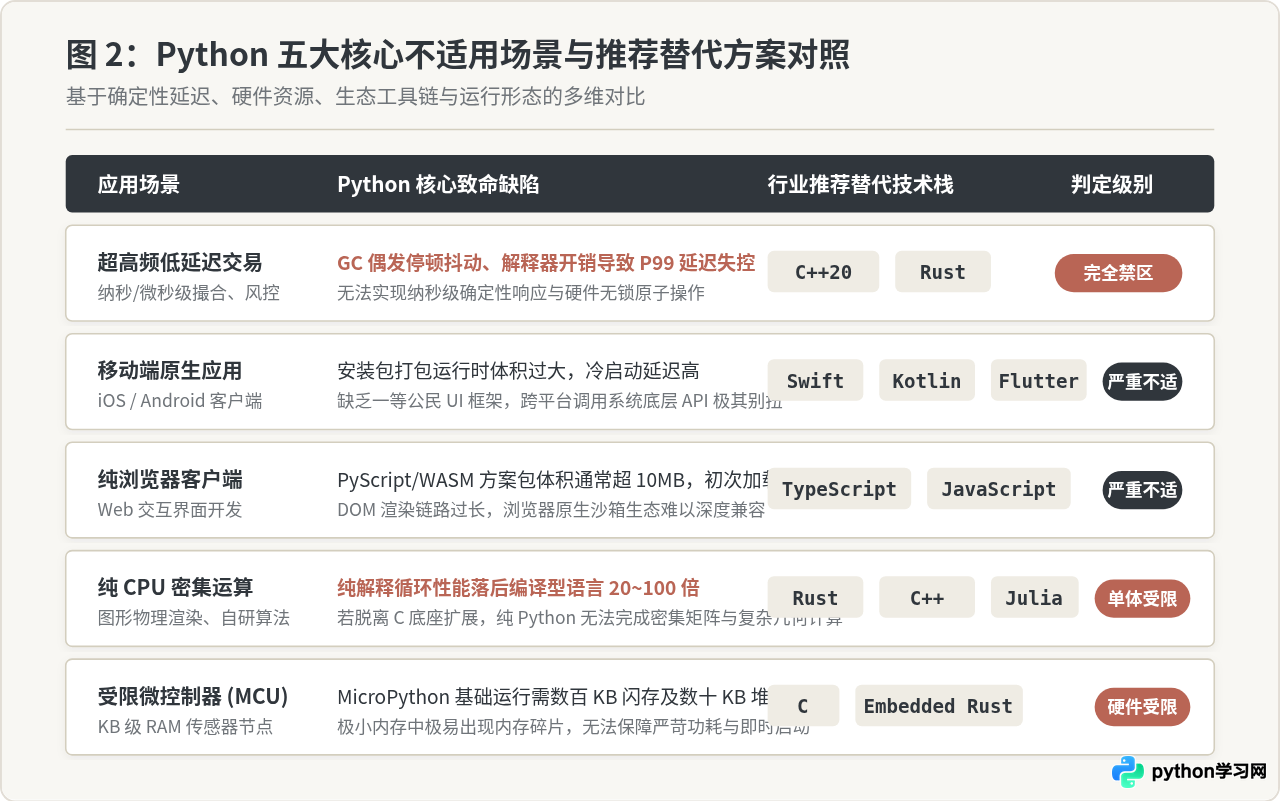
1. 纳秒/微秒级超高频交易与硬实时系统
在量化高频交易(HFT)、工业数控机床、航空航天航电设备等硬实时(Hard Real-Time)场景中,核心诉求不仅是“平均速度快”,更是P99 / P99.9 延迟的极致确定性。任何超过数微秒的抖动都意味着灾难性的穿仓或设备故障。
Python 在此场景下是绝对禁区:CPython 的分代垃圾回收器会在不可控的时间点触发遍历与清理;解释器的执行时间受宿主机缓存和动态调度影响极大;语言本身无法进行精准的无锁队列原子操作与硬件中断绑定。
- 替代选型:
C++20/Rust。通过手动内存管理、无锁数据结构、SIMD 专用指令以及内核旁路(Kernel Bypass,如 DPDK),将端到端延迟压低在纳秒级别。
2. 移动端原生应用开发(iOS & Android)
尽管社区存在 Kivy、BeeWare 等尝试将 Python 带入移动端的框架,但在商业化交付中几乎没有成功案例。
主要原因在于:移动操作系统对应用程序的包体积、冷启动耗时和功耗控制有着极其严苛的规范。将一个完整的 CPython 解释器连同依赖库打包,基础安装包便会膨胀数十兆;应用冷启动需要先在内存中初始化解释器并导入核心模块,首屏渲染往往需要数秒;此外,Python 无法直接映射两端原生的 Material Design 与 UIKit 声明式组件树,跨语言桥接开销极大。
- 替代选型:
Swift(iOS 独占最佳实践)、Kotlin(Android 官方推荐)或Flutter (Dart)/React Native(跨平台商业首选)。
3. 纯浏览器端交互式 Web 客户端
随着 WebAssembly 的普及,出现了 Pyodide、PyScript 等将 CPython 编译至 WASM 在浏览器内运行的项目。但在普通 Web 前端开发中,用它们编写业务交互依然是不明智的。
目前最精简的 Pyodide WASM 运行时二进制文件也在 10MB 以上。在典型的网页访问中,下载、解压并初始化该运行时会导致长达数秒的“白屏”等待;其次,Python 代码操作 DOM 必须通过 JavaScript 胶水层代理,事件循环与浏览器原生渲染引擎之间存在显著的额外损耗。
- 替代选型:
TypeScript/JavaScript是浏览器宿主无可替代的一等公民;对于追求超高计算性能的前端图像处理或 3D 引擎,推荐采用Rust (编译为轻量 WASM)。
4. 纯算法密集的单进程 CPU 运算(脱离 C 底座时)
许多新手存在一种误解:“Python 在科学计算和人工智能领域天下无敌,因此 Python 算力极强”。事实恰恰相反:强的是用 C、C++、Fortran 和 CUDA 写成的底座,Python 自身纯代码的计算能力极其孱弱。
如果一个复杂的图形学光线追踪算法、自研物理碰撞检测或私有加密解密逻辑完全使用纯 Python 的 for 循环与基本数据类型编写,其执行耗时通常会比优化后的 C/Rust 代码慢 20 到 100 倍。单进程下纯 Python 算法不仅无法跑满多核,还会将算力白白浪费在解释器的动态分发上。
- 替代选型:
C++/Rust/Julia。若必须在 Python 项目中调用,必须通过原生扩展承接核心运算。
5. 极端受限的超低功耗嵌入式微控制器(MCU)
在具备数兆字节 RAM 的树莓派单板计算机上,Python 游刃有余;但在工业传感器、低功耗蓝牙 Beacon 等基于 ARM Cortex-M0/M3、RAM 仅有 16KB ~ 64KB 的微控制器上,MicroPython 显得极为吃力。
MicroPython 固件本身需占用上百 KB 的 Flash 存储,堆内存开辟后,哪怕简单的几个变量引用,也极易在有限的十几 KB 堆中产生内存碎片,最终引发 MemoryError。同时,解释执行的高功耗也违背了纽扣电池续航数年的物联网严苛指标。
- 替代选型:
C(裸机/FreeRTOS 黄金标准)或Embedded Rust(零成本抽象与强内存安全保障)。
三、工程选型实战:何时弃用,何时加速?
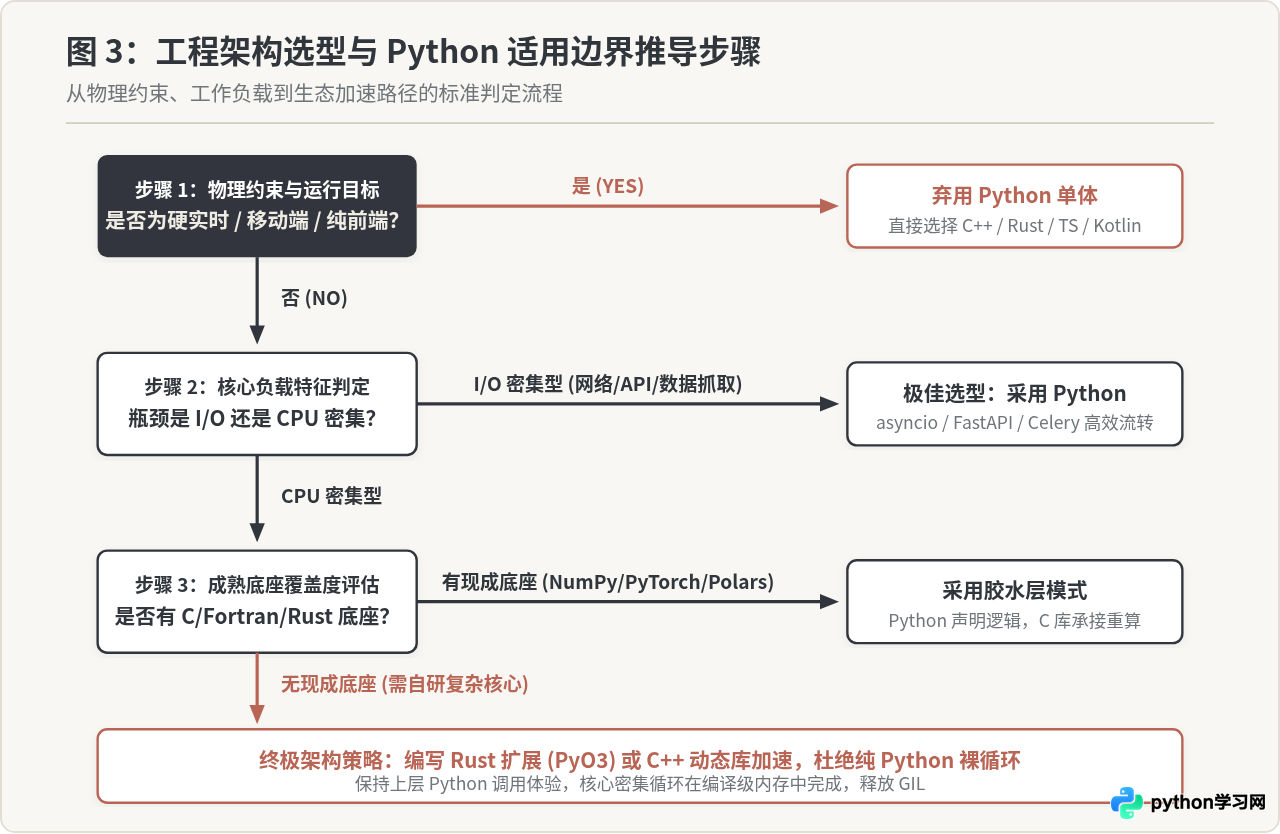
面对实际工程项目,技术选型不应是非黑即白的站队,而应基于清晰的推导步骤进行定性与定量分析。
实战对比:纯 Python 裸循环 vs C 底座向量化加速
为了具体展现 Python 自身与编译扩展的性能代差,我们来看一个计算两千万个随机浮点数欧式距离累加的对比示例。
测试环境说明:Python 3.12, 64-bit Linux / macOS,标准 x86_64 / ARM 架构。
# benchmark.py
import time
import random
import numpy as np

N = 20_000_000

# 方案 A:纯 Python 裸循环(典型反模式)
data_x = [random.random() for _ in range(N)]
data_y = [random.random() for _ in range(N)]

start = time.perf_counter()
total_dist = 0.0
for i in range(N):
    # 每次循环都伴随着 PyObject 拆箱、属性查找与新浮点对象分配
    total_dist += (data_x[i] - data_y[i]) ** 2
cost_py = time.perf_counter() - start
print(f"纯 Python 耗时: {cost_py:.3f} 秒")

# 方案 B:NumPy 向量化(C 底座 SIMD 连续内存加速)
np_x = np.array(data_x)
np_y = np.array(data_y)

start = time.perf_counter()
diff = np_x - np_y
total_dist_np = np.dot(diff, diff)
cost_np = time.perf_counter() - start
print(f"NumPy (C底座) 耗时: {cost_np:.3f} 秒")
• 方案 A(纯 Python 裸循环):通常耗时约 2.8 ~ 3.5 秒,且内存开销极度膨胀(两个千万级浮点数列表占用超 350MB 内存)。
• 方案 B(NumPy C 底座):利用底层连续数组与 CPU AVX2/NEON 向量化单指令多数据流,耗时仅需 0.03 ~ 0.05 秒。
• 结论:两者的性能相差近 70 倍。如果在项目中遇到了性能瓶颈,首先要反思的是是否在纯 Python 层运行了繁重的内部循环。
四、现代工业破局点:Python 的真正生态位与双层架构
既然 Python 存在上述性能瓶颈,为何它依然是当今全球最具生产力的语言之一?答案就在于软件工程中至关重要的“双层架构”(Two-Language Problem 解耦)。
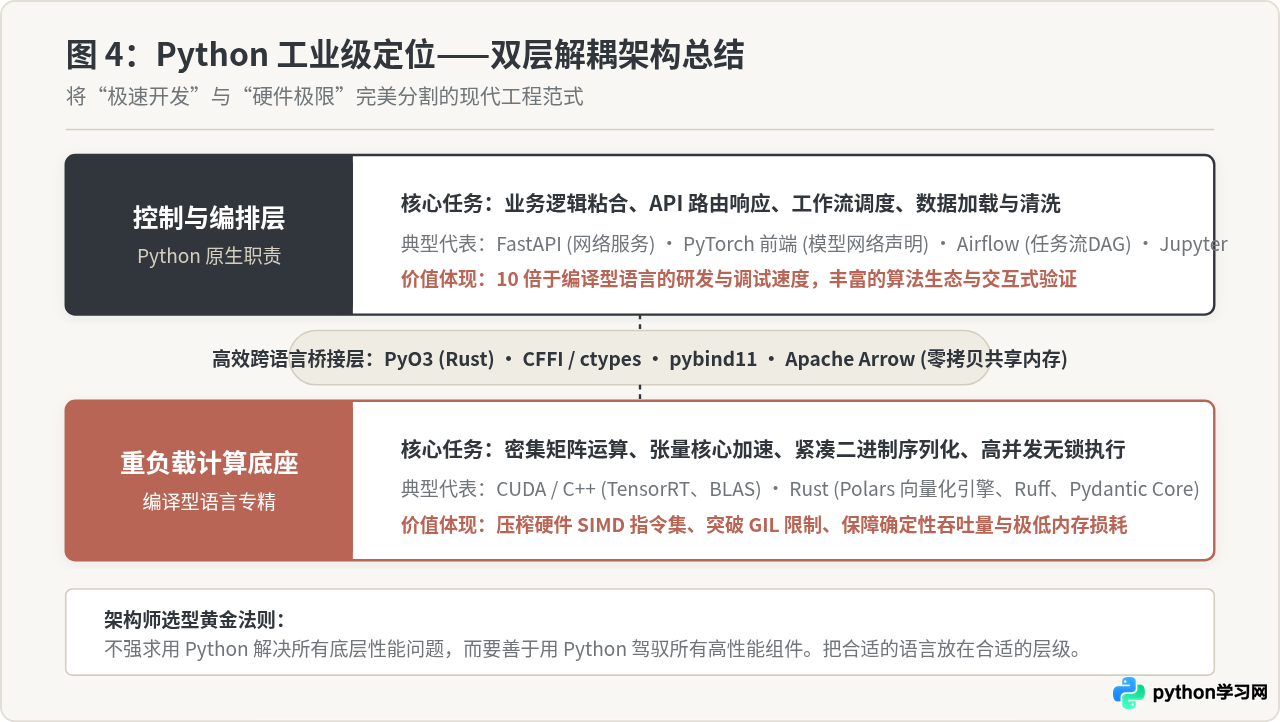
1. Python 负责“控制平面”(Control Plane)
在现代大型系统中,商业逻辑易变、工作流程复杂、需求迭代频繁。如果连业务组装、参数校验、REST/GraphQL 接口暴露、DAG 任务编排都用 C++ 编写,团队的研发成本与心智负担将高得不可承受。
Python 在控制层扮演了无可替代的超级粘合剂:
- 极快的编写与重构反馈速度,REPL 交互式验证让原型开发时间缩短数倍;
- 出色的网络 I/O 并发表现(基于
asyncio、uvloop 与协程,轻松应对万级连接); - 无缝打通跨语言系统,以极其优雅的声明式语法对外输出 SDK。
2. 编译型语言负责“数据与计算平面”(Data Plane)
一旦进入密集的数值运算、加密传输、二进制编解码或多核高并发区域,立刻通过成熟的 FFI(外部函数接口)跨越到编译层执行,并在计算期间主动释放 GIL,让出物理多核。
当前工业界最成功的技术范式全部印证了这一双层模式:
- PyTorch / TensorFlow:开发者编写的是清爽的 Python 代码,底层执行图与反向传播完全由 C++、CUDA 算子和 TensorRT 驱动;
- Polars:新一代超高速数据分析库,上层是 Pythonic API,底层是用 Rust 编写的 Apache Arrow 零拷贝并行内存执行引擎;
- Pydantic V2 / Ruff:Python 生态中最核心的数据校验与代码检查工具,先后完全用 Rust 重写了内核(基于
PyO3绑定),带来了高达 15~50 倍的飞跃性提速。
不要试图在“纯 Python”中死磕微秒级性能或单核循环优化,这是用语言的劣势硬抗物理客观规律;也不要因为性能执念而一开始就全盘拥抱底层复杂语言,导致研发效率低下。
成熟架构师的智慧,在于始终把 Python 放在它最擅长的高层控制与组织平面,用严谨的接口隔离底层密集算力,让工具在各自的生态边界内发挥极致价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















