


在线运行Python代码超时或报错的常见原因及解决办法
针对在线Python执行环境中经常出现的代码超时与运行报错,深入剖析沙箱资源限制、无限循环、交互式输入阻塞、内存溢出及环境依赖缺失等核心原因,并给出具体的排查步骤和修复方案。
一、在线运行环境的核心机制与限制规则
很多初学者常有一个疑问:“为什么这段代码在本地PyCharm或终端里能正常执行,放到在线网页里就直接报超时或被系统杀死?”答案在于运行宿主与安全沙箱机制的差异。
本地运行Python时,解释器拥有您个人计算机的全部空闲CPU算力和内存,没有严格的执行秒数限制,也可以随时打开标准输入等待键盘键入。而在线运行平台(例如各种在线Run Python工具、刷题判题网站、交互式学习系统)本质上是服务提供方在云端服务器中为你启动的一个微型容器或隔离沙箱(如Docker容器、WASM或微虚拟机)。
为了防止个别死循环代码耗尽服务器CPU、防止恶意网络攻击,在线平台通常配置了极其严格的防护策略:
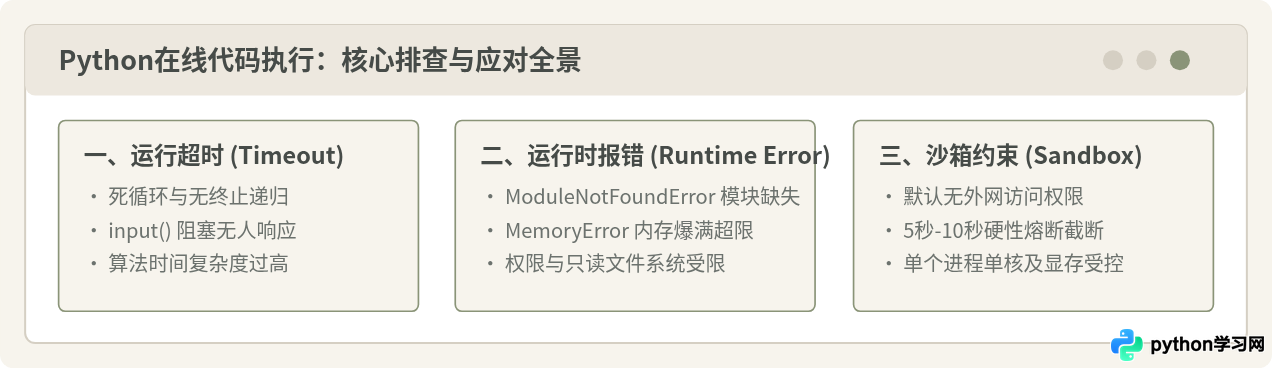
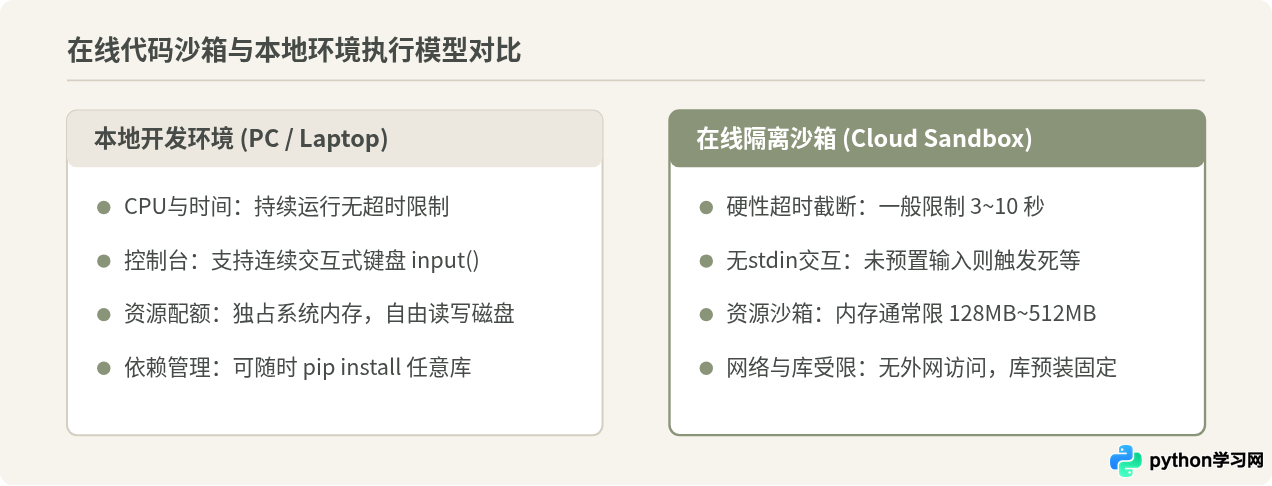
- 硬性执行超时(Wall-Clock Timeout):绝大多数在线轻量平台仅允许单次代码运行3秒至10秒。即使代码只是在处理稍大体量的数据,超过这个时限就会被宿主进程强制发送
SIGKILL信号终止。 - 标准输入流(stdin)被切断或非交互式:传统控制台会等待用户输入,但很多在线平台采用“非交互式”批处理模式。当遇到
input()时,由于没有键盘输入来源,程序会永久陷入挂起状态,直至平台触发超时强杀。 - 受限的内存与磁盘:容器通常只分配128MB至512MB的临时内存,且文件系统大多为只读或临时挂载目录,尝试写入大文件或加载大数组时会直接崩溃。
- 网络隔离:绝大多数公用沙箱完全禁止出站网络连接,无法使用
requests请求外部网页或下载数据。
二、代码运行超时(Time Limit Exceeded)的原因与解决
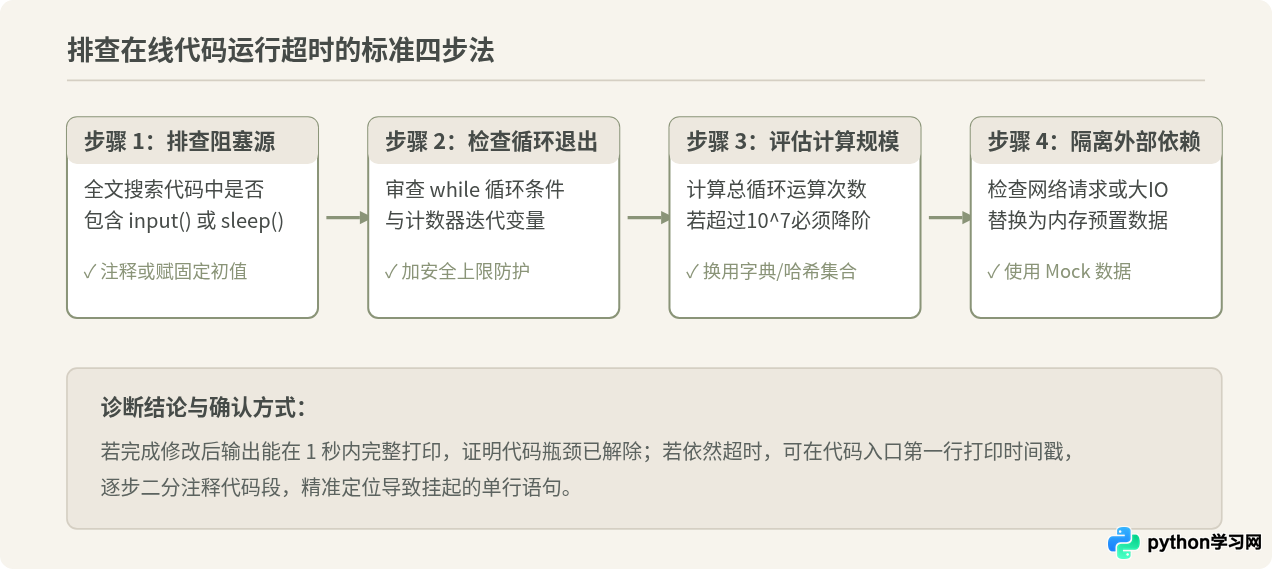
当平台提示 Time Limit Exceeded、TimeoutError 或 Execution timed out after 5000ms 时,通常由以下四种情况引发:
1. 死循环或未推进的状态变量
在编写 while 循环时,循环退出条件永远无法满足,或者在循环体内漏掉了步进语句(如 i += 1),导致程序以100%的CPU占用率反复空转,直到被平台超时拦截。
常见错误示例(死循环)
i = 0
total = 0
while i < 10:
    total += i
    # 忘记递增 i,条件永远为真
print(total)
正确修复示例
i = 0
total = 0
while i < 10:
    total += i
    i += 1  # 确保状态发生推进
print(total)if loop_count > 1000: break)或打印关键变量,检查是否在某一固定状态停止推进。
2. 等待控制台交互输入(input 挂起)
很多教学初学者直接复制课本代码到网页中测试:
name = input("请输入你的名字:")
print("你好," + name)原因分析:很多在线平台不是真正的伪终端(TTY)。代码运行在后端无头进程中,当执行到 input() 时,程序停滞等待标准输入输入字符。由于网页端并没有提供实时流式输入通道,程序无限等待,直到5秒或10秒后系统报错超时。
解决办法:
- 检查在线页面下方或右侧是否有专门的“自定义输入 / STDIN / Input”输入框。如果有,先在输入框中把要提供的内容输入好,再点击“运行”。
- 若平台纯粹用于执行代码展示,直接在代码中给变量赋字面值替代
input(),例如直接写name = "张三"。
3. 算法时间复杂度过高与海量测试数据
在算法刷题类平台(如LeetCode、牛客、各类竞赛判题系统)中,即使代码逻辑完全正确,计算规模超过沙箱承载能力也会判定超时。
例如,数据规模达到 $N = 10^5$ 时,若使用两层嵌套循环($O(N^2)$),总运算次数为 $10^{10}$ 次。Python解释器单核每秒大约能执行 $10^7 \sim 3 \times 10^7$ 次基础指令,执行完需要数百秒,必然超时。
暴力查找 $O(N^2)$(易超时)
def find_duplicates(nums):
    res = []
    for i in range(len(nums)):
        for j in range(i + 1, len(nums)):
            if nums[i] == nums[j] and nums[i] not in res:
                res.append(nums[i])
    return res
哈希集合优化 $O(N)$(快速通过)
def find_duplicates(nums):
    seen = set()
    duplicates = set()
    for x in nums:
        if x in seen:
            duplicates.add(x)
        else:
            seen.add(x)
    return list(duplicates)
4. 发起外部网络请求被沙箱挂起
在线代码中编写类似 requests.get("https://api.example.com") 或 urllib.request.urlopen(...) 的逻辑。由于公有沙箱阻断了外部网络连接,系统底层的 socket 在发起 TCP 握手时长时间等待响应(默认超时时间往往长达数十秒甚至几分钟),进而导致整个脚本被平台的运行时间限制强制截断。
解决办法:在线测试网络爬虫或API调用时,建议转为本地安装Python环境运行;若仅测试数据处理逻辑,请使用写死的本地 Mock 字典或 JSON 字符串替代实时网络请求。
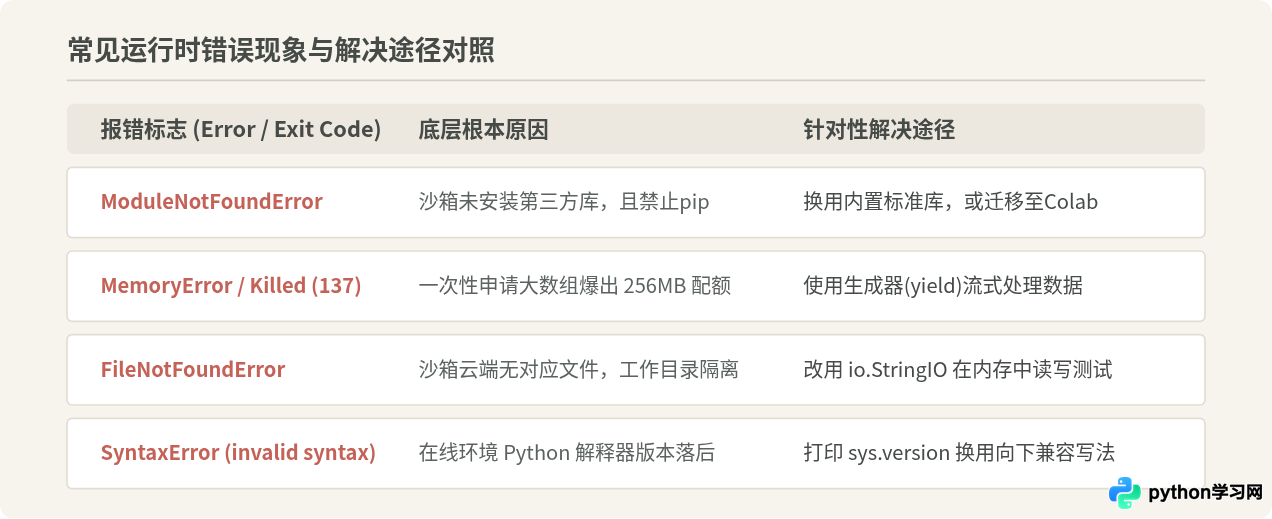
三、常见运行时报错(Runtime Error)及修复
除了超时之外,在线运行还会频繁遇到几类极具代表性的报错信息:
1. ModuleNotFoundError: No module named 'xxx'
报错表现:代码中使用了 import requests、import pandas as pd 或 import cv2,系统直接抛出找不到模块错误并停止。
File "main.py", line 1, in <module>
import requests
ModuleNotFoundError: No module named 'requests'
原因与解决:在线运行平台的镜像中通常只安装了 Python 标准库(如 math、random、sys、collections、itertools),普通网页不支持直接执行 pip install。
对策:
- 优先改用标准库实现。例如:如果需要解析JSON,使用内置的
import json;如果做简单的HTTP请求测试且平台允许外网,尝试内置库urllib.request;如果是简单数值计算,直接用标准库math代替numpy。 - 若必须使用大型第三方库(如 Pandas、PyTorch、OpenCV),应改用支持包管理或专为数据科学设计的在线平台(例如 Google Colab、Kaggle Notebook 或 JupyterHub 环境),而不是简单的单文件在线编辑器。
2. MemoryError 或进程被杀死(Out of Memory / OOM Killed)
报错表现:控制台打印 MemoryError,或者完全没有任何Python调用栈,直接显示 Killed、Exit code 137。
原因分析:沙箱环境分配的内存极为紧张。如果代码一次性生成超大规模列表(例如 [i for i in range(10**8)]),瞬间吃满256MB上限,Linux内核的 OOM Killer 会直接向进程发送信号强行终止。
高内存占用(极易OOM)
# 产生千万级元素的实体列表
data = [x * 2 for x in range(10_000_000)]
total = sum(data)
print(total)
生成器流式迭代(内存占用接近0)
# 使用生成器表达式,边算边消耗
total = sum(x * 2 for x in range(10_000_000))
print(total)
3. FileNotFoundError 与 PermissionError
报错表现:尝试执行 open("data.txt", "w") 或 open("image.png", "rb") 时报错。
原因分析:在本地机器上,我们习惯把数据文件和代码放在同一个目录;但在线沙箱往往是一个临时的只读容器,当前工作目录通常不存在外部文件,或者当前沙箱运行用户没有对宿主路径的写权限。
解决办法:在处理文件操作教学时,建议使用标准库 io.StringIO 或 io.BytesIO 在内存中模拟文件的读写,无需依赖真实磁盘文件:
import io

# 在内存中模拟文本文件
virtual_file = io.StringIO()
virtual_file.write("Python 在线数据测试\n第二行内容")

# 重置读取指针并读出内容
virtual_file.seek(0)
for line in virtual_file:
print("读取行:", line.strip())读取行: 第二行内容
4. 语法错误(SyntaxError)与 Python 版本差异
报错表现:使用了海象运算符(:=)或匹配模式(match ... case),或者格式化字符串(f-string)时报错 SyntaxError: invalid syntax。
原因分析:部分老旧在线平台可能依然运行在 Python 3.6 甚至更早版本中。例如 match case 需要 Python 3.10+,海象运算符需要 Python 3.8+。
解决办法:在代码开头加入 import sys; print(sys.version) 查看当前在线平台的具体 Python 版本,避免使用过高版本的语法糖。
四、容易混淆的常见说法与认识误区
说法一:“在我的本地电脑上运行只要0.5秒,在线平台肯定是卡顿或服务器太差”
辨析:这种判断看似合理,因为本地运行确实通过了。但在很多在线判题或测试平台中,后台采用的是多组大体量测试用例并发输入。读者在本地测试时往往只输入了长度为3到5的简单数组,耗时自然在微秒级;而在线系统评测时,输入的测试数组长度可能达到数十万。如果代码的时间复杂度是 $O(N^2)$,在本地测试集上看不出问题,但在评测用例下必然超时。因此,这通常不是服务器性能问题,而是算法复杂度未能匹配评测集规模。
说法二:“只要给全段代码加上 try...except Exception 就能解决所有报错”
辨析:try...except 只能捕获 Python 解释器层面的标准异常(如 ValueError、KeyError、ZeroDivisionError 等)。对于操作系统内核级别发出的信号(例如超出沙箱时间的 SIGKILL / SIGXCPU,超出沙箱物理内存被系统杀死的 SIGKILL (137)),以及控制台无输入导致的永久等待,try...except 是无法拦截的。解决这类问题的关键在于改善资源使用效率和解除输入挂起,而非依赖异常捕获。
说法三:“在线运行工具既然能连外网访问网页,就一定能运行爬虫”
辨析:读者在浏览器中访问在线编辑器的网页,是“用户的浏览器连接在线服务端的 Web 服务器”;而代码运行是在“服务端内部的无特权 Docker 容器”中。出于防黑客将服务器作为肉鸡发起攻击的安全考虑,绝大多数在线平台的容器网络路由均被设为 --net none(完全断网),因此代码内发起外网网络请求必然失败。
五、在线运行前后的排查与预防清单
为了提高在线提交和调试代码的成功率,建议在每次点击“运行”或“提交”前,依照以下检查清单快速扫视一遍代码:
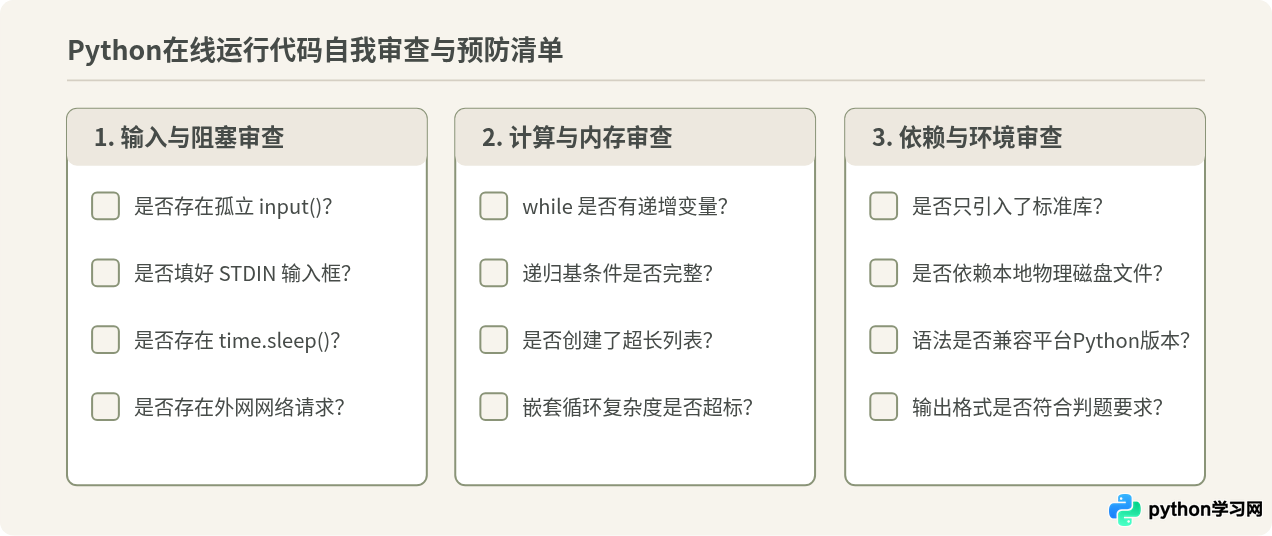
理解了在线云端沙箱的约束之后,遇到报错便无需盲目尝试。先看报错类型:若是 Timeout,优先检查 input() 与循环终止条件;若是 ModuleNotFound,确认平台支持的库范围;若是 Killed / MemoryError,优化算法降低内存占用。按部就班排查,绝大多数在线执行异常都能在几分钟内迅速定位并化解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















