


Python字符串处理作业答案:常用方法与应用实例
针对Python字符串处理编程作业的常见题型,系统梳理清洗、切片、检索与重组等高频方法,提供标准解题代码、流程图解与易错避坑说明。
一、文本清洗与格式标准化作业题
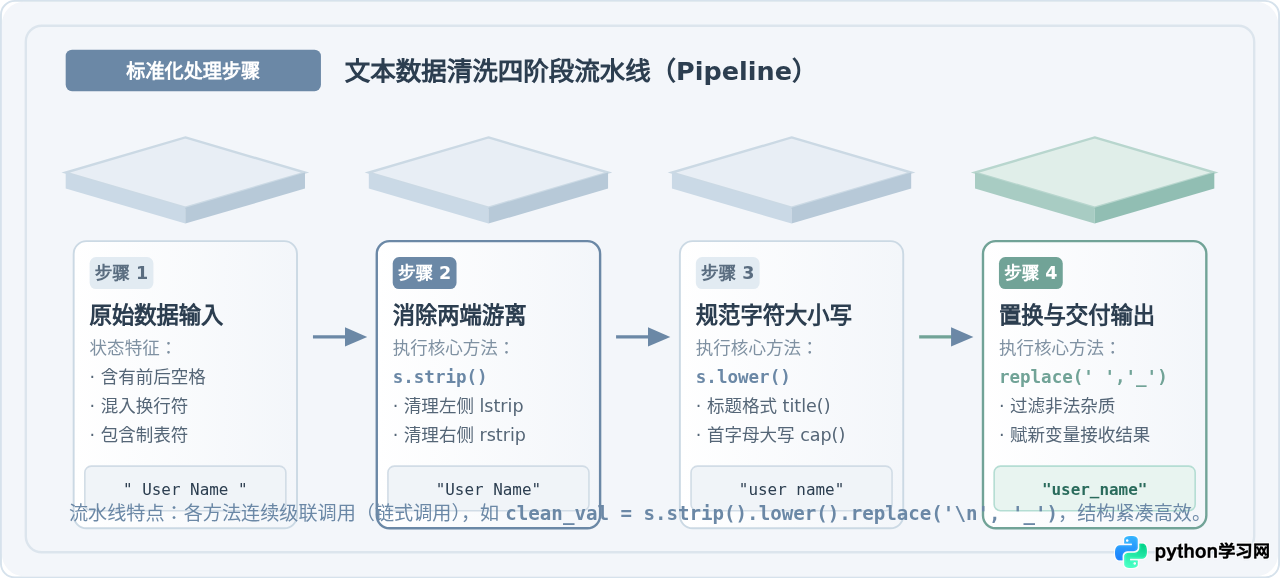
在编程作业与实验中,最常见的第一道题往往是处理“脏文本”:用户键盘输入或文本读取的内容常夹杂首尾多余空格、换行符制表符,以及不规则的大小写。解决此类问题的标准解题路径是执行“去除空白 → 统一大小写 → 过滤特殊字符”的标准化流水线。
1. 核心方法与作用
str.strip([chars]):去除字符串两端包含的空白字符(包括空格、str.lstrip()与str.rstrip():分别仅清除左端或仅清除右端的游离字符。str.lower()与str.upper():将字符全量转换为小写或大写形式。若需处理英文专有名词,可选用str.title()(词首大写)或str.capitalize()(整句首字符大写)。str.replace(old, new[, count]):将文本中的旧子串置换为新子串,可限制置换次数。
2. 典型作业题与标准解答
作业题目:编写一个名为 clean_user_input(text) 的函数,接收一段原始注册字符串,去除两端空白,将其中的换行符
替换为单空格,所有英文字符转为标准小写,并返回处理结果。
def clean_user_input(text: str) -> str:
    # 步骤 1 & 2: 去除两端游离空格与换行
    stripped_text = text.strip()
    # 步骤 3: 转换全量英文字母为小写
    lowered_text = stripped_text.lower()
    # 步骤 4: 将内部换行符置换为规范空格
    normalized_text = lowered_text.replace("\n", " ")
    return normalized_text

# 测试用例验证
raw_input_data = "  \tAlice_Smith\nAdmin_Role  \n"
result = clean_user_input(raw_input_data)
print("清洗前:", repr(raw_input_data))
print("清洗后:", repr(result))text.strip() 却不把返回值赋给变量,导致后续输出依然是原字符串。由于 Python 字符串不可变,必须显式赋值 text = text.strip()。另外,strip() 仅处理首尾边界,绝不会移除单词中间的空格。
二、正反向切片与关键字段提取作业题
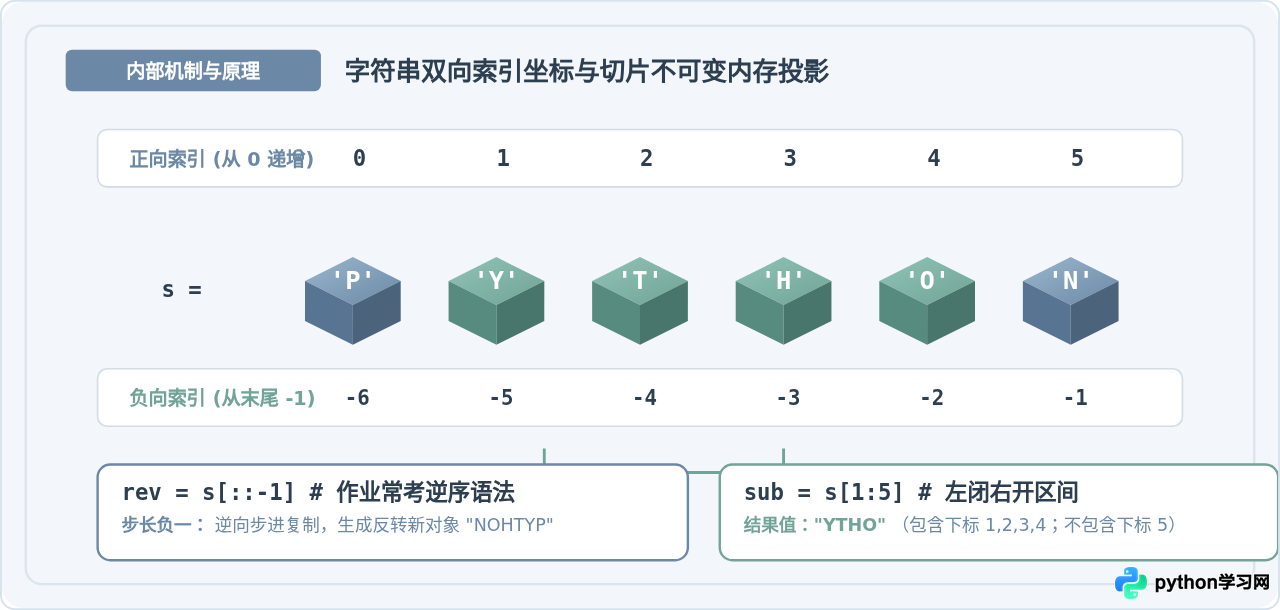
切片是 Python 提取子字符串最灵活的原生机制。Python 支持正向与负向双向索引,正向从 0 开始自左向右递增,负向从 -1 开始自右向左递减。
1. 切片语法格式解析
标准切片语法为 string[start:stop:step],其中:
start:提取起始位置的下标(包含在结果中,即左闭)。默认从头开始。stop:提取终止位置的下标(不包含在结果中,即右开)。默认截取到末尾。step:步长与提取方向。省略时默认为1;当为负数(如-1)时,表示反向提取。
2. 典型作业题与标准解答
作业题目一(字符串反转与回文判断):编写函数 is_palindrome(s),忽略大小写及空格,判断输入文本是否为回文字符串(正读反读均一致)。
def is_palindrome(s: str) -> bool:
    # 预处理:转小写并过滤掉所有空格
    processed = s.lower().replace(" ", "")
    # 利用负步长切片 [::-1] 逆序反转
    reversed_str = processed[::-1]
    return processed == reversed_str

print("Level 是否为回文:", is_palindrome("Level"))
print("'race car' 是否为回文:", is_palindrome("race car"))
print("'python' 是否为回文:", is_palindrome("python"))作业题目二(固定编码字段截取):给定员工档案编码格式为 "DEP-2023-CS-089"(格式:部门代码-入职年份-学科-序号),提取其中的入职年份与序号。
record = "DEP-2023-CS-089"

# 方案 A:已知固定长度切片
year = record[4:8]     # 下标 4 到 7 为年份
seq = record[-3:]      # 倒数第 3 位到末尾为序号

print(f"入职年份: {year}, 档案序号: {seq}")s[100])会直接引发 IndexError;而切片表达式 s[0:100] 即使越界也不会报错,Python 会安全地截取到现有有效字符末尾。在无法预知字符串长度时,切片提取更加安全健壮。
三、子串检索、词频统计与前后缀校验作业题
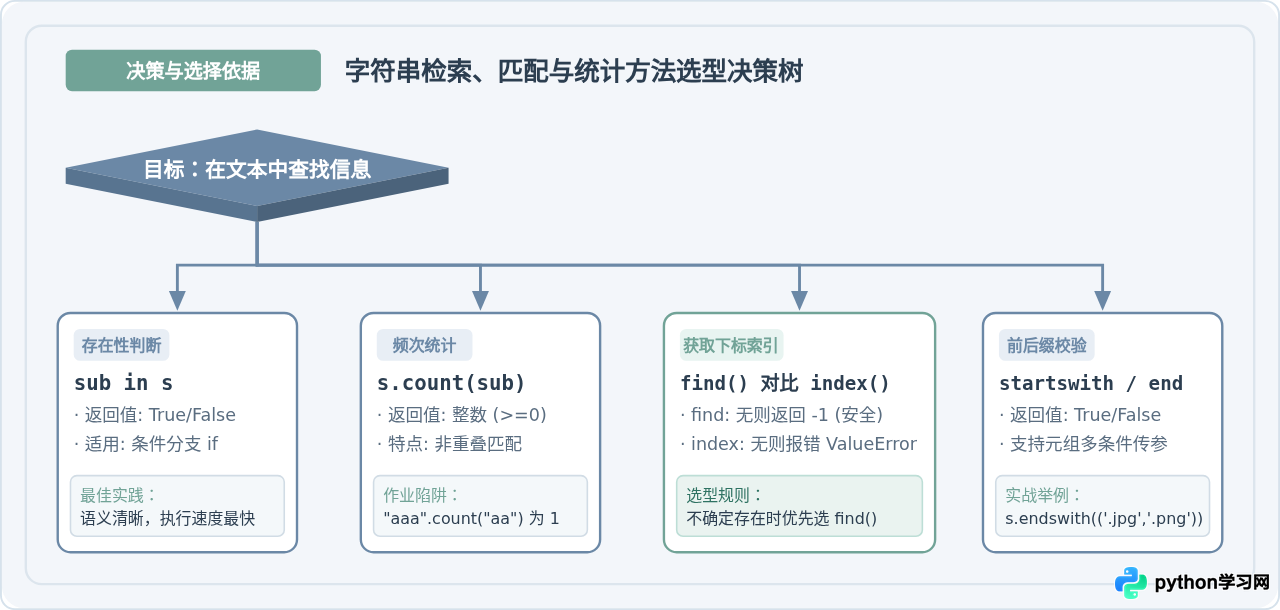
检索类题目要求在文本中定位目标字符、统计频次或验证文件合规性。面对不同场景,选择合适的方法能够避免不必要的条件判断与运行时报错。
1. 检索与统计方法选型依据
| 操作需求 | 首选方法 / 语法 | 返回值特点 | 异常/越界处理表现 |
|---|---|---|---|
| 仅检查是否存在 | sub in s |
True / False |
安全,不会抛出异常,运算开销极小 |
| 获取起始索引(安全) | s.find(sub) |
整数下标(>= 0) |
找不到时返回 -1,不中断程序 |
| 获取起始索引(严格) | s.index(sub) |
整数下标(>= 0) |
找不到时抛出 ValueError 异常 |
| 统计出现次数 | s.count(sub) |
非负整数 | 统计非重叠出现的总频次 |
| 前缀/后缀校验 | startswith / endswith |
True / False |
可传入元组批量匹配多扩展名 |
2. 典型作业题与标准解答
作业题目:编写一个文件分类校验函数 classify_and_inspect(filename, keyword),验证文件是否为合规的图片格式(.jpg, .png, .webp),检查文件名中是否包含指定关键字,并输出该关键字第一次出现的下标。
def classify_and_inspect(filename: str, keyword: str):
    # 步骤 1:利用 endswith 配合元组进行多后缀校验
    is_image = filename.lower().endswith((".jpg", ".png", ".webp"))

    # 步骤 2:利用 in 进行存在性快速检查
    has_keyword = keyword in filename

    # 步骤 3:利用 find 获取安全下标
    kw_pos = filename.find(keyword)

    return {
        "is_image": is_image,
        "has_keyword": has_keyword,
        "keyword_index": kw_pos
    }

# 测试示例
report1 = classify_and_inspect("2026_annual_report_chart.png", "report")
report2 = classify_and_inspect("data_backup.csv", "report")

print("文件 1 校验结果:", report1)
print("文件 2 校验结果:", report2)if s.find(sub): 这种条件语句!当 sub 恰好出现在字符串第 0 个位置时,s.find(sub) 返回 0。在 Python 的布尔判定中,0 被视作 False,导致程序逻辑错误。判断是否存在必须写为 if s.find(sub) != -1: 或直接使用 if sub in s:。
四、文本拆分与重组实战作业题(split 与 join)
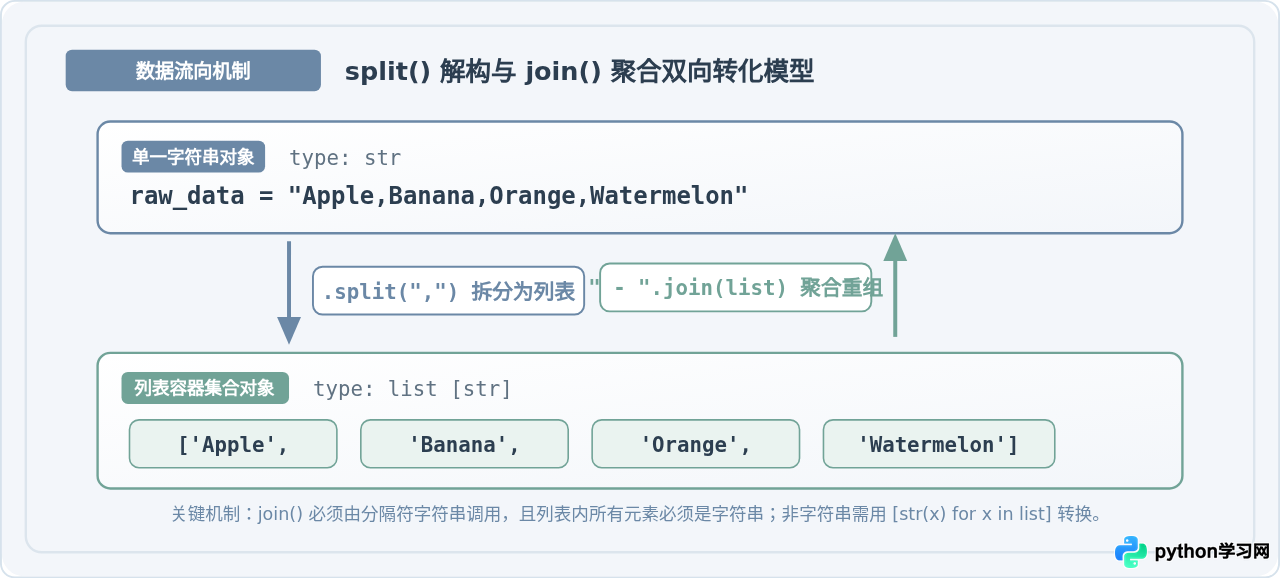
在实际数据处理与综合大作业中,文本很少以孤立字符串的形式存在,更多是以分隔符(逗号、分号、制表符)组合的数据流。split() 与 join() 是实现字符串与列表相互转换的“孪生”方法。
1. 拆分与聚合机制对比
str.split(sep=None, maxsplit=-1):将字符串按指定的分隔符sep拆解成列表。如果不传sep参数,默认会将连续的任意空白字符(空格、换行、制表符)视为一体进行拆分,并自动过滤两端空白。sep.join(iterable):以sep作为连接符,将列表、元组等可迭代容器中的所有字符串元素聚合成一段全新文本。
2. 综合实战作业题与标准解答
作业题目:给定一段非结构化学生成绩登记字符串 "Tom:82 ; Jack:58 ; Alice:95 ; Bob:61 ; Mary:49",要求完成以下任务:
- 解析每一位学生的姓名与分数,清除各字段多余空白。
- 筛选出及格(分数 ≥ 60)的学生名单。
- 将及格名单重新组合为以
" -> "连接的展示文本,并计算及格学生的平均分。
def process_score_sheet(raw_scores: str):
    # 步骤 1:按照分号拆解每一条记录
    records = raw_scores.split(";")

    passed_names = []
    passed_scores = []

    for item in records:
        cleaned_item = item.strip()
        if not cleaned_item:
            continue

        # 步骤 2:按照冒号拆分为姓名与分数
        name, score_str = cleaned_item.split(":")
        name = name.strip()
        score = int(score_str.strip())

        # 步骤 3:及格条件筛选
        if score >= 60:
            passed_names.append(name)
            passed_scores.append(score)

    # 步骤 4:使用 join 重构展示文本
    summary_text = " -> ".join(passed_names)
    avg_score = sum(passed_scores) / len(passed_scores) if passed_scores else 0.0

    return summary_text, round(avg_score, 2)

raw_data = "Tom:82 ; Jack:58 ; Alice:95 ; Bob:61 ; Mary:49"
passed_chain, avg = process_score_sheet(raw_data)

print("及格学生链路:", passed_chain)
print("及格平均分:", avg)join() 严格要求传入容器中的每个元素都必须是 str 字符串类型。如果列表中包含数值(如 [1, 2, 3]),直接调用 ",".join([1, 2, 3]) 会抛出 TypeError: sequence item 0: expected str instance, int found。正确写法必须使用列表推导式或生成器表达式预先转换:",".join(str(x) for x in [1, 2, 3])。
五、核心方法全景图解与作业防坑清单
为了帮助读者系统归纳并快速复习字符串作业涉及的核心方法,下表将常用方法按功能进行结构化分类,并标注最佳应用场景与避坑要领:
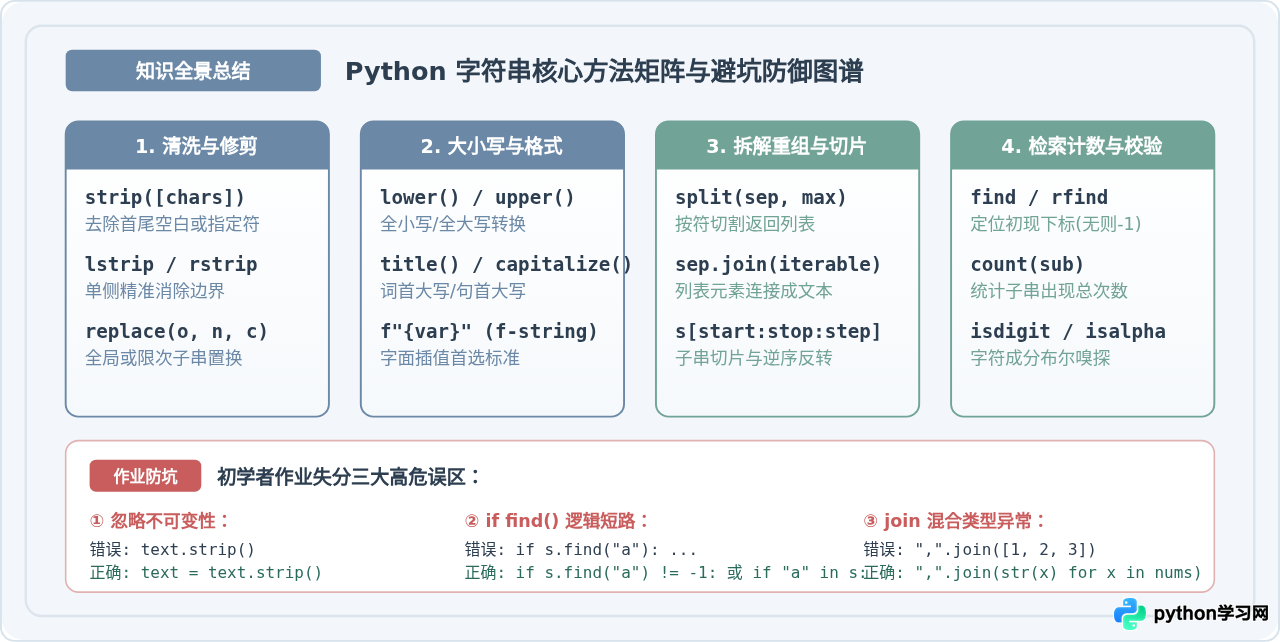
作业自查四大检查清单
- 返回值接收检查:检查所有调用的
strip()、lower()、replace()方法,是否已经赋给原变量或新变量。若未赋值,原变量数据没有任何改动。 - 类型对齐检查:使用
join()前,务必确认列表中的每一个元素均为字符串;拼接字典或数字统计结果时先使用str()转型。 - 条件检索语法检查:判断子串是否存在优先写
if "target" in s:;需要下标时若使用find(),必须显式比对!= -1。 - 切片越界与步长检查:检查反向提取切片是否使用了负步长(如
[::-1]),切片起止索引是否牢记“左闭右开”规则(即包含起点,不包含终点)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















