


Python初学者必知:42个核心内置函数清单与用法详解
精选Python初学者必须掌握的42个核心内置函数,涵盖输入输出、数值计算、类型转换、序列迭代、逻辑聚合、对象反射及实用工具7大维度。配有标准工程代码示例、避坑提示及全景高清SVG架构图解。
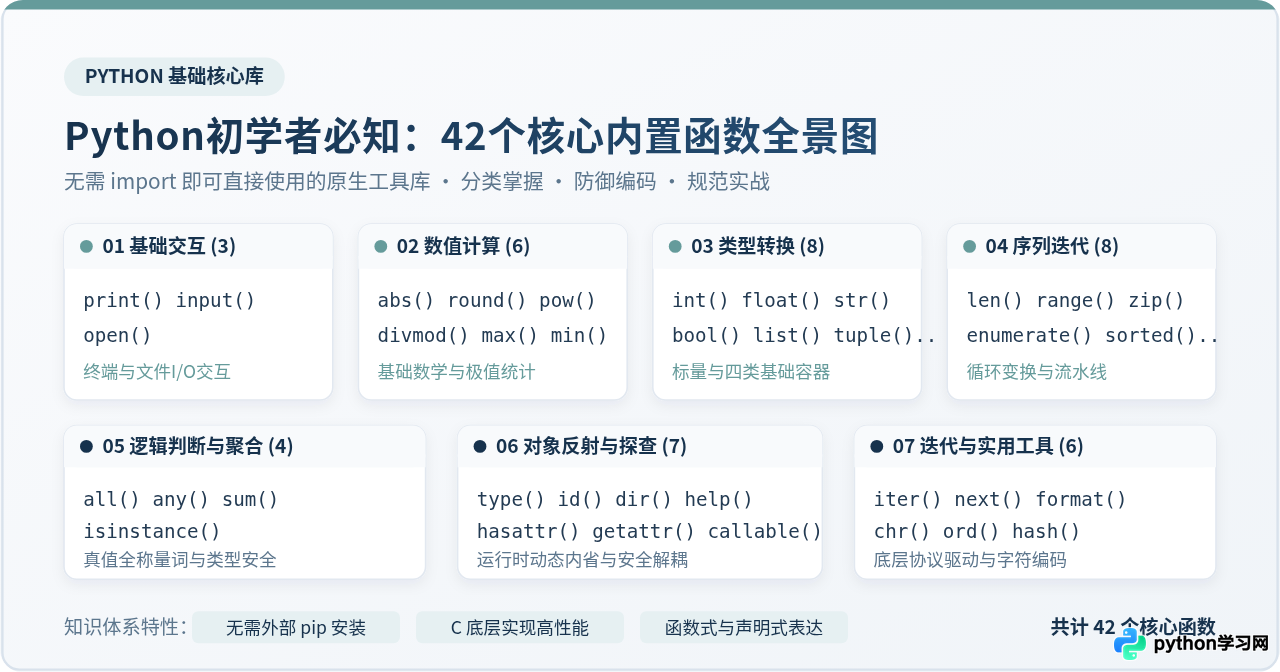
Python 解释器在启动时会自动加载一组称为“内置函数”(Built-in Functions)的原生功能,它们存在于全局作用域中,无需通过任何 import 语句导入即可直接调用。许多初学者在刚开始编写程序时,容易陷入一种误区:遇到列表累加、极值比对、元素编号或条件过滤等基础需求时,第一时间手写 for 循环和临时变量来拼凑逻辑。这样不仅导致代码冗长易错,执行性能也远低于由 C 语言底层深度优化过的原生内置函数。本文从 Python 官方标准库内置函数中,严格筛选出初学者在日常编码中最常用、最具工程价值且最易踩坑的 42 个核心内置函数,按业务逻辑划分为 7 大模块,配合可直接执行的完整代码示例与避坑要点,帮助你快速建立规范、高效的 Pythonic 编程思维。
一、高效使用内置函数的选型与防御法则
在逐个学习具体函数之前,初学者应当先建立一套清晰的内置函数选型思维。面对具体业务需求时,判断是否已有内建函数支持,能够帮你省去大量重复造轮子的成本。在调用这些函数时,关注参数边界与返回值形态则是编写稳健代码的关键。
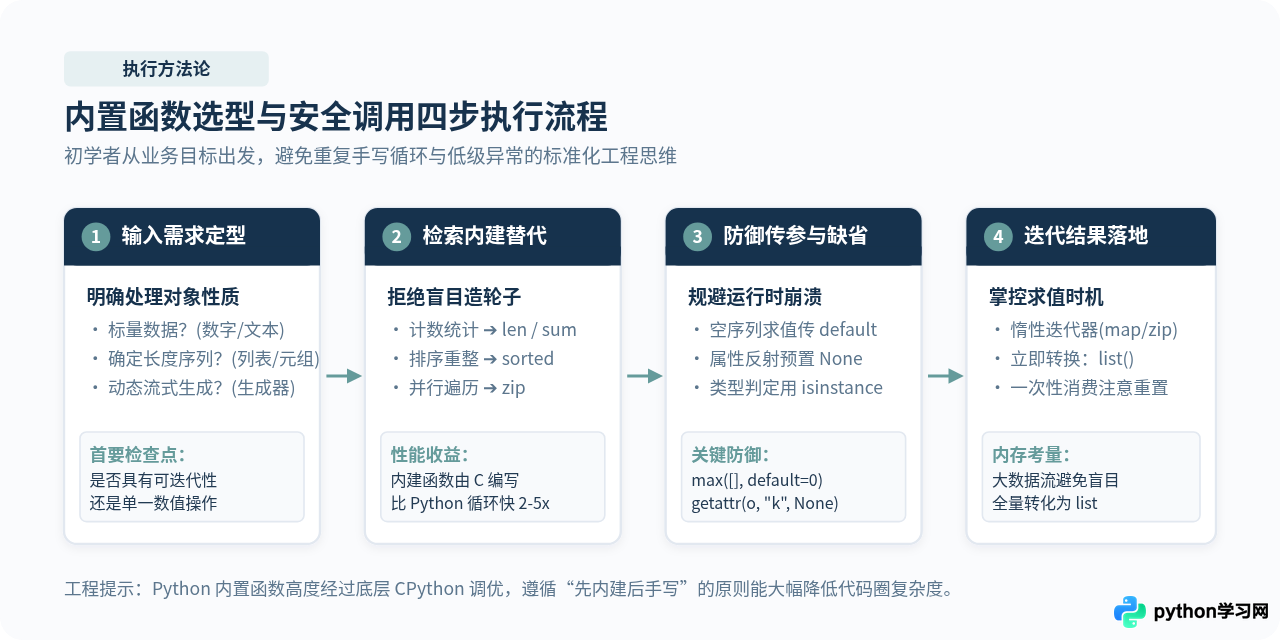
日常编码中请牢记以下四个关键原则:
- 输入类型与可迭代性预检:明确处理对象是单一标量(数字、文本)还是容器(列表、字典、生成器)。若函数要求可迭代对象(如
max()、sum()),传入不可迭代对象会直接抛出TypeError。 - 善用防御性缺省参数:对可能为空的容器取极值时,务必传入
default参数,例如max(data_list, default=0),避免空列表触发ValueError: max() arg is an empty sequence。 - 区分立即计算与惰性求值:
range()、map()、filter()和zip()在 Python 3 中均为惰性迭代器,不会一次性生成完整列表。如果需要反复遍历或直接打印内容,需显式使用list()或tuple()进行实例化物化。 - 内省探测优先于盲目猜测:遇到第三方对象或复杂数据结构时,随时借助
dir()、type()、help()与isinstance()探查其结构属性与行为特征。
二、基础输入输出与交互操作(3个)
输入输出是任何控制台程序与脚本工具的起点,这组函数负责与终端用户及磁盘文件进行数据流交互。
print() 将一个或多个对象转换为文本字符串输出。通过自定义分隔符 sep 和行尾终止符 end,可以精准控制排版输出格式;设置 flush=True 可强制刷新缓冲区(适用于下载进度条或实时日志显示)。
# 代码示例
scores = [88, 92, 95]
print("成绩单:", *scores, sep=" | ")
print("任务处理中", end="...")
print("完成!")

# 示例输出:
# 成绩单: 88 | 92 | 95
# 任务处理中...完成!print() 的返回值始终为 None。切勿写出 result = print("hello") 并试图在后续逻辑中使用 result,此时 result 的值为 None。
input() 暂停程序执行,并在控制台显示提示文字,等待用户键入内容并按下回车键,最终将读取到的输入内容作为纯字符串返回。
# 代码示例
raw_age = "25"  # 模拟用户在终端输入 "25"
age = int(raw_age)  # 必须显式强转为数值类型
print(f"十年后年龄为: {age + 10}")

# 示例输出:
# 十年后年龄为: 35input() 返回的数据类型永远是 str。如果不进行 int() 或 float() 类型转换直接进行数学加减运算,会导致 TypeError: can only concatenate str to str。
open() 是操作本地文件的统一入口。推荐永远与 with 语句结合使用,利用上下文管理器协议确保在读写完毕或发生异常时,底层文件句柄均能被正确释放。
# 代码示例:规范的文件写入与读取流程
filename = "demo_notes.txt"
with open(filename, mode="w", encoding="utf-8") as f:
    f.write("Python 内置函数实践记录\n第二行数据")

with open(filename, mode="r", encoding="utf-8") as f:
    first_line = f.readline().strip()
    print("首行读取结果:", first_line)

# 示例输出:
# 首行读取结果: Python 内置函数实践记录encoding="utf-8"。Windows 环境下若省略该参数,默认可能采用系统 GBK 编码打开文件,极易引发 UnicodeDecodeError。
三、数值计算与数学辅助(6个)
Python 原生内置了基础数学运算函数,用于处理数值的绝对值、四舍五入、取模以及极值查找,无需额外 import math 即可胜任绝大多数基础运算场景。
接收一个整数、浮点数或复数,返回其非负的量值。如果参数是复数,则返回该复数的几何模长 $\sqrt{a^2 + b^2}$。
# 代码示例
print(abs(-42))        # 整数绝对值
print(abs(-3.1415))    # 浮点数绝对值
print(abs(3 + 4j))     # 复数求模: 3^2 + 4^2 = 25,开方得 5.0

# 示例输出:
# 42
# 3.1415
# 5.0将浮点数舍入到指定的小数位数。如果 ndigits 省略或为 None,则返回最接近的整数。
# 代码示例
print(round(2.5))  # 舍入到最近的偶数 2
print(round(3.5))  # 舍入到最近的偶数 4
print(round(3.1415926, 2))

# 示例输出:
# 2
# 4
# 3.14round() 采用国际通用的“银行家舍入法”(Round half to even,即逢五向最近的偶数舍入),而不是初学者习惯的绝对“四舍五入”。若财务系统需要严格的商业四舍五入,应使用标准库中的 decimal 模块。
双参数形式 pow(x, y) 等价于 x ** y。但提供三参数形式 pow(x, y, z) 时,底层采用蒙哥马利模幂算法,直接计算 $(x^y) \pmod z$,在密码学和竞赛中避免了大数溢出与极高内存消耗。
# 代码示例
print(pow(2, 3))        # 2 的 3 次方
print(pow(2, 10, 100))  # 1024 % 100

# 示例输出:
# 8
# 24接收两个实数,返回一个包含整除商与余数的二元元组 (a // b, a % b)。在分页总页数计算、秒数转时分秒等场景中,一次计算即可同时拿到两项结果。
# 代码示例:秒数转为分钟与剩余秒数
total_seconds = 185
minutes, seconds = divmod(total_seconds, 60)
print(f"{minutes}分 {seconds}秒")

# 示例输出:
# 3分 5秒支持多参数传入 max(1, 5, 2) 或单容器传入 max([1, 5, 2])。支持通过 key 传入回调函数自定义比对维度;通过 default 设置容器为空时的兜底返回值。
# 代码示例:查找成绩最高与最低的学生记录
students = [
    {"name": "小明", "score": 85},
    {"name": "小红", "score": 96},
    {"name": "小刚", "score": 78}
]
best = max(students, key=lambda s: s["score"])
worst = min(students, key=lambda s: s["score"])
print("最高分:", best["name"], best["score"])

# 防御空列表场景
empty_data = []
safe_val = max(empty_data, default=0)
print("空序列安全求值:", safe_val)

# 示例输出:
# 最高分: 小红 96
# 空序列安全求值: 0max([]) 或 min([]) 且未设置 default 参数,程序会立即崩溃抛出 ValueError。面对动态数据源时务必配置 default。
四、类型转换与常用容器构建(8个)
Python 是一门强类型动态语言,变量在参与不同运算时往往需要明确的类型转换。这组函数不仅承担标量类型的转换职责,更是构建 4 大基础数据容器的标准构造器。
int() 截断浮点数小数部分转换为整数,还支持指定进制(如二进制 base=2、十六进制 base=16)。float() 解析浮点数字符串并保留精度。
# 代码示例
print(int(3.99))          # 截断取整: 3
print(int("1010", base=2))# 二进制字符串转十进制整数: 10
print(float("3.1415"))    # 字符串转浮点数

# 示例输出:
# 3
# 10
# 3.1415int("3.14") 会直接抛出 ValueError,因为 int() 无法直接解析带小数点的字符串。正确做法是先用 float("3.14") 转为浮点数,再转为 int。
str() 获取对象的直观字符串表示。bool() 根据 Python 的真值测试协议(Truthy / Falsy)将对象转换为 True 或 False。在 Python 中,数字 0、空字符串 ""、空容器 []、{}、() 以及 None 均被判定为假。
# 代码示例
print(str(1024) + " Bytes")
print(bool(0), bool(42))
print(bool(""), bool("Python"))
print(bool([]), bool([1, 2]))

# 示例输出:
# 1024 Bytes
# False True
# False True
# False Truebool("False") 的结果是 True!因为任何非空字符串在 Python 中都视作真值。初学者在解析配置文件的布尔文本时,务必注意比对小写内容(如 val.lower() == "true")。
接收任意可迭代对象,将其元素依序解包生成全新的列表或元组。list 适用于后续需要频繁增删改的集合;tuple 适用于只读配置、函数多返回值或作为字典的合法键。
# 代码示例:将生成器或字符串展开为实体容器
chars = list("ABC")
immutable_config = tuple(["localhost", 8080])
print("列表:", chars)
print("元组:", immutable_config)

# 示例输出:
# 列表: ['A', 'B', 'C']
# 元组: ('localhost', 8080)dict() 可通过关键字传参或 (key, value) 二元组序列快速构建哈希字典。set() 接收可迭代对象并自动剔除所有重复元素,提供 $O(1)$ 时间复杂度的成员检查。
# 代码示例:二元组配对建字典与列表极速去重
pairs = [("id", 101), ("status", "active")]
user_dict = dict(pairs)

raw_tags = ["python", "code", "python", "dev", "code"]
unique_tags = set(raw_tags)
print("字典:", user_dict)
print("去重集合:", unique_tags)

# 示例输出:
# 字典: {'id': 101, 'status': 'active'}
# 去重集合: {'python', 'code', 'dev'}
五、序列遍历与迭代处理(8个)
Python 在处理集合与序列时倡导声明式的数据流水线风格。借助这 8 个核心函数,可以高效完成索引绑定、多源打包、过滤变换以及稳定排序。
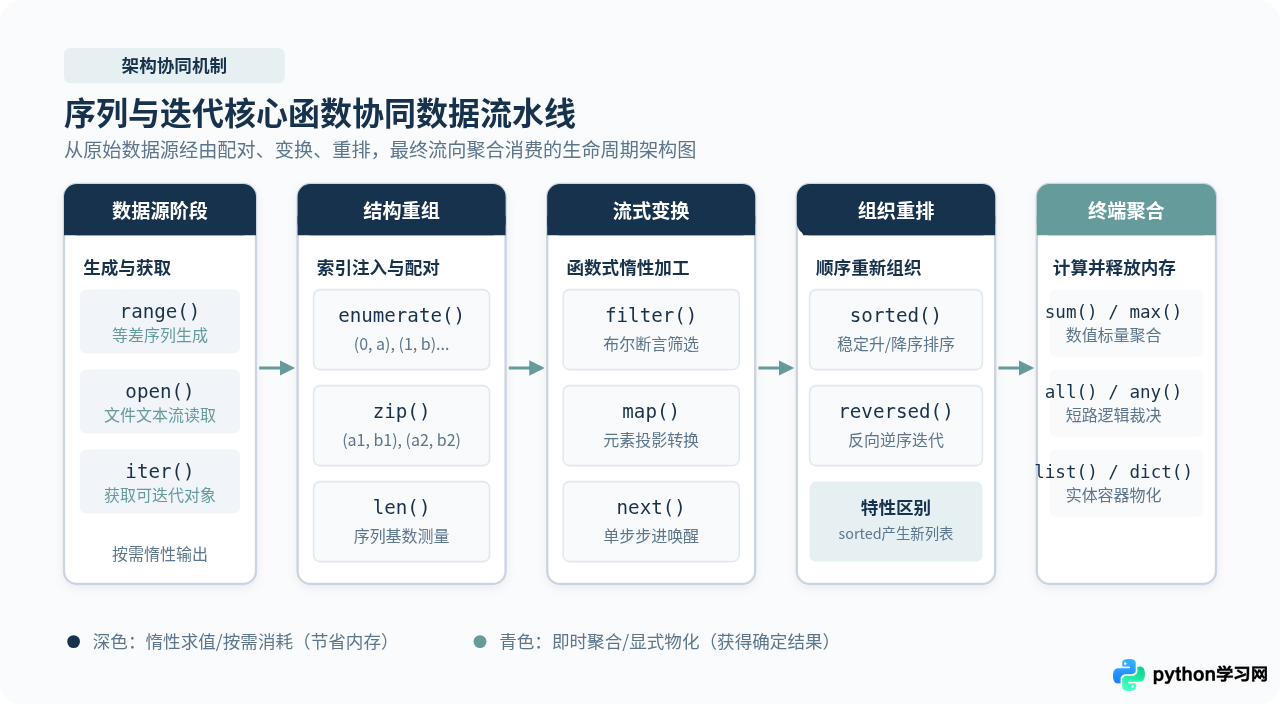
len() 直接读取对象内部的 __len__ 属性,具有 $O(1)$ 常数级复杂度。range() 产生不可变的惰性等差数列,占用内存恒定,是驱动循环的主力工具。
# 代码示例
items = ["apple", "banana", "cherry"]
print("容器长度:", len(items))

# 生成 1 到 10 之间的奇数
odd_nums = list(range(1, 10, 2))
print("等差序列:", odd_nums)

# 示例输出:
# 容器长度: 3
# 等差序列: [1, 3, 5, 7, 9]初学者容易习惯性写出 range(len(items)) 去通过下标访问元素。使用 enumerate() 可以优雅且解构式地同时获得下标和对应元素,并可通过 start 设置起始序号。
# 代码示例:打印带序号的任务清单
tasks = ["环境配置", "编写代码", "单元测试"]
for idx, task in enumerate(tasks, start=1):
    print(f"步骤 {idx}: {task}")

# 示例输出:
# 步骤 1: 环境配置
# 步骤 2: 编写代码
# 步骤 3: 单元测试接收多个可迭代对象,按位置将元素一一配对打包。若序列长度不一致,默认以最短序列为准结束打包。在 Python 3.10+ 中可通过 strict=True 强制要求长度严格一致。
# 代码示例:将姓名列表与分数列表映射为字典
names = ["Alice", "Bob", "Charlie"]
scores = [95, 82, 88]
grade_book = dict(zip(names, scores))
print("配对结果:", grade_book)

# 示例输出:
# 配对结果: {'Alice': 95, 'Bob': 82, 'Charlie': 88}zip() 返回的是一个惰性迭代器,一旦遍历消费完毕,再次对该对象进行遍历将得到空结果。如需重复使用,应立即转存为 list(zip(...))。
sorted() 采用稳定的 Timsort 算法,对任意可迭代对象排序并返回全新列表,不修改原容器。reversed() 则在常数空间内从后向前反向产生元素。
# 代码示例:按字符串长度降序排序
words = ["python", "go", "typescript", "c"]
sorted_words = sorted(words, key=len, reverse=True)
print("降序排序:", sorted_words)
print("逆序遍历:", list(reversed(words)))

# 示例输出:
# 降序排序: ['typescript', 'python', 'go', 'c']
# 逆序遍历: ['c', 'typescript', 'go', 'python']sorted(my_list) 与列表的自身方法 my_list.sort()。sorted() 返回新列表且适用于元组/集合;而 my_list.sort() 是就地修改且返回 None。
filter() 保留使断言函数返回真值的元素;若 function 传入 None,则自动剔除所有假值元素。map() 对每个元素逐一应用函数并产生变换后的结果。
# 代码示例:清洗数据并计算偶数的平方
nums = [1, 2, 3, 4, 5, 6]
evens = filter(lambda x: x % 2 == 0, nums)
squared_evens = map(lambda x: x ** 2, evens)
print("处理结果:", list(squared_evens))

# 剔除空字符串与假值
raw_inputs = ["hello", "", "world", None, "ok"]
clean_inputs = list(filter(None, raw_inputs))
print("过滤空项:", clean_inputs)

# 示例输出:
# 处理结果: [4, 16, 36]
# 过滤空项: ['hello', 'world', 'ok']
六、逻辑判断与数据聚合(4个)
在业务逻辑判断和数据清洗汇总中,全称量词(是否全部满足)与存在量词(是否存在任一满足)是最高频的判决操作。
all() 当且仅当所有元素均为真值时返回 True(遇到首个假值立即短路退出)。any() 只要存在任意一个真值元素即返回 True(遇到首个真值短路退出)。
# 代码示例:表单验证逻辑
fields_valid = [True, True, False]
print("全员合格:", all(fields_valid))
print("存在合格:", any(fields_valid))

# 结合生成器表达式优雅校验列表元素
scores = [85, 92, 78, 90]
all_passed = all(s >= 60 for s in scores)
print("全员及格:", all_passed)

# 示例输出:
# 全员合格: False
# 存在合格: True
# 全员及格: Trueall([]) 时,其返回值是 True(这是数理逻辑中的“空真” Vacuous Truth 特性);而 any([]) 返回 False。初学者在编写校验逻辑时切勿忽略输入可能为空列表的边界情况。
从 start 初始值开始,从左向右将可迭代对象中的元素依次累加。可用于扁平化小列表或自定义统计初始偏移量。
# 代码示例
total = sum([10, 20, 30])
total_with_base = sum([10, 20, 30], start=100)
print("常规求和:", total)
print("带底数求和:", total_with_base)

# 示例输出:
# 常规求和: 60
# 带底数求和: 160sum() 严禁用作拼接字符串列表!若对字符串列表调用 sum(["a", "b"]) 会直接抛出 TypeError。拼接字符串请务必使用字符串方法 "".join(str_list)。
Python 官方推荐的标准类型判断工具。不仅支持单个类,还支持传入类型元组进行多类型组合匹配(满足其一即可)。更关键的是,它完全支持面向对象的继承多态机制。
# 代码示例
num = 42
print(isinstance(num, (int, float)))  # 是否为整型或浮点型
print(isinstance(True, int))          # bool 是 int 的子类,返回 True

# 示例输出:
# True
# True
七、对象探查与动态属性操作(7个)
Python 具备强大的运行时自省(Introspection)与反射能力。通过这 7 个内置函数,你可以随时观察运行中的对象结构,安全地按字符串名称读取属性,防范空指针或非法调用。
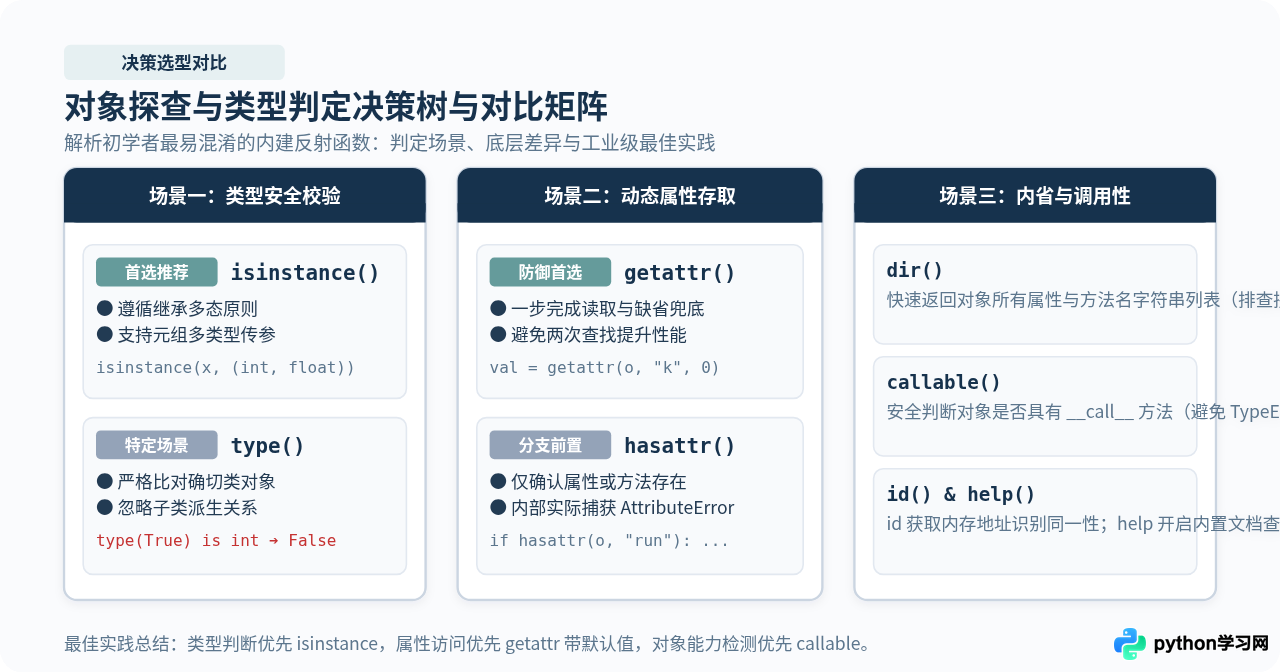
单参数的 type() 返回对象的具体类(Class)。id() 返回对象在 CPython 底层内存中的地址整数,只要对象生命周期不结束,该值全局唯一,是判断两个变量是否指向同一内存对象(is 运算)的底层依据。
# 代码示例
a = [1, 2, 3]
b = a
print("类型:", type(a))
print("内存相同性:", id(a) == id(b))

# 示例输出:
# 类型: <class 'list'>
# 内存相同性: Truetype(x) == int 不会识别子类。例如 type(True) is int 返回 False,因为 True 的直接类型是 bool。这也是生产环境中绝大多数类型判定优先选择 isinstance() 的核心原因。
dir() 返回对象包含的所有属性、方法与魔术方法的字符串列表,是排查属性拼写或探索未知模块的最佳工具。help() 开启交互式说明,格式化输出函数的签名与文档注释。
# 代码示例:探索字符串对象的独有方法
str_methods = [m for m in dir("") if not m.startswith("__")]
print("字符串常用方法示例 (前5个):", str_methods[:5])

# 示例输出:
# 字符串常用方法示例 (前5个): ['capitalize', 'casefold', 'center', 'count', 'encode']当属性名以字符串变量形式传入时(如插件架构、动态配置解析),使用 getattr() 可以动态读取属性;配置 default 参数可在属性不存在时返回默认值,避免程序抛出 AttributeError。
# 代码示例:动态安全读取配置项
class Config:
    host = "127.0.0.1"
    port = 8000

cfg = Config()
# 存在则读取,不存在则回退为默认值
host = getattr(cfg, "host", "0.0.0.0")
timeout = getattr(cfg, "timeout", 30)

print(f"主机: {host}, 超时时间: {timeout}")
print("是否具备启动端口:", hasattr(cfg, "port"))

# 示例输出:
# 主机: 127.0.0.1, 超时时间: 30
# 是否具备启动端口: True在设计回调机制、中间件或动态插件时,传入的参数可能是普通数据也可能是处理函数。在对其加括号执行前调用 callable(),可以彻底规避 TypeError: 'xxx' object is not callable 异常。
# 代码示例:防御式执行回调函数
def execute_callback(cb):
    if callable(cb):
        return cb()
    return "非可调用对象,跳过执行"

print(execute_callback(lambda: "回调成功触发"))
print(execute_callback("静态文本字符串"))

# 示例输出:
# 回调成功触发
# 非可调用对象,跳过执行
八、底层迭代与基础实用工具(6个)
这一组函数涵盖了 Python 迭代器协议的底层触发入口、高级文本格式化、字符与 ASCII/Unicode 码位映射以及哈希运算。
iter() 调用对象的 __iter__() 协议返回迭代器。next() 调用 __next__() 获取后继值;设置 default 可以在迭代耗尽时优雅返回默认值,代替引发 StopIteration 异常。
# 代码示例:手动单步消费迭代器
colors = ["红", "绿", "蓝"]
color_iter = iter(colors)

print(next(color_iter))             # 获取第1项: 红
print(next(color_iter))             # 获取第2项: 绿
print(next(color_iter))             # 获取第3项: 蓝
print(next(color_iter, "已结束"))   # 防御 StopIteration

# 示例输出:
# 红
# 绿
# 蓝
# 已结束这是 f-string 和 str.format() 底层调用的内置实现,用于数字补零、千分位逗号分隔、百分比转换及对齐排版。
# 代码示例:数值美化排版
print(format(1234567.89, ",.2f"))  # 千分位与两位小数
print(format(0.856, ".1%"))        # 转化为百分比
print(format(42, "08d"))           # 左侧补零对齐8位

# 示例输出:
# 1,234,567.89
# 85.6%
# 00000042ord() 接收单字符返回其对应的十进制整数码位;chr() 接收合法的码位整数并返回对应的单字符。常用于生成字母表序列、字符偏移加密以及协议编码转换。
# 代码示例:自动生成 A-Z 字母列表
print("字母 A 的码位:", ord("A"))
print("码位 97 对应的字符:", chr(97))

alphabet = [chr(code) for code in range(ord("A"), ord("Z") + 1)]
print("大写字母表 (前6个):", alphabet[:6])

# 示例输出:
# 字母 A 的码位: 65
# 码位 97 对应的字符: a
# 大写字母表 (前6个): ['A', 'B', 'C', 'D', 'E', 'F']只有不可变对象(如整数、浮点数、字符串、元组)才是可哈希(Hashable)的,可哈希是能够作为字典的 key 或存入集合 set 的先决条件。
# 代码示例
key_tuple = ("user", 101)
print("元组哈希值:", hash(key_tuple))

# 可变列表无法被哈希
try:
    hash([1, 2, 3])
except TypeError as e:
    print("抛出预期的异常:", e)

# 示例输出:
# 元组哈希值: 7724219488346453965 (注: 具体数值随 Python 进程加盐变动)
# 抛出预期的异常: unhashable type: 'list'__eq__ 但未定义 __hash__,该类的实例将自动变成不可哈希对象,无法放入字典键或集合中。
九、42个核心内置函数全景分类速查
为了便于日常编码时随时对照查验,下表整理了本文介绍的全部 42 个核心内置函数所属分类、核心语义及高频使用建议:
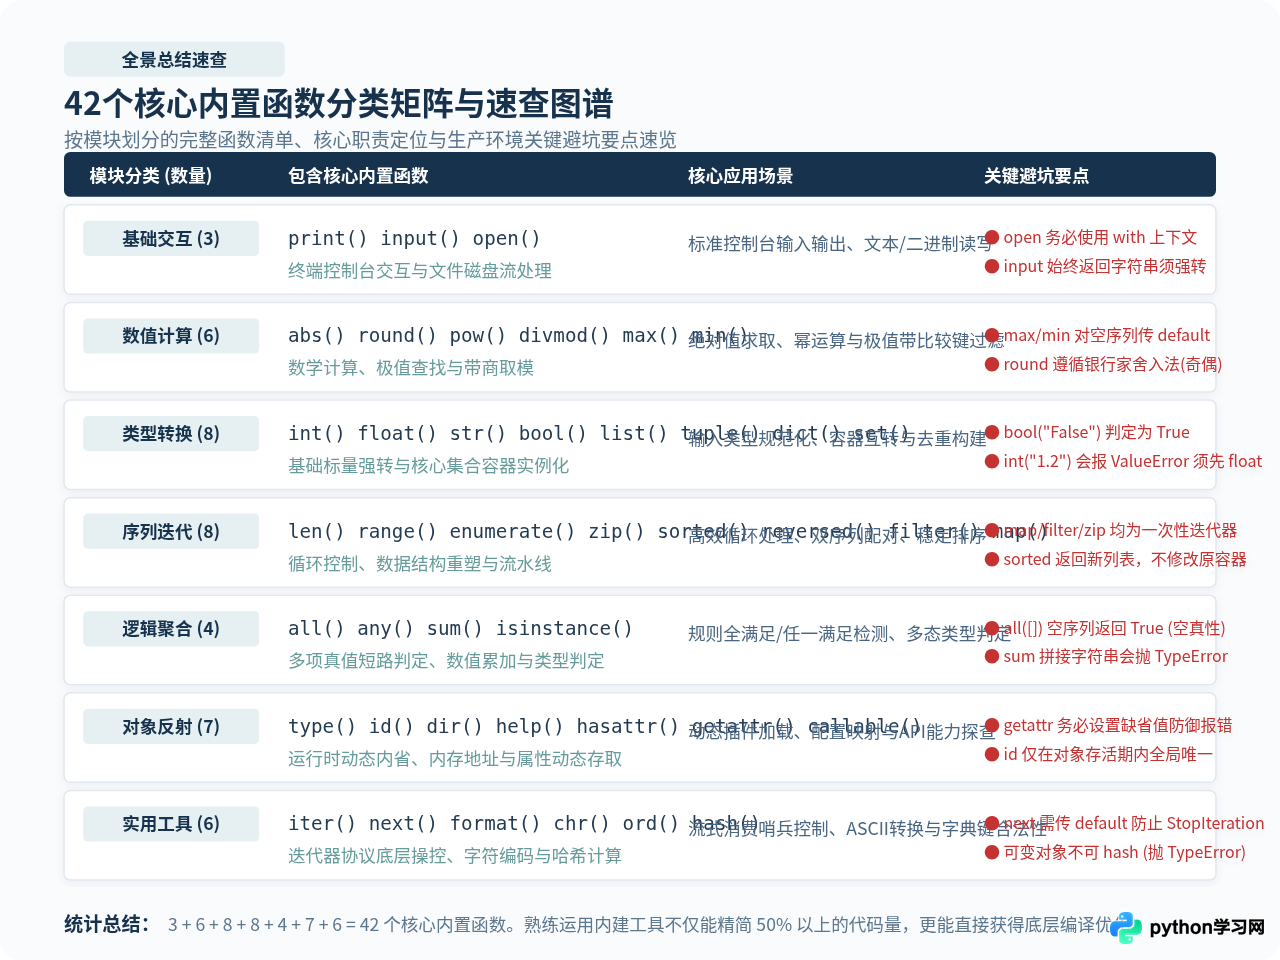
| 分类 (数量) | 函数清单 | 核心能力与推荐用法 |
|---|---|---|
| 基础交互 (3) | print, input, open |
终端 I/O 与文件读写。文件务必用 with open() 上下文管理。 |
| 数值计算 (6) | abs, round, pow, divmod, max, min |
数学基础与极值。max/min 对空序列必须加 default。 |
| 类型转换 (8) | int, float, str, bool, list, tuple, dict, set |
数据强转与容器初始化。去重优先 set(),不可变约束用 tuple()。 |
| 序列迭代 (8) | len, range, enumerate, zip, sorted, reversed, filter, map |
循环控制与数据流。带索引遍历用 enumerate(),排序优先 sorted()。 |
| 逻辑聚合 (4) | all, any, sum, isinstance |
条件判定与累加。类型检查一律优先 isinstance()。 |
| 对象反射 (7) | type, id, dir, help, hasattr, getattr, callable |
运行时动态内省。动态读取属性首选带默认值的 getattr()。 |
| 实用工具 (6) | iter, next, format, chr, ord, hash |
底层协议与编码。迭代器推进消费用 next(it, default) 防溢出。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















