


Python大数据量绘图卡顿怎么办?性能优化与降采样策略
针对Python处理数十万至千万级数据绘图时界面卡死、渲染极其缓慢的问题,本文从渲染底层瓶颈剖析、Matplotlib原生加速配置、LTTB等高保真降采样算法,到千万级Datashader栅格化方案,提供全套可落地的性能优化与工程实践策略。
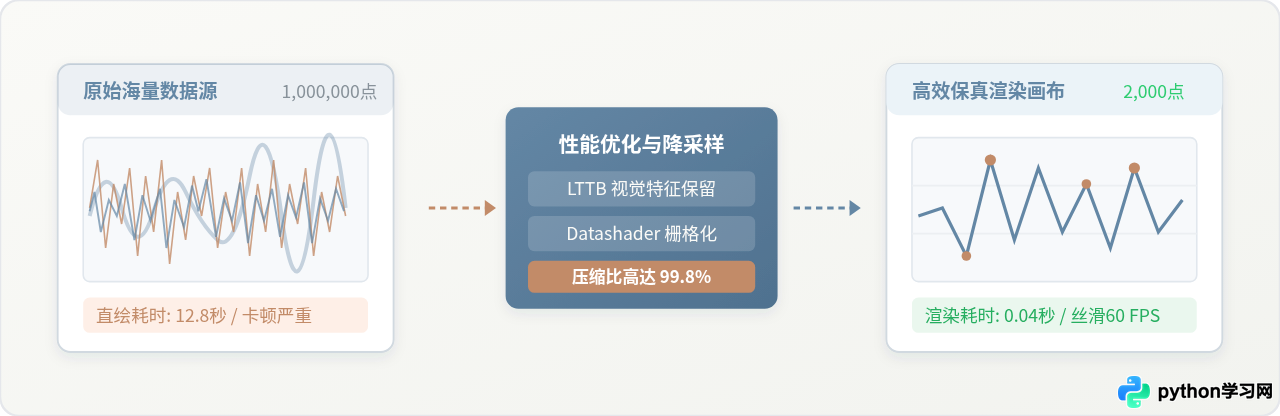
plt.plot() 或 sns.lineplot() 往往会导致程序假死、内存瞬间被占满甚至GUI直接崩溃。解决这一问题的本质,是在不损失人眼与业务可观测特征的前提下,降低底层几何计算与显存传输的负载——通过剖析底层渲染瓶颈、开启Matplotlib原生路径极简配置、运用以LTTB为代表的视觉特征保留降采样算法,以及在超大规模场景下接入Datashader像素级栅格化管线,可将原本数十秒的卡顿耗时压低至毫秒级。
一、为什么大数据量绘图会卡顿?理解渲染瓶颈
许多初学者在遇到绘图卡顿的第一反应是“计算机算力不足”,但实际上瓶颈主要来源于屏幕物理分辨率与底层矢量绘图管线之间的供需失衡。
主流1080P显示器的横向有效绘图区通常只有1200到1600像素。如果向画布输入100万个点,意味着每个像素宽度内平均塞入了600到800个数据点。这些点在物理屏幕上完全重叠,人眼根本无法区分单个像素内数百个点的细微差异。
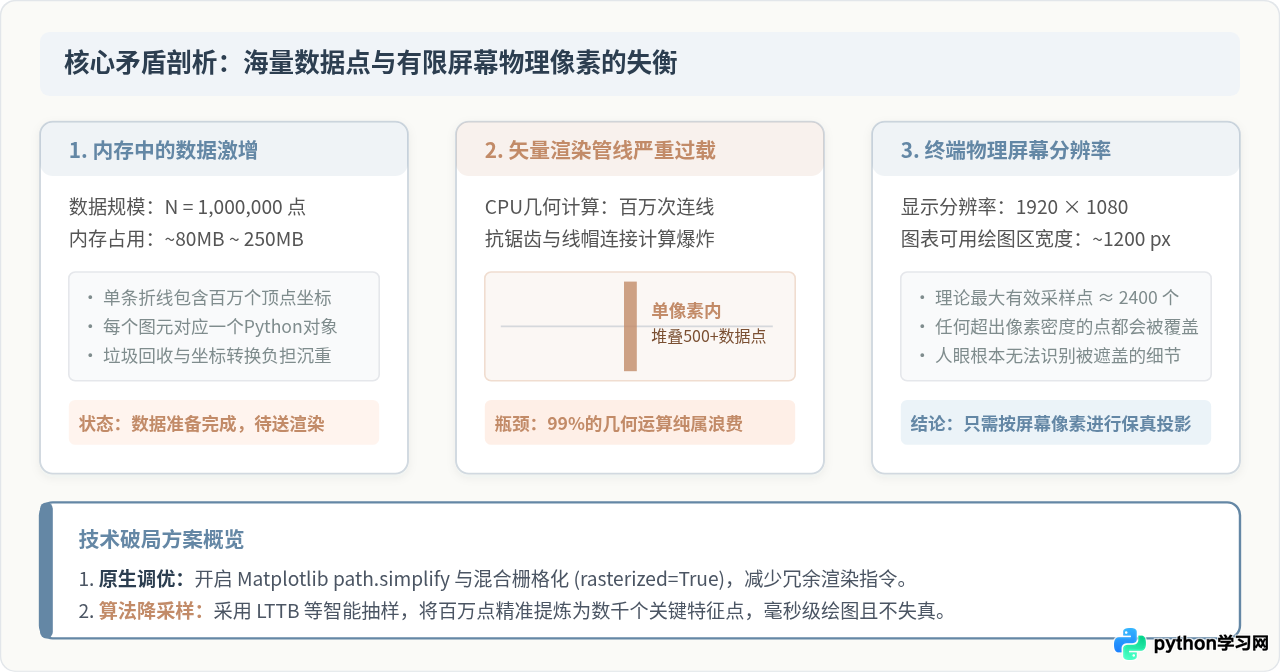
然而,传统的矢量绘图后端(如Matplotlib默认的绘图逻辑)并不知道哪些点被重叠遮挡了。为了保证矢量可缩放性,它会严格执行以下重度计算:
- Python对象内存膨胀:为每一个点或折线段维护Python内部对象、属性字典及坐标转换矩阵,海量对象会导致严重的垃圾回收(GC)延迟。
- 几何连线与抗锯齿过载:CPU逐点计算折线顶点连接(Line Join Style)、线帽(Cap Style)以及抗锯齿半透明混合,导致单像素内发生数百次无效过绘制(Overdraw)。
- 交互式DOM节点崩溃:如果在Jupyter中使用了Plotly或Bokeh且未做降采样,库会尝试将几百万个SVG/HTML节点直接推送至浏览器前端,导致浏览器标签页内存溢出崩溃。
二、Matplotlib原生绘图的轻量级性能调优
在很多数据分析任务中,数据量处于5万至50万之间,尚未达到必须更换专业大数据引擎的程度。此时通过微调Matplotlib底层的几何运算配置,往往就能获得数倍的提速,且不需要修改业务逻辑代码。
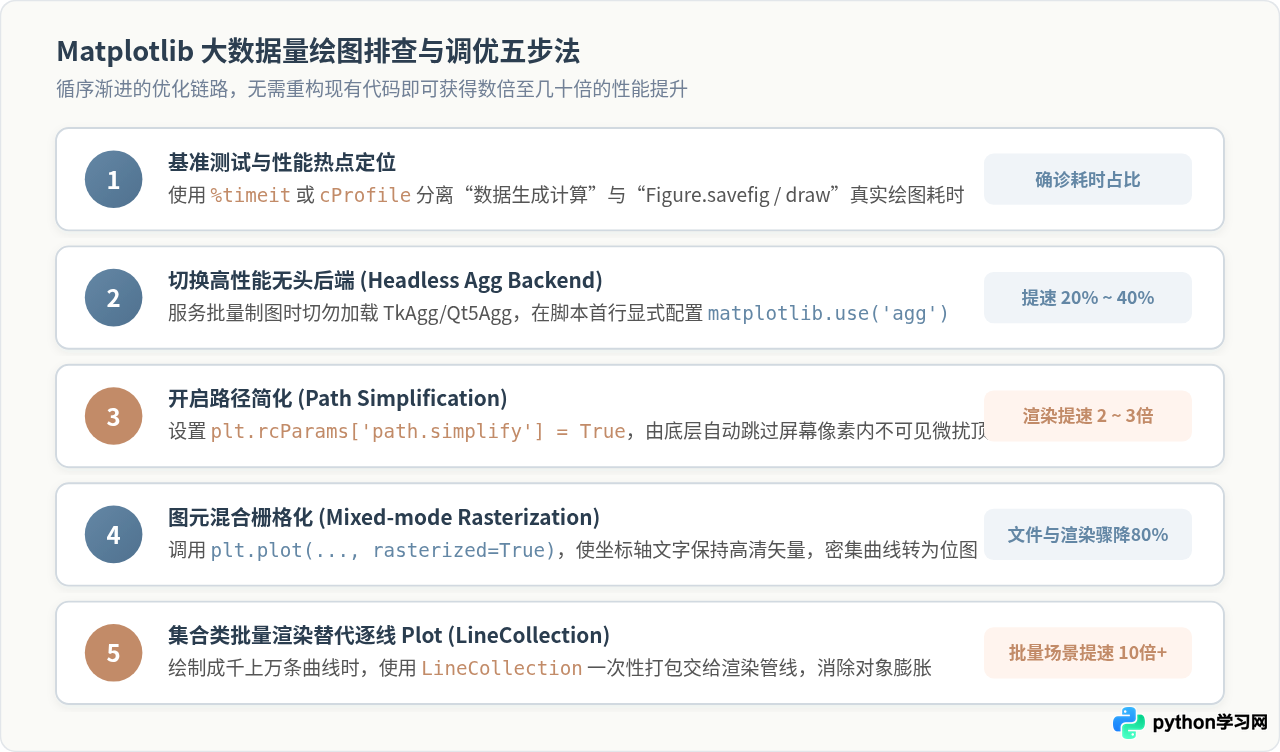
1. 开启路径简化(Path Simplification)
Matplotlib内置了基于Douglas-Peucker演算法的路径简化机制。默认情况下该机制对部分图元是关闭或阈值保守的。开启后,底层C++渲染层会自动合并屏幕像素步长内的细微抖动点,大幅减少传给渲染后端的顶点数:
import matplotlib.pyplot as plt

# 开启路径全局简化
plt.rcParams['path.simplify'] = True
# 设定简化阈值:以物理像素为单位,1.0即表示小于1个像素宽度的抖动将被合并
plt.rcParams['path.simplify_threshold'] = 1.0
# 开启聚合块简化
plt.rcParams['agg.path.chunksize'] = 10000
2. 使用混合栅格化(Mixed-mode Rasterization)
当需要保存高清晰度的PDF或SVG矢量报告,但折线图或散点图包含几十万个点时,生成的文件往往达数百兆且打开极卡。通过为密集数据层显式指定 rasterized=True,可以让坐标轴、刻度、图例和文本保持高清矢量,而唯独将密集的点或线图层栅格化为位图:
# 散点图或密集曲线仅对图元层栅格化
plt.scatter(x, y, s=1, alpha=0.5, rasterized=True)
plt.savefig("high_perf_chart.pdf", dpi=300)
3. 使用 LineCollection 替代多重循环绘制
如果需要绘制成百上千条时间序列曲线(如金融多标的行情或传感器集群),切忌在 for 循环中反复调用 plt.plot()。每次调用都会创建一个独立的 Line2D 对象并向轴注册事件监听。改用 LineCollection 可以将所有线条打包在一个单一图元中批量提交:
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.collections import LineCollection

# 模拟 500 条曲线,每条 2,000 个点(共 1,000,000 点)
num_lines, points_per_line = 500, 2000
x = np.linspace(0, 10, points_per_line)
ys = np.random.randn(num_lines, points_per_line).cumsum(axis=1)

# 将数据重构为 (num_lines, points_per_line, 2) 的三维网格
segments = [np.column_stack([x, y]) for y in ys]

fig, ax = plt.subplots(figsize=(10, 5))
# 单一集合批量渲染,耗时从数十秒骤降至0.1秒
line_collection = LineCollection(segments, linewidths=0.5, alpha=0.6, colors='#6487A5')
ax.add_collection(line_collection)
ax.autoscale()
plt.show()
三、降采样策略:兼顾性能与形态的关键
当数据量超过50万行且主要为时序型数据时,仅仅依赖绘图库底层优化依然会消耗大量内存。此时最科学的方案是在数据送入绘图函数之前进行特征保真降采样。
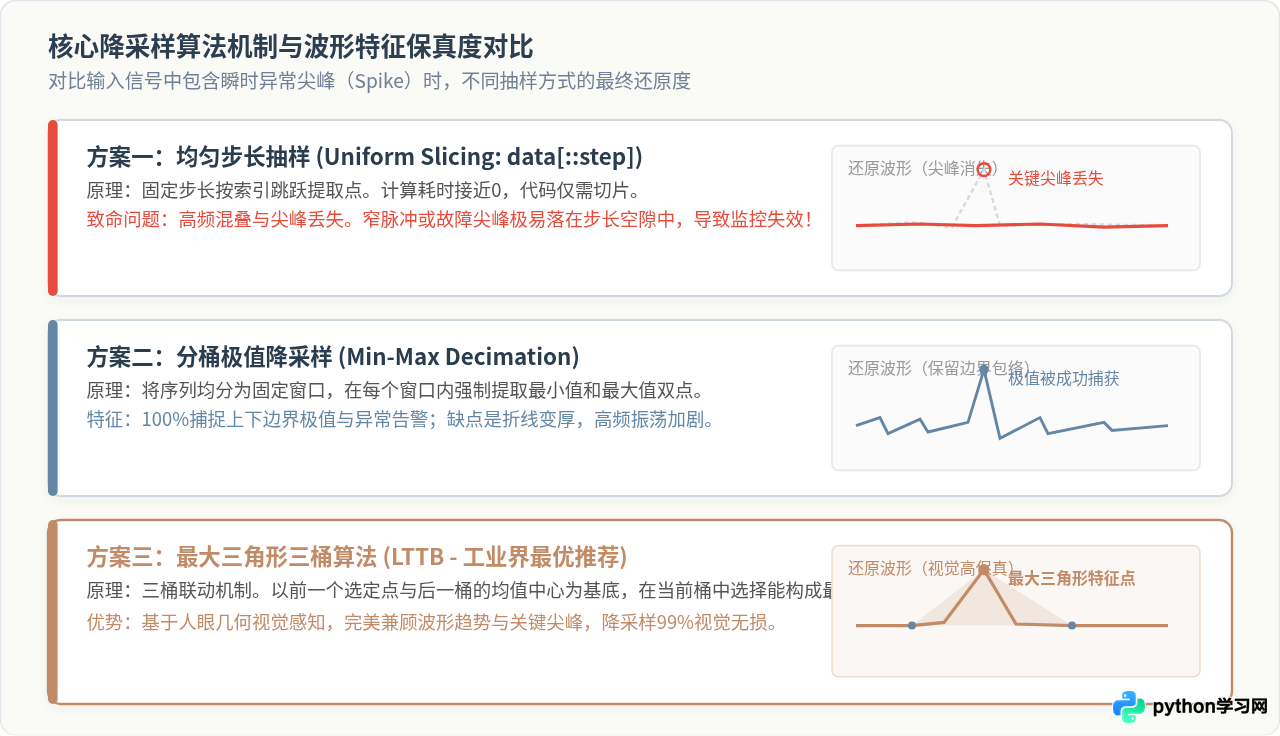
1. 为什么不能直接用切片抽样(data[::step])?
很多工程师习惯使用步长切片(如 data[::100])。这种做法的致命缺陷在于高频混叠与极值盲区。如果机械设备在第10,042毫秒发生了一次剧烈的电压击穿(持续仅1毫秒的高尖峰),而你的切片刚好提取了第10,000和第10,100毫秒的点,这个关键的故障尖峰就会在图表上彻底蒸发,导致严重的业务漏报。
2. 分桶极值抽样(Min-Max Decimation)
分桶极值法的逻辑是将全量序列划分为 $K$ 个区间桶,每个桶内强制提取最大值与最小值两个采样点。
- 优点:算法复杂度仅为 $O(N)$,且100%能够保留信号包络线与异常尖峰,极度适合硬件监控与警报回溯。
- 缺点:每个桶输出两点并按时间排列,绘制出的折线会在局部呈现上下高频锯齿震荡,整体波形视觉偏“粗糙”。
3. LTTB 算法(最大三角形三桶算法)——视觉无损首选
LTTB(Largest Triangle Three Buckets)算法由冰岛大学学者Sveinn Steinarsson提出,现已成为Grafana等主流时序监控面板的核心采样标准。
工作原理:将数据分为除首尾点外的 $K$ 个分桶。在处理桶 $i$ 时,算法利用已选定的前一个采样点(点A)以及下一个桶 $i+1$ 中所有点的几何中心(点C)作为底边,在当前桶 $i$ 中寻找一个点B,使得三角形 $\Delta ABC$ 的有效面积最大。面积最大的点代表了该区域偏离平均趋势最显著的形态转折点(即极值或拐点)。
使用基于Rust/C加速的 tsdownsample 库,可以在数十毫秒内将千万行时序压缩为2000个点:
import numpy as np
import matplotlib.pyplot as plt
from tsdownsample import LTTBDownsampler

# 1. 模拟生成包含高频尖峰的 1,000,000 阶测试时序
n_points = 1_000_000
t = np.linspace(0, 100, n_points)
signal = np.sin(t * 0.1) + np.random.normal(0, 0.05, n_points)
# 人为注入突发故障尖峰
signal[500_200] = 8.5
signal[750_100] = -7.2

# 2. 应用 LTTB 算法,将百万数据点智能提炼为 2,000 点
downsampler = LTTBDownsampler()
sampled_indices = downsampler.downsample(signal, n_out=2000)

x_sampled = t[sampled_indices]
y_sampled = signal[sampled_indices]

# 3. 毫秒级绘制高保真图表
plt.figure(figsize=(10, 4.5))
plt.plot(x_sampled, y_sampled, color='#6487A5', linewidth=1.2, label='LTTB (2,000 pts)')
# 标出被成功捕获的故障尖峰
plt.scatter([t[500_200], t[750_100]], [signal[500_200], signal[750_100]],
            color='#C28B68', s=35, zorder=5, label='Captured Spikes')

plt.title("LTTB Downsampling: 1,000,000 pts -> 2,000 pts (High Fidelity)", fontsize=12)
plt.legend(loc='upper right')
plt.grid(True, linestyle='--', alpha=0.4)
plt.show()tsdownsample,其底层采用SIMD矢量化指令集与多线程,处理1000万个点仅需约30毫秒。
四、千万级数据的终极方案:Datashader 像素级栅格化
当数据量攀升至1000万到1亿以上,或者面对的是空间地理散点、非单调的多维轨迹数据时,时序降采样算法已无法应对。此时业界的终极解决方案是Datashader。
传统库的做法是“数据 $ ightarrow$ 几何矢量图元 $ ightarrow$ 屏幕像素”。而Datashader彻底打破了这一流程,采用了类似现代游戏引擎的计算直方图栅格化管线:
- 聚合阶段(Aggregation):利用多核CPU(基于Numba)直接将海量坐标投影到一个与输出图像像素大小相同的二维数组(如 $1000 imes 600$ 网格)中,每个网格记录落入该像素的数据频次或统计量。
- 着色阶段(Shading):通过对二维数组应用动态范围压缩(如对数色彩映射),直接渲染成一张位图。
由于无论输入是100万点还是1亿点,最终传给前端的都只是一张小巧的位图,渲染耗时与数据总量几乎解耦,不仅彻底消除了浏览器的卡顿,而且能够真实反映散点的高密度重叠分布。
import datashader as ds
import datashader.transfer_functions as tf
import pandas as pd
import numpy as np

# 生成 5,000,000 个二维散点
n = 5_000_000
df = pd.DataFrame({
    'x': np.random.normal(0, 1, n),
    'y': np.random.normal(0, 1, n)
})

# 定义画布物理像素尺寸 (1000 x 600)
cvs = ds.Canvas(plot_width=1000, plot_height=600)
# 内存聚合:将500万个点映射到60万个像素网格中(耗时约0.08秒)
agg = cvs.points(df, 'x', 'y')
# 着色生成位图
img = tf.shade(agg, cmap=["#FAFAF7", "#6487A5", "#C28B68"])
# 输出为高保真位图对象进行展示
img.to_pil().save("datashader_output.png")
五、方案选型矩阵与避坑实践
在实际项目落地时,切勿盲目引入最复杂的架构。应根据数据体量、图表交互需求以及运行环境选择投入产出比最高的方案:
| 数据量级 | 推荐技术路线 | 典型渲染耗时 | 适用场景与特征 |
|---|---|---|---|
| < 10万点 | Matplotlib 原生优化 / Seaborn | < 0.2 秒 | 常规离线报表,只需设置 path.simplify=True 即可流畅运行。 |
| 10万 ~ 100万点 | LTTB (tsdownsample) + 任意前端 | 0.02 ~ 0.05 秒 | 单通道/多通道工业时序,完美保留异常波形与故障尖峰,支持Plotly缩放。 |
| 100万 ~ 5000万点 | Datashader + HoloViews / Bokeh | 0.08 ~ 0.3 秒 | 海量地理轨迹、基因测序、高密度散点图,渲染时间与数据量几乎无关。 |
| 实时高频数据流 (>100Hz) | PyQtGraph / Fastplotlib (WebGPU) | 保持 60 FPS | 医疗心电图、雷达信号、实时量化盯盘等桌面级实时刷新系统。 |
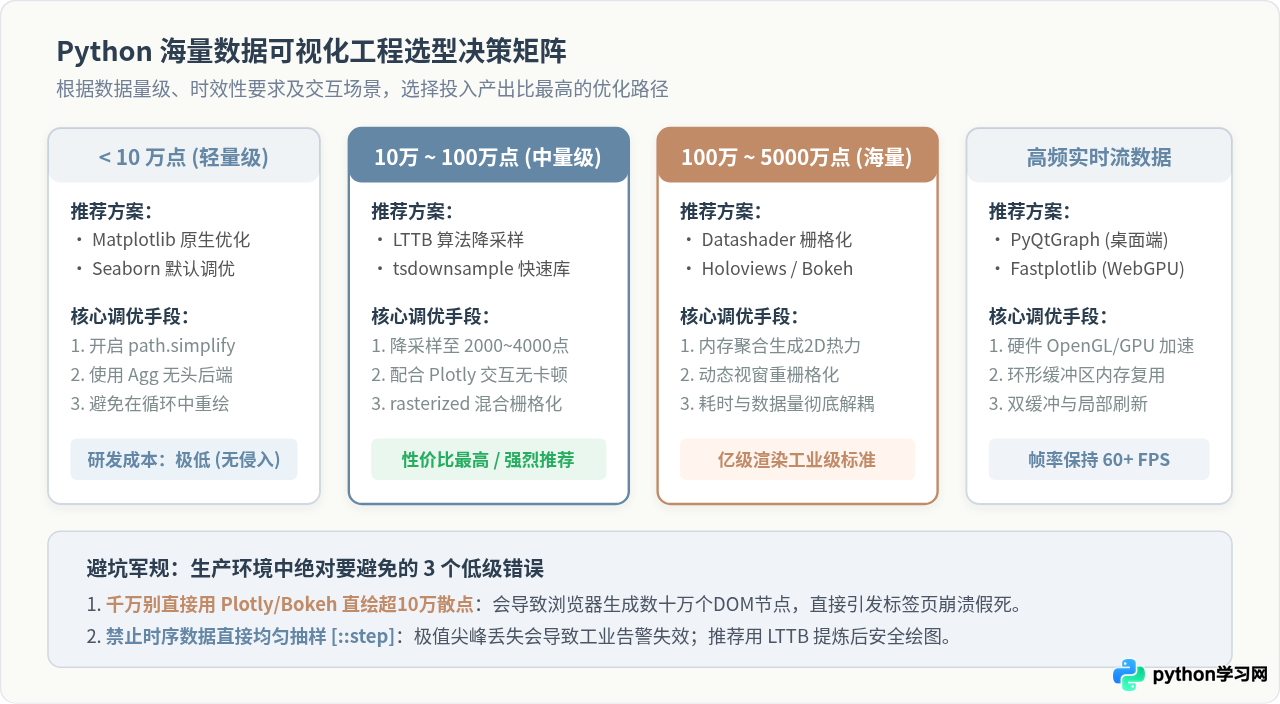
- 及时关闭画布释放显存:在循环批量出图的服务端脚本中,务必在保存后显式调用
plt.close(fig),否则未释放的 Figure 对象会常驻内存导致静默 OOM。 - 确保时序数据严格单调:LTTB 等降采样算法假设输入 $X$ 轴时间序列具有单调性。若存在时间戳乱序,必须先调用
df.sort_values(),否则会导致几何连线交叉形成严重混乱。 - 前端交互库警惕 DOM 膨胀:若使用 Plotly 或 ECharts,在传输给前端 JSON 之前务必确认数据点已降至 5,000 点以内,将算力压力留在后端。
通过结合原生图元优化、基于感知的LTTB特征降采样以及工业级Datashader栅格化管线,Python完全具备在普通工作站上秒级呈现千万级数据的能力。根据实际数据特征精准匹配渲染管线,不仅能彻底告别界面卡顿,更能保障核心业务洞察的高保真呈现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















