


运维自动化为何首选Python?脚本编写与系统管理应用实践
深入解析系统运维自动化首选Python的核心原因,对比Bash与Go的适用边界,提供涵盖系统监控、远程SSH批量管理及日志解析的生产级脚本规范与落地实践。
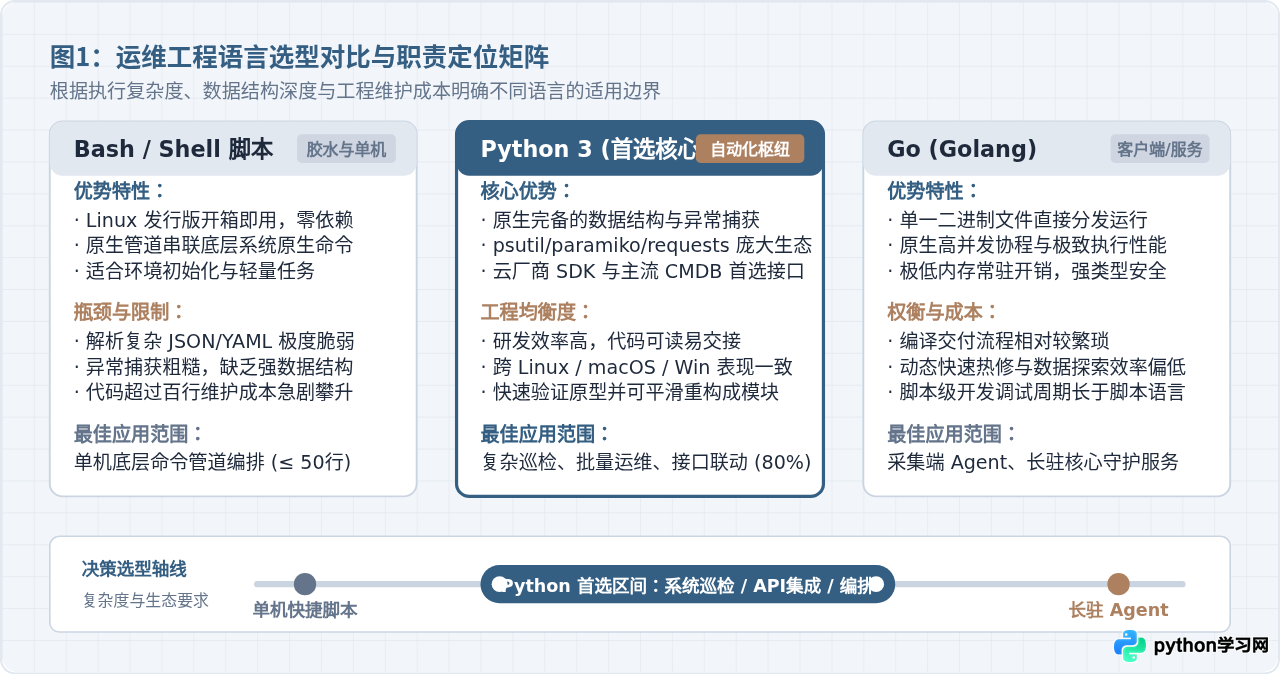
一、技术选型透视:Bash、Python 与 Go 的权衡与适用边界
在实际生产环境中,系统管理员与 SRE 工程师最常接触的三种语言分别是 Bash、Python 和 Go。选择 Python 并不意味着彻底排斥其他两者,而是依据任务复杂度、执行环境和数据处理需求划定最合理的工程边界。
| 对比维度 | Bash / Shell | Python 3 | Go (Golang) |
|---|---|---|---|
| 数据结构与解析 | 依赖外部命令(awk/sed/jq),变量弱类型,数组操作繁琐 | 原生列表、字典、集合,内置 json / csv,扩展解析极强 |
强类型 Struct,解析高效严谨,但数据探索修改繁琐 |
| 异常捕获与容错 | 基于进程退出码($?、set -e),不易精细恢复 |
完备的 try-except-finally 异常层次树与回溯栈 |
显式 if err != nil,严密但脚本逻辑较为冗长 |
| 外部生态与SDK | 主要通过 curl 拼凑 HTTP 请求,缺少面向对象客户端 |
云厂商(AWS/阿里云/腾讯云)与 Kubernetes、Prometheus 全覆盖 | 云原生底层(Docker/K8s)原生支持,但依赖模块打包 |
| 跨平台与环境一致性 | 受限于 GNU/BSD 工具链差异(如 macOS 与 Linux 的 sed 参数不同) | 跨平台标准库屏蔽底层 OS 差异(os.path、pathlib) |
交叉编译为单一静态二进制文件,运行零外部依赖 |
| 代码规模与可维护性 | 超过 100 行即极难阅读与交接,缺乏统一模块包规范 | 强制缩进、自解释语法、模块化拆包,易于团队协同演进 | 规范严格,适合大型长生命周期守护进程 |
从选型决策来看,三者存在明确的“甜蜜区”:
- 使用 Bash 的场景: 50 行以内的单机初始化脚本、原生管道串联简单命令行工具、容器 Entrypoint 启动包装。此场景下直接调用 Linux 原生指令开销最低。
- 首选 Python 的场景: 涵盖 80% 以上的日常运维自动化任务,包括但不限于复杂巡检状态收集、多机 SSH 编排、日志流结构化提取、监控数据清洗并推送钉钉/企业微信、对接 CMDB 或公有云 API 批量创建与回收实例。
- 使用 Go 的场景: 需要驻留在数万台主机上持续运行的轻量级采集 Agent、对内存占用有极致要求(< 20MB)、需要极高并发协程吞吐的网络代理或控制平面服务。
二、核心运行架构:生产级 Python 自动化脚本的标准范式
编写临时运行的代码与编写“生产级运维脚本”有着本质的区别。初学者容易把所有逻辑写成平铺直叙的顺序指令,一旦遇到网络抖动、目标主机离线或配置缺失,脚本便会异常中断甚至留下脏状态。
一个符合工业标准的自动化脚本应当具备清晰的流水线分层:输入与配置解耦 → 状态感知与信息采集 → 业务规则与异常防护 → 调度执行与动作闭环。
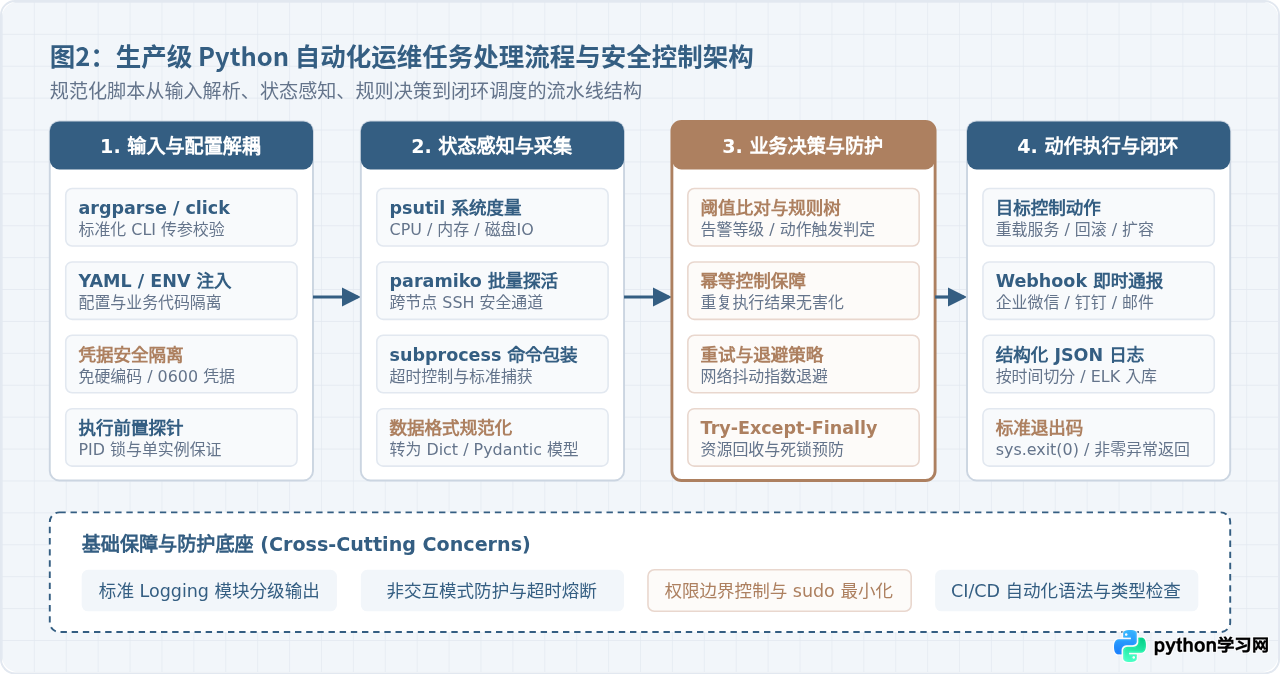
1. 配置与业务逻辑彻底解耦
严禁将服务器 IP、端口、告警 Webhook 地址、账号凭据硬编码在 .py 业务代码中。应通过 argparse 接收运行时参数,通过外部 YAML 配置文件或环境变量(os.environ)注入运行上下文。这不仅便于多环境(开发、测试、生产)复用,也杜绝了代码提交导致敏感凭据泄露的安全隐患。
2. 超时与重试机制(防挂起原则)
运维脚本常涉及网络通信(HTTP 请求、SSH 连接、数据库查询)或子进程调用。任何没有设置 timeout 的网络操作都可能导致脚本永久阻塞挂起,进而卡死计划任务队列。使用 requests 或 subprocess.run 时,必须明确传入超时秒数,并对可恢复的临时网络波动设计指数退避重试逻辑。
3. 幂等性与执行状态闭环
幂等性是指同一个脚本重复执行多次,系统最终状态保持一致且不会产生副作用。例如:在创建目录或下发用户前先检查是否存在;修改配置后仅在 MD5 变更时才触发重载。脚本退出时必须使用 sys.exit(0) 表示成功,非零数字(如 sys.exit(1))表示异常,以便外部监控或 CI/CD 流水线捕获状态。
三、系统管理高频实操:三大核心场景应用实践
为了让读者切实掌握 Python 在系统管理中的编写手法,下面选取最典型的三大场景:系统运行指标巡检告警、跨主机批量 SSH 运维管控、以及日志流结构化提取。
实操一:基于 psutil 的主机健康巡检与 Webhook 告警联动
psutil(process and system utilities)是 Python 运维事实上的标准库,能够跨平台获取 CPU、内存、磁盘使用率、网络流量和进程状态,彻底取代通过 top、free、df 拼凑文本解析的脆弱方式。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import os
import sys
import logging
import requests
import psutil

# 初始化日志记录
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger("SysMonitor")

def collect_system_metrics():
    # 采集 CPU 使用率(采样间隔 1 秒)
    cpu_percent = psutil.cpu_percent(interval=1)

    # 采集物理内存
    mem = psutil.virtual_memory()
    mem_percent = mem.percent

    # 采集根分区磁盘占用
    disk = psutil.disk_usage('/')
    disk_percent = disk.percent

    # 采集平均负载 (1min, 5min, 15min)
    load_1, load_5, load_15 = os.getloadavg()
    cpu_count = psutil.cpu_count() or 1

    return {
        "cpu_usage": cpu_percent,
        "mem_usage": mem_percent,
        "disk_usage": disk_percent,
        "load_5min": round(load_5, 2),
        "cpu_count": cpu_count
    }

def evaluate_and_alert(metrics, webhook_url=None):
    alerts = []

    # 定义判定阈值
    if metrics["cpu_usage"] > 85.0:
        alerts.append(f"CPU 使用率过高: {metrics['cpu_usage']}% (阈值 85%)")
    if metrics["mem_usage"] > 90.0:
        alerts.append(f"物理内存告急: {metrics['mem_usage']}% (阈值 90%)")
    if metrics["disk_usage"] > 85.0:
        alerts.append(f"根分区磁盘紧张: {metrics['disk_usage']}% (阈值 85%)")
    if metrics["load_5min"] > (metrics["cpu_count"] * 1.5):
        alerts.append(f"5分钟负载超载: {metrics['load_5min']} (核心数 {metrics['cpu_count']})")

    if not alerts:
        logger.info("系统健康状态正常: CPU=%.1f%%, MEM=%.1f%%, DISK=%.1f%%",
                    metrics["cpu_usage"], metrics["mem_usage"], metrics["disk_usage"])
        return True

    # 触发警报逻辑
    alert_summary = "\n".join(alerts)
    logger.warning("触发健康阈值报警:\n%s", alert_summary)

    if webhook_url:
        payload = {
            "msgtype": "text",
            "text": {
                "content": f"【系统报警】主机状态异常\n{alert_summary}\n当前主机: {os.uname().nodename}"
            }
        }
        try:
            resp = requests.post(webhook_url, json=payload, timeout=5)
            resp.raise_for_status()
            logger.info("Webhook 报警推送成功")
        except requests.RequestException as err:
            logger.error("Webhook 报警发送失败: %s", err)
            return False

    return False

if __name__ == "__main__":
    # 从安全环境变量读取 Webhook,避免凭据泄漏
    alert_webhook = os.getenv("MONITOR_WEBHOOK_URL")
    sys_metrics = collect_system_metrics()
    is_healthy = evaluate_and_alert(sys_metrics, alert_webhook)

    # 规范退出码:健康退出为 0,告警退出为 2(可供监控系统捕获)
sys.exit(0 if is_healthy else 2)2026-11-01 12:25:01 [INFO] 系统健康状态正常: CPU=12.4%, MEM=68.2%, DISK=45.1%当指标越界时输出:
2026-11-01 12:25:01 [WARNING] 触发健康阈值报警: 根分区磁盘紧张: 88.5% (阈值 85%)
实操二:基于 Paramiko 的安全密钥鉴权与并发远程任务执行
在批量管理多台应用服务器时,避免使用密码明文,推荐统一使用 SSH 密钥(Ed25519 或 RSA 4096)进行免密认证。使用 paramiko 配合 Python 标准库 concurrent.futures.ThreadPoolExecutor,可以极短的代码实现类似 Ansible 的轻量级高并发任务下发。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import os
import sys
import logging
from concurrent.futures import ThreadPoolExecutor, as_completed
import paramiko

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("SSHExecutor")

def execute_remote_cmd(host, port, username, key_path, command, timeout=10):
    client = paramiko.SSHClient()
    # 自动加载已知主机公钥,未知主机使用警告策略避免中间人攻击风险
    client.set_missing_host_key_policy(paramiko.WarningPolicy())

    result = {
        "host": host,
        "success": False,
        "stdout": "",
        "stderr": "",
        "exit_code": -1
    }

    try:
        # 加载私钥(优先采用密钥认证,避免明文密码)
        private_key = paramiko.RSAKey.from_private_key_file(key_path)
        client.connect(
            hostname=host,
            port=port,
            username=username,
            pkey=private_key,
            timeout=timeout,
            banner_timeout=timeout
        )

        # 执行远程指令
        stdin, stdout, stderr = client.exec_command(command, timeout=timeout)
        exit_status = stdout.channel.recv_exit_status()

        result["exit_code"] = exit_status
        result["stdout"] = stdout.read().decode('utf-8', errors='replace').strip()
        result["stderr"] = stderr.read().decode('utf-8', errors='replace').strip()
        result["success"] = (exit_status == 0)

    except (paramiko.SSHException, TimeoutError, OSError) as err:
        result["stderr"] = f"SSH 连接或执行异常: {str(err)}"
        logger.error("[%s] 任务执行失败: %s", host, err)
    finally:
        client.close()

    return result

def batch_dispatch(hosts, command, max_workers=5):
    key_file = os.path.expanduser("~/.ssh/id_rsa")
    if not os.path.exists(key_file):
        logger.error("SSH 私钥不存在: %s", key_file)
        sys.exit(1)

    logger.info("开始并发下发任务至 %d 台主机...", len(hosts))
    reports = []

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        future_map = {
            executor.submit(execute_remote_cmd, h, 22, "opsuser", key_file, command): h
            for h in hosts
        }

        for future in as_completed(future_map):
            res = future.result()
            reports.append(res)
            status_text = "成功" if res["success"] else "失败"
            logger.info("[%s] 执行完成, 结果状态: %s (code=%d)", res["host"], status_text, res["exit_code"])

    return reports

if __name__ == "__main__":
    target_hosts = ["192.168.10.11", "192.168.10.12", "192.168.10.13"]
    # 示例执行指令:检查目标机系统运行时间与磁盘
    cmd_to_run = "uptime && df -h / | tail -n 1"

    task_reports = batch_dispatch(target_hosts, cmd_to_run)
    all_ok = all(r["success"] for r in task_reports)
    sys.exit(0 if all_ok else 1)
实操三:高吞吐日志分析与错误特征结构化提炼
线上故障排查时,Web 服务器或服务网关往往产生数十 GB 的访问日志。使用 Bash 配合 grep | awk | sort | uniq -c 虽然快速,但若要完成复杂的时间窗口对齐、多状态码交叉比对以及输出结构化 JSON 报表,脚本编写将极其冗长且易产生死锁。Python 采用生成器逐行处理,能在占用极小内存的前提下完成流式解析。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
import sys
import re
import json
from collections import Counter
from pathlib import Path

# 标准 Nginx combined 日志正则解析格式
LOG_PATTERN = re.compile(
    r'(?P<ip>[\d\.]+)\s+-\s+-\s+\[(?P<time>[^\]]+)\]\s+'
    r'"(?P<method>\w+)\s+(?P<uri>\S+)\s+HTTP/[\d\.]+"\s+'
    r'(?P<status>\d{3})\s+(?P<bytes>\d+)'
)

def stream_log_lines(file_path):
    with open(file_path, 'r', encoding='utf-8', errors='ignore') as f:
        for line in f:
            yield line

def analyze_nginx_log(log_path):
    status_counter = Counter()
    top_uris = Counter()
    error_samples = []
    total_requests = 0

    path_obj = Path(log_path)
    if not path_obj.exists():
        raise FileNotFoundError(f"日志文件未找到: {log_path}")

    for raw_line in stream_log_lines(path_obj):
        total_requests += 1
        match = LOG_PATTERN.match(raw_line)
        if not match:
            continue

        data = match.groupdict()
        status_code = data["status"]
        status_counter[status_code] += 1
        top_uris[data["uri"]] += 1

        # 记录 5xx 异常请求样本(前 5 条作为诊断线索)
        if status_code.startswith("5") and len(error_samples) < 5:
            error_samples.append({"time": data["time"], "ip": data["ip"], "uri": data["uri"], "status": status_code})

    if total_requests == 0:
        return {"error": "日志文件为空"}

    # 计算 5xx 错误率
    server_errors = sum(count for code, count in status_counter.items() if code.startswith("5"))
    error_rate = (server_errors / total_requests) * 100

    report = {
        "file": str(path_obj),
        "total_requests": total_requests,
        "error_rate_percent": round(error_rate, 3),
        "status_distribution": dict(status_counter),
        "top_5_uris": top_uris.most_common(5),
        "critical_5xx_samples": error_samples
    }
    return report

if __name__ == "__main__":
    if len(sys.argv) < 2:
        print(f"用法: python3 {sys.argv[0]} <nginx_access.log>")
        sys.exit(1)

    analysis_result = analyze_nginx_log(sys.argv[1])
    # 结构化格式化输出至标准输出
    print(json.dumps(analysis_result, indent=2, ensure_ascii=False))
四、从脚本到服务:可靠落地与部署实操规范
许多运维团队的痛点在于:脚本在开发人员个人终端上运行良好,但一旦迁移到生产集群的定时任务中,就频繁出现路径找不到、Python 版本冲突或特权越权等事故。生产落地必须遵循严格的工程化流程。
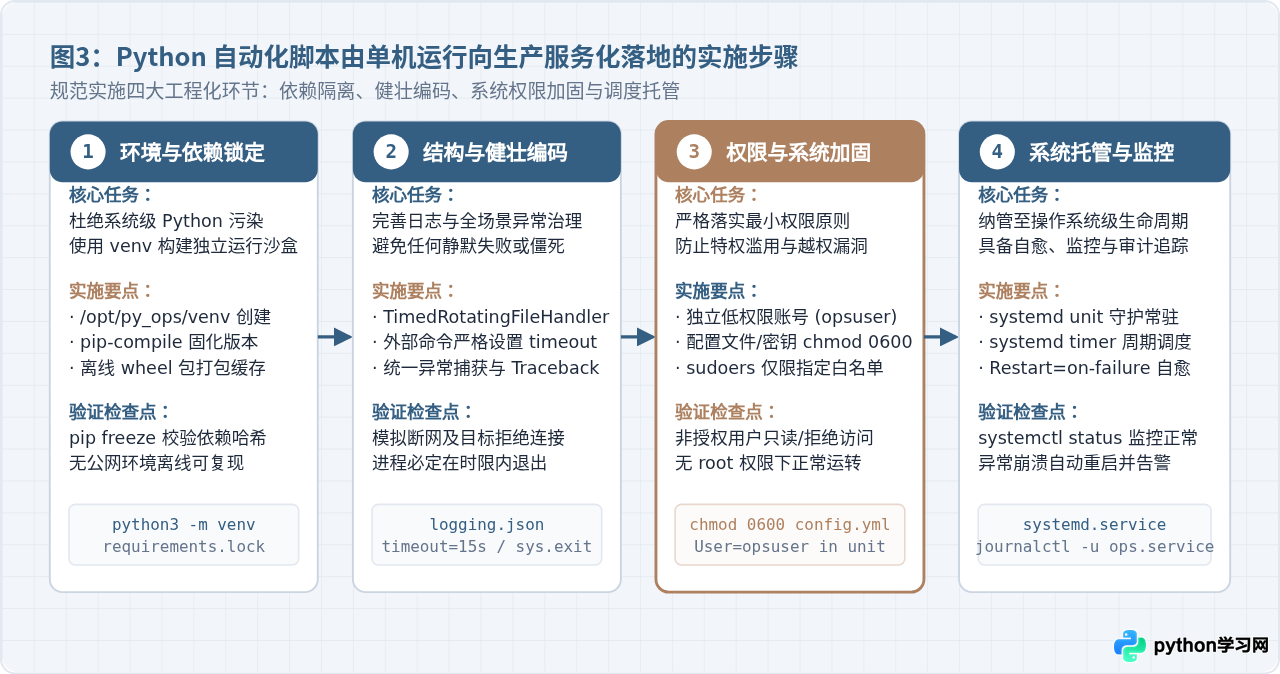
1. 环境隔离与依赖固化
严禁直接向操作系统全局 Python 环境(如 /usr/bin/python3)执行 pip install,这极易覆盖发行版系统管理工具(如 yum / dnf / cloud-init)的依赖包导致系统崩溃。
- 在部署目录创建专用虚拟环境:
python3 -m venv /opt/ops_automation/venv - 通过版本锁文件严格固定版本:
/opt/ops_automation/venv/bin/pip install -r requirements.lock - 在无外网隔离机房,利用
pip download -r requirements.txt -d ./wheels打包离线 Wheel 轮子直接安装。
2. 权限隔离与文件保护(0600 原则)
生产自动化任务必须由专用低权限运维账号(如 opsuser)运行,禁止直接以 root 用户常驻执行。
所有存放数据库连接串、API Token 或 SSH 密钥的配置文件,必须将属主设为执行账号,并严格设置文件访问权限为
0600(仅属主可读写),目录权限设为 0700:chmod 0600 /opt/ops_automation/config/*.yamlchmod 0600 /opt/ops_automation/keys/id_rsa
3. 使用 Systemd 纳管代替裸奔的 Crontab
传统的 crontab 缺乏运行环境可见性、无进程崩溃自愈机制,且日志往往被静默丢弃。推荐使用 systemd.service 配套 systemd.timer 进行生命周期纳管。
[Unit]
Description=Python Daily Ops Patrol Service
After=network.target

[Service]
Type=oneshot
User=opsuser
Group=opsuser
WorkingDirectory=/opt/ops_automation
EnvironmentFile=/opt/ops_automation/env/production.env
ExecStart=/opt/ops_automation/venv/bin/python3 /opt/ops_automation/scripts/sys_monitor.py
StandardOutput=journal
StandardError=journal
TimeoutSec=120

[Install]
WantedBy=multi-user.target[Unit]
Description=Run Python Ops Patrol Every 10 Minutes
[Timer]
OnCalendar=*:0/10
Persistent=true
[Install]
WantedBy=timers.target
通过 systemctl enable --now ops-patrol.timer 启动后,所有执行输出统一进入系统的 systemd-journald 日志中心,运维人员可通过 journalctl -u ops-patrol.service -n 50 -f 随时审查执行历史与退出状态。
五、知识总结与运维能力演进图谱
回顾全文,运维自动化之所以首选 Python,其核心优势从不是极致的执行速度,而在于卓越的综合工程投入产出比(ROI)。它让运维工程师能以极低的心理负担写出语法优雅、具备工业级容错与结构化数据处理能力的健壮程序。
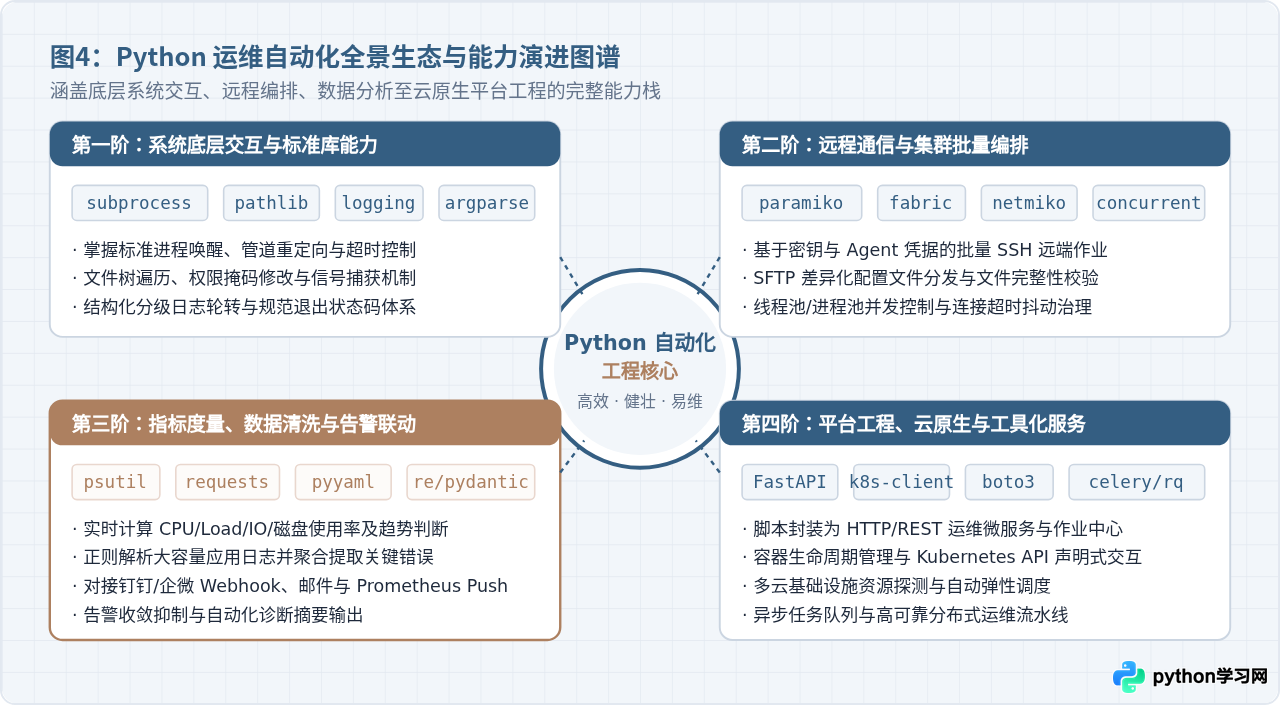
对于系统运维工程师而言,掌握 Python 自动化通常经历四个进阶阶段:
- 初阶(单机标准库): 熟练使用
os、sys、pathlib、subprocess和logging,替代冗长脆弱的 Shell 脚本,完成本机的规范化操作。 - 中阶(集群与网络交互): 掌握
psutil资源探针、paramiko/fabric远程批量编排,结合并发线程池构建高吞吐的集群作业分发能力。 - 高阶(数据化与闭环治理): 结合
requests、pyyaml与正则解析,打通监控告警渠道(企业微信/钉钉/邮件)、CMDB 系统资产与自动化自愈决策。 - 专家阶(平台工程与云原生): 利用
FastAPI/Flask将脚本封装为微服务,对接 Kubernetes Client、云厂商 SDK 及分布式任务队列(Celery),构建企业级自动化运维管理平台。
遵循标准工程规范、落实权限与依赖隔离,Python 将成为你在复杂系统架构中最为锋利、可靠的基础设施利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















