


Python列表含字典或嵌套列表时怎么去重
详细讲解Python中当列表包含字典或嵌套列表等不可哈希对象时的去重方案,深入分析TypeError报错根因,提供基于辅助集合、元组转换、业务主键提取及全量比对的完整实现与选型建议。
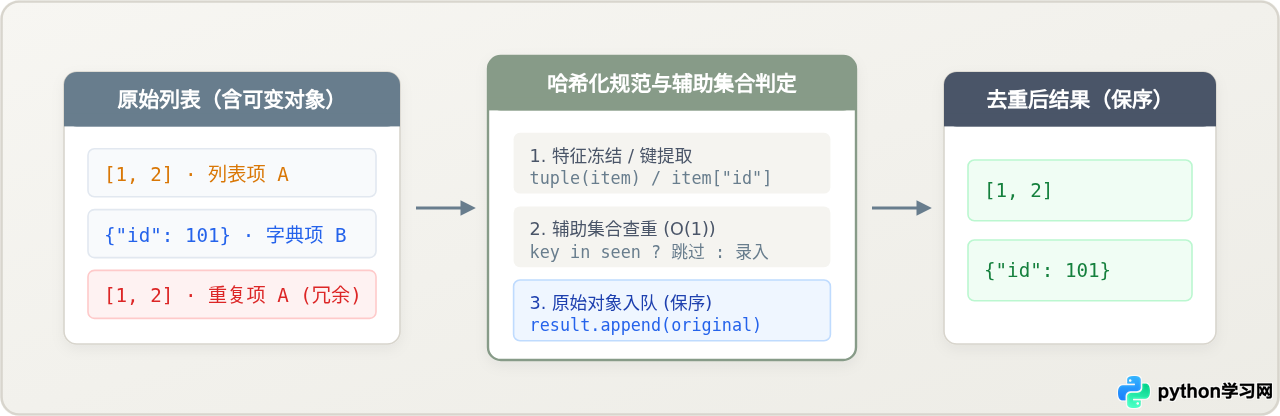
list(set(seq)),但当列表中包含字典(dict)或嵌套列表(list)等可变类型时,解释器会立即抛出 TypeError: unhashable type 异常。解决该问题的标准路径是:将不可哈希的元素转换为等价的不可变形态(例如元组、排序键值对或唯一主键标识),并借助辅助集合(seen set)在遍历过程中进行高效比对与保留顺序的过滤。
一、为什么常规 set() 会抛出 TypeError 异常?
Python 的集合(set)和字典底层均依赖哈希表(Hash Table)结构实现 O(1) 的查找性能。为了保证元素在哈希桶中的定位不会在运行时发生漂移,集合强制要求放入其中的每一个元素都必须是可哈希的(Hashable)。
一个对象要成为可哈希对象,必须实现 __hash__() 魔术方法,并且其哈希值在其生命周期内保持恒定。基础类型中的整数、浮点数、字符串和仅含不可变对象的元组(tuple)都是天然可哈希的。相反,字典与列表作为容器类型,其内容允许通过增删改等原地操作发生变更,因此 Python 官方在实现时特意禁用了它们的哈希支持:
# 触发异常的典型场景演示
data = [[1, 2], [3, 4], [1, 2]]
try:
    unique_data = list(set(data))
except TypeError as exc:
    print(f"捕获异常: {{exc}}")
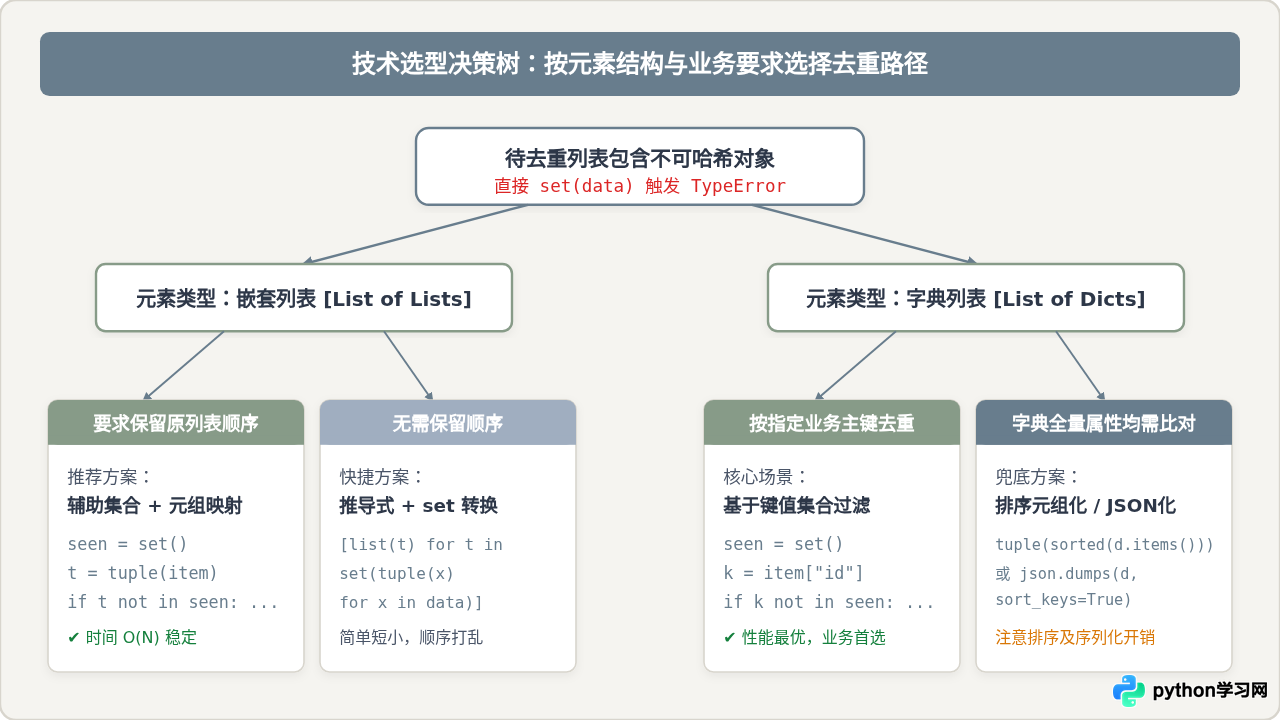
同理,若将列表内元素替换为字典,例如 [{"id": 1}, {"id": 1}],则会抛出 TypeError: unhashable type: 'dict'。要解决这一限制,核心思路不是绕开哈希,而是通过规则转换,为每个复合对象建立一个稳定、不可变且等价的哈希凭证。
二、嵌套列表(List of Lists)的去重方法
嵌套列表的元素均为列表。由于元组(tuple)是不可变序列且只要其包含的子元素可哈希,元组自身就具备完整的哈希能力,因此“列表转元组”是处理嵌套列表最直接的数学映射。
1. 仅要求去重、不要求保留原始顺序
如果下游业务逻辑对列表中元素的相对排列次序没有任何依赖,可以利用列表推导式配合 set() 完成两道转换:先将内层列表批量转换为元组进行集合去重,再将去重后的元组还原为内层列表。
raw_matrix = [[1, 2], [3, 4], [1, 2], [5, 6], [3, 4]]

# 转换内层列表为元组后放入 set,随后转回 list
deduped_unordered = [list(item) for item in set(map(tuple, raw_matrix))]
print(deduped_unordered)
这种写法代码紧凑,但在经过集合散列重组后,原列表中 [5, 6] 与 [3, 4] 的先后次序可能发生逆转。在绝大多数真实业务处理链路(如按时间排序的数据流、带权重的配置表)中,丢失原有次序往往是不可接受的。
2. 生产推荐:保留原始相对顺序的辅助集合法
要在保留原始先后次序的同时剔除后续重复项,标准做法是维护一个名为 seen 的集合记录已出现的特征值,同时用一个新列表收集首次出现的原始列表项。
def deduplicate_nested_lists(items):
    seen = set()
    result = []
    for sublist in items:
        # 将内层列表转为元组作为特征标记
        marker = tuple(sublist)
        if marker not in seen:
            seen.add(marker)
            result.append(sublist)
    return result

raw_matrix = [[10, 20], [30, 40], [10, 20], [50, 60], [30, 40]]
deduped_ordered = deduplicate_nested_lists(raw_matrix)
print("保序去重结果:", deduped_ordered)[1, [2, 3]]),单纯调用 tuple(sublist) 会得到包含内层列表的元组,该元组仍然包含可变对象,计算哈希时依然会报错。针对深层嵌套场景,需要编写递归函数将各层级的列表彻底“冻结”为元组:
def deep_to_tuple(item):
    if isinstance(item, list):
        return tuple(deep_to_tuple(x) for x in item)
    return item

deep_list = [[1, [2, 3]], [4, 5], [1, [2, 3]]]
seen = set()
deep_deduped = []
for elem in deep_list:
    key = deep_to_tuple(elem)
    if key not in seen:
        seen.add(key)
        deep_deduped.append(elem)

print("深度嵌套保序去重结果:", deep_deduped)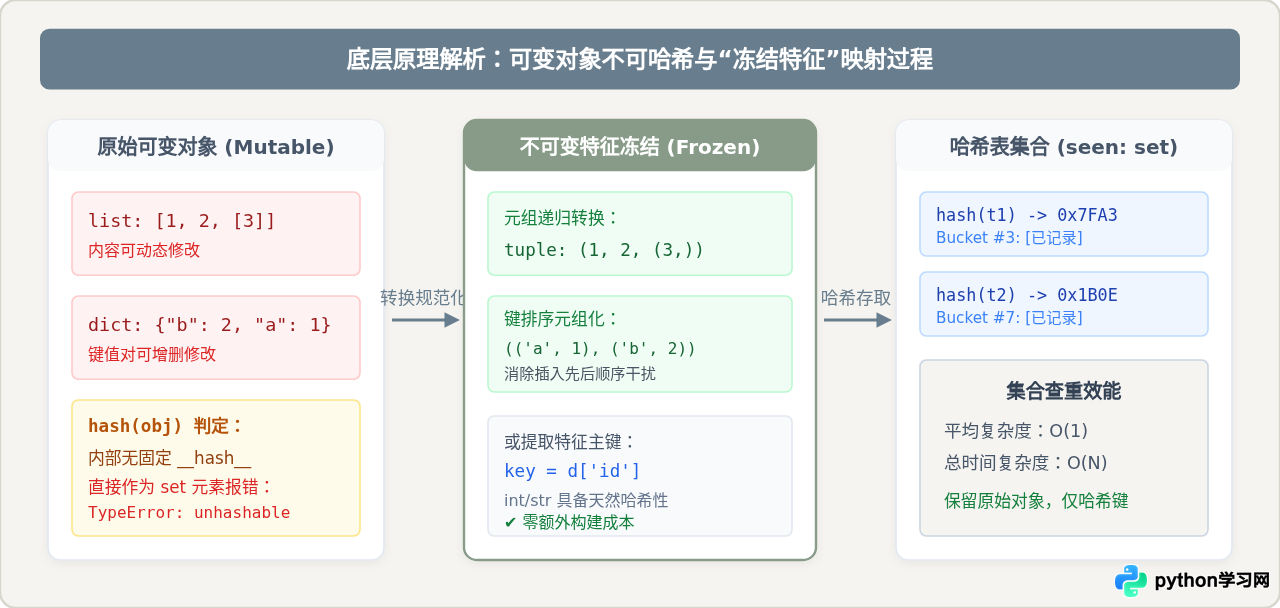
三、包含字典(List of Dicts)的去重方法
在后端接口响应、数据库批量查询或日志解析中,最常见的数据结构即为字典列表。对字典列表去重,首先需要明确业务上的“重复”定义:是某个业务主键重复,还是所有键值对全量相同才算重复。
1. 按指定业务主键(单个或联合主键)去重
在大部分实际开发中,字典都包含具有唯一性标识的字段,如 id、order_no 或 uuid。此时只需提取该字段的值放入 seen 集合即可,无需比对字典的全部字段,性能最为优异。
users = [
    {{"id": 101, "name": "张三", "dept": "研发部"}},
    {{"id": 102, "name": "李四", "dept": "市场部"}},
    {{"id": 101, "name": "张三", "dept": "技术支持"}},  # id重复
    {{"id": 103, "name": "王五", "dept": "人事部"}}
]

def dedupe_dicts_by_key(dict_list, key_name):
    seen = set()
    unique_list = []
    for item in dict_list:
        val = item[key_name]
        if val not in seen:
            seen.add(val)
            unique_list.append(item)
    return unique_list

result = dedupe_dicts_by_key(users, "id")
print("按单一主键去重后结果:")
for u in result:
    print(u)
若去重条件依赖多个联合字段(如同时校验 tenant_id 与 user_id),只需将多个字段组合为元组放入 seen 集合,例如 key = (item["tenant_id"], item["user_id"])。
2. 按字典全量内容(全字段)去重
如果字典没有固定的唯一主键,必须每个键与对应的值完全一致才算重复,则需要将整个字典转为可哈希对象。
这里有一个关键陷阱:虽然 Python 3.7+ 字典保证了插入顺序,但在数据来源不同时,两个逻辑上内容完全相等的字典,其内部键的顺序可能并不一致。例如:
d1 = {{"a": 1, "b": 2}}
d2 = {{"b": 2, "a": 1}}
print("字典逻辑相等性:", d1 == d2)
print("直接items转元组:", tuple(d1.items()) == tuple(d2.items()))为了规避键顺序差异造成的假性不重复,必须对键值对进行排序规范化。
records = [
    {{"code": 200, "msg": "ok", "tag": "prod"}},
    {{"tag": "prod", "code": 200, "msg": "ok"}},  # 键顺序不同,但内容一致
    {{"code": 404, "msg": "not found", "tag": "prod"}},
    {{"code": 200, "msg": "ok", "tag": "prod"}}   # 完全重复
]

seen = set()
deduped_records = []

for item in records:
    # 使用 sorted 确保键值对按固定字典序排列,构成不可变元组
    canonical_repr = tuple(sorted(item.items()))
    if canonical_repr not in seen:
        seen.add(canonical_repr)
        deduped_records.append(item)

print(f"全量去重后保留项数: {{len(deduped_records)}}")
for r in deduped_records:
    print(r)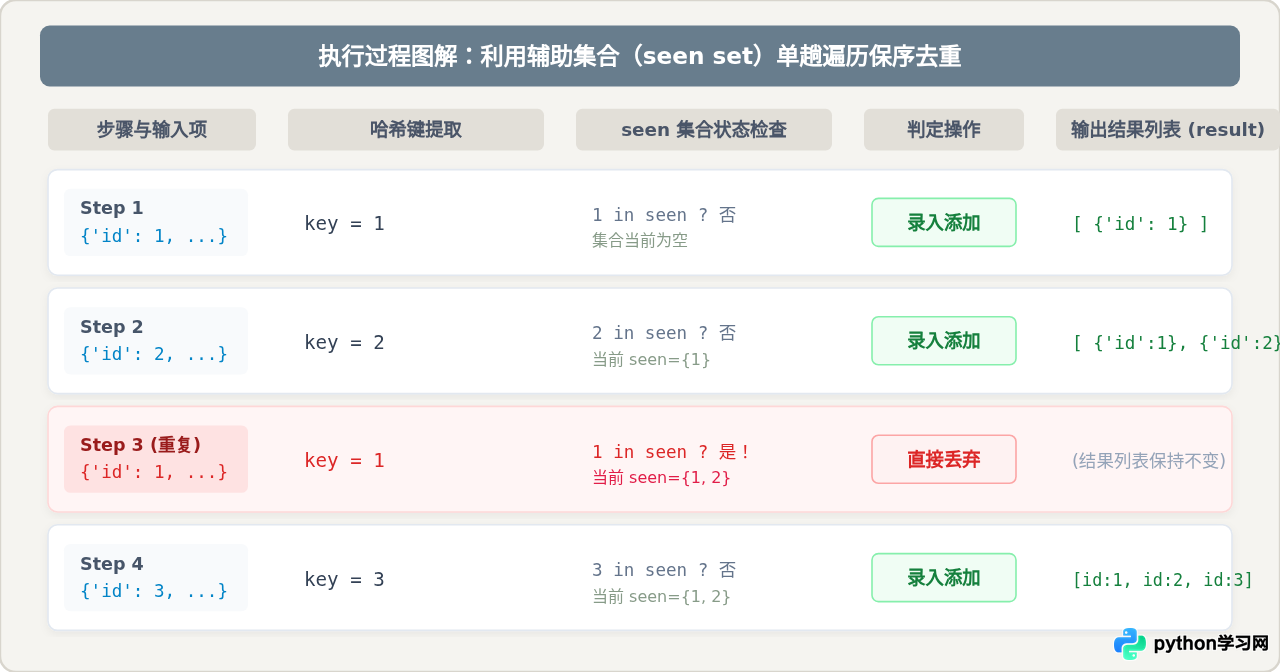
四、两类典型实现的关键差异与性能权衡
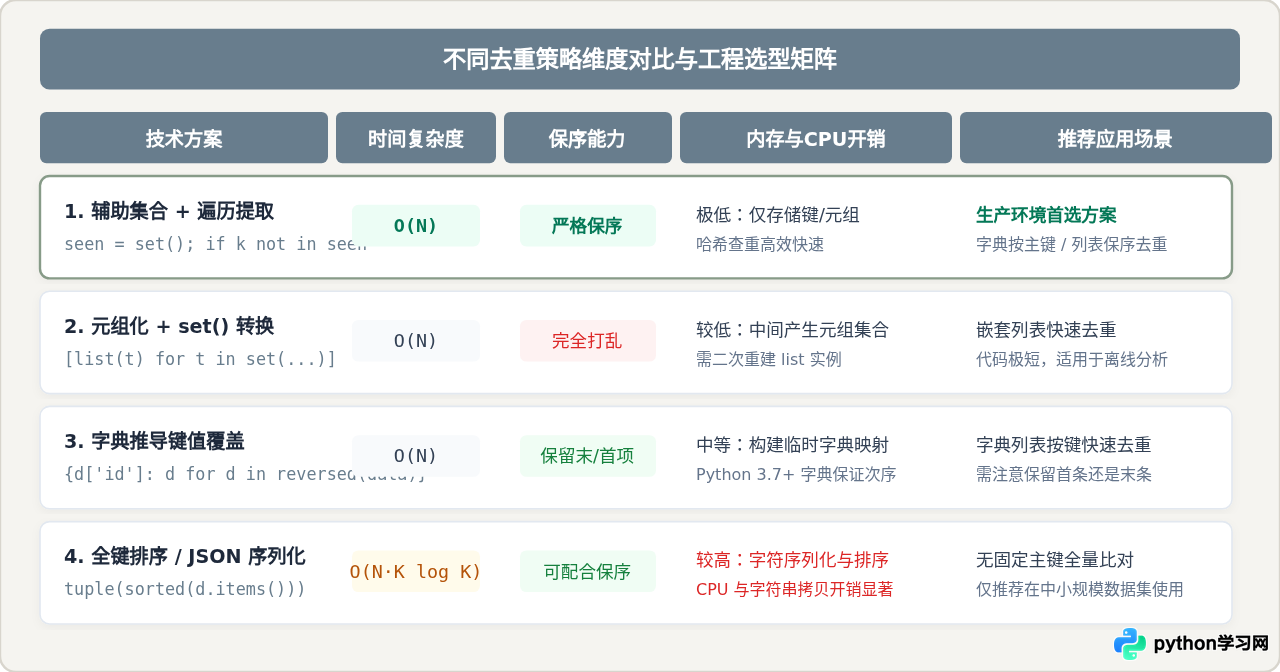
在解决复杂列表去重时,开发者常在两类具体做法之间权衡:一类是仅提取关键字段进行轻量级哈希过滤,另一类是将整项数据序列化/规范化后进行全量哈希过滤。在相同数据规模(如 100,000 条字典数据)下,两者的执行特征和系统影响存在显著差异:
| 比对维度 | 按指定主键提取过滤 (Key-based) | 全量键值排序元组化 (Canonical Tuple) |
|---|---|---|
| 时间复杂度 | 严格的 O(N),常数极小 |
O(N · K log K),K 为字典键数量 |
| 临时内存开销 | 低:集合中仅保存基础类型标量(如整数 ID) | 高:每次循环产生大量中间元组与排序列表 |
| CPU 负载表现 | 极低,主要耗时在字典字段查找与哈希查询 | 较高,大量耗费在字符串比对与多次排序运算上 |
| 适用判定依据 | 业务语义明确,具备天然唯一标识列 | 无固定 Schema,无唯一主键,必须严格全字段一致 |
这种差异的重要影响在于:如果开发人员在具备明确主键(如 ID)的场景下,为了省事而滥用全量排序元组化或 JSON 序列化(json.dumps(d, sort_keys=True)),随着数据规模增大,CPU 密集型的排序和字符串拷贝会成为整个数据流的处理瓶颈。因此在工程落地时,优先明确业务唯一标识,首选轻量主键提取去重。
五、常见问题排查与注意事项
-
慎用推导式中的副作用代码:网络上常有流传一行代码实现保序去重的方式,如
[x for x in data if not (key in seen or seen.add(key))]。利用seen.add()返回None这一特性虽然语法合法,但在代码审查、调试和后期维护中极不友好,甚至容易引起新人误读,在规范工程中应优先使用显式的for循环或标准生成器函数。 -
字典的值中嵌套了列表怎么处理?如果采用全量去重,而字典的值本身又是列表,直接执行
tuple(sorted(d.items()))仍会触发异常。此时可以引入标准库模块json.dumps(d, sort_keys=True)将其序列化为规范 JSON 字符串存入seen集合,或者编写递归深层元组转换函数。 - 超大规模数据集的流式处理:对于内存敏感或来自大型文件的数据流,无需一次性将所有数据加载到内存列表中,可将保序去重逻辑封装为生成器(Generator):
def deduplicate_stream(generator_source, key_func):
    seen = set()
    for record in generator_source:
        k = key_func(record)
        if k not in seen:
            seen.add(k)
            yield record

# 示例:流式消费并去重
def mock_data_stream():
    yield {{"id": 1, "value": "A"}}
    yield {{"id": 2, "value": "B"}}
    yield {{"id": 1, "value": "A (重复)"}}

stream_result = list(deduplicate_stream(mock_data_stream(), lambda x: x["id"]))
print(stream_result)掌握以上方法后,在面对含不可哈希对象的复合列表时,便能准确识别异常本质,根据数据结构特性与保序要求选用最稳健、高效的去重策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















