


怎么判断一个对象是Python序列?isinstance与collections.abc用法
深入讲解在 Python 中如何准确判断一个对象是否为序列类型。详细介绍 isinstance 与 collections.abc.Sequence 及 MutableSequence 的标准用法、底层协议、字符串避坑技巧与方案横向对比。
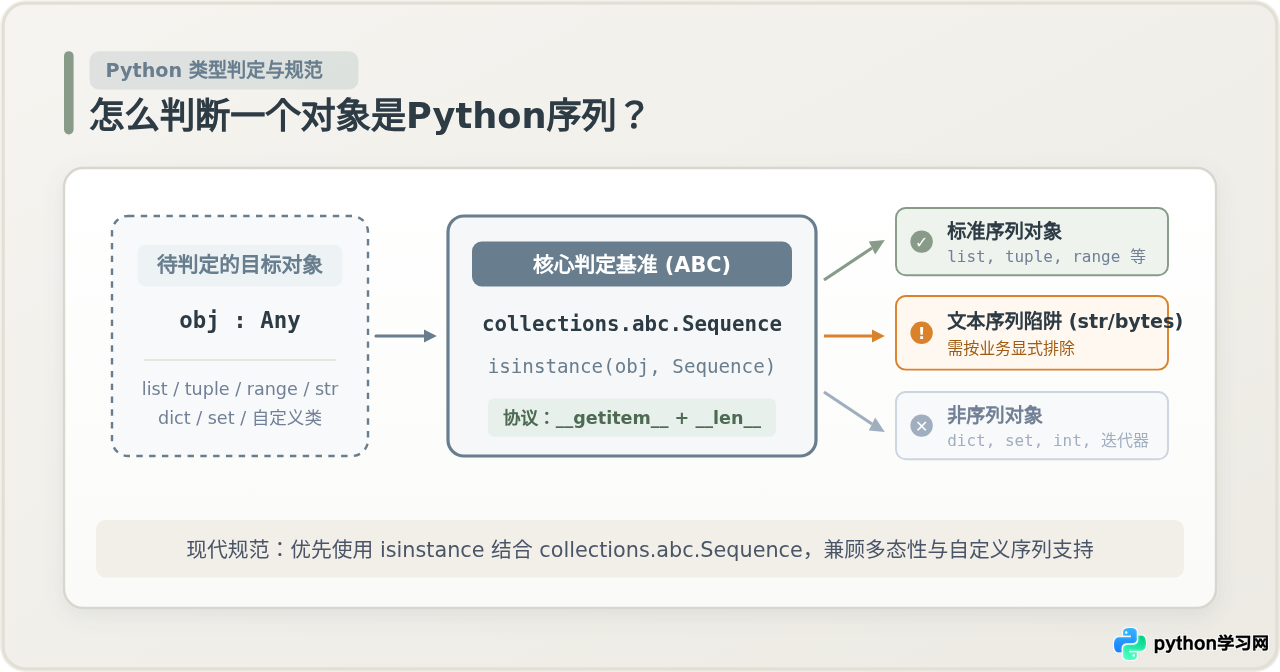
在 Python 中判断一个对象是否为序列,最规范、稳健的现代做法是使用 isinstance(obj, collections.abc.Sequence)。序列不仅要求元素能够被顺序迭代,还要求具备确定的长度且支持基于非负整数下标的高效随机访问与切片。本文通过具体代码与对比分析,系统讲解如何使用 collections.abc 准确完成序列判定、如何甄别只读与可变序列、如何规避字符串(str)与字节串(bytes)带来的逻辑陷阱,以及在生产级项目中如何编写健壮的类型防护代码。
一、什么是 Python 序列?它与可迭代对象有何区别
在深入具体代码之前,我们需要厘清 Python 中“序列”(Sequence)与“可迭代对象”(Iterable)及“容器”(Container)的边界。在 Python 的数据模型中:
- 可迭代对象(Iterable):只需实现
__iter__()方法,能够被for循环消费即可。例如生成器、文件句柄、字典键视图都是可迭代对象,但它们不一定能回头遍历,也不一定知道总长度。 - 序列(Sequence):比可迭代对象严格得多。它必须是有序集合,支持通过整数索引(从
0到len(s)-1)直接访问元素(实现__getitem__()),并且支持查询确定长度(实现__len__())。此外,序列还天然支持反向迭代(__reversed__())和成员测试(__contains__())。
Python 标准库中的内置序列包括:list、tuple、range、str、bytes、bytearray 以及 collections.deque 等。而像 dict 和 set,虽然属于容器并支持遍历,但集合无序且无法用下标访问,字典属于映射(Mapping),虽然字典也实现了 __getitem__,但那是基于键而非整数位置序列。
二、核心用法:isinstance 与 collections.abc.Sequence
在现代 Python 代码中,标准库模块 collections.abc 提供了丰富的抽象基类(Abstract Base Classes)。其中 Sequence 就是只读序列的最高抽象。
直接使用 isinstance(obj, Sequence) 可以让 Python 运行时根据抽象基类的协议校验对象的类型身份。
from collections.abc import Sequence

# 测试不同类型的对象
data_list = [10, 20, 30]
data_tuple = (1, 2, 3)
data_range = range(5)
data_dict = {"a": 1, "b": 2}
data_set = {1, 2, 3}
number = 42

print("list 是序列:", isinstance(data_list, Sequence))
print("tuple 是序列:", isinstance(data_tuple, Sequence))
print("range 是序列:", isinstance(data_range, Sequence))
print("dict 是序列:", isinstance(data_dict, Sequence))
print("set 是序列:", isinstance(data_set, Sequence))
print("int 是序列:", isinstance(number, Sequence))tuple 是序列: True
range 是序列: True
dict 是序列: False
set 是序列: False
int 是序列: False
从上述输出可以看出,Sequence 准确识别了 list、tuple 和 range,并排除了 dict、set 与标量数字。这正是抽象基类带来的强大类型识别能力。
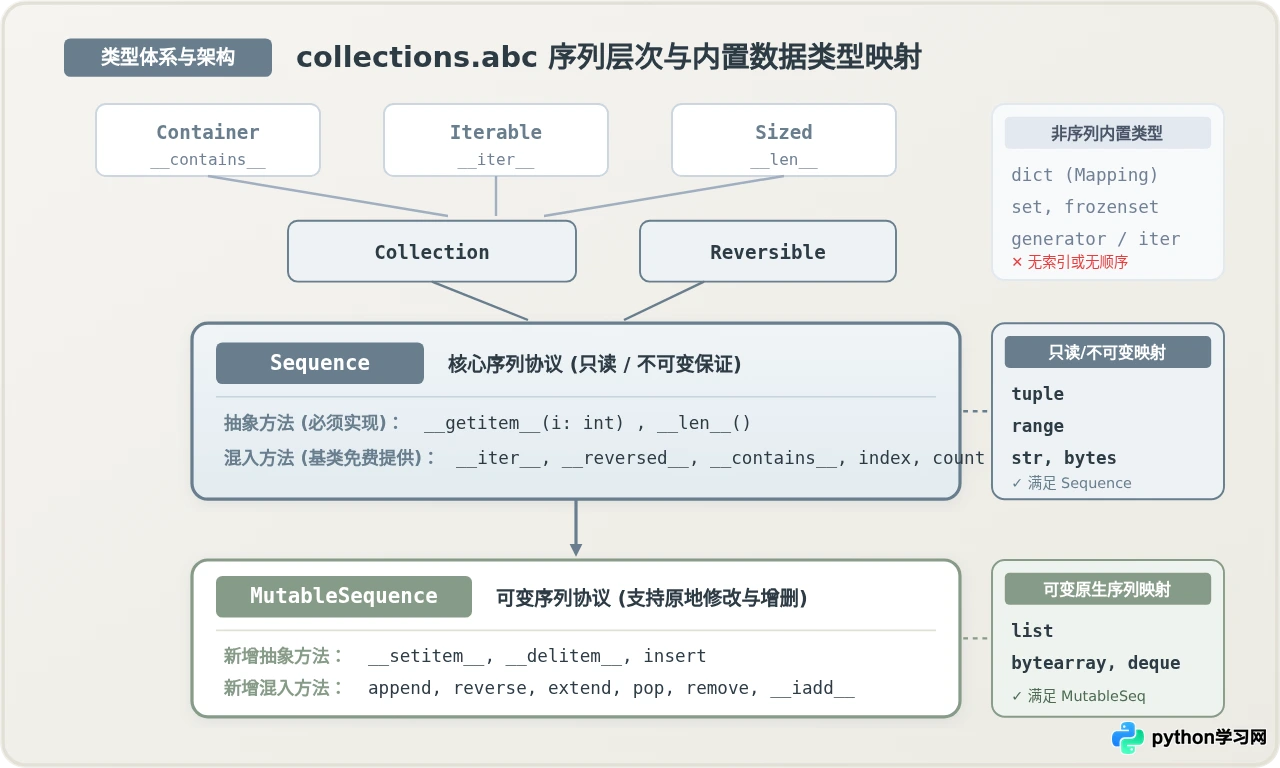
如图 2 所示,collections.abc.Sequence 继承自 Collection 与 Reversible,底层依赖 Iterable、Container 和 Sized。只要一个类继承并实现了 __getitem__ 和 __len__,基类就会自动免费提供 __iter__、__reversed__、__contains__、index 和 count 等混入方法(Mixin Methods)。
三、避坑指南:警惕字符串(str)与字节串(bytes)的误判
在日常业务开发中,最常遇到的隐蔽问题是:在 Python 中,字符串 str 和字节串 bytes 都是严谨合法的 Sequence!
请观察下面的代码执行结果:
from collections.abc import Sequence

text = "hello"
raw_bytes = b"hello"

print("str 是序列:", isinstance(text, Sequence))
print("bytes 是序列:", isinstance(raw_bytes, Sequence))bytes 是序列: True
如果你的业务函数设计是“接收一个用户 ID 列表进行批量查询”,若传入了单个字符串 "user_101",而在函数开头简单判断 if isinstance(param, Sequence):,该条件会直接成立!接下来如果对该对象进行循环,Python 会拆散出每个单字符 ['u', 's', 'e', 'r', '_', '1', '0', '1'],从而引发极难排查的逻辑灾难。
生产级安全写法:排除文本型序列
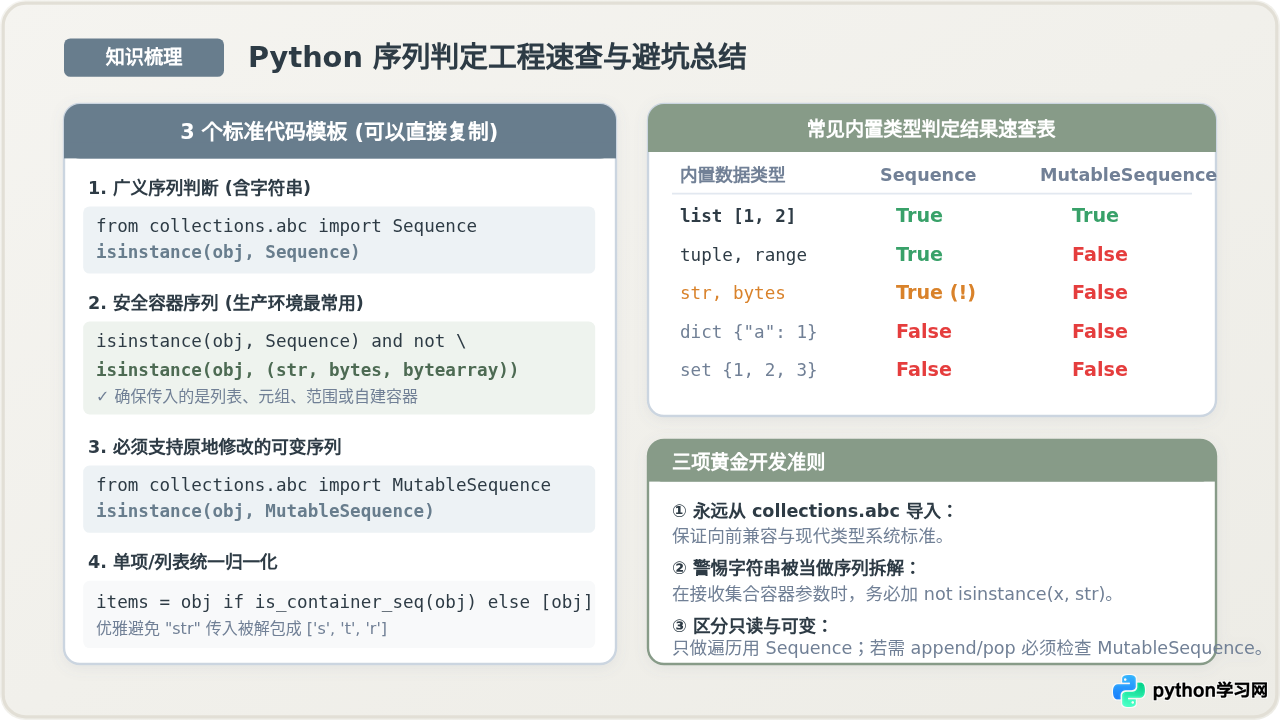
当我们在实际工程中需要判断“是否是包含多个业务元素的容器序列”时,应当在判断 Sequence 的同时显式排除 (str, bytes, bytearray):
from collections.abc import Sequence

def is_container_sequence(obj) -> bool:
    """
    判断一个对象是否是安全的容器型序列(排除文本与二进制流)
    """
    return isinstance(obj, Sequence) and not isinstance(obj, (str, bytes, bytearray))

# 验证测试
print(is_container_sequence(["apple", "banana"]))  # True (列表)
print(is_container_sequence(("apple", "banana")))  # True (元组)
print(is_container_sequence(range(10)))            # True (范围)
print(is_container_sequence("apple"))              # False (字符串被安全排除)
print(is_container_sequence(b"binary_data")) # False (字节串被安全排除)True
True
False
False
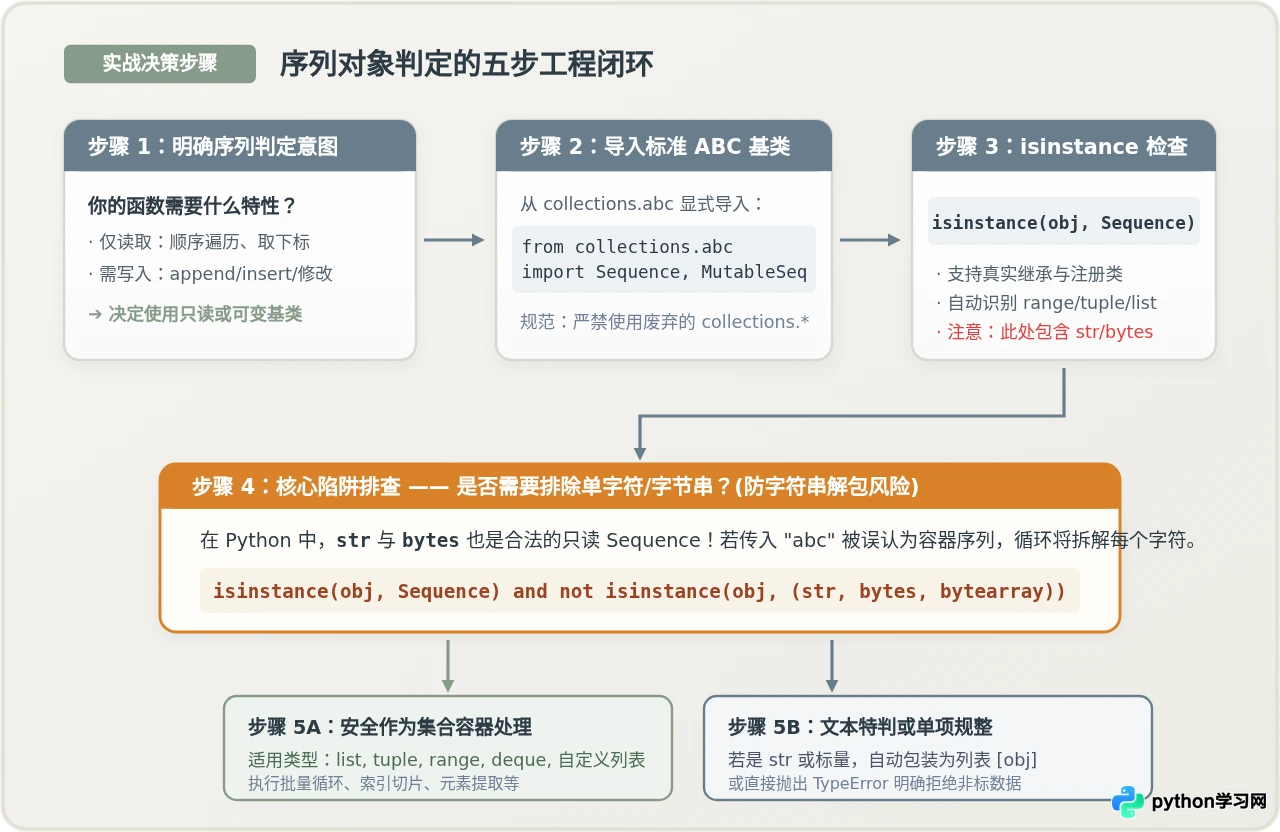
通过图 1 所示的判定流程,我们建立起标准五步闭环:从明确读写意图、导入标准抽象基类、执行判定、剔除文本序列特例,到最终安全进入批处理逻辑。
四、只读序列 vs 可变序列:Sequence 与 MutableSequence
在面向对象设计中,我们还需要区分只读序列与可变序列。
许多函数在处理序列时,不仅要按索引读取,还需要在原地追加元素(append)、插入(insert)或修改指定位置的元素(__setitem__)。此时如果传入的是 tuple 或 range,虽然它们满足 Sequence,但执行修改操作会抛出 TypeError: 'tuple' object does not support item assignment。
标准库专门提供了 collections.abc.MutableSequence 来解决这一需求:
from collections.abc import Sequence, MutableSequence

lst = [1, 2, 3]
tup = (1, 2, 3)

print("lst 是否为 Sequence:", isinstance(lst, Sequence))
print("lst 是否为 MutableSequence:", isinstance(lst, MutableSequence))

print("tup 是否为 Sequence:", isinstance(tup, Sequence))
print("tup 是否为 MutableSequence:", isinstance(tup, MutableSequence))lst 是否为 MutableSequence: True
tup 是否为 Sequence: True
tup 是否为 MutableSequence: False
| 数据类型 | 示例 | Sequence (只读序列) | MutableSequence (可变序列) | 典型操作场景 |
|---|---|---|---|---|
list |
[1, 2, 3] |
True | True | 随机访问、就地增删改 |
tuple |
(1, 2, 3) |
True | False | 不可变记录、定长只读容器 |
range |
range(10) |
True | False | 惰性等差数字序列、节省内存 |
str |
"python" |
True (特例) | False | 文本处理(容器判断需显式排除) |
dict |
{"k": "v"} |
False | False | 键值映射,非连续整数索引 |
set |
{1, 2, 3} |
False | False | 无序唯一集合,不可索引 |
五、关键差异对比:isinstance(ABC) 与其他判断策略的深度权衡
很多初学者在编写代码时习惯使用以下两种替代方案,我们在相同的基准条件下对比它们的关键差异及其对工程的影响:
1. 对比:硬编码类型判断 isinstance(obj, (list, tuple))
做法:写死 isinstance(obj, (list, tuple))。
影响分析:这种写法的最大好处是不会把 str 误判为序列。但是,它直接破坏了 Python 面向对象的多态性。它无法识别 range 对象、无法识别标准库中的 collections.deque,更无法兼容团队自定义的任何序列类或第三方库封装的数据结构(例如 ORM 查询集、NumPy 衍生列表等)。在设计通用库或底层组件时,这种写法具有极强的排他性,不推荐使用。
2. 对比:纯粹鸭子类型 hasattr(obj, '__getitem__')
做法:直接检查对象是否具备取下标方法 hasattr(obj, '__getitem__')。
影响分析:这种做法极度危险。因为 dict 字典也实现了 __getitem__(用于通过键取值)。如果单纯依靠此条件判定,字典会被当成序列放行,后续根据数字下标访问 obj[0] 时就会直接触发 KeyError: 0。同时,鸭子类型检查并未验证 __len__ 与迭代协议的完整性。
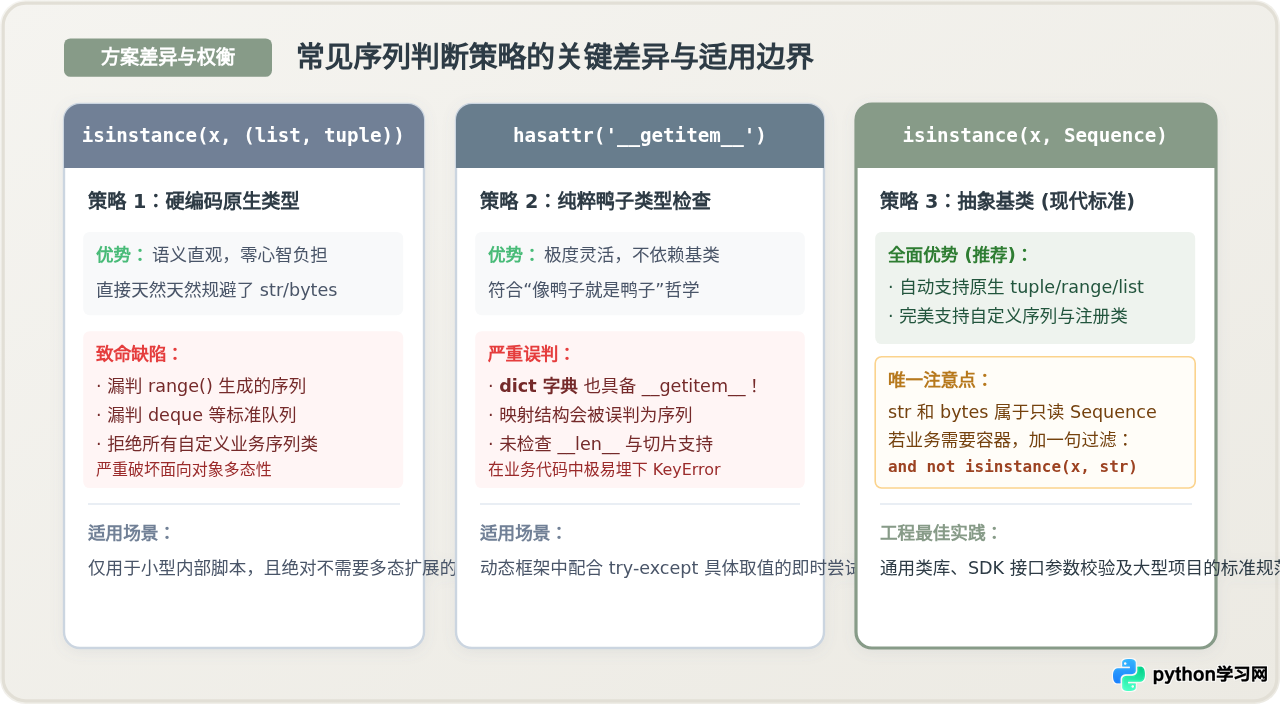
由图 3 可见,使用 isinstance(obj, collections.abc.Sequence) 是兼顾了类型完整性、多态扩展性与安全性的现代标准方案。
六、进阶扩展:自定义类如何被正确识别为序列
如果你在业务中编写了一个自定义数据容器,如何让它被 isinstance(..., Sequence) 正确识别呢?有两种标准途径:
途径一:显式继承抽象基类(推荐)
直接继承 collections.abc.Sequence,并实现抽象方法 __getitem__ 与 __len__:
from collections.abc import Sequence

class CustomRange(Sequence):
    def __init__(self, start: int, stop: int):
        self._data = list(range(start, stop))

    def __len__(self) -> int:
        return len(self._data)

    def __getitem__(self, index):
        return self._data[index]

my_seq = CustomRange(1, 5)
print("my_seq 是 Sequence 吗?", isinstance(my_seq, Sequence))
print("支持反向迭代:", list(reversed(my_seq)))
print("支持索引查询:", my_seq.index(3))支持反向迭代: [4, 3, 2, 1]
支持索引查询: 2
显式继承的巨大好处在于:只要你实现了 __getitem__ 和 __len__,基类就会自动为你注入 reversed()、in 成员测试、.index() 和 .count() 的默认实现,极大减少了重复工作量。
途径二:虚拟子类注册(Virtual Subclass)
如果类来自不可修改的三方代码库,不能直接修改其继承关系,你可以使用 register 将其动态注册为虚拟子类:
from collections.abc import Sequence

class ThirdPartyContainer:
    def __init__(self, items):
        self.items = items
    def __getitem__(self, i):
        return self.items[i]
    def __len__(self):
        return len(self.items)

# 动态注册为虚拟子类
Sequence.register(ThirdPartyContainer)

obj = ThirdPartyContainer([10, 20, 30])
print("虚拟子类判定:", isinstance(obj, Sequence))七、全文总结与速查清单
要准确判断一个对象是否属于 Python 序列,请牢记以下结论与速查清单:
- 首选标准方案:从
collections.abc导入Sequence或MutableSequence,搭配isinstance()进行判定。 - 只读 vs 可变:仅做顺序遍历与按需取值使用
Sequence;若需修改、追加或弹出元素,必须检查MutableSequence。 - 防御性编程:业务函数接收序列参数时,谨防
str和bytes被误当成容器序列解包,务必使用isinstance(x, Sequence) and not isinstance(x, (str, bytes, bytearray))。 - 摒弃过时写法:避免死板的
isinstance(x, (list, tuple))(破坏多态性),避免脆弱的hasattr(x, '__getitem__')(会把字典当序列误判)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















