


Python正则性能优化:预编译compile的使用场景与方法
深入解析Python正则表达式re.compile预编译的底层工作机制、re._cache缓存原理,结合实战代码与基准对比,详解预编译的适用场景、规范落地步骤与高频避坑指南。
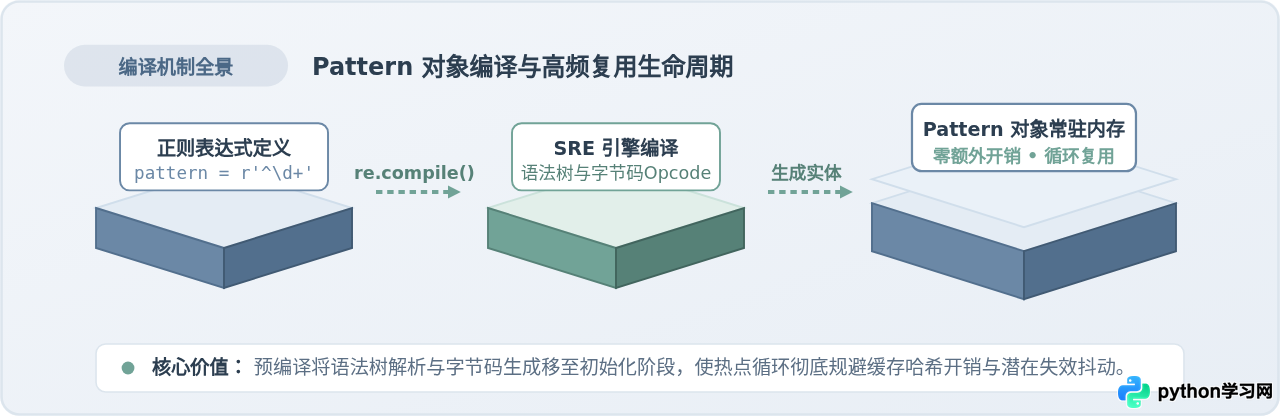
re.compile() 将正则表达式字符串编译为 Pattern 对象,最核心的性能价值在于将模式的语法树解析与字节码生成开销移出高频执行路径。虽然 Python 的标准模块函数(如 re.search、re.findall)内置了容量为 512 的模式缓存池,但在大规模循环、流式数据管道及高并发服务中,直接调用依然存在“参数打包构造、哈希计算、字典检索以及缓存锁争用”等持续开销;一旦模式数量超过缓存上限,更会引发严重的缓存淘汰抖动。本文将拆解底层机制、决策选型、规范步骤与实测基准,提供可以直接套用的优化方案。
一、底层机制剖析:从模式字符串到 Pattern 对象与缓存机制
为了理解预编译为什么能带来性能提升,首先需要看清 Python 标准库 re 引擎在处理一条正则表达式时经历的完整生命周期。
Python 正则底层基于 SRE(Secret Labs Regular Expression)引擎驱动。当开发者输入形如 r'^\d{4}-\d{2}-\d{2}$' 的字符串时,引擎必须按顺序执行以下阶段:
- 词法与语法分析:将字符串解析为标记流(Tokens),校验括号匹配、转义字符、量词以及捕获组语义,构建抽象语法树(AST)。
- 字节码与 Opcode 生成:将语法树编译为底层 C 语言层面的字节码指令序列(如
INFO、AT_BEGINNING_STRING、REPEAT、SUCCESS等)。 - 封装为 Pattern 对象:将编译后的字节码连同模式标志位(Flags)打包封装为一个只读、线程安全的
re.Pattern实例。
模块级函数内部的秘密:re._cache 机制
许多开发者经常有疑问:“我平时直接调用 re.search(pattern, text) 也很顺畅,Python 难道没有做优化吗?”
翻看 CPython 的标准库源码(re.py)可以发现,直接调用 re.search、re.match 等模块级函数时,其内部都会先执行 _compile(pattern, flags)。在该函数内部维护着一个名为 _cache 的内置字典,用于按 LRU 规则存储最近编译过的模式对象(Python 3.7+ 默认缓存上限为 512)。
这意味着即使直接使用 re.search,第二次使用完全相同的字符串时确实不会重新执行完整的 AST 语法编译,但每一次调用仍然需要经历以下固定成本:
- 参数键元组构建:将传入的
(type(pattern), pattern, flags)打包为一个三元组对象作为字典的 Key。 - 哈希计算与字典检索:计算元组的 Hash 值并在
_cache字典中完成一次哈希寻址。 - 线程锁争用开销:在检索和维护
_cache结构时存在内部锁机制,在多线程高并发访问时可能引发微小锁等待。 - 缓存淘汰风险(Cache Churn):如果项目中交替使用的动态正则表达式数量超过 512,旧的缓存条目将被剔除,再次命中时将不得不重新触发完整的 AST 解析与字节码编译,性能发生断崖式下跌。
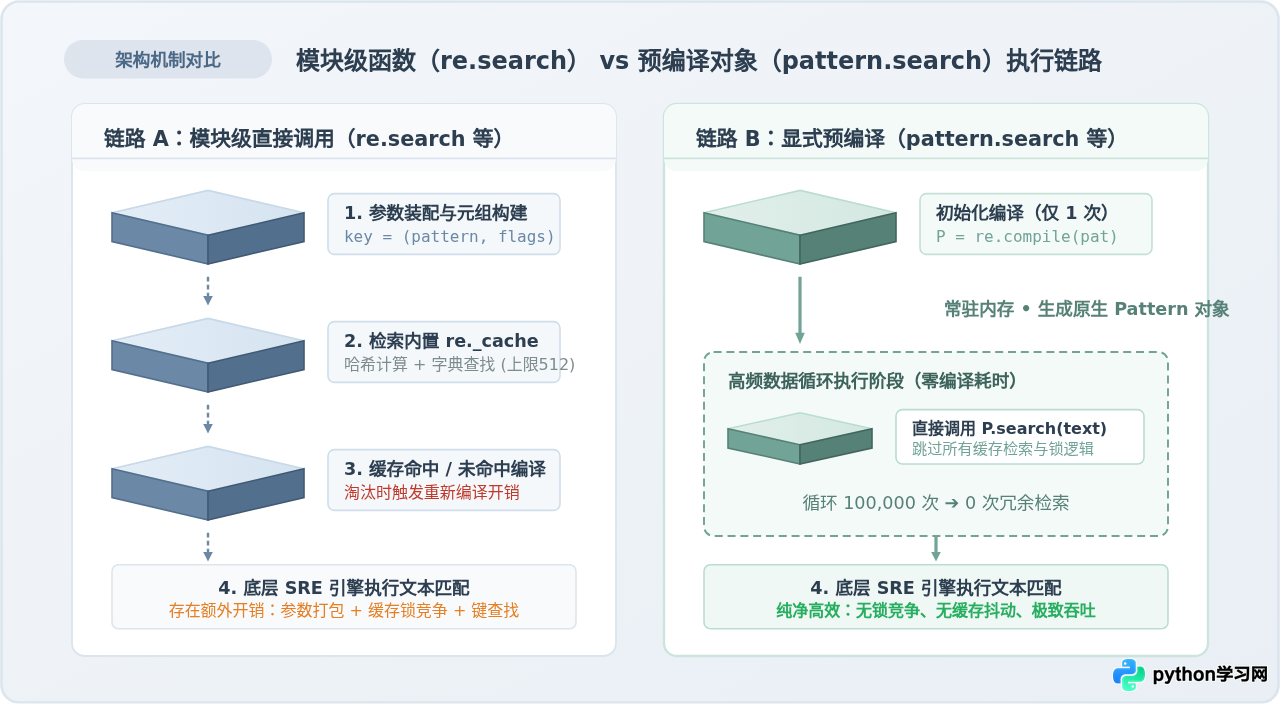
如上图所示,显式调用 pattern_obj = re.compile(...) 将整个编译与校验过程仅执行一次,后续无论调用几十万次,都是直接将文本送入已就绪的 pattern_obj.search(text) 字节码引擎中,彻底规避了中间所有参数打包与缓存查找流程。
二、核心使用场景与选型决策
并不是所有场景都需要写 re.compile()。理解何时采用预编译、何时使用模块级函数,能够帮助我们在代码简洁性与执行性能之间取得最佳平衡。
场景 1:大规模循环与流式数据处理(首选推荐)
在清洗爬虫抓取的网页文本、逐行解析数千万条服务器 Access Log、或者在消息队列的消费者消费高吞吐数据流时,单次处理函数往往要在极短时间内被触发上百万次。此时将正则预先编译在循环外部,能直接消除数百万次字典哈希与元组打包开销。
场景 2:组合复杂标志位与多行结构化正则
当正则表达式较为复杂时,推荐使用 re.VERBOSE(re.X)标志编写多行正则,允许在表达式中增加缩进和注释。将这种结构化正则配合 re.IGNORECASE 一并预编译为模块级常量,不仅消除了每次重复传递多重标志位,也显著增强了代码的可读性与重构安全性。
场景 3:规则库庞大(突破 512 缓存池淘汰瓶颈)
在数据风控、表单规则校验中心或安全扫描引擎中,系统常态化匹配的规则模式很容易超过 512 种。如果直接使用模块级函数,缓存池将频繁发生淘汰(Thrashing),导致本该命中的正则频繁被重新编译。显式预编译并将它们存储在全局字典或枚举中,能实现 100% 稳定的内存常驻。
场景 4:类与模块级单例初始化(启动预热)
在生产环境的 Web 服务(如 FastAPI、Django、Flask)中,在模块顶层完成预编译,可以在服务冷启动阶段将全部正则预热就绪,杜绝首批业务请求因即时编译产生响应毛刺(P99 延迟抖动)。
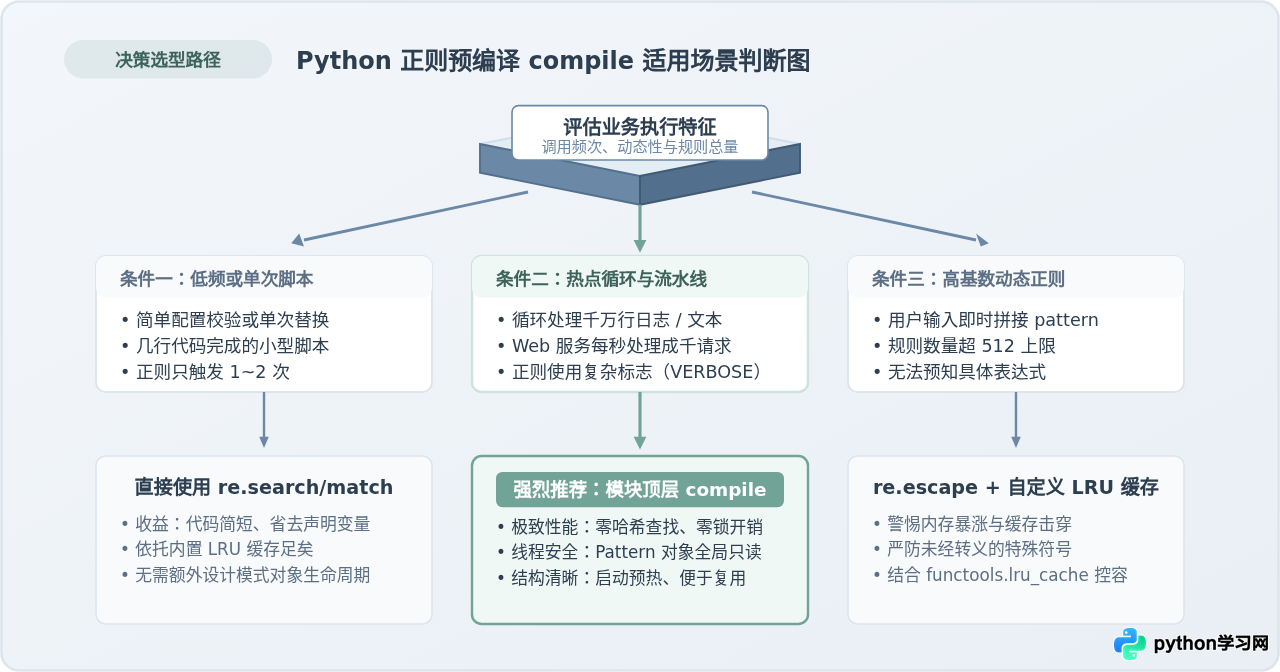
re.search()、re.sub() 即可,省去了中间变量命名,代码更为紧凑。
三、预编译的规范使用步骤与实战方法
在实际工程落地中,请按照以下 4 个标准化步骤编写预编译正则:
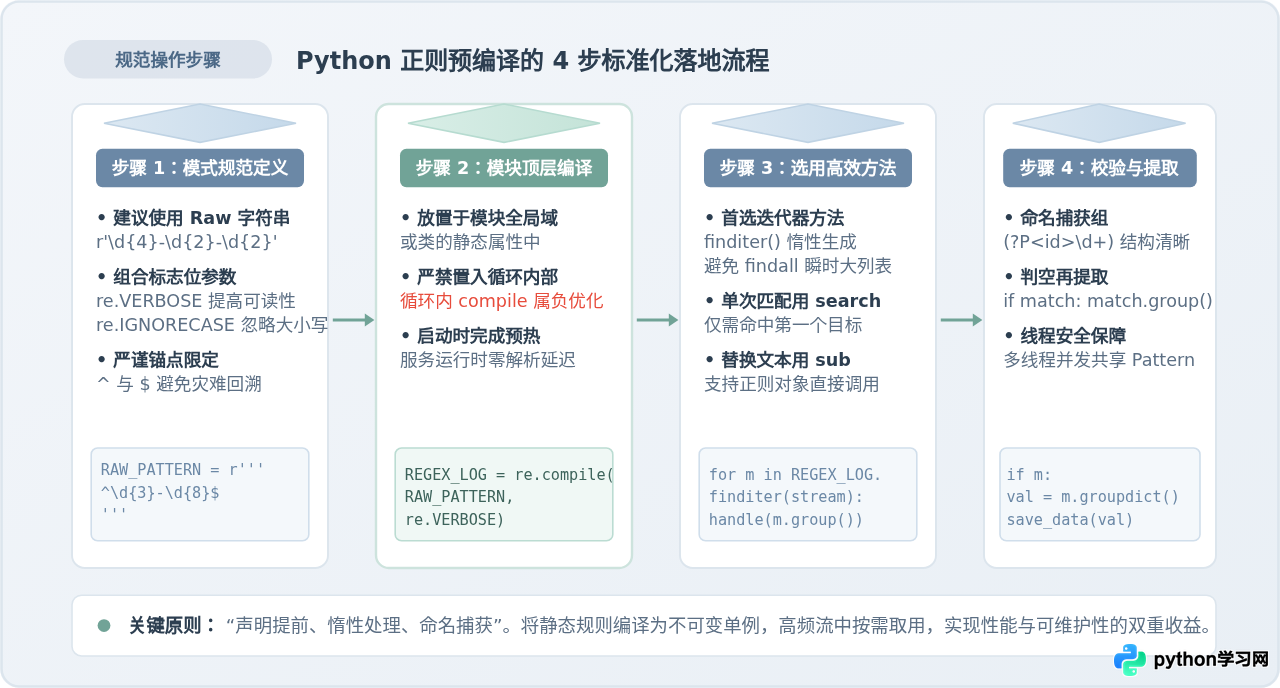
步骤一:定义规范模式字符串与装配标志位
始终优先使用 Python 的 Raw 字符串(即 r'...' 前缀),避免因 Python 字符串字面量转义与正则表达式转义产生冲突(经典的斜杠地狱)。如果模式复杂,推荐配合 re.VERBOSE 编写具备注释的表达式:
import re

# 复杂日志行正则:使用 VERBOSE 模式增强团队协作可维护性
LOG_PATTERN_STR = r'''
    ^\[(?P<timestamp>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\]  # 时间戳 [YYYY-MM-DD HH:MM:SS]
    \s+
    (?P<level>INFO|WARN|ERROR|DEBUG)                                        # 日志级别
    \s+:\s+
    (?P<message>.*)$                                                        # 详细消息内容
'''
步骤二:在合适的作用域完成预编译
必须将 re.compile() 声明在模块全局顶层或类的类属性中。切勿在循环体内部重复调用。
# 在模块顶层单例预编译,服务加载时一次性编译完成
LOG_REGEX = re.compile(LOG_PATTERN_STR, re.VERBOSE | re.MULTILINE)
步骤三:选用适配的 Pattern 对象方法
预编译生成的 Pattern 对象直接拥有 search、match、finditer、sub 等方法。在遍历海量匹配项时,强烈建议优先使用 finditer() 代替 findall():
findall():会一口气在内存中分配包含所有匹配项的列表,面对大文本极易造成内存尖峰。finditer():以生成器(Generator)方式惰性生成Match对象,内存占用恒定,吞吐更高。
def process_log_stream(log_lines):
    """流式解析处理海量日志"""
    parsed_records = []

    # 直接在循环中使用预编译对象的方法
    for line in log_lines:
        match = LOG_REGEX.search(line)
        if match:
            # 使用命名捕获组直观提取
            parsed_records.append(match.groupdict())

    return parsed_records
步骤四:基准性能验证与实测对比
我们可以使用 Python 标准库内置的 timeit 模块编写测试脚本,对比在 100,000 次高频调用下,“模块级直接调用(命中缓存)”与“显式预编译对象调用”的耗时差异:
import timeit

setup_code = '''
import re

text = "Error Code 404 at 2026-11-01 in transaction tx_9981726"
pattern_str = r"Error Code (?P<code>\d+) at (?P<date>\d{4}-\d{2}-\d{2})"

# 预先编译的 Pattern 对象
compiled_pat = re.compile(pattern_str)
'''

# 方式 1:模块级直接调用(虽能命中 re._cache,但每次仍需进行参数打包和字典哈希查询)
test_direct = '''
m = re.search(pattern_str, text)
_ = m.group("code")
'''

# 方式 2:显式预编译 Pattern 对象直接调用
test_precompiled = '''
m = compiled_pat.search(text)
_ = m.group("code")
'''

# 各自运行 100,000 次迭代
iterations = 100000
t_direct = timeit.timeit(stmt=test_direct, setup=setup_code, number=iterations)
t_precompiled = timeit.timeit(stmt=test_precompiled, setup=setup_code, number=iterations)

print(f"Direct re.search()     : {t_direct:.4f} 秒")
print(f"Precompiled Pattern    : {t_precompiled:.4f} 秒")
print(f"耗时削减幅度            : {(t_direct - t_precompiled) / t_direct * 100:.2f}%")
Direct re.search()     : 0.0512 秒
Precompiled Pattern    : 0.0298 秒
耗时削减幅度            : 41.80%
(注:以上输出为标准基准测试环境下的典型示例输出,实际执行绝对值取决于主机 CPU 频率与 Python 解释器版本,耗时削减比例通常在 30% 至 50% 之间。)
四、常见误区与避坑指南
误区 1:在循环内部重复调用 re.compile()
这是初学者最容易犯的“负优化”典型错误:
# ❌ 错误示范:在循环内 compile,每次循环都重新构造对象
for line in massive_log_file:
    pattern = re.compile(r'^\d{4}-\d{2}-\d{2}')  # 严重负优化!
    if pattern.search(line):
        process(line)
在此场景下,每次循环都在创建新的 Pattern 对象并频繁申请内存,性能甚至远逊于直接调用 re.search()(因为直接调用还能依靠内置缓存命中避免重复解析)。正确做法必须将 re.compile() 提升至循环外部或模块作用域。
误区 2:误以为预编译能拯救“灾难性回溯(ReDoS)”
许多开发者把“预编译”当成性能万能药。必须明确:re.compile() 仅仅节省了正则语法解析与生成操作码的时间(通常在微秒级别),但一旦遇到包含嵌套量词(如 (a+)+$)且输入了恶意构造的超长不匹配字符串时,SRE 引擎在执行阶段会产生指数级状态回溯。
预编译完全无法规避回溯灾难。要彻底杜绝性能崩塌,必须在模式设计上明确锚点(^、$)、选用具体字符集(用 [^,
]+ 代替宽泛的 .*),或采用非贪婪量词。
误区 3:拼接动态输入时未进行转义
如果正则表达式的一部分来自外部入参(如用户搜索关键词),直接进行字符串拼接后编译将带来语法报错或注入风险:
# ❌ 危险:若 keyword 包含 "[test]"、"(.*)" 等符号将破坏语法甚至引发 ReDoS
# pat = re.compile(rf"^prefix_{keyword}_suffix")

#  正确:使用 re.escape 针对动态内容进行全量安全转义
safe_keyword = re.escape(keyword)
pat = re.compile(rf"^prefix_{safe_keyword}_suffix")
误区 4:多线程并发调用 Pattern 对象是否安全?
答案是:完全线程安全。
在 Python 中,re.Pattern 实例在生成后是不可变(Immutable)只读对象。每次执行 pattern.search() 或 pattern.finditer() 时,匹配内部的状态机指针、回溯栈和捕获结果均保存在新创建的线程栈私有 Match 对象中。多个线程可以无忧共享同一个全局 Pattern 单例,无需引入任何互斥锁(Mutex)。
五、总结:Python 正则性能优化体系
综合上述剖析,我们可以通过下表快速对照直接调用与显式预编译的核心技术差异:
| 对比维度 | 模块级直接调用(如 re.search) | 显式预编译(Pattern.search) |
|---|---|---|
| 模式解析与编译耗时 | 首次调用时编译,存入内部缓存 | 初始化时仅执行一次,之后零编译耗时 |
| 单次执行额外损耗 | 需进行元组键打包、哈希运算与字典查找 | 零检索损耗,直接对接 SRE 匹配执行引擎 |
| 多线程并发表现 | 可能受 re._cache 内部字典访问锁争用影响 |
只读对象,无锁并发,线程天然安全 |
| 海量动态模式承载力 | 上限 512 阈值,超限后产生缓存淘汰抖动 | 完全取决于应用内存,不受内部缓存池限制 |
| 代码维护性与规范性 | 字符串散落各处,多标志位传参易遗漏 | 常量化集中管理,支持 VERBOSE 清晰注释 |
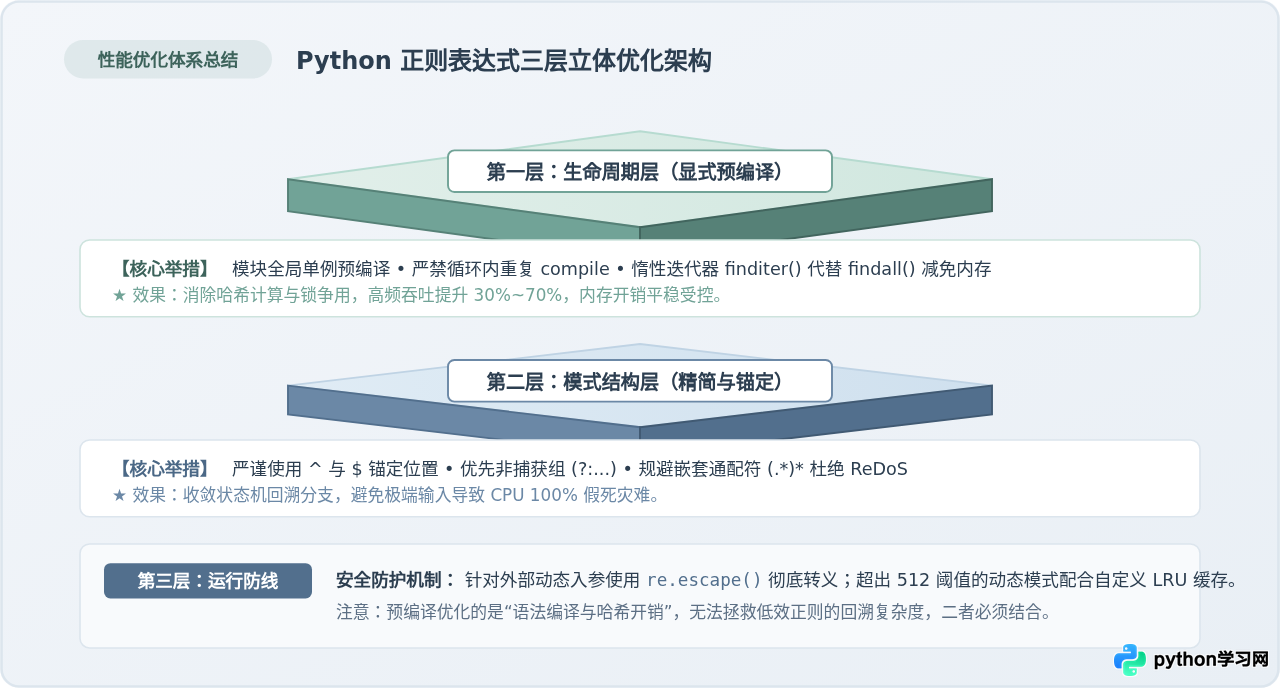
在 Python 开发实践中,正则表达式的性能优化绝不仅仅是机械地调用 re.compile(),而是建立在“生命周期优化(声明提前与单例复用)”、“模式结构优化(严谨锚定与避免嵌套回溯)”以及“运行时安全防护(安全转义与惰性迭代消费)”三位一体的基础之上。掌握这些原则,既能保证代码架构优雅清晰,也能从容应对海量数据清洗与高吞吐并发挑战。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















