


Python自动化在个人生活中的应用:抢票、社交互动与图片处理
系统讲解如何利用Python自动化解决个人生活中的高频重复痛点,深度剖析票务抢购、社交通知枢纽搭建与本地图片批量处理的具体实现、代码规范与风险控制边界。
一、票务预约与抢票自动化:机制、流转与反风控
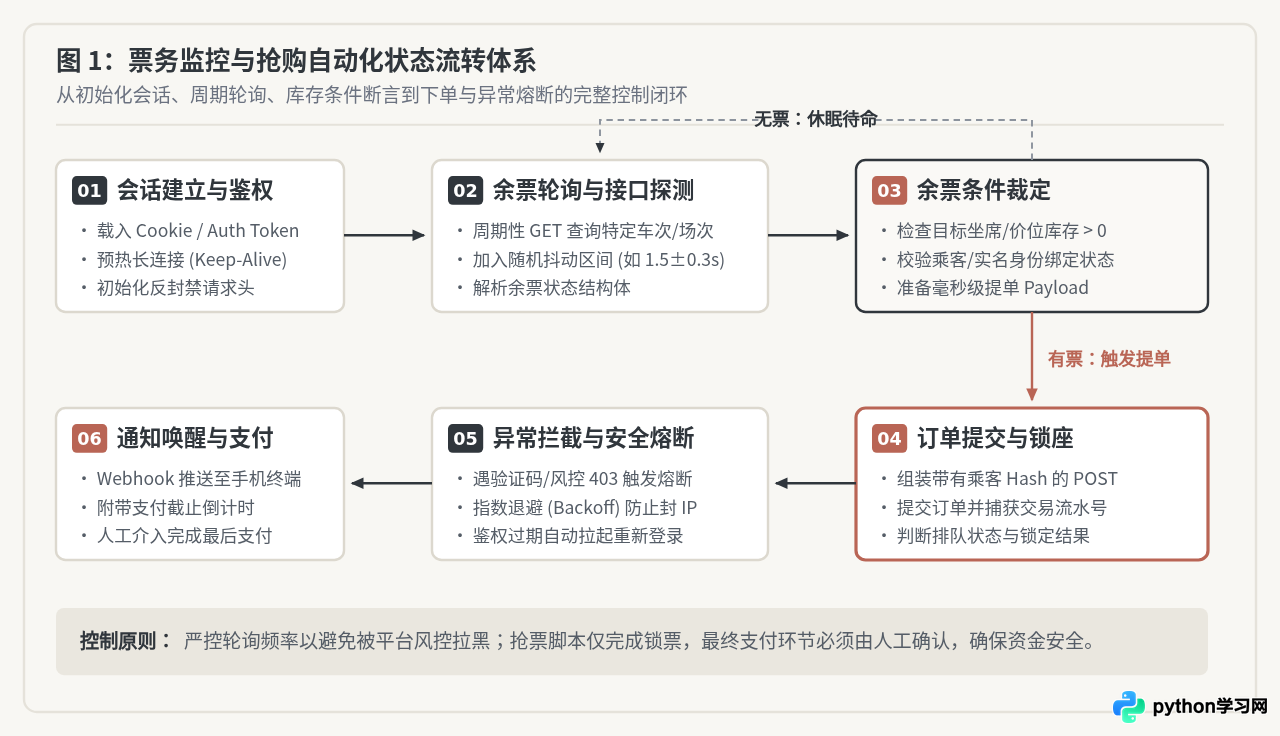
生活中的火车票、演唱会、医院专家号及热门展馆门票预约,本质上是客户端与服务端在有限资源分配下的状态同步与高并发请求竞争。人工操作受限于肉眼刷新频率(通常 1~2 秒一次)和点击反应速度(200~400 毫秒),而 Python 脚本能够以毫秒级精度持续感知接口状态,并在余票放出的瞬间完成提单。
1. 两种实现路径的技术取舍
实现票务自动化主要存在两条技术路线:
- 基于网络接口直接交互(Requests / httpx):通过浏览器开发者工具分析订票请求的 URL、请求头与 Payload 参数,编写脚本直接向服务器发送网络数据包。这种方式网络开销极小、响应速度在数十毫秒以内,效率最高。但难点在于需要持续解析动态变化的加密 Token、会话 Cookie 以及滑块验证码。
- 基于无头浏览器模拟操作(Playwright / Selenium):通过程序驱动真实浏览器内核打开页面、填写表单并点击按钮。这种方式天然具备完整的浏览器环境指纹与 Cookie 状态,能规避许多基础风控,但在页面资源加载与 DOM 渲染上会有较大耗时。
2. 核心控制逻辑与代码实现
编写抢票脚本不能使用无脑死循环,否则会导致 IP 被平台防火墙直接封禁,甚至对公共服务造成类似拒绝服务攻击的负面影响。健全的实现必须包含:连接复用(Session)、随机抖动延迟(Jitter)与指数退避重试(Exponential Backoff)。
import time
import random
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

class TicketMonitor:
    def __init__(self, query_url: str, order_url: str, auth_token: str):
        self.query_url = query_url
        self.order_url = order_url

        # 初始化 Session 并挂载连接池与底层重试策略
        self.session = requests.Session()
        retries = Retry(total=3, backoff_factor=0.5, status_forcelist=[500, 502, 503, 504])
        self.session.mount("https://", HTTPAdapter(max_retries=retries))

        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
            "Authorization": f"Bearer {auth_token}",
            "Accept": "application/json"
        })

    def check_availability(self, target_id: str) -> bool:
        """检查特定场次/车次是否有余票"""
        try:
            response = self.session.get(self.query_url, params={"id": target_id}, timeout=3)
            if response.status_code == 200:
                data = response.json()
                # 依据服务端结构判断库存字段
                return data.get("data", {}).get("stock", 0) > 0
        except requests.RequestException:
            return False
        return False

    def submit_order(self, target_id: str, passenger_ids: list) -> bool:
        """提交订单锁定库存"""
        payload = {
            "target_id": target_id,
            "passengers": passenger_ids,
            "timestamp": int(time.time() * 1000)
        }
        try:
            res = self.session.post(self.order_url, json=payload, timeout=5)
            result = res.json()
            return result.get("code") == 0
        except requests.RequestException:
            return False

    def run(self, target_id: str, passenger_ids: list, max_retries: int = 200):
        print(f"[监控启动] 目标编号: {target_id}")
        attempts = 0
        while attempts < max_retries:
            attempts += 1
            if self.check_availability(target_id):
                print(f"[库存触发] 发现可预订资源,立即提交订单...")
                if self.submit_order(target_id, passenger_ids):
                    print("[成功锁票] 订单提交成功,请在15分钟内前往官方渠道支付!")
                    return True
                else:
                    print("[提单受阻] 资源可能被并发锁定,继续监测...")

            # 加入随机扰动时间 (1.2 ~ 2.0 秒),防止固定频率被风控识别
            sleep_sec = 1.2 + random.uniform(0.1, 0.8)
            time.sleep(sleep_sec)

        print("[监控结束] 已达到最大轮询次数。")
        return False

if __name__ == "__main__":
    # 示例运行参数
    monitor = TicketMonitor(
        query_url="https://api.example.com/v1/tickets/status",
        order_url="https://api.example.com/v1/tickets/book",
        auth_token="YOUR_TOKEN_HERE"
    )
    # monitor.run(target_id="G101_SECOND_CLASS", passenger_ids=["P001"])
二、社交互动与自动化消息管理:安全通道与通知枢纽
在个人数字生活中,我们经常需要处理多种信息:定时向特定群组发送日报、汇总天气与提醒日程、在服务器或抢票脚本发生异常时第一时间唤醒手机。然而,社交自动化的技术路径选择直接决定了账号的生命周期。
1. 技术路径剖析:逆向 Hook 个人号 vs 开放平台 Webhook
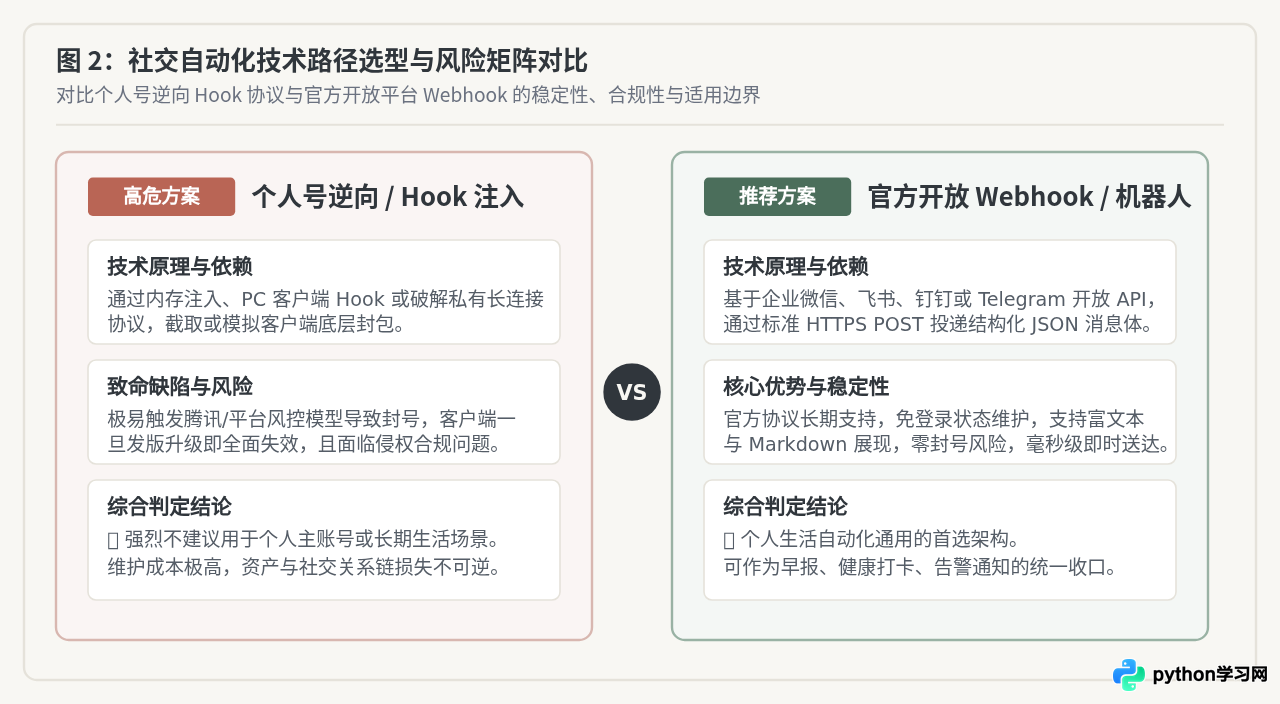
过去很多用户尝试使用基于逆向工程的工具(如基于微信 PC 客户端注入的 itchat 衍生库)来控制个人微信号。这种做法存在不可逆的致命风险:
- 风控熔断:即时通讯服务商对个人号的底层通信行为有严格的行为学检测(如消息间隔、心跳频率、内存特征检测),极易判定为外挂并实施封号。
- 协议脆弱:客户端软件每次微小的版本更新,都会导致内存偏移量与加密算法失效,维护成本极其高昂。
相比之下,利用企业微信、飞书、钉钉或 Telegram 提供的官方自定义机器人(Webhook)是个人自动化唯一的长效正道。你可以建立一个只有自己的单人工作群,通过几行代码将 Python 变成全天候待命的生活信息枢纽。
2. 通用消息网关的实现代码
以下代码展示了一个可复用的企业微信/飞书通用消息发送器,支持富文本 Markdown 格式和失败自动补偿:
import requests
import json
from typing import Dict, Any

class MessageGateway:
    def __init__(self, webhook_url: str):
        self.webhook_url = webhook_url

    def send_markdown(self, title: str, content_lines: list) -> bool:
        """向 Webhook 推送 Markdown 格式化消息卡片"""
        formatted_content = f"### {title}\n\n" + "\n".join(content_lines)

        # 以企业微信机器人标准消息协议为例
        payload = {
            "msgtype": "markdown",
            "markdown": {
                "content": formatted_content
            }
        }

        try:
            response = requests.post(
                self.webhook_url,
                headers={"Content-Type": "application/json"},
                data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
                timeout=5
            )
            res_data = response.json()
            if res_data.get("errcode") == 0 or res_data.get("code") == 0:
                return True
            else:
                print(f"[推送失败] 服务端返回: {res_data}")
                return False
        except requests.RequestException as e:
            print(f"[网络异常] 消息投递中断: {e}")
            return False

if __name__ == "__main__":
    # 配置你的个人机器人 Webhook 地址
    BOT_WEBHOOK = "https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_KEY"
    gateway = MessageGateway(BOT_WEBHOOK)

    # 模拟每日晨间生活助理推送
    gateway.send_markdown(
        title="☀️ 今日生活提醒与日程晨报",
        content_lines=[
            "> **天气情况**:晴转多云,气温 18℃~26℃,空气指数优",
            "> **待办事项**:下午 15:00 车辆年审预约",
            "> **系统状态**:票务监控服务持续稳定运行中,未见异常",
            "请注意补充水分并安排出行时间。"
        ]
    )
三、本地图片批量化处理:流水线、隐私脱敏与格式重构
智能手机和数码相机在日常生活中产生了海量的照片。常见的管理痛点包括:苹果设备默认导出的 HEIC 格式在许多 Windows 软件或网页中无法直接预览;单反照片单张体积达 30MB 以上,备份或分享极慢;拍摄照片内嵌的 EXIF 信息完整记录了拍摄时的 GPS 经纬度、相机序列号和镜头参数,在公开社交平台发布容易泄露家庭住址隐私。
1. 批处理管道的设计规范
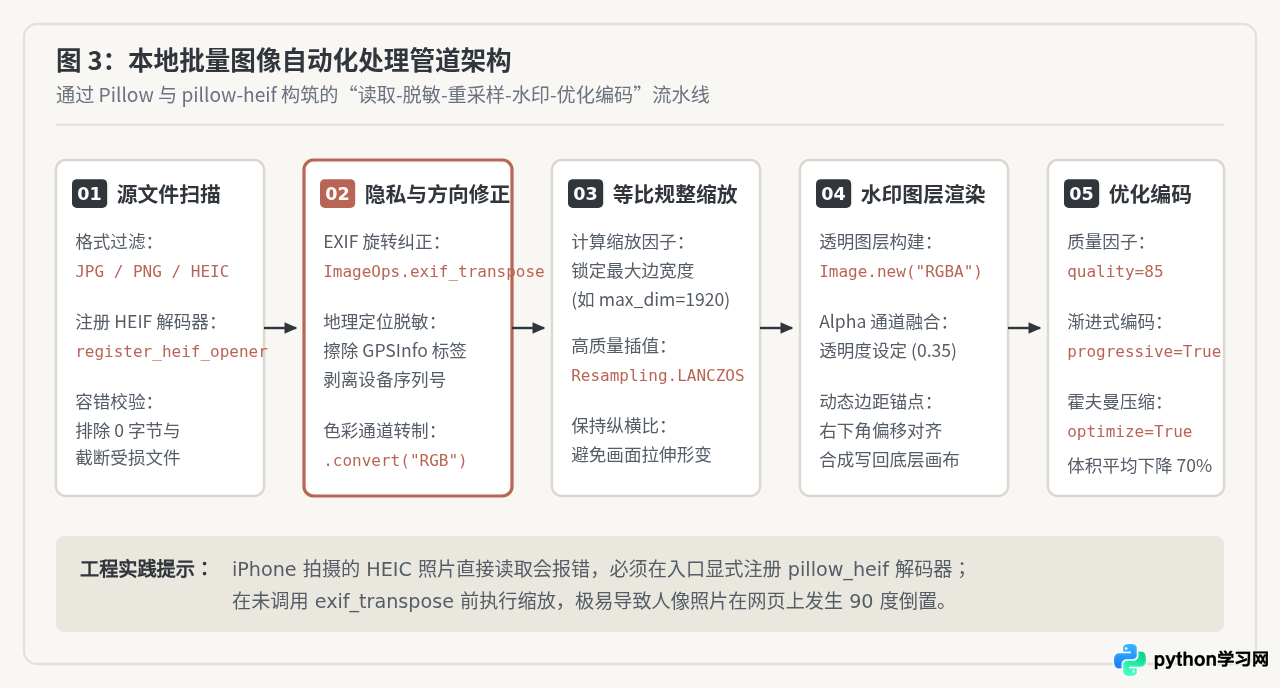
利用 Python 的 Pillow 及其生态库,我们可以构建一条自动化的照片处理管道。处理流程遵循以下顺序:
- 格式解析与兼容:显式注册
pillow_heif,让程序能够无缝解码苹果特有的 HEIC 图像容器。 - 方向校正与色彩统一:使用
ImageOps.exif_transpose校正由于重力感应记录导致的照片倒置问题,并转制为通用的 RGB 色彩空间。 - 隐私清洗:剥离原图的 EXIF 元数据,彻底阻断敏感地理位置信息。
- 等比重采样(Resampling):采用抗锯齿表现优异的
Resampling.LANCZOS算法,将超大尺寸按比例压缩至适合网页或存储的规格。 - 渐进式编码保存:设定适当的压缩质量因子(85% 左右是人眼无损与体积缩小的平衡点),开启渐进式(Progressive)传输。
2. 生产级批处理脚本实现
以下脚本能够遍历源目录,自动跳过异常损坏文件,将所有照片统一归一化为体积轻巧、隐私安全的高清 JPEG:
import os
from pathlib import Path
from PIL import Image, ImageOps

# 尝试注册 HEIF 解码器以支持 iPhone 照片
try:
    import pillow_heif
    pillow_heif.register_heif_opener()
except ImportError:
    print("[提示] 未检测到 pillow-heif,HEIC 格式支持已降级")

def process_single_image(src_path: Path, dst_dir: Path, max_dimension: int = 1920, quality: int = 85):
    """
    清洗并优化单张图片:
    1. 修正方向 2. 转 RGB 3. 等比缩放 4. 清除 EXIF 5. 压缩存储
    """
    try:
        with Image.open(src_path) as img:
            # 1. 依据 EXIF 标签自动转正图片(解决手机拍摄旋转90度问题)
            img = ImageOps.exif_transpose(img)

            # 2. 转换色彩模式,去除 Alpha 透明通道干扰
            if img.mode != "RGB":
                img = img.convert("RGB")

            # 3. 计算等比例缩放尺寸
            width, height = img.size
            if max(width, height) > max_dimension:
                scale_factor = max_dimension / float(max(width, height))
                new_size = (int(width * scale_factor), int(height * scale_factor))
                img = img.resize(new_size, Image.Resampling.LANCZOS)

            # 4. 生成目标路径(统一为 .jpg 格式)
            dst_file = dst_dir / f"{src_path.stem}_optimized.jpg"

            # 5. 保存并剔除 EXIF,开启渐进式与优化编码
            img.save(
                dst_file,
                "JPEG",
                quality=quality,
                optimize=True,
                progressive=True
            )
            return True, dst_file
    except Exception as e:
        return False, str(e)

def batch_process_photos(input_folder: str, output_folder: str):
    """批量执行文件夹图像转换管线"""
    src_dir = Path(input_folder)
    dst_dir = Path(output_folder)
    dst_dir.mkdir(parents=True, exist_ok=True)

    valid_exts = {".jpg", ".jpeg", ".png", ".heic", ".webp"}
    image_files = [f for f in src_dir.iterdir() if f.suffix.lower() in valid_exts]

    print(f"[任务启动] 扫描到 {len(image_files)} 个目标图片文件")
    success_count = 0

    for f in image_files:
        ok, res = process_single_image(f, dst_dir)
        if ok:
            success_count += 1
            print(f"[OK] {f.name} -> {res.name}")
        else:
            print(f"[FAIL] {f.name} 处理出错: {res}")

    print(f"[处理完成] 成功 {success_count} / {len(image_files)}")

if __name__ == "__main__":
    # 使用示例:将 input_photos 下的照片全部规整后输出到 output_photos
    # batch_process_photos("./input_photos", "./output_photos")
    pass
四、全景技术对比与工程落地原则
生活自动化脚本虽然服务于个人日常,但如果缺乏良好的工程设计,往往会在运行数天后由于内存泄露、凭据失效或异常断网而悄然崩溃。为了帮助读者在不同生活场景中建立清晰的技术选型标准,下表汇总了三大场景的维度对照:
| 场景领域 | 核心挑战 | 主要工具栈 | 最佳运行环境 | 维护复杂度 |
|---|---|---|---|---|
| 票务与预约 | 接口风控拦截、会话鉴权过期、高并发抢购 | requests, playwright |
低延迟云服务器 / 本地宽带 | 较高(需定期更新会话与防风控策略) |
| 社交与通知 | 账号封禁风险、消息格式规范化、长效存活 | requests, crontab, Webhook |
家用软路由 / NAS / 树莓派 | 极低(标准开放接口数年不变) |
| 图片批量处理 | 异构格式解析、色彩形变、内存与磁盘占用 | Pillow, pillow-heif |
个人电脑本地环境 | 低(纯本地计算,零外部网络依赖) |
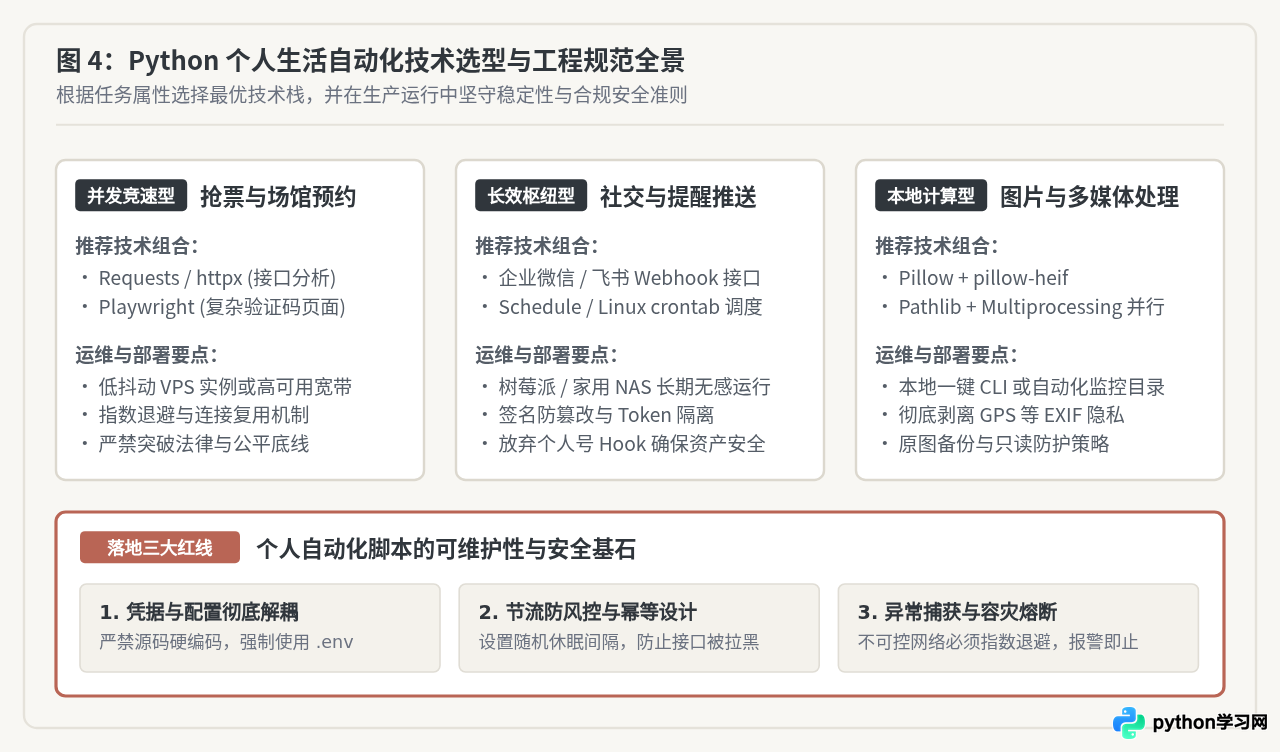
个人自动化稳健落地的三条底线
为了让自动化脚本能够安静、稳定、不惹麻烦地常年运行,必须在代码架构中贯彻以下三项基本原则:
-
配置与代码绝对解耦:绝不在代码中硬编码任何 API 密钥、账号密码或个人家庭住址。统一使用
python-dotenv读取.env环境变量文件,并将其加入.gitignore中,防止私人凭据随代码误传至公共代码托管平台。 - 恪守请求节流与网络礼仪:任何针对公网服务的查询请求,都必须设置具有随机波动的时间间隔(如 1~3 秒随机休眠)。高频狂轰滥炸不仅会迅速导致个人 IP 被拉黑,也破坏了公共网络服务的公平性。
-
防御性编码与容错熔断:外部网络调用极易出现超时、DNS 解析失败或服务返回 502 等瞬态故障。脚本必须通过
try...except捕获具体异常并执行重试逻辑;若连续报错超过阈值,应自动退出并触发消息报警,避免失控死循环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















