


Python random与secrets模块对比:为何密码学场景不应使用random
深入对比Python内置的random与secrets模块,解析梅森旋转算法(MT19937)在密码学场景下的确定性安全隐患,推导如何通过624个输出反解内部状态,并提供从random平滑迁移至secrets的完整安全实践方案。
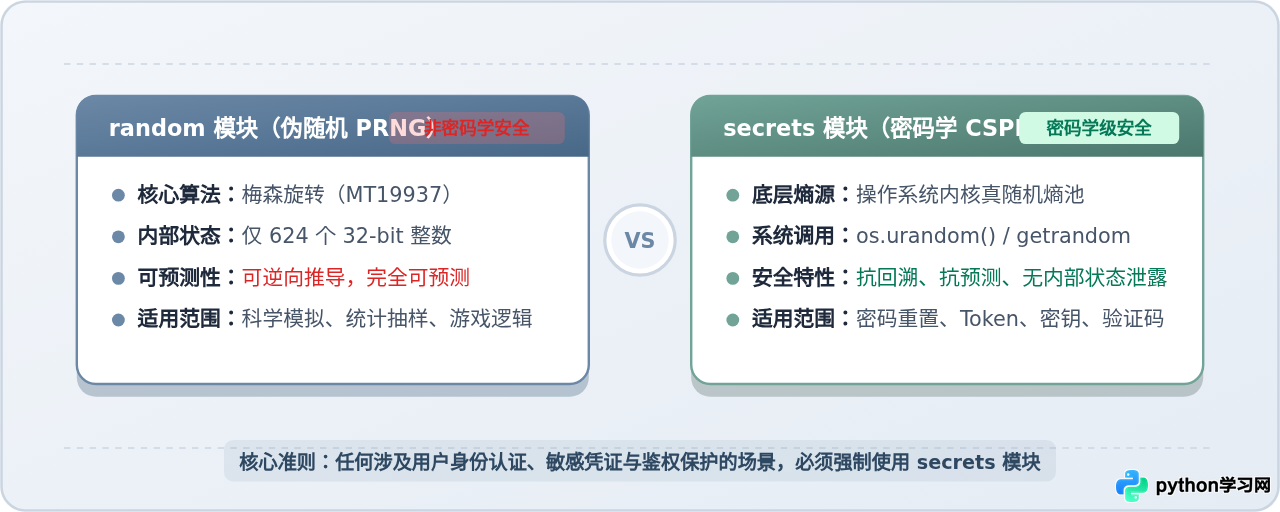
random 模块绝不能用于任何密码学、身份鉴权、敏感凭证生成或安全防护场景。其根本原因在于 random 底层采用梅森旋转算法(MT19937),该算法是纯粹面向统计均匀性设计的伪随机数生成器(PRNG),其全部内部状态仅为 624 个 32 位整数。攻击者只需拦截连续 624 个生成的 32 位随机数,即可通过简单的数学逆运算完全还原其内部状态,从而 100% 预测未来生成的所有随机数。Python 3.6 专门引入了 secrets 模块,直接调用操作系统内核的高熵加密级安全伪随机数发生器(CSPRNG),具备抗逆向推导与抗前向猜测能力,是生成 Token、密钥和验证码的唯一标准选择。
一、核心差异速览:PRNG 与 CSPRNG 的本质分野
很多开发者在编写代码时,出于习惯直接调用 random.choice() 或 random.randint() 来生成密码重置链接、验证码或 Session 令牌。表面上看,这些数值分布均匀、毫无规律,但在信息安全领域,“统计学上的随机”与“密码学上的不可预测”是完全不同的两个概念。
为了直观理解两者的分工与边界,下表整理了 random 与 secrets 在底层机制、设计目标及适用范围上的全面对比:
| 对比维度 | random 模块 | secrets 模块 |
|---|---|---|
| 发生器类型 | 伪随机数生成器(PRNG) | 加密级安全伪随机数生成器(CSPRNG) |
| 核心算法 | 梅森旋转算法(Mersenne Twister, MT19937) | 内核 CSPRNG(如 ChaCha20 / AES-CTR 混合模型) |
| 底层熵源 | 内存中的确定性算法(或手动指定的 Seed 整数) | 操作系统内核真随机熵池(硬件噪声、中断抖动等) |
| 系统调用接口 | 纯用户态内存计算,无需系统调用 | Linux getrandom() / macOS getentropy() / Windows BCryptGenRandom() |
| 内部状态大小 | 固定 624 个 32-bit 整数(约 2.5 KB 内存) | 由操作系统内核维护,用户态不可直接读取或克隆 |
| 抗推导能力 | 零抗推导能力:观测 624 个输出即可完美逆向 | 极高:具备抗前向猜测(Forward Secrecy)与抗后向溯源 |
| 能否设定 Seed | 支持 random.seed(),保证结果完全可复现 |
不支持,强制依赖环境物理熵源保证不可预测 |
| 生成性能 | 极高(每秒可生成千万级随机数) | 中高(每秒百万级,受系统调用影响略低于 random) |
| 权威设计目标 | 蒙特卡洛模拟、数据科学、机器学习 Shuffle、游戏机制 | 密码生成、Session ID、OAuth State、密码重置 Token、OTP 验证码 |
二、random 的本质:梅森旋转算法与确定性安全缺陷
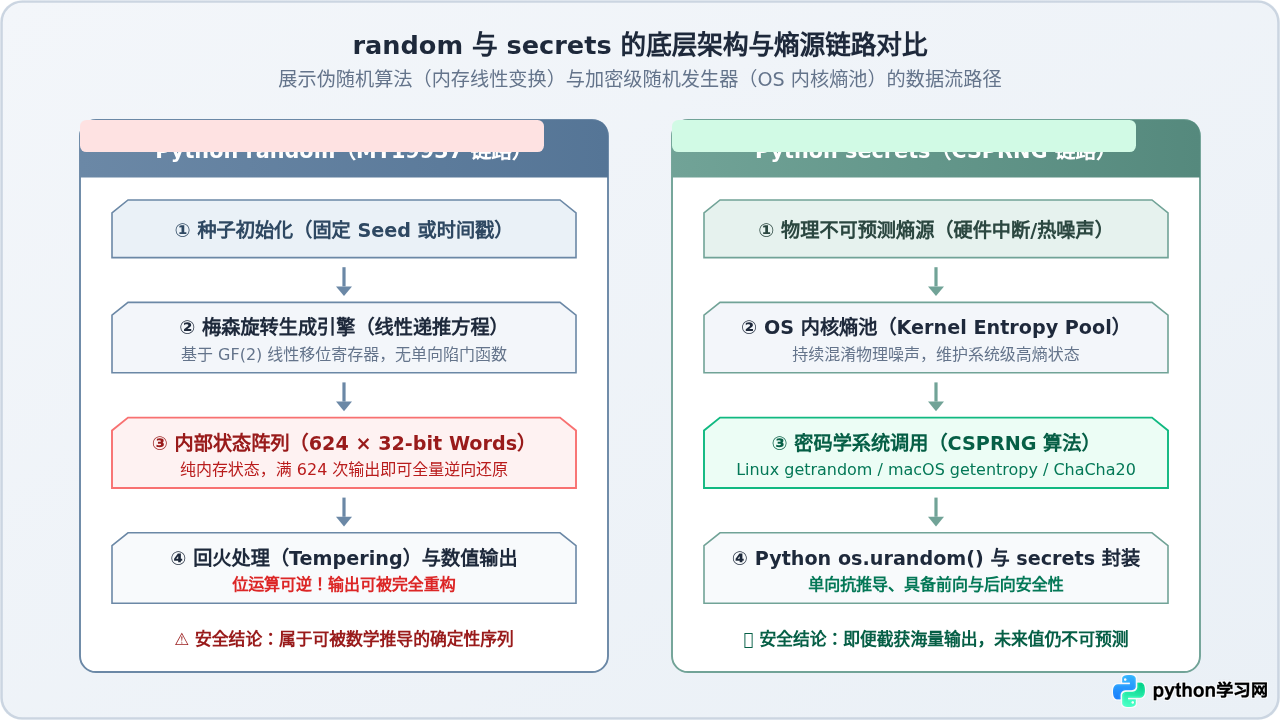
random 模块默认基于由日本学者松本真(Makoto Matsumoto)和西村拓士(Takuji Nishimura)于 1997 年提出的梅森旋转算法(MT19937)。该算法拥有高达 2^19937 - 1 的天文数字周期,并通过了针对统计随机性的严苛测试(如 Dieharder 测试套件),在统计学和数值模拟中表现优异。
然而,在密码学场景中,MT19937 存在致命的结构性弱点:它是一个完全线性的生成器,内部不存在任何单向陷门函数(One-way Trapdoor Function)。
1. MT19937 的状态转移与回火(Tempering)机制
MT19937 在内存中维护了一个长度为 624 的 32 位无符号整数数组 state[0..623] 以及一个当前状态指针 index。每当生成一个随机数时,算法会取出一个状态字 y = state[index],并通过以下 4 步可逆的位移和掩码异或操作输出最终值 z,这一过程称为“回火”(Tempering):
# MT19937 的 4 步回火运算(Tempering)
y1 = y ^ ((y >> 11) & 0xFFFFFFFF)
y2 = y1 ^ ((y1 << 7) & 0x9D2C5680)
y3 = y2 ^ ((y2 << 15) & 0xEFC60000)
z  = y3 ^ ((y3 >> 18) & 0xFFFFFFFF)  # z 即为对外输出的 32 位随机数
2. 为什么 624 个输出即可完全破译?
注意上述 4 个公式中的运算:只有位右移、位左移、常数按位与(AND)以及按位异或(XOR)。在二进制代数中,这 4 种运算全部存在确定且唯一的逆运算(Untemper)!
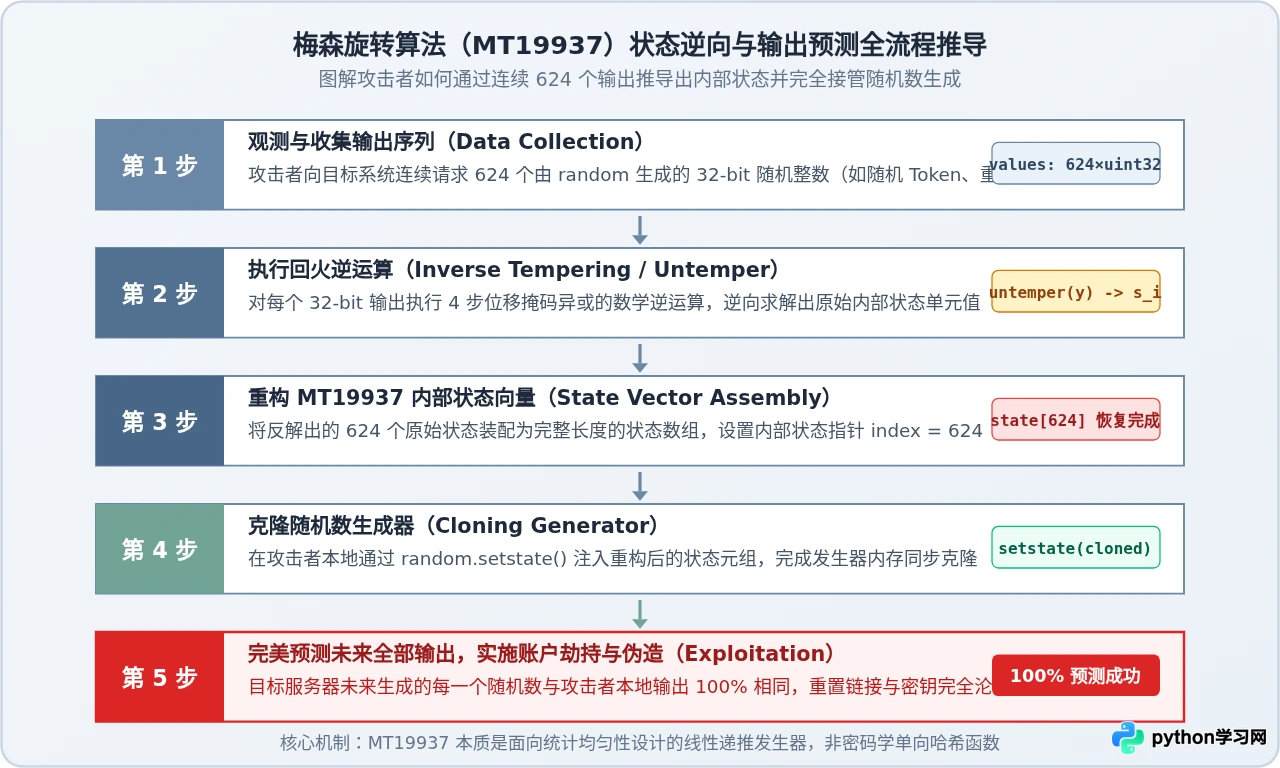
这意味着,攻击者只要拿到输出的 z,就能通过编写对应的逆向位运算函数,逆向推导出原始的 y。而只要连续获取 624 个输出,攻击者便能逆向出完整的 state[0..623] 数组。此时,攻击者的计算机便拥有了与服务器完全一模一样的内部状态,未来的每一个随机数都可以被零误差精确计算出来。
3. 状态逆向与预测验证代码实测
为了证实这一安全脆弱性,以下展示了一段完整的状态逆运算(Untemper)实现。该脚本模拟目标服务器使用 random 产生 624 个随机值,攻击者仅凭这 624 个公开数值,便能成功预测第 625 个及后续全部数值:
import random

# 1. 针对 MT19937 回火操作的数学逆函数(Untemper)
def undo_right_shift_xor(value, shift):
    result = 0
    for i in range(0, 32, shift):
        part = (value >> i) & ((1 << shift) - 1)
        result |= (part ^ ((result >> shift) & ((1 << shift) - 1))) << i
    return result

def undo_left_shift_xor_and(value, shift, mask):
    result = 0
    for i in range(0, 32, shift):
        mask_part = (mask >> i) & ((1 << shift) - 1)
        value_part = (value >> i) & ((1 << shift) - 1)
        prev_result_part = (result >> (i - shift)) & ((1 << shift) - 1) if i >= shift else 0
        part = value_part ^ (prev_result_part & mask_part)
        result |= part << i
    return result

def untemper(z):
    y3 = undo_right_shift_xor(z, 18)
    y2 = undo_left_shift_xor_and(y3, 15, 0xEFC60000)
    y1 = undo_left_shift_xor_and(y2, 7, 0x9D2C5680)
    y0 = undo_right_shift_xor(y1, 11)
    return y0

# 2. 模拟服务器端使用 random 生成随机数
server_rng = random.Random(987654321)  # 服务器任意初始化
observed_outputs = [server_rng.getrandbits(32) for _ in range(624)]

# 3. 攻击者仅凭 observed_outputs 重构内部状态
reconstructed_state = [untemper(val) for val in observed_outputs]

# 4. 攻击者克隆一个本地的 random 实例
attacker_rng = random.Random()
attacker_rng.setstate((3, tuple(reconstructed_state + [624]), None))

# 5. 验证预测能力:对比服务器未来的输出
server_next_token = server_rng.getrandbits(32)
attacker_predicted = attacker_rng.getrandbits(32)

print(f"服务器生成的第 625 个随机数: {server_next_token}")
print(f"攻击者预测的第 625 个随机数: {attacker_predicted}")
print(f"预测是否完全一致: {server_next_token == attacker_predicted}")
# 示例运行结果: 预测是否完全一致: Truerandom 产生的值(例如每次点击抽奖、验证码获取、UUID4 替代实现),攻击者就能静默收集样本并重建你的生成器。一旦完成克隆,未来生成的所有敏感凭证对攻击者而言都是完全透明的明文。
三、secrets 的工作原理:加密级安全伪随机数(CSPRNG)
为彻底解决因误用 random 导致的安全隐患,Python 官方在 Python 3.6 中正式引入了标准库 secrets(基于 PEP 506 提案)。secrets 的设计目标非常明确:成为生成安全凭证与密码学随机数的唯一权威接口。
1. 内核高熵源与 CSPRNG 机制
secrets 底层直接调用 Python 的 os.urandom(),而 os.urandom() 在不同的操作系统中会调用操作系统内核经过严格密码学审查的高熵接口:
- Linux:调用
getrandom()系统调用,若系统刚启动熵池尚未就绪,调用会阻塞直到内核熵池收集完毕,杜绝早期弱熵缺陷; - macOS / BSD:调用内核
getentropy()系统调用; - Windows:调用微软密码学 API
BCryptGenRandom()。
操作系统的内核熵池持续混合来自物理世界的不可预测噪声(如键盘按键微秒间隔、磁盘 I/O 寻道时间、网卡数据包到达抖动、CPU 硬件随机指令 RDRAND 等)。内核在此基础上运行经过密码学验证的流密码(如 ChaCha20)或哈希算法持续搅拌,确保其输出具备数学证明的单向性(One-wayness)。
2. 前向安全性与后向安全性
与 MT19937 相比,CSPRNG 具备两个核心数学属性:
- 前向安全性(Forward Secrecy / Next-bit Unpredictability):即便攻击者获得了当前时刻之前的所有随机数输出,利用现存最强的计算能力,也无法在多项式时间内以高于 50% 的概率猜出下一个比特是 0 还是 1。
- 后向安全性(Backward Secrecy):即便攻击者在某一时刻通过物理手段非法读取了系统当前的内部状态,也无法推导出此前已经生成过的历史随机数。
四、random 与 secrets 核心 API 映射与安全迁移
在实际工程重构中,从 random 迁移到 secrets 的成本极低,因为 secrets 提供了高度对称且更符合 Web 安全规范的 API 封装:
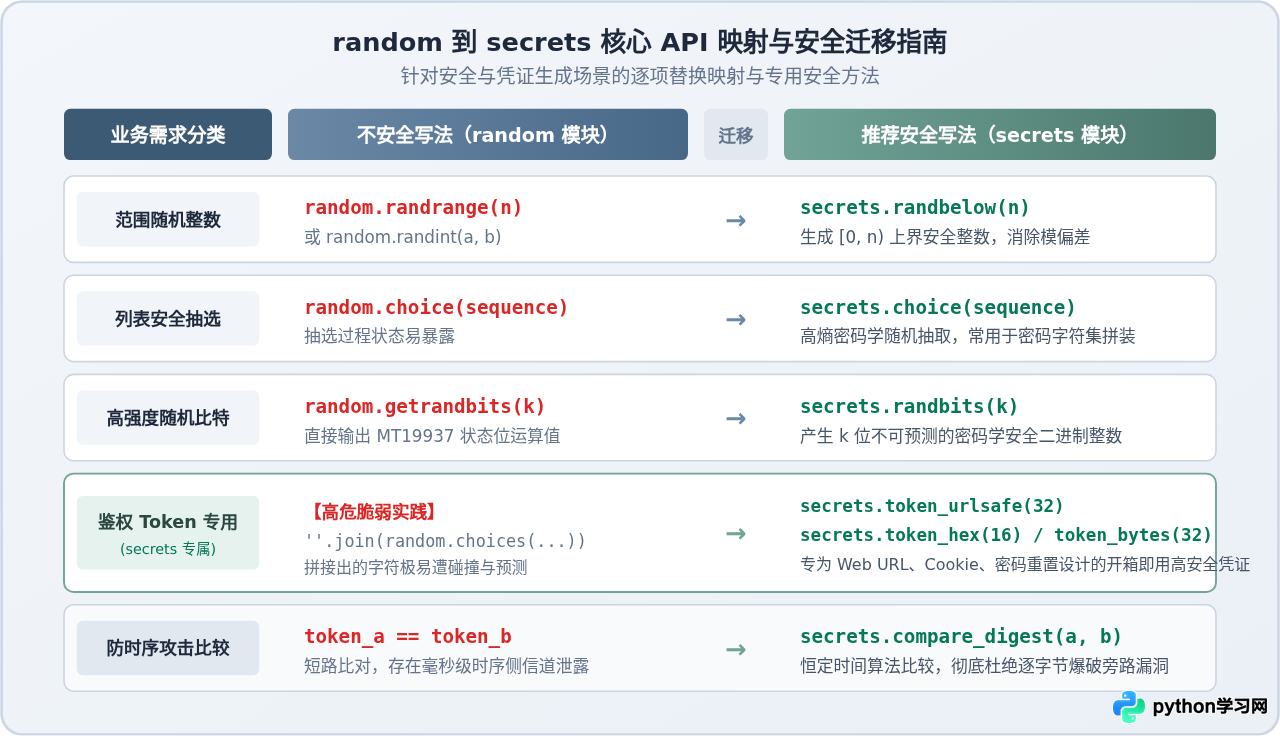
1. 范围整数生成:secrets.randbelow() 替代 random.randint()
在生成指定范围内的整数时,严禁使用 random.randint(a, b) 或利用模运算 % 取余(模运算会带来模偏差 Modulo Bias,破坏概率均匀性)。应使用 secrets.randbelow(n):
import secrets

# 需求:生成 6 位手机短信验证码 [000000, 999999]
# secrets.randbelow(n) 会安全返回 [0, n) 之间的整数
code_num = secrets.randbelow(1_000_000)
sms_code = f"{code_num:06d}"
print(f"安全生成的 6 位验证码: {sms_code}")  # 例如: "048291"
2. 序列随机抽选:secrets.choice() 替代 random.choice()
当需要从给定的字符集(如大写字母、小写字母、数字、特殊符号)中随机抽选字符拼装强密码时,使用 secrets.choice():
import string
import secrets

# 需求:生成 16 位高强度随机复杂密码
alphabet = string.ascii_letters + string.digits + "!@#$%^&*"
password = "".join(secrets.choice(alphabet) for _ in range(16))
print(f"高强度随机密码: {password}")
3. Web 安全凭证三剑客:token_hex()、token_urlsafe()、token_bytes()
以往许多开发者使用 random 配合字符串拼接来手写 Token 生成逻辑,这既冗长又容易引入脆弱字符。secrets 内置了开箱即用的安全 Token 生成函数:
import secrets

# 1. 生成 32 字节(64 字符)的十六进制 Token,常用于 API Key 或 CSRF Token
api_key = secrets.token_hex(32)
print(f"API Key: {api_key}")

# 2. 生成 URL 安全的 Base64 编码 Token(无 '+'、'/' 等 URL 冲突符号),最适合找回密码链接
reset_token = secrets.token_urlsafe(32)
reset_url = f"https://example.com/reset-password?token={reset_token}"
print(f"重置链接: {reset_url}")

# 3. 生成 16 字节原始随机二进制数据,常用于对称加密 AES 的初始化向量(IV)或密钥加盐(Salt)
salt = secrets.token_bytes(16)
print(f"加密盐字节长度: {len(salt)}")
4. 凭证比对的最后防线:secrets.compare_digest()
除了生成随机数外,安全凭据的比对同样隐藏着巨大的安全陷阱。很多系统在验证用户提交的 Token 时直接使用 token_received == token_stored。标准的字符串 == 运算符在发现首个不匹配字符时会立即提前返回(短路求值),这会导致比对耗时与正确前缀长度产生微秒级的关联,攻击者可以借助高精度的网络时序测量逐字节推导出整个 Token,即时序攻击(Timing Attack)。
import secrets

user_token = "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
expected_token = "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"

# 错误做法(易受时序侧信道攻击):
# is_valid = (user_token == expected_token)

# 正确做法:使用常量时间比对(Constant-Time Comparison)
is_valid = secrets.compare_digest(user_token, expected_token)
if is_valid:
    print("凭据校验通过,允许授权")
else:
    print("凭据无效,拒绝访问")
五、架构选型决策树与安全规程
在系统架构设计与日常开发中,选择 random 还是 secrets 不应取决于个人偏好,而应严格遵循清晰的安全边界原则。
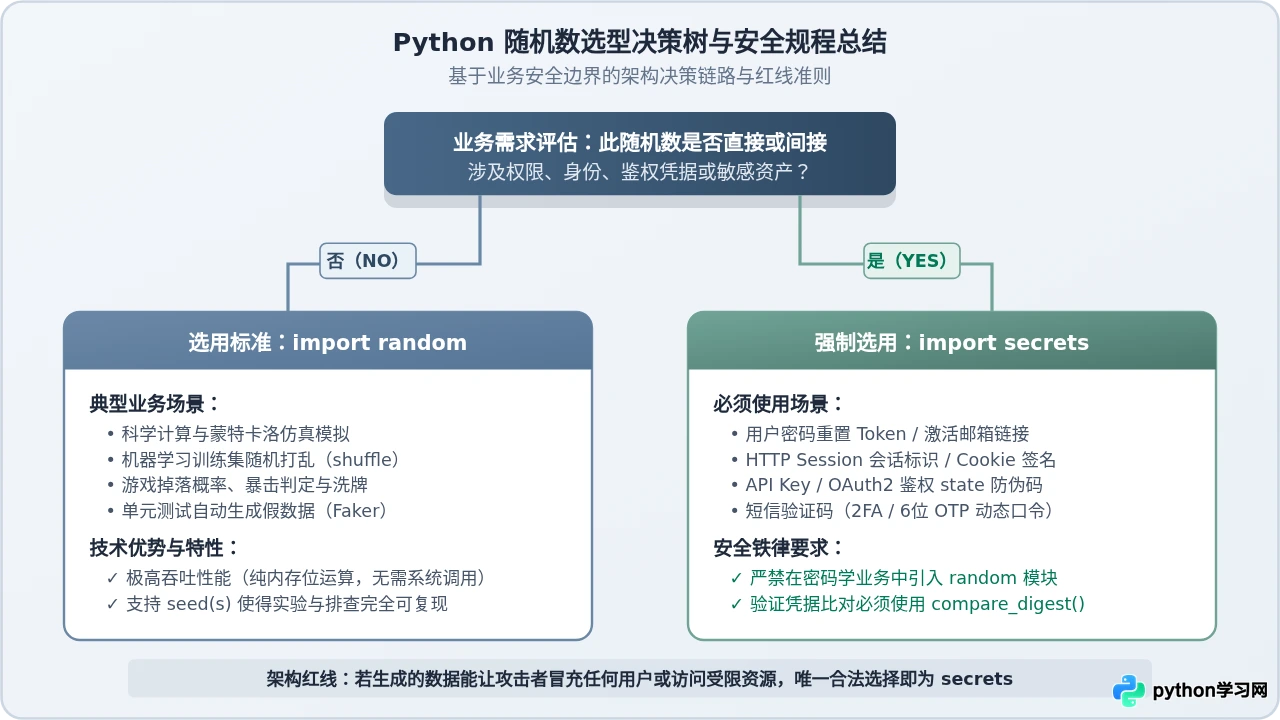
- 判定边界:只要该数值具有“授权价值”——即一旦攻击者预知或猜出该值,就能以任何形式绕过权限、冒充用户、篡改数据或获取特权,就必须 100% 选用
secrets。 - 允许 random 的唯一前提:该随机数仅用于纯技术计算(如 Monte Carlo 计算、图形学抖动、物理模拟碰撞、无博弈性质的单机游戏道具动画),且明确接受结果在理论上被完全逆向。
- 代码规范审查:在 CI/CD 流水线中,建议配置静态代码审查工具(如 Bandit),对涉及
random用于字符串拼接生成 Token 的行为进行阻断拦截。
六、常见误区与高频问题解答(FAQ)
secrets 提供了 seed() 方法,开发者便可能因便利性而传入固定值或容易被推测的值,从而完全毁掉系统调用的加密安全性。因此,secrets 模块在设计时故意去除了任何可自定义种子的接口,强制所有熵值必须来自内核物理真随机熵池。
random 产生整数的速度大约是 secrets 的 10 到 20 倍,因为 random 是纯内存位运算,而 secrets 涉及操作系统系统调用(Context Switch)。但是在密码学与凭据生成场景下,这种性能差距完全可以忽略不计。 生成一个密码重置 Token 仅耗费几个微秒,而网络 HTTP 往返、数据库写入或邮件发送至少耗费数十到数百毫秒,瓶颈永远在 I/O 端。安全至关重要,切勿为了几微秒的 CPU 耗时牺牲整个系统的安全性。
numpy.random 在早期版本也是基于 MT19937,自 NumPy 1.17 起默认采用了更现代的高性能生成器 PCG-64(Permuted Congruential Generator)。PCG-64 在统计性能、缓存利用和多线程并行流生成上极为优秀,但它依然是非密码学安全的 PRNG。如果在分布式系统或深度学习服务中生成 API Token 或会话标识,同样绝对不能使用 numpy.random,仍应使用 Python 原生的 secrets 模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















