


面试中被问“Python掌握程度”该怎么回答?
面对面试官提问“Python掌握程度”,本文提供了一套结合能力定界、核心特性、工程产出与底层机制的实用回答方法,帮助求职者清晰展现真实技术深度并有效引导面试节奏。
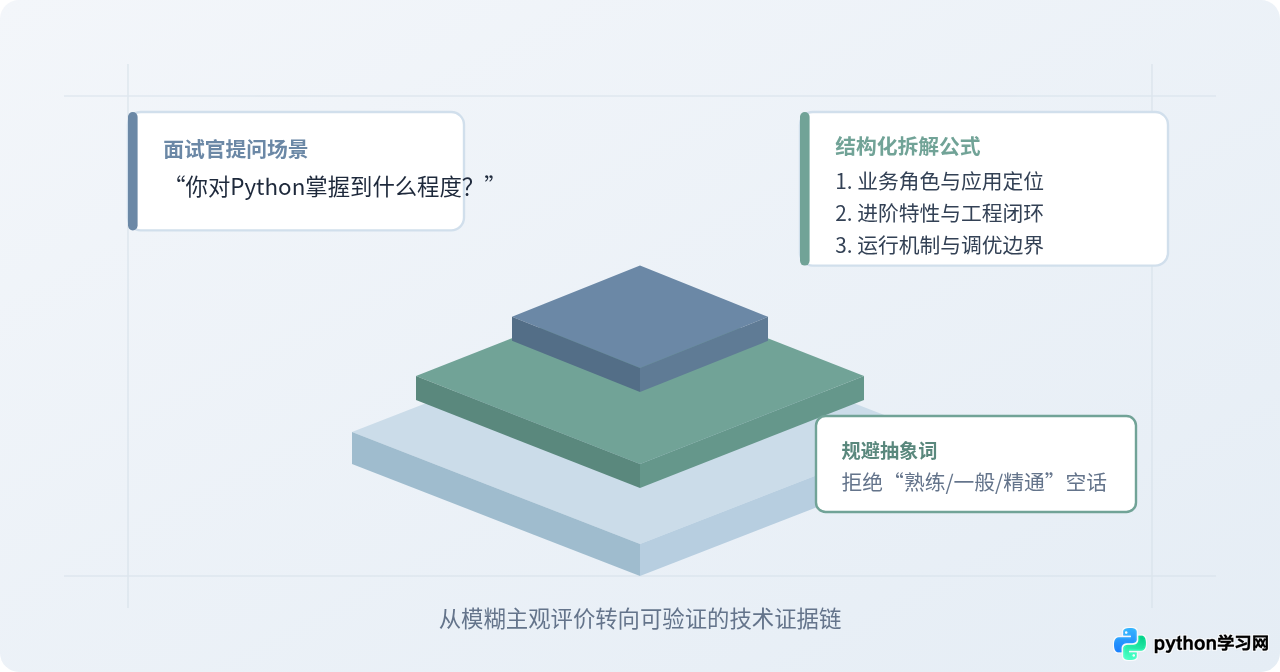
在技术面试中,当面试官问到“你对 Python 的掌握程度如何”时,核心考察的并不是求职者对语言的自我感觉,而是能否提供清晰、客观、可验证的证据链来证明自己的工程与技术能力。回答这一问题的有效路径是:摒弃“熟练”、“精通”或“了解”等模糊词汇,直接采用“业务领域定界 + 进阶特性与工程实践 + 底层机制认知与主动引导”的三段式结构展开,让面试官快速掌握你的技能边界与技术深度。
一、为什么简单的形容词无法令面试官信服
多数求职者习惯直接回答“熟练使用”、“做过几年开发”或“基本语法没问题”。这种回答在面试场景中存在两个明显弊端:其一是主观标准差异巨大,一位仅用 Python 编写单文件脚本的初学者和一位能够熟练使用元编程与分析底层 GIL 机制的工程师,都可能自称“熟练”;其二是缺乏锚点,容易导致面试官为了探明边界而随意选择极深或极偏的问题进行摸底,增加候选人的应试风险。
面试官提出这个开放式问题的核心目的通常有三个方面:评估候选人能否直接胜任目标岗位的业务代码编写、确认候选人是否对语言特性有体系化的理解,以及观察候选人在表达技术方案时是否具备严谨的结构化思维。
二、建立 Python 掌握程度的四层能力阶梯
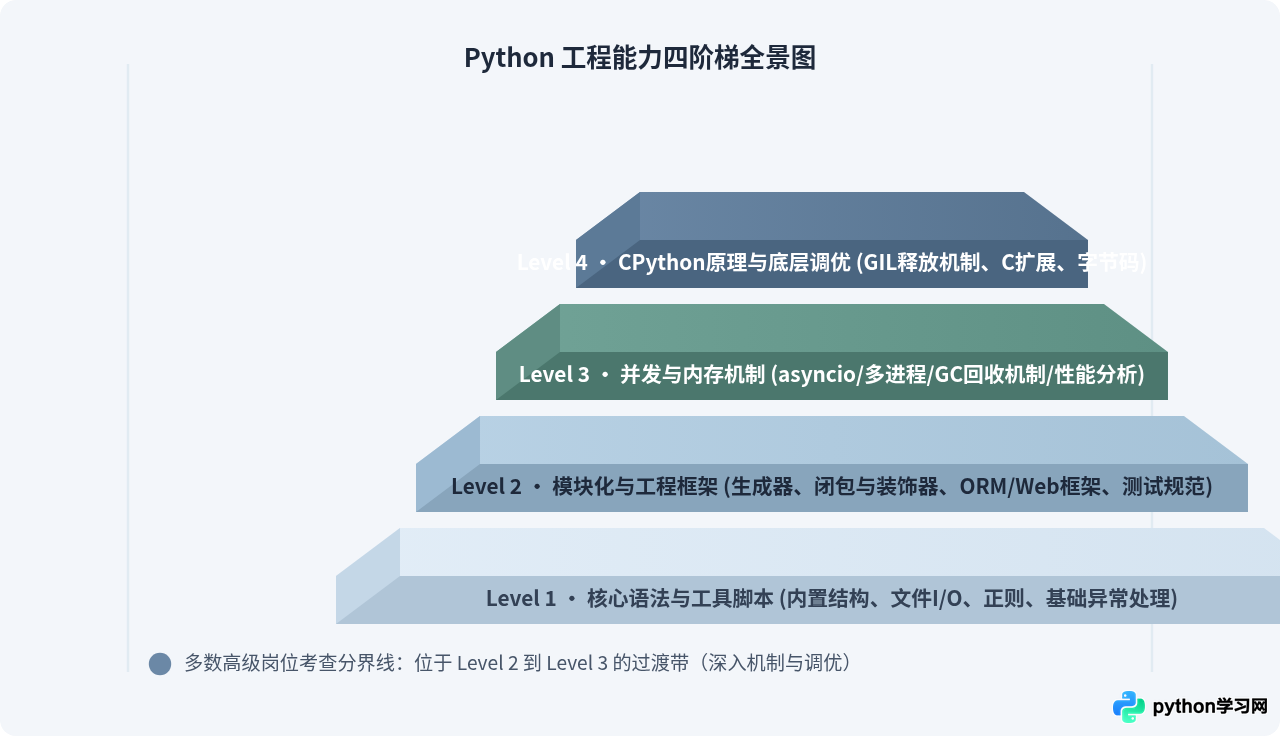
在组织回答之前,求职者需要对照客观的技术层级确立自己的真实技能水位。Python 技能在工程实践中通常划分为四个递进阶段:
- 第一层:语法与脚本编写能力(Level 1):掌握常用内置数据结构(列表、字典、集合)、控制流、函数传参机制、标准文件 I/O,能够完成自动化测试脚本或简单工具编写。
- 第二层:模块化与工程实践能力(Level 2):掌握面向对象编程设计、迭代器与生成器原理、装饰器封装、包管理与虚拟环境(Poetry、Pipenv),能熟练使用常见生态框架(如 FastAPI、Django、Pandas)进行标准化项目交付。
- 第三层:并发处理与运行机制理解(Level 3):清楚多进程、多线程与
asyncio异步协程的适用场景与开销差异,理解 Python 内存管理(引用计数与三代垃圾回收算法),熟悉常见性能瓶颈诊断工具(如cProfile、memory_profiler)。 - 第四层:底层原理与架构级调优(Level 4):深入理解 CPython 解释器实现、GIL(全局解释器锁)的设计权衡与释放时机、字节码执行过程,具备 C 扩展开发或大规模系统性能优化经验。
三、四步构建可落地的回答结构
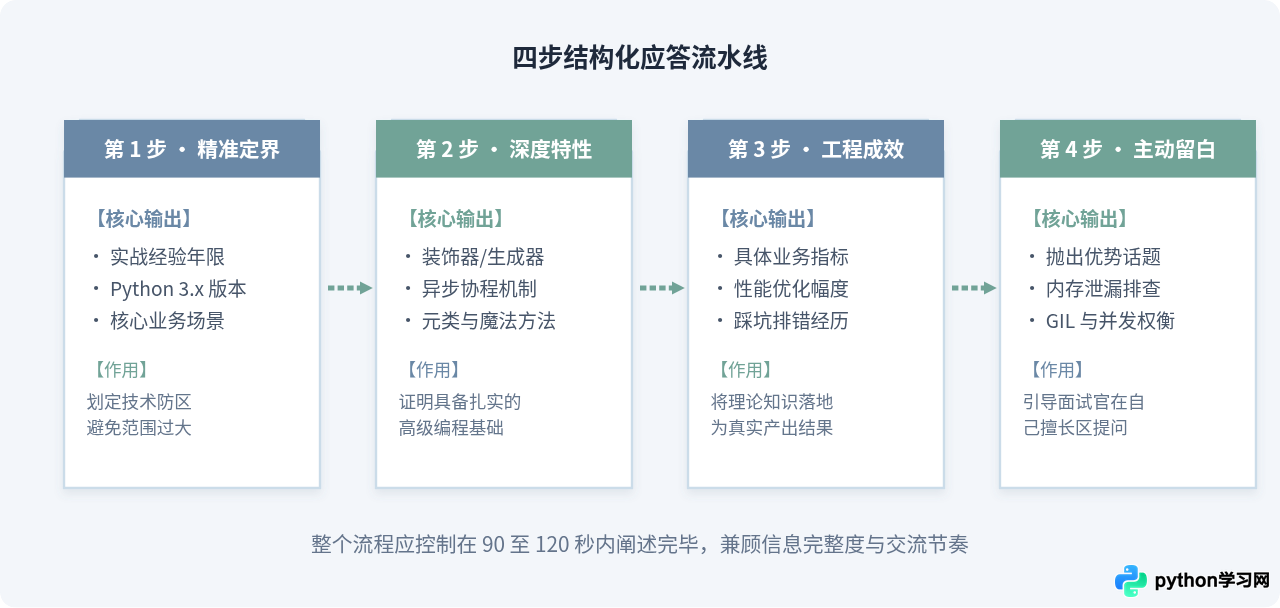
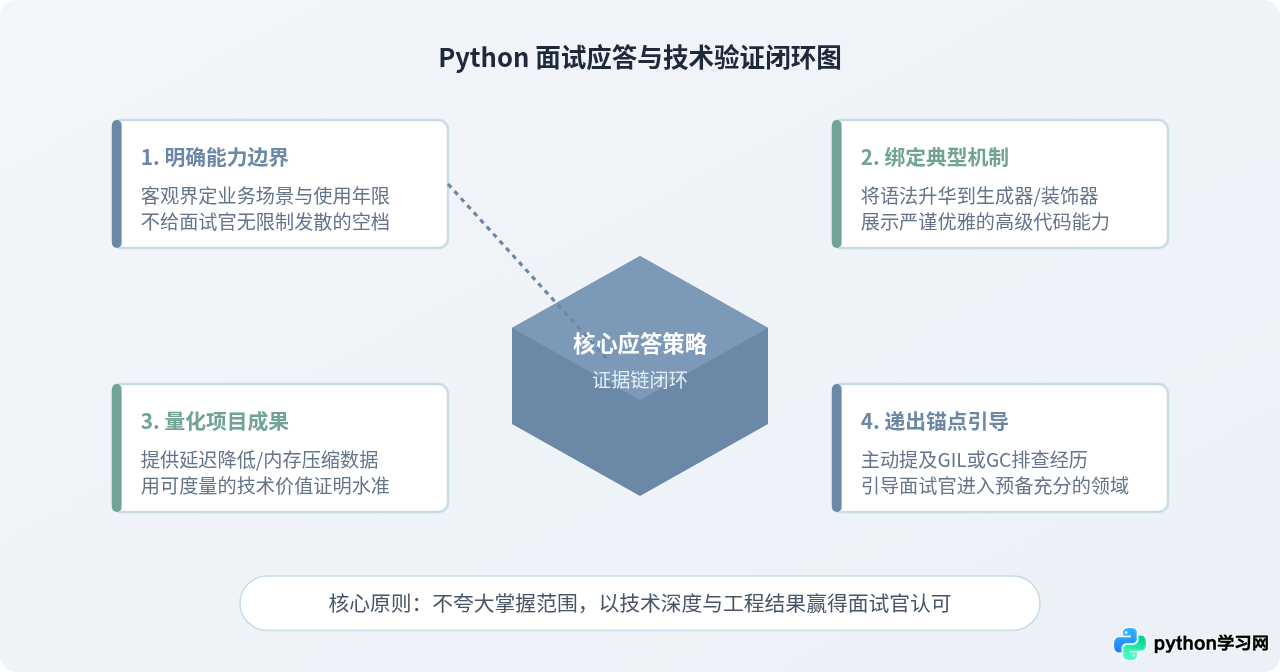
在面试交谈中,应当按照逻辑层层递进的方式组织回答,避免毫无条理的技术点堆砌。推荐采用四步推导法:
- 第一步:精准定界(说明使用年限、版本与核心场景):首先给出客观数据,说明自己在具体业务中持续使用 Python 的时长、主要维护的项目版本(例如 Python 3.10+),以及主要解决的业务问题域(如后端 API 服务、数据清洗或运维自动化)。
- 第二步:阐述掌握的核心特性(突出技术深度):不要只罗列基础语法,挑选 2 到 3 个能够体现语言深度的机制。例如生成器的延迟计算与内存节约、自定义上下文管理器的资源释放、元编程或装饰器对业务鉴权与埋点的封装。
- 第三步:带出典型工程场景与成效(形成证据闭环):结合实际项目案例,说明自己如何利用上述特性解决具体问题。例如通过
asyncio改造传统阻塞式网络调用,使批量外部接口请求延迟降低 50%。 - 第四步:主动引导后续追问(递出技术“锚点”):在回答结尾,主动提及自己在并发模型、内存管理或性能调优方面的关注点,为面试官提供接下来的提问线索,牢牢掌握面试节奏。
四、针对常见技术岗位的回答范式与拆解
不同岗位的面试官对 Python 能力的关注维度差异显著。Web 后端开发更看重并发与网络 I/O,数据分析重点考察内存与向量化运算,而测试开发与运维则更关注自动化框架与异常容错。
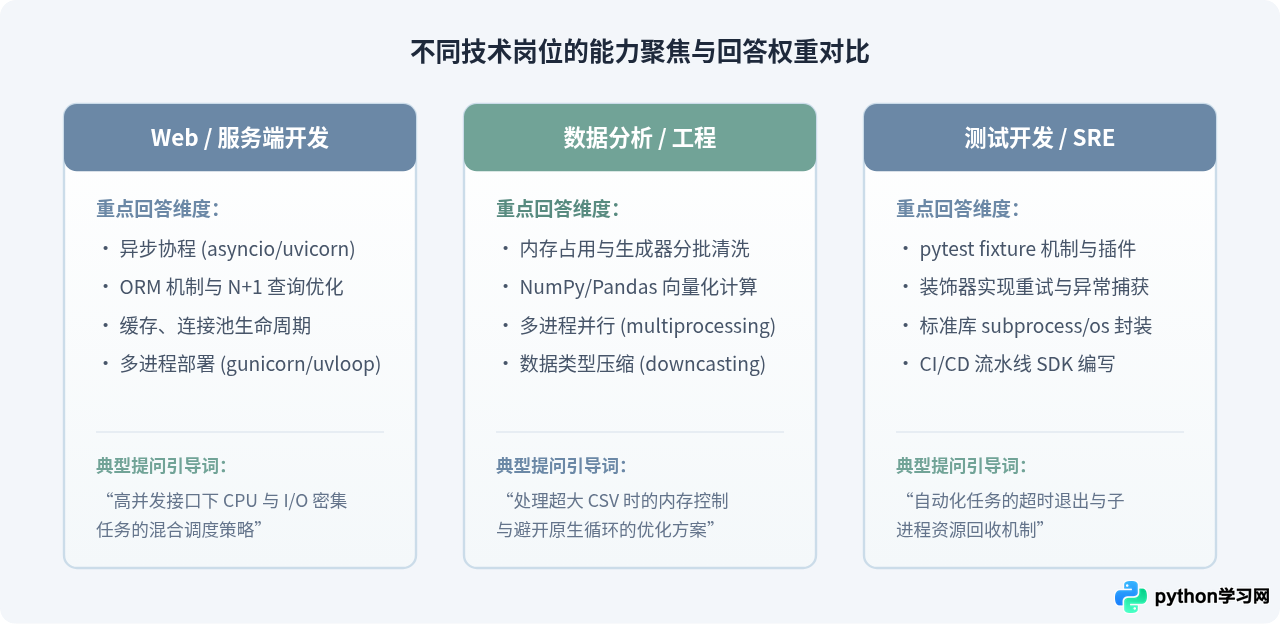
岗位实战示例 1:Web 后端开发方向
“我使用 Python 进行后端开发有 3 年时间,主力技术栈是 Python 3.10 与 FastAPI。在语言特性层面,我深度应用了 asyncio 异步协程处理高 I/O 请求,并通过自定义装饰器和上下文管理器完成了统一的鉴权与链路耗时统计。”
“在最近的一个微服务重构中,我使用生成器逐步处理上游推送的批量消息,解决了之前一次性反序列化导致内存瞬间暴增的问题,将服务单实例常驻内存控制在 200MB 以内。对于 Python 运行时的底层机制,比如 GIL 对多线程在 CPU 密集任务中的限制、以及垃圾回收在循环引用场景下的工作机制,我在排查偶发性能退化时做过针对性的跟踪。”
岗位实战示例 2:数据分析 / 数据工程方向
“我使用 Python 处理数据管道和分析有近 3 年,主要使用 Python 3.9 及 Pandas/NumPy 生态。在编写数据清洗逻辑时,我重点关注向量化运算,避免在大型数据集上使用低效的 for 循环或 apply 操作。”
“面对超过服务器物理内存的单批次数据,我通过 read_csv(chunksize=...) 结合生成器管道进行分块流式计算,并针对数值列进行下采样(Downcasting),使内存开销降低了 60% 以上。同时,针对多核计算需求,我熟悉 concurrent.futures.ProcessPoolExecutor 的多进程调度与数据分片通信开销控制。”
五、回答过程中务必规避的三个常见陷阱
陷阱提醒:语言能力不等于三方库的使用。面试官问的是你对“Python”的掌握程度,而不是对第三方框架 API 的背诵程度。回答必须落脚于语言机制、运行原理和代码组织结构。
- 陷阱一:随意声明“精通 Python”:在工业界技术面试中,“精通”通常意味着候选人阅读或修改过 CPython 解释器源码、深入理解其内存分配器(如 pymalloc)、熟悉字节码指令集实现并能编写 C 扩展模块。如果未达到该水准,声称精通容易引出极为严苛的底层考查。
- 陷阱二:只报库名,不讲原理:单纯罗列“我会用 Django、Requests、Celery”等同于展示工具清单,无法证明编码质量与架构能力。应结合为什么这样选型、如何排查过该组件中的连接池耗尽或阻塞事件循环等实际问题来阐述。
- 陷阱三:遇到未触及的底层知识强行猜测:当面试官顺着你的回答深挖到底层机制(例如问到“Python 字典在 3.6 之后是如何通过紧凑数组降低内存占用的”),如果确实没有了解过,切忌凭空臆断。正确的做法是坦承认知边界,并基于已知的散列结构、拉链法或开放寻址法阐述分析逻辑。
六、总结:构建可靠的技术应答闭环
回答“Python 掌握程度”的精髓在于化被动应答为主动展示。通过将抽象的形容词转化为可量化的工程指标、可验证的语言特性和清晰的底层机制,求职者不仅能够向面试官传达扎实稳健的技术功底,还能有效将后续的面试考查引导到自己具备实战经验的技术主场中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















