


Python使用SQLAlchemy实现数据库增删改查基础教程
本教程详细讲解如何使用 Python 与 SQLAlchemy 2.0 实现数据库的基础增删改查(CRUD)操作,包含声明式模型定义、会话管理、数据插入、条件查询、属性更新、数据删除及事务异常回滚的完整代码示例与架构图解。
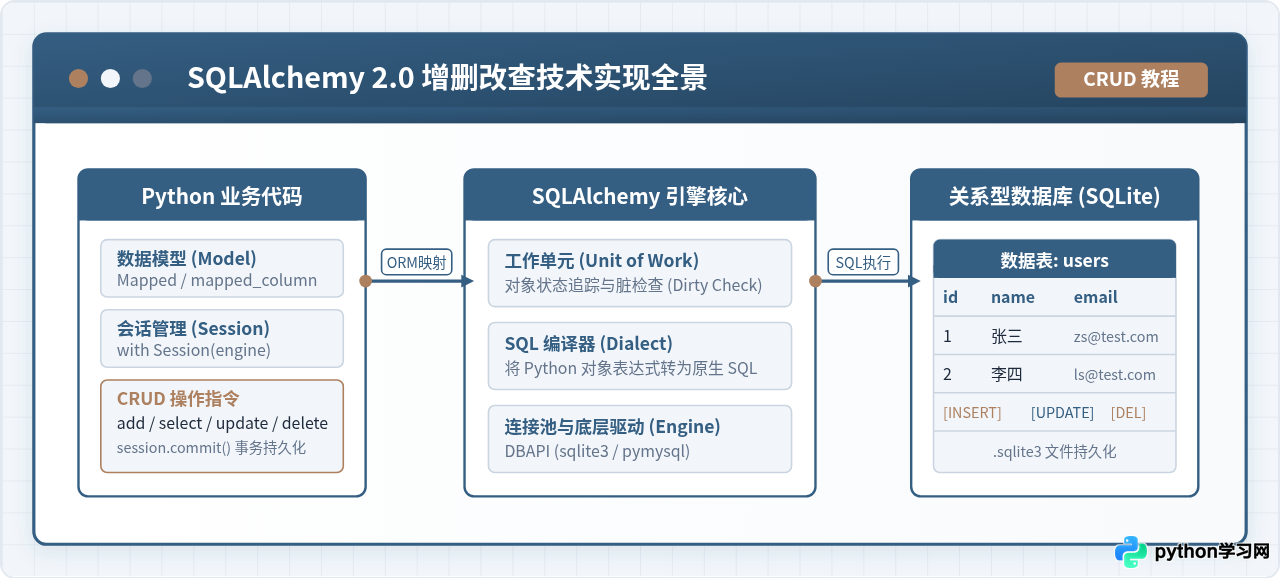
一、准备工作与环境依赖安装
SQLAlchemy 2.0 在核心 API 上进行了重大升级,推荐使用统一的 select()、update()、delete() 结构化语句和类型注解驱动的 Mapped 声明方式。在本教程中,我们将使用 Python 自带的轻量文件型数据库 SQLite,无需额外安装或配置独立的数据库服务端软件即可直接运行验证。
在命令行终端执行以下命令安装最新版 SQLAlchemy:
# 在终端或虚拟环境中安装 SQLAlchemy
pip install sqlalchemy
安装完成后,可以在 Python 交互环境中确认版本信息。推荐确保安装的版本为 2.0.x 或更高:
# 示例命令与输出
$ python -c "import sqlalchemy; print(sqlalchemy.__version__)"
2.0.36  # [示例输出]
二、核心概念与数据库引擎连接(Engine 与 Session)
使用 SQLAlchemy 操作数据库主要依赖两个核心层级:
- Engine(引擎):负责管理数据库连接池(Connection Pool)并处理不同数据库方言(Dialect)的底层通信。它是应用程序与底层物理数据库之间的唯一交互枢纽。
- Session(会话):代表一次数据库会话事务。它维护了“工作单元”(Unit of Work)和“身份映射”(Identity Map),负责跟踪所有模型对象的变更状态,并在提交时统一编译并执行 SQL。
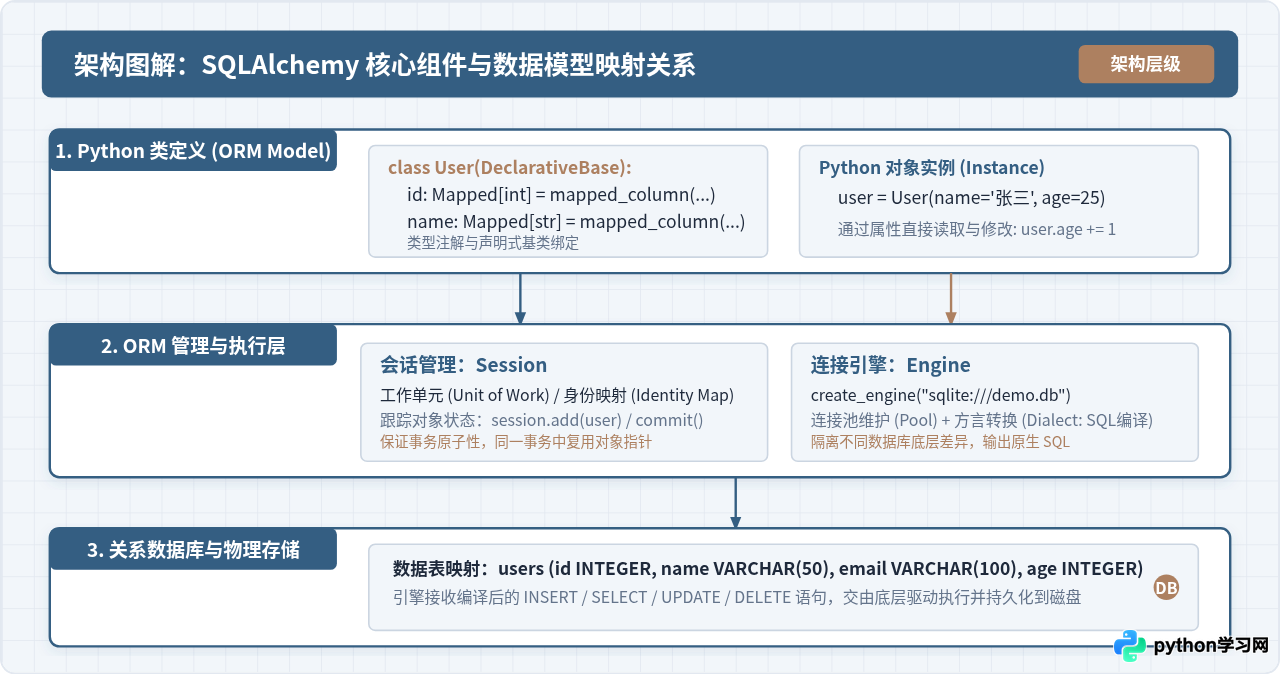
创建引擎和会话生成器的基本代码结构如下:
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, Session

# 1. 创建数据库引擎,指定 SQLite 文件路径(echo=True 会在控制台打印生成的真实 SQL)
engine = create_engine("sqlite:///tutorial.db", echo=False)

# 2. 创建会话工厂,用于按需构建会话对象
SessionLocal = sessionmaker(bind=engine)
三、定义声明式数据模型(Declarative Model)
在 SQLAlchemy 2.0 中,数据模型通过继承 DeclarativeBase 基类来定义。使用 Python 的类型注解 Mapped[T] 配合 mapped_column() 函数,可以直观地标注数据表列的数据类型、主键、唯一约束和默认值。
下面我们定义一个通用的用户表模型 User:
from sqlalchemy import String, Integer
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column

# 1. 声明基类
class Base(DeclarativeBase):
    pass

# 2. 定义 User 实体模型
class User(Base):
    __tablename__ = "users"  # 数据库中对应的表名

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    name: Mapped[str] = mapped_column(String(50), nullable=False)
    email: Mapped[str] = mapped_column(String(100), unique=True, nullable=False)
    age: Mapped[int] = mapped_column(Integer, default=18)

    def __repr__(self) -> str:
        return f"<User(id={self.id}, name='{self.name}', email='{self.email}', age={self.age})>"

# 3. 将模型映射到数据库并建表(若表已存在则跳过)
Base.metadata.create_all(engine)Base.metadata.create_all(engine) 仅负责创建数据库中尚未存在的数据表。如果后续在模型类中新增或删除了字段,该方法不会自动修改物理表结构。对于生产环境中的字段结构变更,应配合 Alembic 等迁移工具管理。
四、增删改查核心操作详解(CRUD)
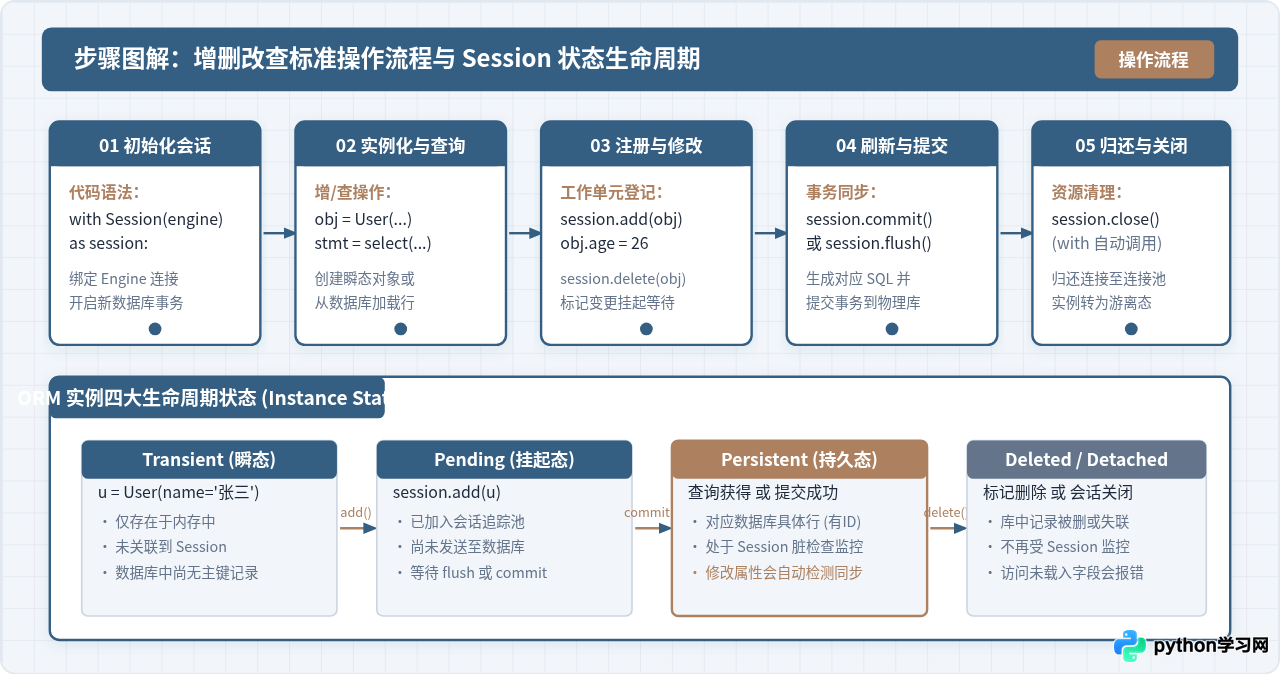
增删改查的整个执行周期都应当在 Session 的上下文中完成。使用 with Session(engine) as session: 能够保证在代码块退出时自动关闭会话并释放数据库连接。
4.1 增加数据(Create / Insert)
添加新数据时,首先实例化模型对象(此时对象处于瞬态 Transient),然后通过 session.add() 将其注册入会话(进入挂起态 Pending),最后执行 session.commit() 提交事务将数据持久化到数据库中。
def add_single_user():
    with Session(engine) as session:
        # 创建模型对象实例
        new_user = User(name="张三", email="zhangsan@example.com", age=24)

        # 将实例登记至当前会话中
        session.add(new_user)

        # 提交事务,执行真实 INSERT 操作
        session.commit()

        # 提交后,数据库自动生成的主键 id 会回填至该对象中
        print(f"成功新增用户,分配的ID为: {new_user.id}")

def add_multiple_users():
    with Session(engine) as session:
        users = [
            User(name="李四", email="lisi@example.com", age=28),
            User(name="王五", email="wangwu@example.com", age=32),
            User(name="赵六", email="zhaoliu@example.com", age=19),
        ]
        # 批量添加列表对象
        session.add_all(users)
        session.commit()
        print(f"批量添加成功,新增 {len(users)} 条数据")
4.2 查询数据(Read / Select)
SQLAlchemy 2.0 统一采用 select() 构造器来构建查询,通过 session.scalars() 解析单实体标量结果,支持 where() 过滤、order_by() 排序和 limit() 分页。
from sqlalchemy import select

def query_users():
    with Session(engine) as session:
        # 1. 主键精准查询:使用 session.get() 是最高效的单记录获取方式
        user_by_id = session.get(User, 1)
        print(f"主键为1的用户: {user_by_id}")

        # 2. 条件过滤查询所有匹配项
        stmt = select(User).where(User.age >= 20).order_by(User.age.desc())
        results = session.scalars(stmt).all()
        print("年龄大于等于20岁的用户列表:")
        for u in results:
            print(f"  - {u.name} (年龄: {u.age}, 邮箱: {u.email})")

        # 3. 查询单条记录(若未匹配返回 None,匹配多条时返回第一条)
        first_user = session.scalars(select(User).where(User.name == "张三")).first()
        print(f"根据姓名查找结果: {first_user}")
4.3 更新数据(Update)
更新数据有两种常见方式:一种是先查询出对象,直接修改其 Python 属性并提交事务(ORM 脏检查机制);另一种是直接使用 update() 表达式批量更新(无需先读入内存)。
from sqlalchemy import update

def update_user_by_orm():
    with Session(engine) as session:
        # 方式一:面向对象修改(推荐用于单条或带有业务逻辑的场景)
        user = session.scalars(select(User).where(User.name == "张三")).first()
        if user:
            user.age = 25  # 直接修改属性
            user.email = "zhangsan_new@example.com"
            session.commit()
            print("张三的信息已成功通过 ORM 属性变更更新")

def update_users_by_expression():
    with Session(engine) as session:
        # 方式二:Core 表达式直接更新(推荐用于无需加载对象的批量变更)
        stmt = (
            update(User)
            .where(User.age < 25)
            .values(age=User.age + 1)
        )
        result = session.execute(stmt)
        session.commit()
        print(f"批量更新完成,受影响行数: {result.rowcount}")
4.4 删除数据(Delete)
同更新操作类似,删除同样支持“查出后删除”与“按条件表达式直接删除”两种路径。
from sqlalchemy import delete

def delete_user_by_orm():
    with Session(engine) as session:
        # 方式一:查出对象后调用 session.delete()
        user = session.get(User, 1)
        if user:
            session.delete(user)
            session.commit()
            print("ID为1的用户已被删除")

def delete_user_by_expression():
    with Session(engine) as session:
        # 方式二:使用 delete() 语句批量删除满足条件的行
        stmt = delete(User).where(User.name == "赵六")
        result = session.execute(stmt)
        session.commit()
        print(f"按条件删除完成,删除条数: {result.rowcount}")
五、完整可执行代码演示(增删改查闭环)
以下是将上述步骤整合为一个完整独立脚本的代码,读者可直接保存为 crud_demo.py 并在本地执行测试:
# -*- coding: utf-8 -*-
# SQLAlchemy 2.0 增删改查完整示例脚本
from sqlalchemy import create_engine, select, update, delete, String, Integer
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

# 1. 建立 SQLite 文件引擎
engine = create_engine("sqlite:///demo.db", echo=False)

# 2. 声明数据模型
class Base(DeclarativeBase):
    pass

class Product(Base):
    __tablename__ = "products"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    title: Mapped[str] = mapped_column(String(100), nullable=False)
    price: Mapped[int] = mapped_column(Integer, nullable=False)
    stock: Mapped[int] = mapped_column(Integer, default=0)

    def __repr__(self) -> str:
        return f"<Product(id={self.id}, title='{self.title}', price={self.price}, stock={self.stock})>"

# 3. 初始化数据表
Base.metadata.create_all(engine)

# 4. 增删改查业务演练
if __name__ == "__main__":
    with Session(engine) as session:
        # 【Create 增加】
        p1 = Product(title="机械键盘", price=399, stock=50)
        p2 = Product(title="无线鼠标", price=129, stock=100)
        p3 = Product(title="4K显示器", price=1899, stock=15)
        session.add_all([p1, p2, p3])
        session.commit()
        print("[1. 插入数据] 成功插入 3 件商品")

    with Session(engine) as session:
        # 【Read 查询】
        stmt = select(Product).where(Product.price > 200).order_by(Product.price.desc())
        items = session.scalars(stmt).all()
        print(f"[2. 查询数据] 价格大于200元的商品共有 {len(items)} 件:")
        for item in items:
            print(f"    - {item.title} : 价格 {item.price} 元, 库存 {item.stock} 件")

    with Session(engine) as session:
        # 【Update 修改】
        prod = session.scalars(select(Product).where(Product.title == "机械键盘")).first()
        if prod:
            prod.price = 349  # 降价促销
            prod.stock -= 1   # 库存扣减
            session.commit()
            print(f"[3. 更新数据] 机械键盘调价为 {prod.price} 元,当前库存 {prod.stock} 件")

    with Session(engine) as session:
        # 【Delete 删除】
        del_stmt = delete(Product).where(Product.title == "4K显示器")
        res = session.execute(del_stmt)
        session.commit()
        print(f"[4. 删除数据] 已下架 4K显示器,影响行数: {res.rowcount}")

    with Session(engine) as session:
        # 【最终验证】
        all_prods = session.scalars(select(Product)).all()
        print(f"[5. 最终库存] 数据库当前剩余商品数: {len(all_prods)} 件")
        for p in all_prods:
            print(f"    - {p}")
执行该脚本后的控制台输出示例如下:
# 示例运行输出
$ python crud_demo.py
[1. 插入数据] 成功插入 3 件商品
[2. 查询数据] 价格大于200元的商品共有 2 件:
    - 4K显示器 : 价格 1899 元, 库存 15 件
    - 机械键盘 : 价格 399 元, 库存 50 件
[3. 更新数据] 机械键盘调价为 349 元,当前库存 49 件
[4. 删除数据] 已下架 4K显示器,影响行数: 1
[5. 最终库存] 数据库当前剩余商品数: 2 件
    - <Product(id=1, title='机械键盘', price=349, stock=49)>
    - <Product(id=2, title='无线鼠标', price=129, stock=100)>
六、ORM 模式与 Core 表达式更新/删除的机制差异
在实际工程开发中,开发者常对“先查再改”与“直接写表达式更新”的选择产生疑问。理解二者在运行机制与生命周期上的区别,有助于在性能与一致性之间取得平衡。
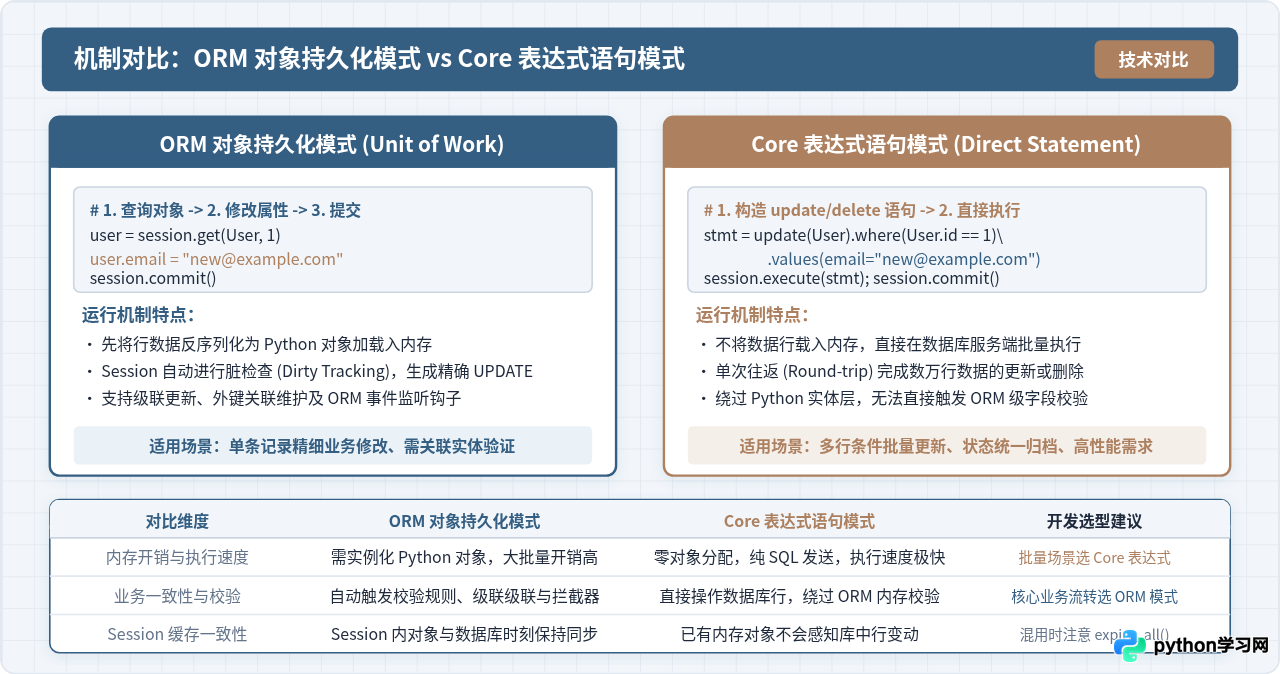
| 对比维度 | ORM 对象模式 (先查后改) | Core 表达式模式 (update/delete) |
|---|---|---|
| 实现代码 | obj = session.get(...); obj.field = val |
session.execute(update(...).values(...)) |
| 数据库交互 | 先执行一次 SELECT,提交时再执行 UPDATE | 直接发送一条 UPDATE/DELETE 语句,无前置查询 |
| 内存开销 | 需要将每一行反序列化为 Python 对象入池 | 无需实例化对象,内存开销极低 |
| 适用场景 | 单条数据的业务修改、依赖原有字段业务校验 | 批量数据状态翻转、全表或大区间字段重置 |
七、事务控制与常见踩坑排查(回滚机制与生命周期)
在数据库操作中,保持数据一致性至关重要。如果在操作过程中发生网络抖动、字段唯一键冲突(如重复的 email)或业务验证失败,必须及时回滚(Rollback)会话,避免脏数据影响连接池后续连接。
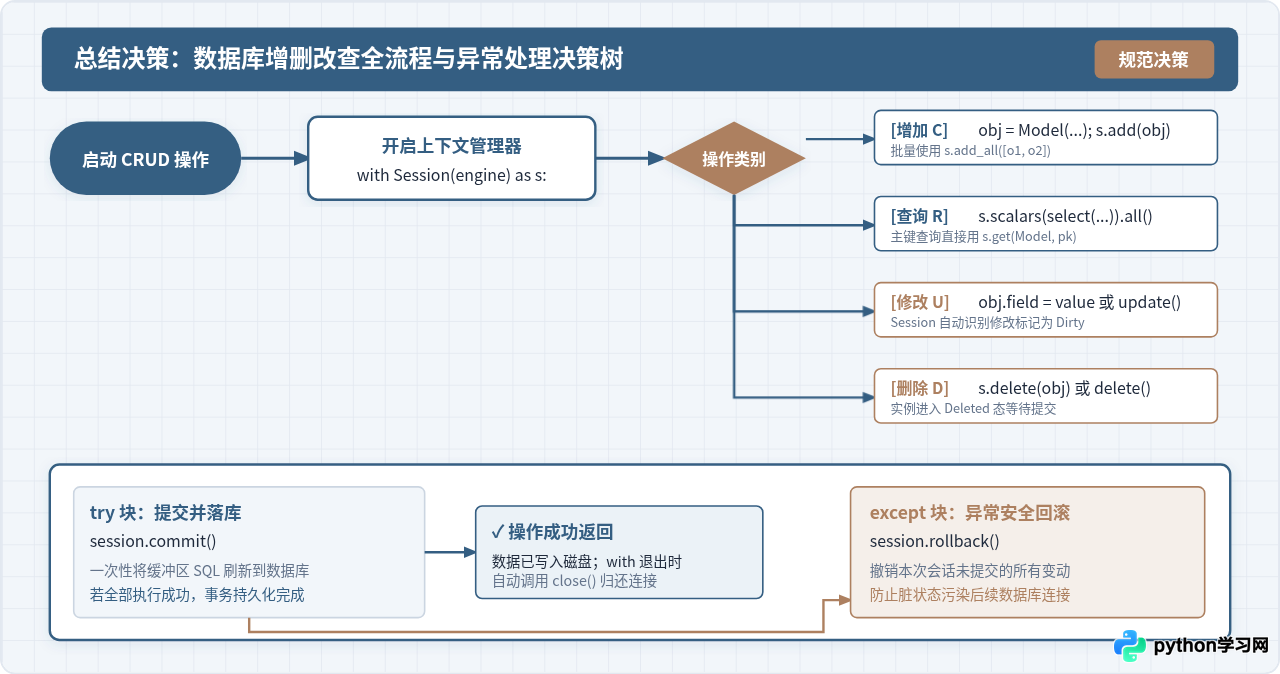
1. 标准的 try-except-rollback 容错模板
def safe_create_user(name: str, email: str, age: int):
    with Session(engine) as session:
        try:
            user = User(name=name, email=email, age=age)
            session.add(user)
            session.commit()
            print(f"用户 {name} 录入成功")
        except Exception as err:
            session.rollback()  # 发生异常时主动撤销未完成操作
            print(f"录入失败,事务已安全回滚。原因: {err}")
            raise err
2. 常见新手问题排查
- 问题一:数据未报错但数据库中找不到记录。
原因:未调用session.commit()。SQLAlchemy 的会话默认处于事务保护状态,若未显式 commit,所有暂存在缓冲区中的写入操作将在会话关闭时自动被废弃。 - 问题二:抛出
DetachedInstanceError异常。
原因:在with Session(...)代码块结束后,模型对象转为游离态(Detached)。此时如果访问尚未预先加载的延迟关联属性,SQLAlchemy 会因无法获取活跃数据库连接而报错。解决方法是在会话关闭前读取所有必要字段,或在查询时配置预先加载策略。 - 问题三:多线程下共用同一个 Session 对象出现竞态。
原因:SQLAlchemy 的Session实例不是线程安全的。在多线程或异步编程中,每个线程必须通过会话工厂独立创建专属的会话实例,或者在 Web 框架中使用由作用域管理的作用域会话(scoped_session)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















