


《Python数据分析与可视化》第二版相比第一版更新了哪些内容?
详细梳理《Python数据分析与可视化》第二版相比第一版在核心依赖、API语法规范、可视化工具链、实战案例设计及学习路径等方面的关键更新与差异对比。
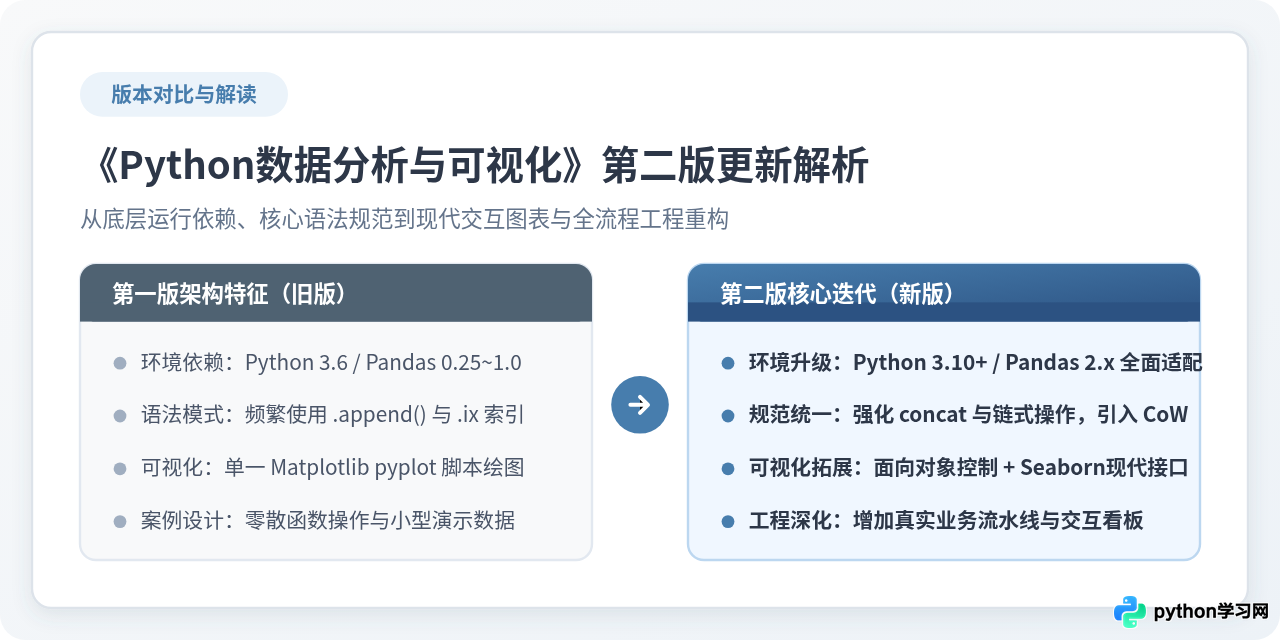
df.append()、df.ix[] 以及隐式视图修改等易错语法,将数据底座升级为高性能 PyArrow 引擎与写时复制(Copy-on-Write)机制,并将可视化体系从传统的单例脚本绘图转变为规范的面向对象控制与交互式看板,同时将案例工程从零散的演示数据集提升为工业级端到端业务流水线。
一、核心更新概览:教材技术栈的全面代际跨越
在数据科学与分析领域,近几年 Python 生态经历了显著的底层演进。第一版教材编写时,行业基准多建立在 Python 3.6~3.7 和早期版本的 Pandas(0.2x~1.0)之上。随着 Pandas 2.0 的正式发布,大量早期过渡性语法被永久移除,内存管理机制也发生了本质改变。第二版教材针对这一代际跨越,重构了全书的示例、知识脉络与技术边界。
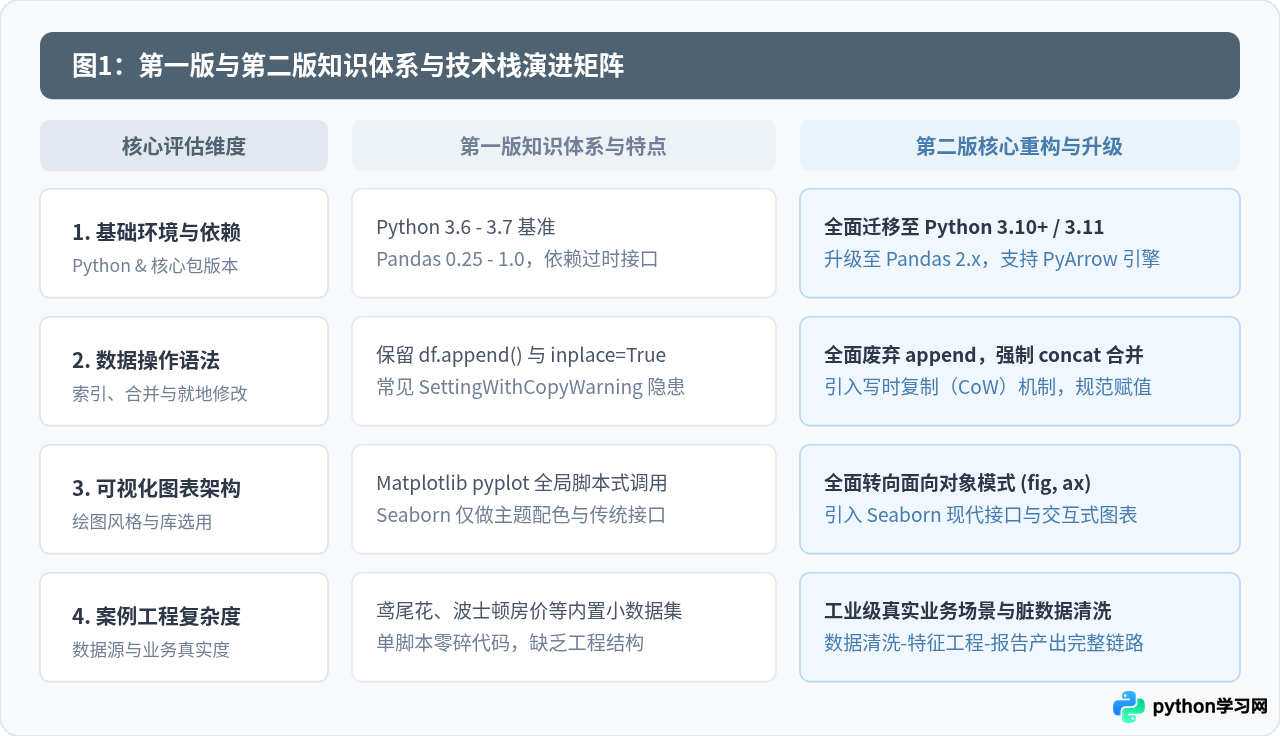
从知识矩阵来看,第二版在四个核心维度进行了结构性调整:
- 依赖底座升级:全书运行环境整体平移至 Python 3.10 与 3.11 平台,第三方库全面采用 Pandas 2.x、Matplotlib 3.8+ 及 Seaborn 0.13+,杜绝了读者按照书本操作直接报错的环境不一致问题。
- 语法规范彻底清洗:全面清除被官方正式废弃的 API,规范数据切片、索引与批量合并方式,杜绝第一版中常见的警告信息。
- 可视化体系重构:彻底告别
plt.xxx()的全局状态机调用习惯,全面建立以Axes轴对象为核心的面向对象绘图规范,并引入现代声明式绘图体系。 - 案例工程化重塑:用覆盖“脏数据清理—多源关联—统计分析—多维度报表展示”的综合闭环项目,替代原先割裂的玩具级单步练习。
二、依赖库底座升级与废弃语法淘汰
对初学者和工程开发者而言,第二版最直观的变化在于运行时的确定性与安全性。如果在安装了最新版 Pandas 的环境中运行第一版的随书代码,最常见的问题就是代码直接抛出 AttributeError 崩溃。
| 功能场景 | 第一版实现方式(旧版) | 第二版实现方式(新版) | 改动原因与收益 |
|---|---|---|---|
| 数据行拼接 | df.append(row, ignore_index=True) 已移除 |
pd.concat([df, pd.DataFrame([row])]) 标准 |
Pandas 2.0 永久移除 append 方法,统一由 concat 负责,避免低效反复申请内存。 |
| 位置与标签索引 | 混用 df.ix[x, y] 或模糊切片 |
严格区分 df.loc[] 与 df.iloc[] |
彻底消除混合类型索引时的歧义,杜绝不可控的切片行为。 |
| 字符串数据存储 | NumPy object 基础类型 |
可选 string[pyarrow] 高性能引擎 |
减少 50%~70% 的内存消耗,大幅提升字符串正则过滤与切分性能。 |
| 切片写时保护 | 频繁触发 SettingWithCopyWarning |
启用 Copy-on-Write (CoW) 规范 | 消除隐式浅拷贝陷阱,赋值行为更具确定性,不再产生悬空引用。 |
| 就地修改属性 | 重度依赖 inplace=True 参数 |
链式重写 df = df.func() |
社区正逐步废弃 inplace 参数,第二版全面推荐显式重新赋值。 |
for index, row in df.iterrows(): df = df.append(...) 是典型反模式。在第二版中,该模式被彻底重构为列表推导式收集字典、或构建中间列表后单次调用 pd.concat(),执行效率可实现数十倍至上百倍的提升。
三、实战:旧版代码与开发环境平滑迁移操作步骤
为了帮助手头有第一版代码或正在维护老工程的读者顺利过渡,第二版教材在附录与开篇章节中总结了一套标准的四步排查流程。
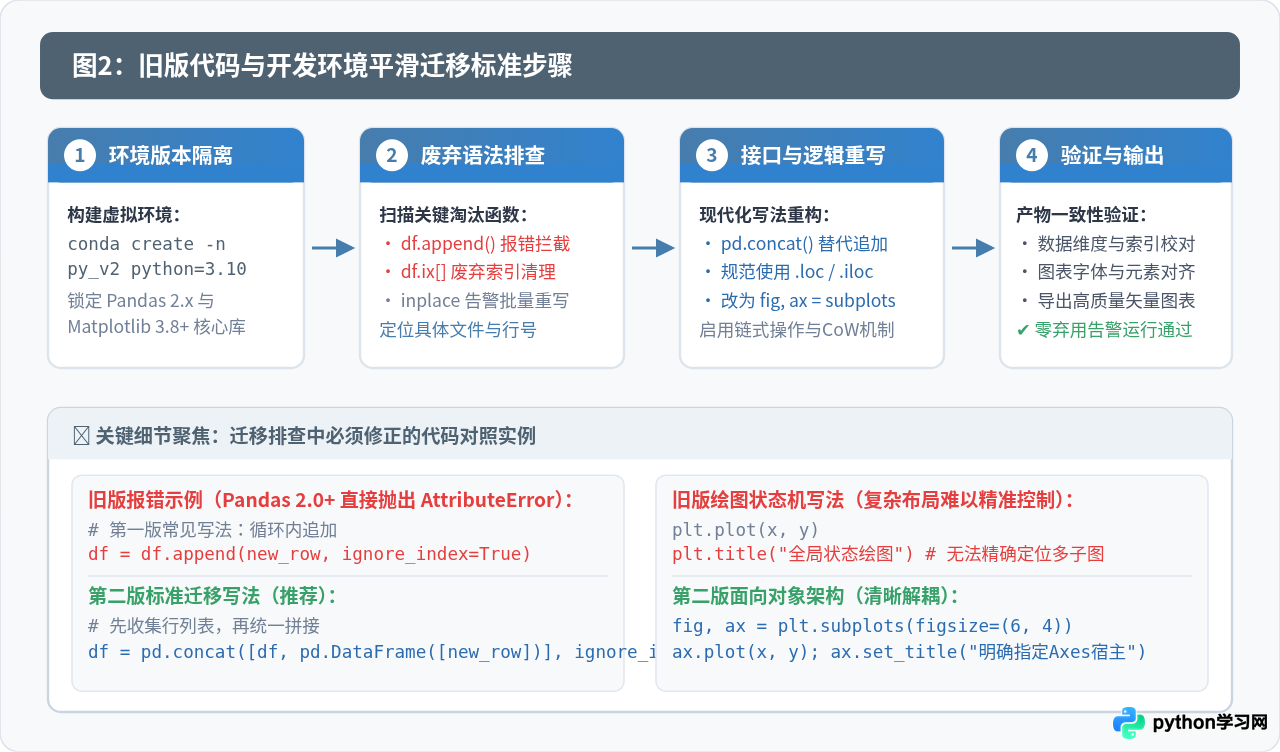
步骤 1:构建隔离的第二版验证环境
在终端中切勿直接覆盖全局环境,使用 Conda 或 Python 虚拟环境工具进行环境隔离:
步骤 2:定位淘汰方法并进行语法替换
对现有代码进行检索,排查 .append()、.ix[] 等已被移除的标识符。以下是具体重构对照代码:
步骤 3:重构可视化脚本为面向对象体系
第一版常用的 plt.plot() 全局命令难以精准控制多子图的轴范围、共享坐标轴及次要刻度。第二版全流程推行 fig, ax = plt.subplots():
步骤 4:验证数据产物与去除运行时告警
运行脚本时,确保终端不再抛出 FutureWarning 与 SettingWithCopyWarning。第二版要求代码在零告警状态下运行,确保数据清洗结果的一致性。
四、核心 API 语法演变与可视化机制深度对比
很多读者好奇:第二版除了修复报错,在分析效能和表现力上究竟有哪些质的提升?本节通过关键细节对比深入说明。
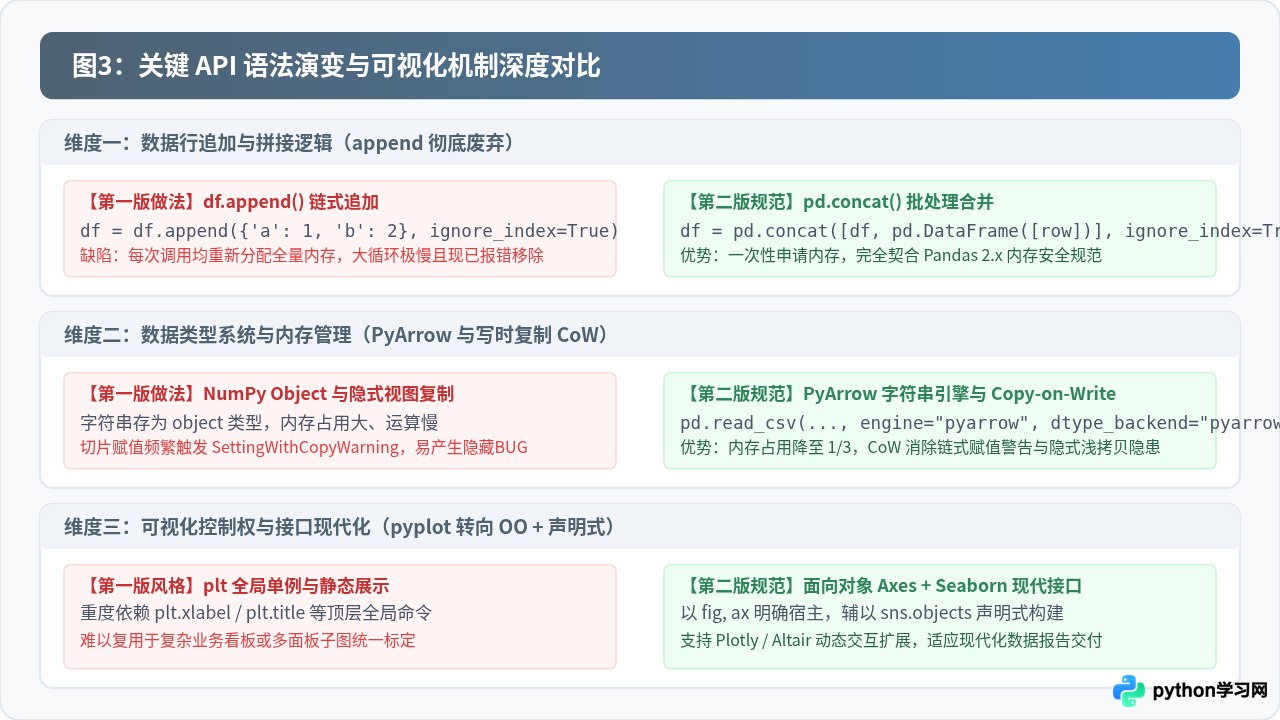
1. 引入 PyArrow 数据后端带来的性能跃升
第一版中处理含有大量文本标签或字符串分类的表格时,NumPy 的 object 类型不仅占用大量内存,而且缺乏对缺失值(Missing Values)的原生一致性支持(np.nan 与 None 混杂)。第二版介绍了如何借助 PyArrow 驱动数据导入:
2. Seaborn 0.12+ 现代对象体系(objects interface)
第一版对于 Seaborn 的讲解大多停留在单一功能函数(如 sns.distplot(),该方法现已被官方废弃并由 sns.displot() 或 sns.histplot() 代替)。第二版不仅更新了基础绘图函数,还引入了符合图形语法(Grammar of Graphics)的现代化构建模式:
五、综合实战案例工程的重构
教材案例的实用程度直接决定了学习者的迁移能力。第一版教材的实战部分通常以经典教学数据集为主(例如鸢尾花、泰坦尼克号生还者、波士顿房价等)。随着时代发展,波士顿房价数据集由于伦理问题已被 scikit-learn 正式下线,传统玩具数据集也难以反映现代企业的实际业务痛点。
第二版在案例章节做出了如下针对性革新:
- 贴近现代真实商业场景:引入电商用户行为漏斗分析、在线内容平台用户留存、新能源车电池传感器时序监控、金融风控特征工程等具有现实参考价值的案例。
- 涵盖脏数据与异常值完整生命周期:第一版往往直接提供规整好的 CSV 文件;第二版则真实还原时间戳时区不一致、字符集编码混杂、空值与无效字符串并存、重复打卡流水等现实清洗环节。
- 交付形态多元化:除了静态图片导出,第二版增加了现代数据科学报告常用的动态交互可视化看板(如结合 Plotly 制作可缩放、支持鼠标悬停浮动卡片的 HTML 交互图表),更贴近当下企业数据汇报需求。
六、读者选择建议与升级决策路径
很多读者面临具体的选择疑问:“手头已有第一版,究竟有没有必要购买或系统翻阅第二版?”答案取决于你的学习阶段和具体需求。
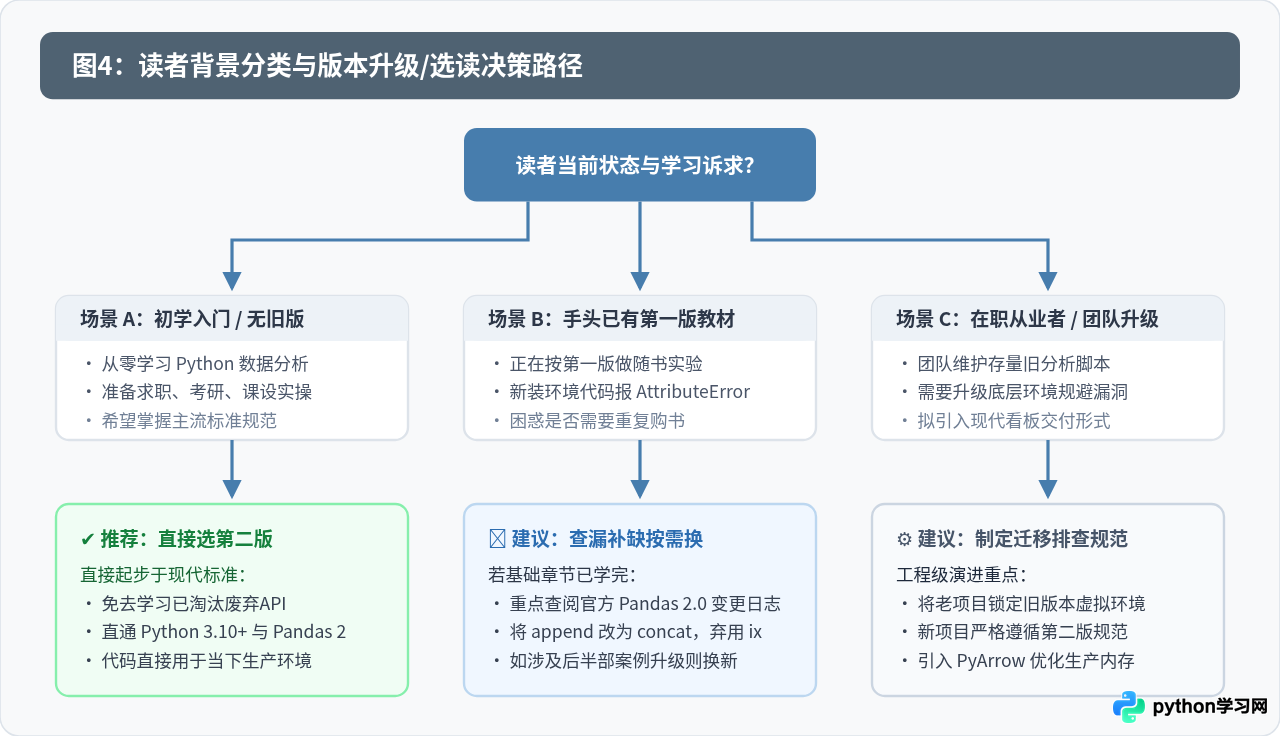
以下是明确的参考依据:
- 如果是零基础或初次系统学习:强烈建议直接选用第二版。从第一版学起会导致读者在开头就掌握已被废弃的 API,后续在最新环境中编写代码将频繁受挫,重新建立规范的试错成本较高。
- 如果已经学完第一版前半部分基础:若你的核心诉求是了解更新点,无需通篇重读。建议重点查阅本文列出的四项废弃语法、阅读 Pandas 2.0 官方 Migration Guide,并重点研读第二版新增的高阶可视化与综合实战案例章节。
- 如果是高校师生或团队技术负责人:建议更新课程大纲或团队编码规范至第二版基准,统一开发环境版本(Python 3.10+ / Pandas 2.x),从根本上避免因为教学代码或遗留脚本与现代工具链脱节引发的兼容性故障。
七、常见问题解答(FAQ)
Q1:我在第一版环境写的代码,能一键无缝运行在第二版配套环境里吗?
通常不能。只要老代码中使用了 df.append()、df.ix[]、或依赖早期版本的 sns.distplot(),在第二版推荐的最新环境中就会直接触发报错或中断执行。必须按照第二节和第三节的方法完成关键 API 重构。
Q2:如果因为老旧业务系统限制只能使用 Python 3.7,第二版教材适用吗?
第二版的核心分析思维与面向对象可视化方法论依然具有指导意义,但需要注意:Python 3.7 无法安装 Pandas 2.0 及以上版本(Pandas 2.0 最低要求 Python 3.8+)。如果运行环境被严格限制在 Python 3.7,建议保持第一版对应依赖(Pandas 1.3 左右)进行开发,但编写代码时应主动避开已被标记过时的老语法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















