


Python字符串split()方法基础语法与默认空白处理
深入解析Python字符串split()方法的基础语法、参数规则以及默认空白处理机制。通过细致的代码示例、机制对比与流程图解,讲清sep=None的连续空白折叠和首尾空白剔除原理,帮助开发者避开split(' ')常见陷阱。
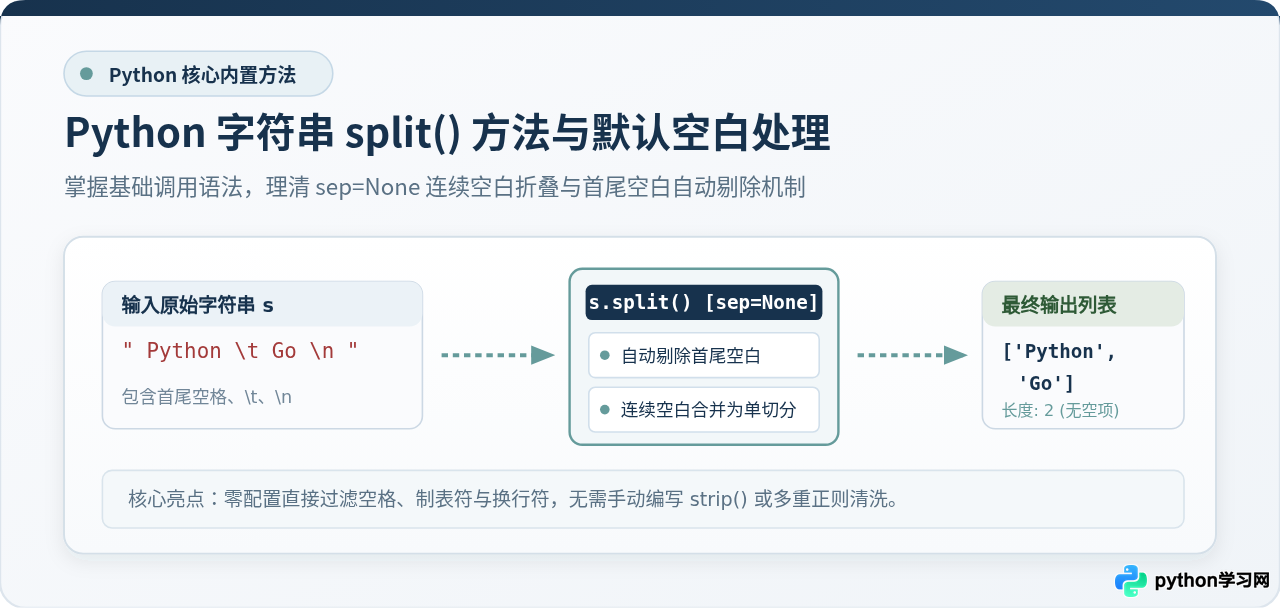
在 Python 文本处理中,str.split() 是最常用也是最容易被误读的方法之一。它的核心功能是将一个字符串依照指定规则拆分成子字符串列表。如果不显式传递任何参数,split() 默认执行一套高度优化的空白处理机制:自动丢弃字符串首尾的所有空白,并将中间任意多个连续的空格、制表符与换行符整体视为单一分隔符。理解这一默认机制与显式传入分隔符的区别,是编写健壮文本解析代码的基本功。
一、split() 基础语法与核心参数
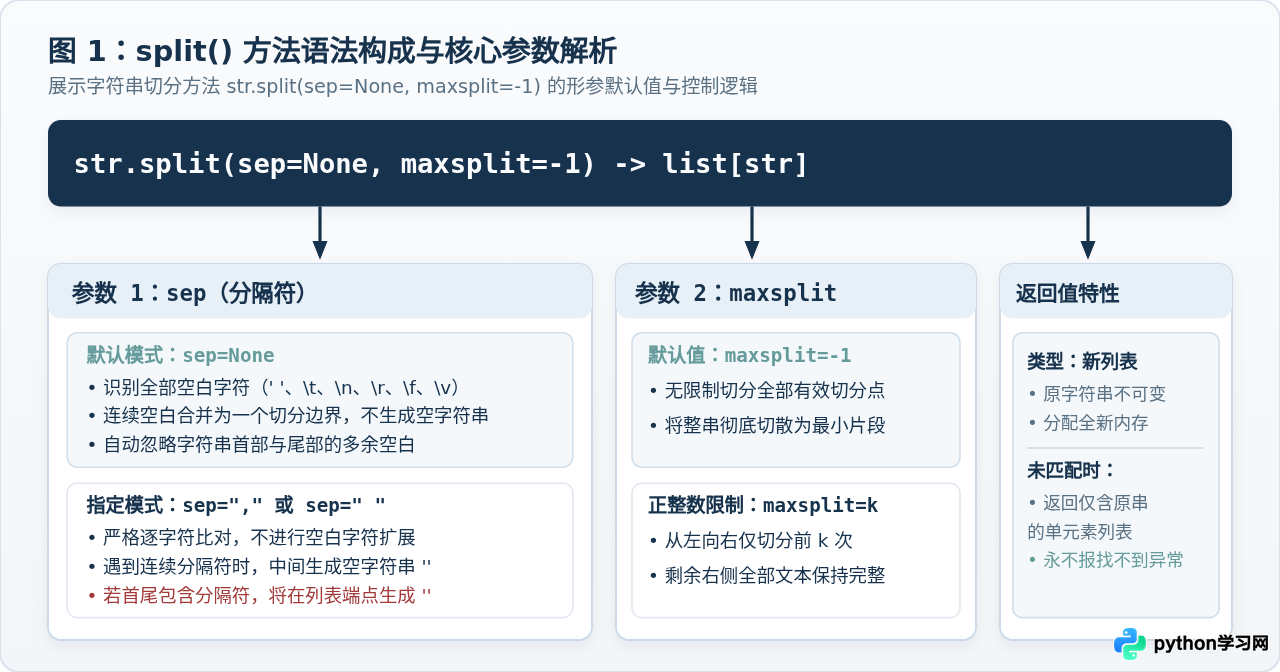
Python 官方内置的 str.split() 完整定义签名如下:
str.split(sep=None, maxsplit=-1) -> list[str]该方法接收两个可选参数,其具体功能与默认行为如下:
sep(分隔符):指定用于拆分字符串的界定字符或子字符串。默认值为None。当sep=None时,采用“空白字符算法”;当显式指定为非空字符串(如','、' ')时,采用“精确匹配算法”。需要特别注意,sep不能传入空字符串"",否则会抛出ValueError: empty separator。maxsplit(最大切分次数):指定最多执行切分的次数。默认值为-1,表示“无限制切分”,即把字符串中所有符合条件的分隔点全部切开;如果传入非负整数k,则至多切分k次,返回的列表长度至多为k + 1,字符串剩余未切分的部分将完整保留在列表的最后一个元素中。- 返回值类型:无论切分成功与否,始终返回一个全新构造的
list[str]。因为 Python 字符串具备不可变性(Immutable),调用split()绝不会修改原字符串变量的内容。
二、默认空白处理机制(sep=None 的三项核心规则)
当调用 s.split() 且不传递 sep 参数(即保留默认值 None)时,Python 会启动一套智能的空白聚合算法。这套算法包含三个关键行为:
1. 识别并归拢全部空白字符族
默认模式下认定的“空白”不仅限于普通的半角空格,而是覆盖全部 ASCII 空白字符,包括制表符( )、换行符(
)、回车符( )、进纸符( )以及垂直制表符(),并包含 Unicode 标准中定义的所有空白字符。只要遇到任意这些字符连续出现,Python 都会将其合并视作一个切分单元。
# 示例代码:混合空白字符切分
text = "Python		is

great
and   fast"
words = text.split()
print("切分结果:", words)
print("列表长度:", len(words))
可以看到,无论是两个制表符 ,还是跨平台的回车换行
或连续三个空格,都被合并成了单一的分隔点,提取出的单词干干净净。
2. 自动剔除首尾空白,不产生边界空字符串
在很多编程语言中,如果文本头部或尾部存在分隔符,切分后通常会在列表首尾留下空字符串 ""。但在 Python 中,s.split() 会先自动跳过字符串首部和尾部的全部空白字符,仅在有效文本之间寻找切分点。这意味着你无需在切分前专门调用 s.strip().split(),直接调用 s.split() 就能得到完全干净的结果。
3. 空字符串与全空白字符串的安全返回
对于仅由空格、制表符构成的全空白字符串,或者长度为 0 的纯空字符串 "",s.split() 默认都会直接返回一个空列表 [],而不会返回 ['']。这种设计非常符合列表迭代与布尔判断的直觉。
# 示例代码:边界空值处理
empty_str = ""
space_str = "
   "

print("纯空串 split():", empty_str.split())
print("全空白 split():", space_str.split())三、关键避坑:s.split() 与 s.split(' ') 的本质区别
很多初学者甚至有一定经验的开发者,常常下意识地认为 s.split() 就是 s.split(' ') 的简写。这是 Python 字符串处理中最典型的认知误区之一。两者的底层逻辑截然不同:
| 对比维度 | s.split() [sep=None 默认模式] | s.split(' ') [sep=' ' 显式空格] |
|---|---|---|
| 匹配对象 | 任意空白字符(空格、 、 、 等) | 仅严格匹配单个半角空格 ' ' |
| 连续空格处理 | 自动折叠合并,视作单个分隔点 | 严格切分,每两个相邻空格之间生成 '' |
| 首尾空格处理 | 自动丢弃,不生成空字符串 | 在结果列表首尾产生 '' 元素 |
| 空字符串输入 | "".split() 返回 [] |
"".split(' ') 返回 [''] |
| 制表符/换行符 | 自动作为分隔符处理 | 不视作分隔符,保留在子字符串内 |
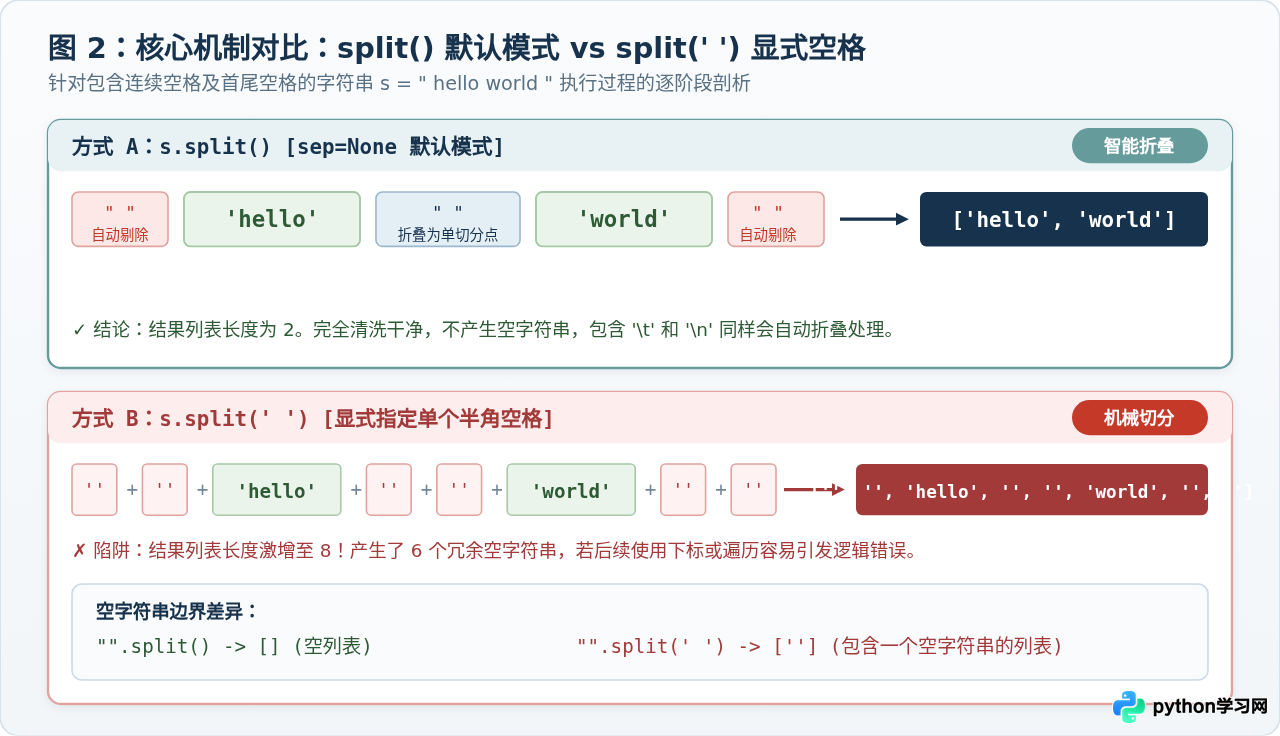
让我们通过一段具体的代码直观感受两者的巨大反差:
# 示例代码:两种切分模式的鲜明对比
raw_data = "  hello   world  "

res_default = raw_data.split()
res_explicit = raw_data.split(' ')

print("res_default :", res_default, "=> 长度:", len(res_default))
print("res_explicit:", res_explicit, "=> 长度:", len(res_explicit))
可以看到,原本只有 2 个词的字符串,使用 split(' ') 切分后长度竟然变成了 8,充斥着 6 个无意义的空字符串 ''。若后续代码直接使用索引访问(如 res_explicit[1]),就会获取到空字符串而非期望的单词;若是进行统计计数,结果更会彻底失真。因此,凡是需要按自然空白切词的场景,务必直接使用 split(),切勿显式传入 ' '。
四、maxsplit 参数的执行原理与实用场景
maxsplit 参数控制切分的最大次数。了解它的运作过程有助于高效解决很多常见的数据解析需求。
1. 切分终止与剩余保留机制
当指定 maxsplit=k 时,Python 会从左到右依次寻找分隔符。每次找到有效分隔符时,切分计数器加 1。一旦计数器达到 k,Python 就会立刻停止后续匹配,并将剩余的所有文本作为一个独立的完整字符串放入列表中。
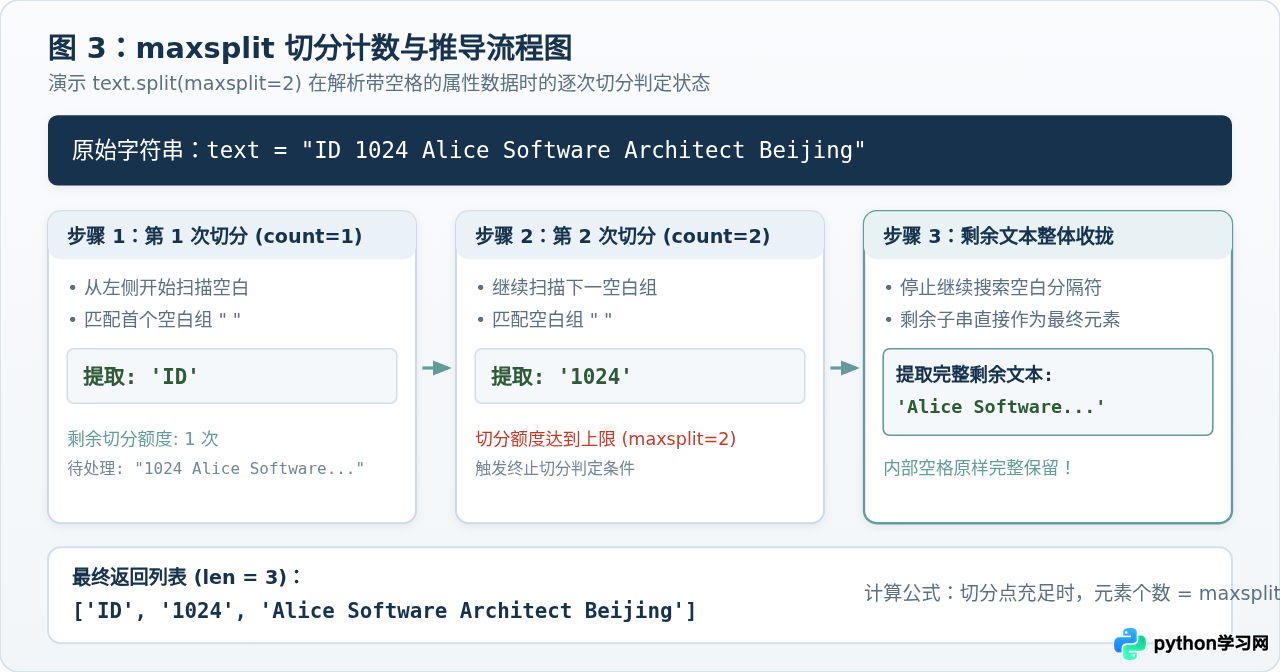
2. 典型实战场景:解析键值对与配置指令
在解析日志文本或命令行参数时,往往只有前几个字段有固定的结构,而后面的内容本身可能包含空格或分隔符。此时 maxsplit 能发挥极大的威力:
# 示例代码:解析用户发帖数据或命令行输入
command_line = "POST 200 /api/v1/user Query succeeded with 0 errors"

# 仅切分前 3 个字段:动作、状态码、路径,保留后续完整消息
parts = command_line.split(maxsplit=3)
action, status_code, path, message = parts

print("动作:", action)
print("状态码:", status_code)
print("请求路径:", path)
print("附带消息:", message)
如果不限制 maxsplit,后面的 Query succeeded with 0 errors 就会被强行切散成 5 个独立单词,破坏了原本完整的句子语义。
五、常见边界情况与使用注意事项
在实际工程开发中,围绕 split() 有几个容易被忽视的边界场景,需要特别警惕:
经常有开发者直接使用多变量解构赋值,例如 first, last = full_name.split()。如果用户输入了三个词(如包含中间名),或者只输入了一个词,Python 都会直接抛出 ValueError: too many values to unpack 或 not enough values to unpack。
稳妥做法:配合带星号的解构语法 first, *middle, last = s.split(),或者先判断切分后列表的长度。
当需要从字符串末尾开始限制切分时(例如提取文件的扩展名),如果直接使用 split('.', 1),切分的将是最左侧的第一个点号。正确的做法是使用 rsplit('.', 1)。
例如:"archive.backup.tar.gz".rsplit('.', 1) 会准确得到 ['archive.backup.tar', 'gz']。
六、总结与切分策略决策指南
Python 提供了丰富的字符串拆分手段。为了在不同场景下写出最简洁、不易出错的代码,可以参考以下选型决策:
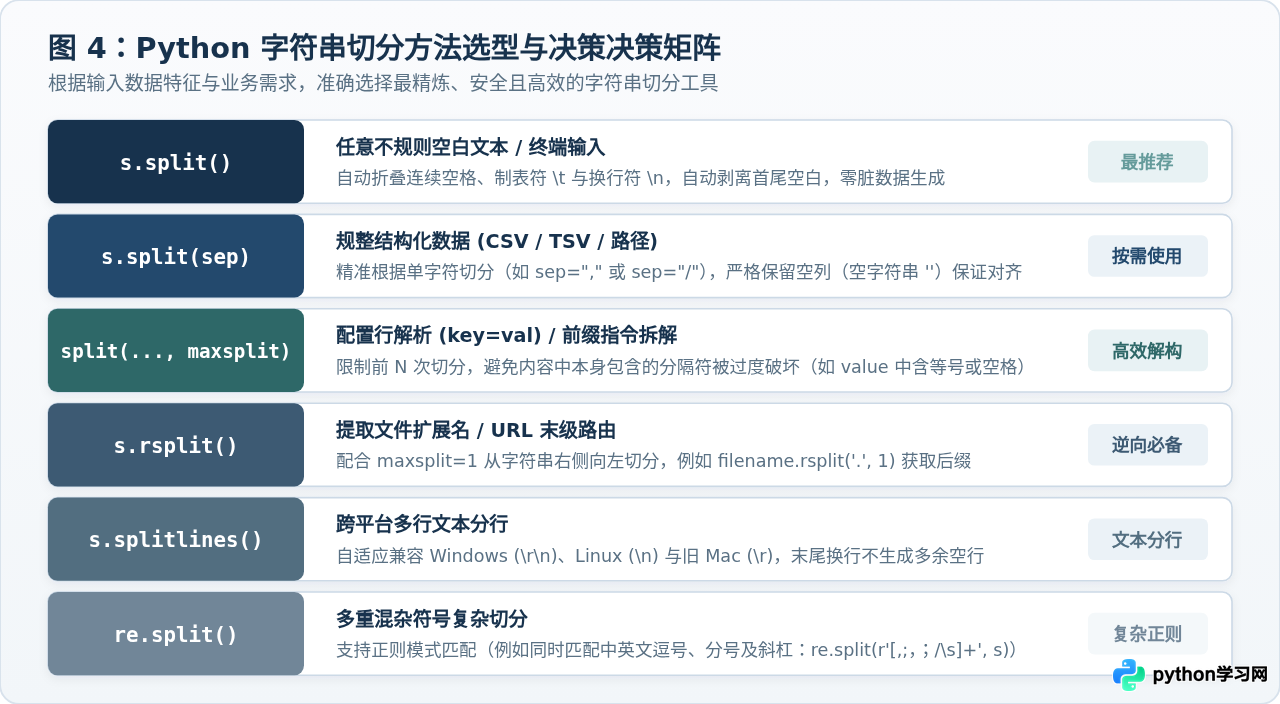
- 自然文本优先无参调用:处理用户输入、自然句子、日志单词时,直接写
s.split(),它会自动处理首尾空格和多连空格。 - 分清
s.split()与s.split(' '):前者折叠所有空白且剔除首尾;后者机械匹配单个空格且产生大量空字符串''。 - 空串安全:
"".split()返回[],而"".split(',')返回['']。 - 固定字段数量解构:善用
maxsplit=N防止后半段内容被误切,配合解构赋值更安全高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















