


怎么高效查找和评估适合的Python第三方库?
从需求边界提炼、权威检索渠道、指标迷思辨析到多维技术体检与沙盒验证,系统化讲解如何高效查找与评估适合项目的Python第三方库。
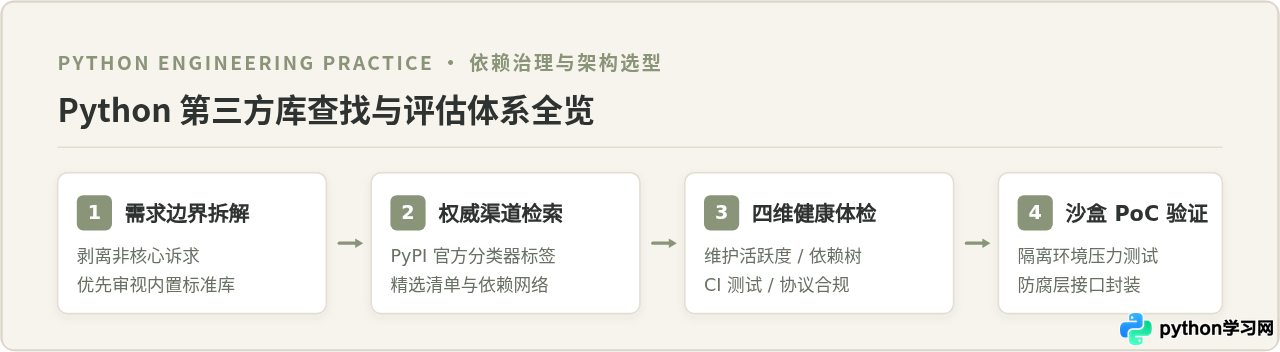
一、明确需求边界:先审视标准库与原子功能
在着手查找任何外部库之前,第一步必须是界定“最小需求原子”。很多开发者在遇到问题时,容易顺着搜索引擎直奔大型解决方案,从而不自觉地为一个微小的功能引入庞大的外部框架。例如,若项目只需要按行读取并解析结构固定的 CSV 文件,标准库自带的 csv 模块便已足够稳定快速;只有在面对复杂的宽表统计、多源合并或类型推断时,引入 pandas 或 polars 才具备工程合理性。
现代 Python(Python 3.10+)的标准库已经内置了大量过去依赖第三方库的优秀功能:
- 路径与文件操作:内置的
pathlib提供了面向对象的直观路径封装,彻底取代了零散的os.path操作。 - 结构化数据建模:
dataclasses与新版类型系统足以应对轻量数据类,未必要立即引入运行时代价更高的pydantic。 - 轻量级持久化:内置的
sqlite3足以支撑本地单机缓存,无需额外依赖外部嵌入式数据库客户端。 - 结构化并发与异步:内置的
asyncio已经成熟,绝大多数日常异步任务无需依赖第三方特定事件循环驱动。
当经过审视,确认业务逻辑超出标准库能力范围、或者自研需编写数百行复杂且易错的代码时,第三方库的引入才具备必要性。此时应写下一份包含核心入参、期望返回值、性能要求与部署环境(如目标 Python 版本)的“最小需求规格”。
二、权威查找渠道:建立高质量的候选短名单
不要直接在常规网页搜索引擎中输入泛化的中文关键词,那往往会返回大量年代久远、相互抄袭的博客文章,甚至把早已停更的库排在首页。建立候选池的最佳路径是依托官方索引与专业社区的分类机制。
建议按以下三个层级的渠道依次排查:
- PyPI 官方索引(pypi.org)高级过滤:利用 PyPI 的分类器(Classifiers)进行精准过滤。重点查看
Programming Language :: Python :: 3.11等支持标签、开发阶段(Development Status 如 Production/Stable),以及最后一次版本的发布日期。 - 社区精选主题清单(Awesome-Python & GitHub Topics):由领域资深维护者持续甄选维护的项目清单,能帮你迅速定位到某一细分领域内公认前两到三名的候选项目。
- 生态拓扑与安全评分工具(Libraries.io & OpenSSF Scorecard):通过这些平台可以查看候选项目被多少开源项目作为依赖引入、安全漏洞披露历史,以及自动化安全审计评分。
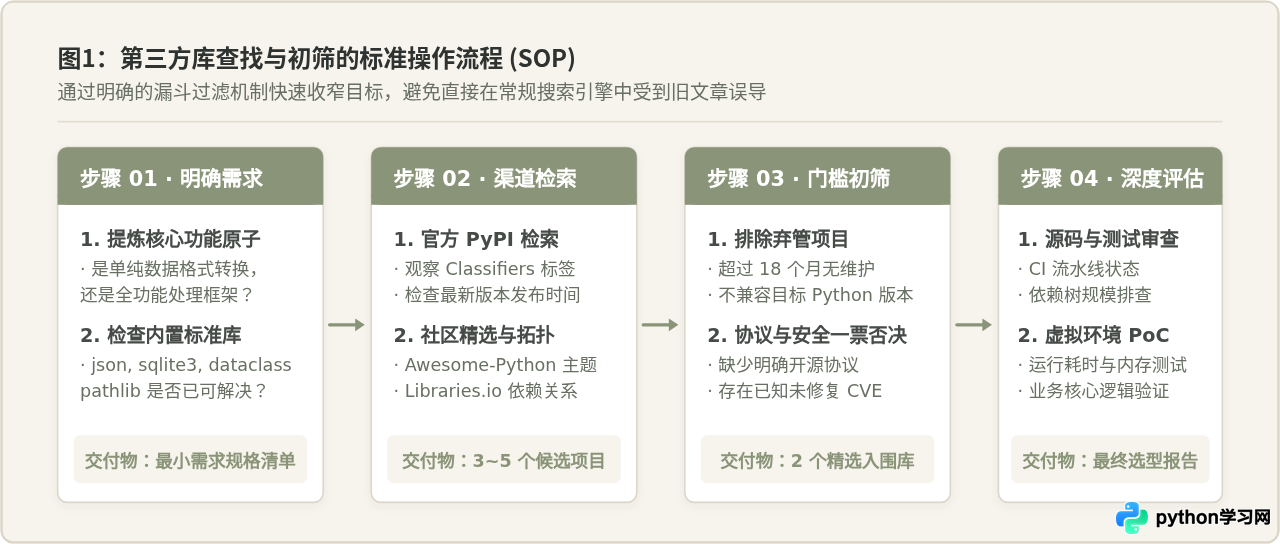
初筛阶段的目标不是直接敲定唯一的库,而是从全网候选者中快速筛除“明显不合格者”,最终收敛至 2 到 3 个候选库,形成评估短名单。
三、指标辨析:破除 Star 与周下载量的认知迷思
在开源生态中,最容易诱导开发者误判的往往是两个被频繁讨论的表层数据:GitHub Stars 数量与 PyPI 下载量。
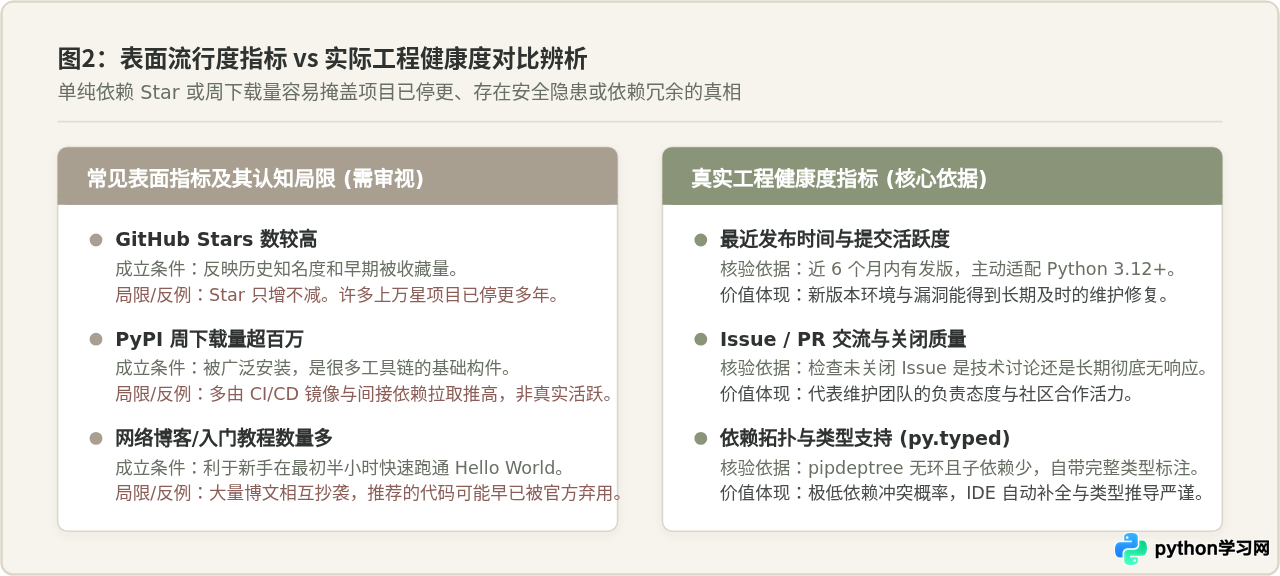
迷思一:“GitHub Star 越多的库一定越好、越适合”
这种说法看似合理的原因:Star 数量直观体现了项目的历史知名度、曝光量以及社区早期的认同感。对于像 requests 或 fastapi 这样的知名基础设施,庞大的 Star 数量确实反映了广泛的用户基数。
在哪些条件下成立:当评估属于宽泛的基础框架,且该项目由知名基金会或全职商业公司持续注资维护时,Star 数与生态成熟度通常呈正相关。
为什么必须修正与反例:Star 具有“只增不减”的单向累积属性。一个在十年前极其流行但已停更三年以上的库,其 Star 数可能仍然停留在两万以上;然而当你在 Python 3.12 环境中安装它时,可能会直接遭遇底层 C 扩展编译失败或 DeprecationWarning 升级报错。相反,许多诞生于近两三年、代码风格纯粹、完整支持现代异步与类型注解的轻量工具库,可能只有几百颗 Star,但在代码健康度与现代 Python 的契合度上远胜陈旧的大型库。
迷思二:“PyPI 周下载量超百万就代表稳定无风险”
这种说法看似合理的原因:极高的下载量往往意味着被成千上万的项目所引用,通常被视为经过了大规模现实环境的检验。
在哪些条件下成立:下载量能证明该库打包格式标准,在各大主流操作系统及架构上能被 pip 正常拉取和解压。
为什么必须修正与反例:PyPI 的统计口径包含了大量的持续集成(CI/CD)流水线反复拉取、云原生容器构建以及镜像站点的定时全量同步。如果某个底层库被某个陈旧的历史包作为传递依赖关联,哪怕该库本身漏洞频发、API 极其晦涩,它的统计下载量依然会随着现代 CI 任务的激增而水涨船高。高下载量无法直接证明项目的 API 人体工学优秀,更不能代表其维护团队当前处于积极响应状态。
四、多维技术体检:源码与工程治理的排查方法
在候选短名单确立后,需要从代码仓库的治理细节入手,执行四个维度的“技术体检”。
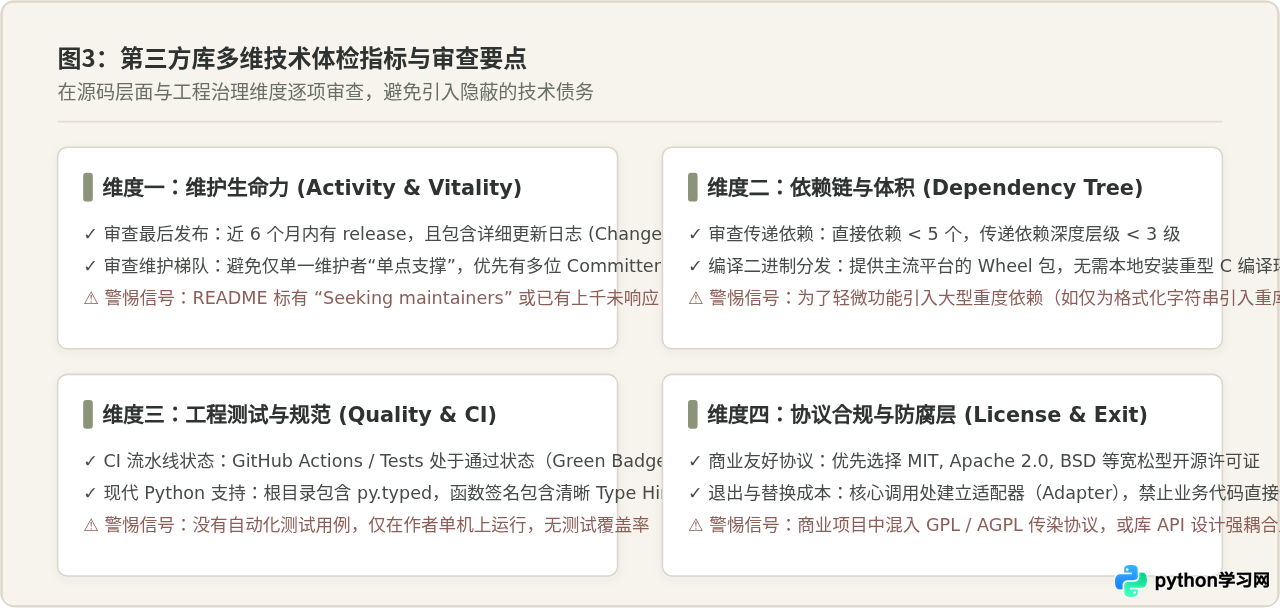
1. 维护生命力与团队响应(Activity & Vitality)
进入候选库的 GitHub 仓库,审查其生命体征:
- 版本发布频次:观察近 6 个月内是否有 Release。稳定的项目通常保持按季或按半年的迭代节奏,且附带详尽的 Changelog 说明。
- Issue 与 PR 的消化效率:不仅要看未解决(Open)的数量,更要看最近两个月新提交的 Issue 是否有维护者参与互动。如果列表前 10 个 Issue 全由用户提出且没有任何官方回复,表明项目维护力量极度匮乏。
- 维护者梯队结构:通过 Insights 观察贡献者图表。如果 99% 的提交全依赖某位单一作者,意味着项目承受着极高的“巴士系数(Bus Factor)”风险;一旦该作者生活节奏改变,整个库将迅速陷入事实弃管。
2. 依赖链深度与体积控制(Dependency Tree)
软件工程中的重大脆弱性多由传递依赖(Transitive Dependencies)引入。如果一个简单的工具库引入了 20 个子依赖,那么未来任何一个子依赖的版本冲突都会阻塞整个主项目的升级。
可以通过安装并运行 pipdeptree 工具,在沙盒中打印完整的依赖拓扑:
# 在隔离虚拟环境中安装候选库与依赖树分析工具
pip install candidate-pkg pipdeptree

# 打印特定包的依赖树深度
pipdeptree -p candidate-pkg理想的候选库应当依赖克制。如果输出展现出多达五层嵌套、包含已被弃用的底层包,或者为了一个极简单的函数引入了大型编译二进制包,应当果断下调该库的候选优先级。
3. 工程测试完备度与现代语言规范(Quality & CI)
- 持续集成徽章(CI Status):检查主干分支的 GitHub Actions 或自动化流水线是否全绿。关注其构建矩阵是否覆盖了你项目所需的目标 Python 版本。
- 单元测试覆盖率:查看仓库是否包含完整的
tests/目录,测试用例是否真实覆盖了边界异常与边缘分支。 - 类型系统支持:现代 Python 开发高度依赖静态类型检查(如
mypy,pyright)。检查仓库根目录下是否包含py.typed标记文件,函数签名是否标有规范的 Type Hints。缺乏类型提示的库在大型项目中会导致协同维护成本大幅增加。
4. 许可证合规性与商业边界(License Compliance)
许可证是一票否决项。必须在库的根目录查看 LICENSE 文件:
- 商业友好型(宽松型):
MIT、Apache-2.0、BSD-2-Clause / BSD-3-Clause。这类协议允许在闭源商业软件中自由集成与二次分发,仅需保留原作者版权声明。 - 传染型协议:
GPL-3.0、AGPL-3.0。若在闭源商业产品中直接静态引入 GPL 依赖,可能会面临整体源码被迫开源的法律风险。除非企业有专门的法务指引,否则在商业项目中应避开传染型库。
五、隔离验证与防御封装:PoC 与退出策略
即便所有纸面指标均符合要求,也不要直接将新库写入核心项目的 requirements.txt。必须通过沙盒原型(PoC)检验其真实的执行特征。
1. 沙盒环境下的最小可行性验证(PoC)
使用标准虚拟环境工具创建干净的临时沙盒:
# 创建并进入干净的独立测试环境
python3 -m venv .venv_poc
source .venv_poc/bin/activate

# 测量导入耗时(观察是否拖慢应用冷启动)
python -X importtime -c "import candidate_pkg"随后编写一段最小业务场景脚本,重点测试三个维度的行为:
- 异常体系是否自洽:该库抛出的错误是继承自自建的明确异常基类,还是直接抛出无意义的通用
Exception? - 资源是否安全释放:网络连接或文件句柄是否提供合乎规范的上下文管理器(
with语句)支持? - 高并发或边界负载表现:输入空数据、超大数据或格式损坏数据时,是否会发生段错误(Segmentation Fault)或未捕获的恐慌。
2. 防御性设计:建立防腐层适配器(Adapter Pattern)
在正式引入业务代码时,应严格避免在各个业务模块中直接 import candidate_pkg。工程最佳实践是设计一个浅层的内部适配层(Anti-Corruption Layer)。
例如,引入某个 JSON 序列化优化库时,在项目内建立统一的网关封装:
# 位于 internal/serializer.py
from typing import Any
import candidate_pkg  # 仅在此适配器模块中集中引用

class SerializerError(Exception):
    """项目内部统一的序列化异常基类"""
    pass

class DataSerializer:
    @staticmethod
    def dumps(payload: Any) -> str:
        try:
            return candidate_pkg.encode_to_str(payload)
        except candidate_pkg.BaseCandidateException as err:
            # 将第三方库的特定异常转换为内部系统统一的异常
            raise SerializerError(f"数据序列化失败: {err}") from err

    @staticmethod
    def loads(raw_text: str) -> Any:
        try:
            return candidate_pkg.decode_from_str(raw_text)
        except candidate_pkg.BaseCandidateException as err:
            raise SerializerError(f"数据反序列化失败: {err}") from err
DataSerializer。未来一旦该第三方库停更、爆出无法修复的 CVE 漏洞或出现了性能翻倍的新替代品,你只需要修改这一个适配器文件,而无需对全工程发起大规模侵入性重构。
六、总结与选型决策速查
评估第三方库的核心并不是寻找在所有指标上完美无缺的“神器”,而是在项目的交付时间、维护成本与技术风险之间取得务实平衡。选型全生命周期的执行路径可梳理为以下决策闭环:
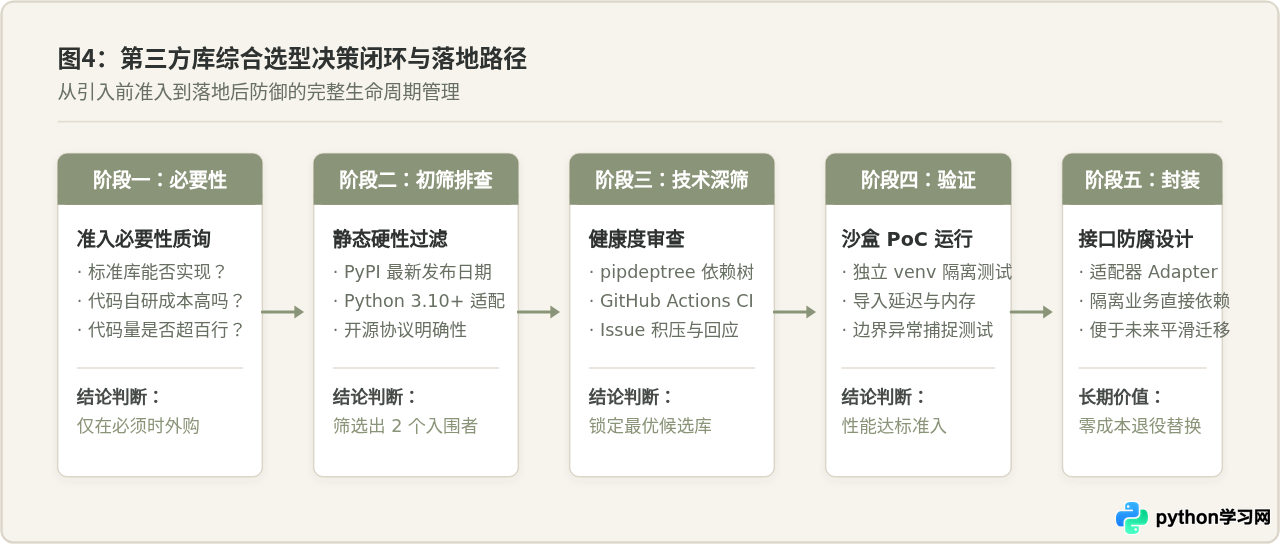
| 评估维度 | 及格基准线 | 加分项 | 一票否决项 |
|---|---|---|---|
| 需求必要性 | 自研代码预估超过 100 行 | 逻辑高度专门化且有国际标准规约 | 标准库原生模块已有成熟等价实现 |
| 维护活跃度 | 近 12 个月内有发版或合并修复 | 近 3 个月有发版,Issue 解决率 > 70% | 官方明确标注弃用或超过 2 年无响应 |
| 依赖树规模 | 直接依赖 ≤ 3 个,传递层级 ≤ 2 级 | 纯 Python 零外部第三方依赖 | 依赖链中包含已停更或存在严重 CVE 的子包 |
| 工程质量 | CI 自动化测试通过,支持 Python 3.10+ | 提供 py.typed 与 90%+ 测试覆盖率 |
完全缺乏自动化测试,代码风格杂乱无章 |
| 开源许可证 | 明确标注主流开源协议 | MIT / Apache 2.0 / BSD 宽松商业友好型 | 未声明 License、自定义歧义协议或误用 AGPL |
掌握这一套标准化的排查与验证流程后,团队不仅能在项目初期快速锁定稳固的技术底座,还能在整个系统演进周期中最大限度地规避依赖膨胀、版本锁死与供应链安全事故。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















