


Python爬虫常用库有哪些:从Requests到Scrapy的选型指南
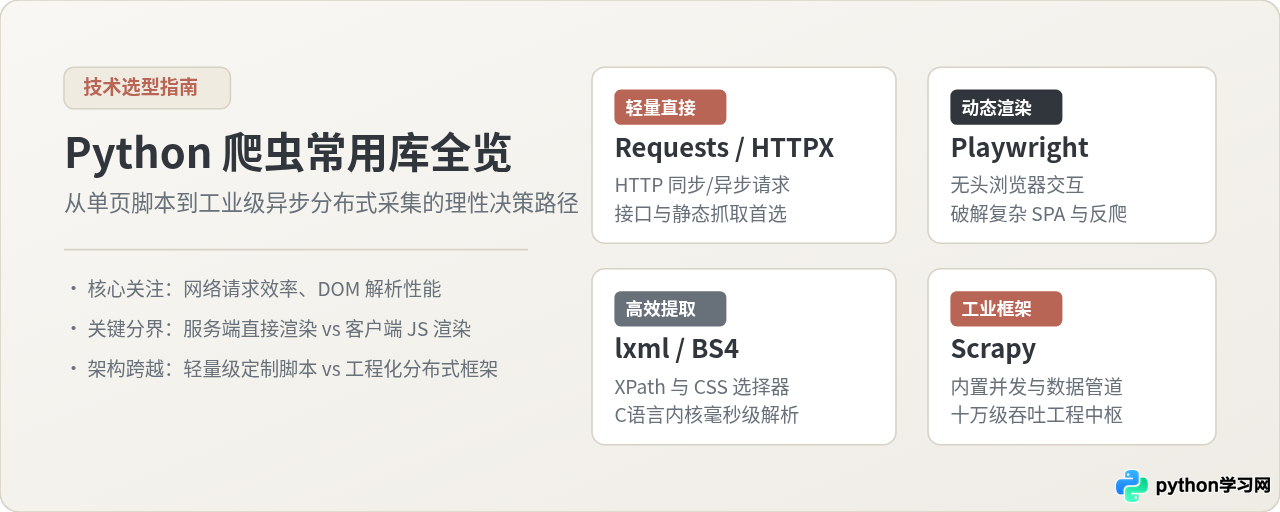
深入梳理Python爬虫核心库:从网络请求库Requests与HTTPX、解析器BeautifulSoup与lxml,到动态无头浏览器Playwright与工业级框架Scrapy。提供清晰的技术选型指南与决策路径。
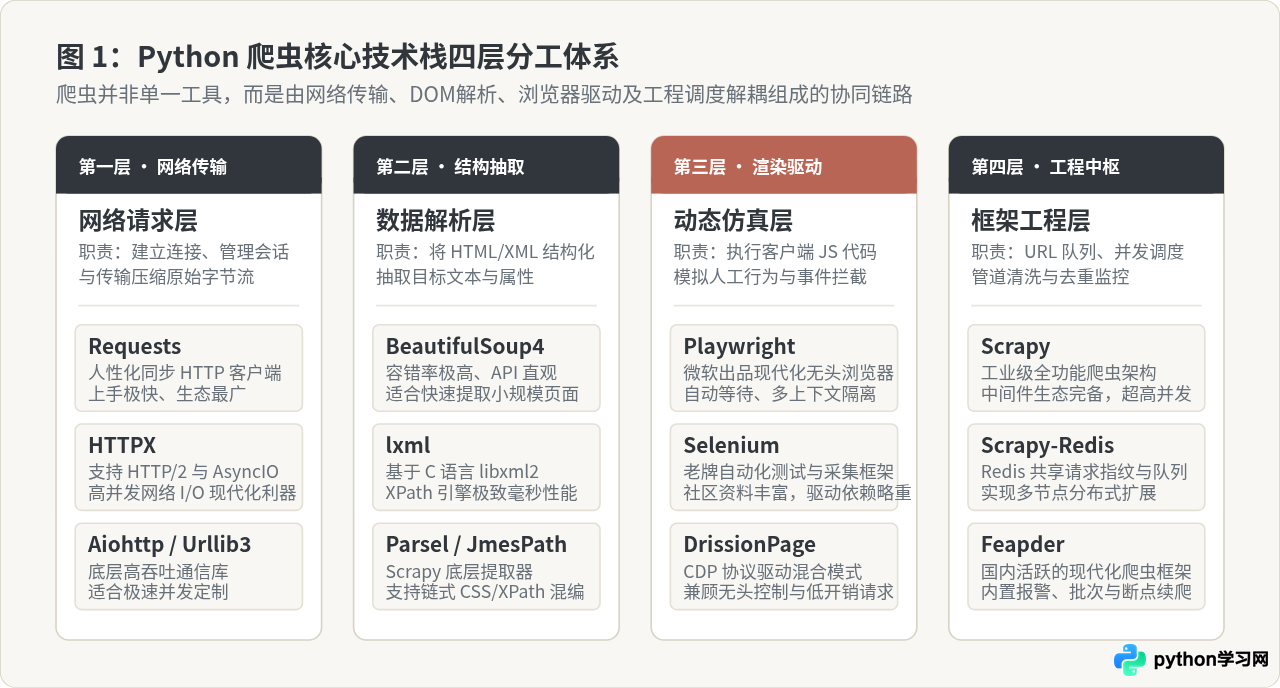
一、Python 爬虫生态的四层解耦分工
很多初学者在面对爬虫选型时,容易将“发送请求的库”和“完整爬虫框架”混为一谈。例如拿 Requests 与 Scrapy 直接对比,或者纠结于 BeautifulSoup 与 Selenium 选谁。要做出正确的选型,首先需要在工程视角上将爬虫技术栈拆解为独立分工的四个层面:
- 网络请求层(HTTP Client):负责通过 TCP/TLS 发送 HTTP 请求,处理状态码、重定向、Cookies 与连接池,返回未加工的原始字符串或字节流(如 Requests、HTTPX、urllib3)。
- 数据解析层(Parser):负责将接收到的 HTML、XML 或 JSON 文本解析为内存树形结构,利用 XPath、CSS 选择器或属性匹配快速检索出目标字段(如 lxml、BeautifulSoup4、Parsel)。
- 动态渲染层(Headless Browser):负责完整执行浏览器环境中的 JavaScript 代码,处理 SPA 单页渲染、滚动懒加载、Canvas 混淆及点击拖拽行为(如 Playwright、Selenium)。
- 框架工程层(Framework):负责 URL 队列调度、并发控制、断点续爬、中间件扩展及数据清洗持久化(如 Scrapy、Feapder)。
二、网络请求层:Requests 与 HTTPX 怎么选
当目标网站的数据直接存在于初始 HTML 源码中,或者后端通过清晰的 RESTful JSON 接口提供数据时,直接使用网络请求库是开销最小、吞吐最高的方案。
1. Requests:单任务与标准静态抓取的通用基石
Requests 自发布以来便是 Python 最著名的 HTTP 客户端,其核心优势在于极度符合直觉的 API 设计。对于常规抓取,你无需管理繁琐的底层套接字,几行代码就能完成带有 Headers 伪装、Cookie 维持和代理转发的请求:
import requests

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
})

try:
    response = session.get("https://example.com/data", timeout=(3.05, 10))
    response.raise_for_status()
    # 显式指定编码防止乱码
    response.encoding = response.apparent_encoding
    html_text = response.text
except requests.exceptions.RequestException as err:
print(f"请求发生异常: {err}")局限与边界:Requests 是基于阻塞式同步 I/O 构建的。当面对数千个 URL 时,单纯依赖 for 循环会造成严重的网络 I/O 阻塞;即使采用多线程池(ThreadPoolExecutor),由于 Python GIL 与线程上下文切换成本,抓取速度依然受限。此外,Requests 无法解释 JavaScript,对前端动态渲染无能为力。
2. HTTPX:现代异步与 HTTP/2 支持的进阶替代
HTTPX 在保持与 Requests 几乎 95% 语法兼容的前提下,原生地提供了 async/await 异步客户端,并支持现代网络协议 HTTP/2。如果你的项目需要在一台机器上同时保持数百个非阻塞网络请求,或者正配合 FastAPI 构建微服务数据流,HTTPX 是非常理想的选择:
import asyncio
import httpx

async def fetch_item(client, url):
    resp = await client.get(url, timeout=10.0)
    return resp.json()

async def main():
    async with httpx.AsyncClient(http2=True) as client:
        tasks = [fetch_item(client, f"https://api.example.com/items/{i}") for i in range(20)]
        results = await asyncio.gather(*tasks)
        print(f"成功获取 {len(results)} 条记录")

# 示例:通过 asyncio.run(main()) 执行异步抓取
三、数据解析层:BeautifulSoup4 与 lxml 的性能取舍
获取到 HTML 字符串后,下一步是结构化提取字段。解析库的选择直接决定了 CPU 密集的解析耗时:
- BeautifulSoup4:API 极其宽容,即使面对格式极其破损、标签未闭合的残缺 HTML,也能借助
html.parser或html5lib正确修复并定位。但它的解析由纯 Python 驱动,执行速度较慢,适合一次性任务或数据规模在千级以内的小项目。 - lxml:底层基于 C 语言编写的
libxml2与libxslt库,支持完整的 XPath 1.0 语法。在面对数万级复杂网页时,lxml 的解析耗时通常只有纯 Python 解析器的十分之一甚至几十分之一,是追求吞吐效率时的必然首选。
BeautifulSoup(html, 'lxml') 指定 lxml 作为底层引擎,兼具人性化接口与 C 级别解析性能。
四、动态仿真层:Playwright 为何逐步替代 Selenium
随着现代前端框架(Vue、React 等)的普及,大量网站的数据不再由服务器直接渲染输出,而是通过 Webpack 打包的 JavaScript 代码异步拉取并在客户端渲染。更复杂的网站还会加入滑块验证码、字体加密与反调试检测。
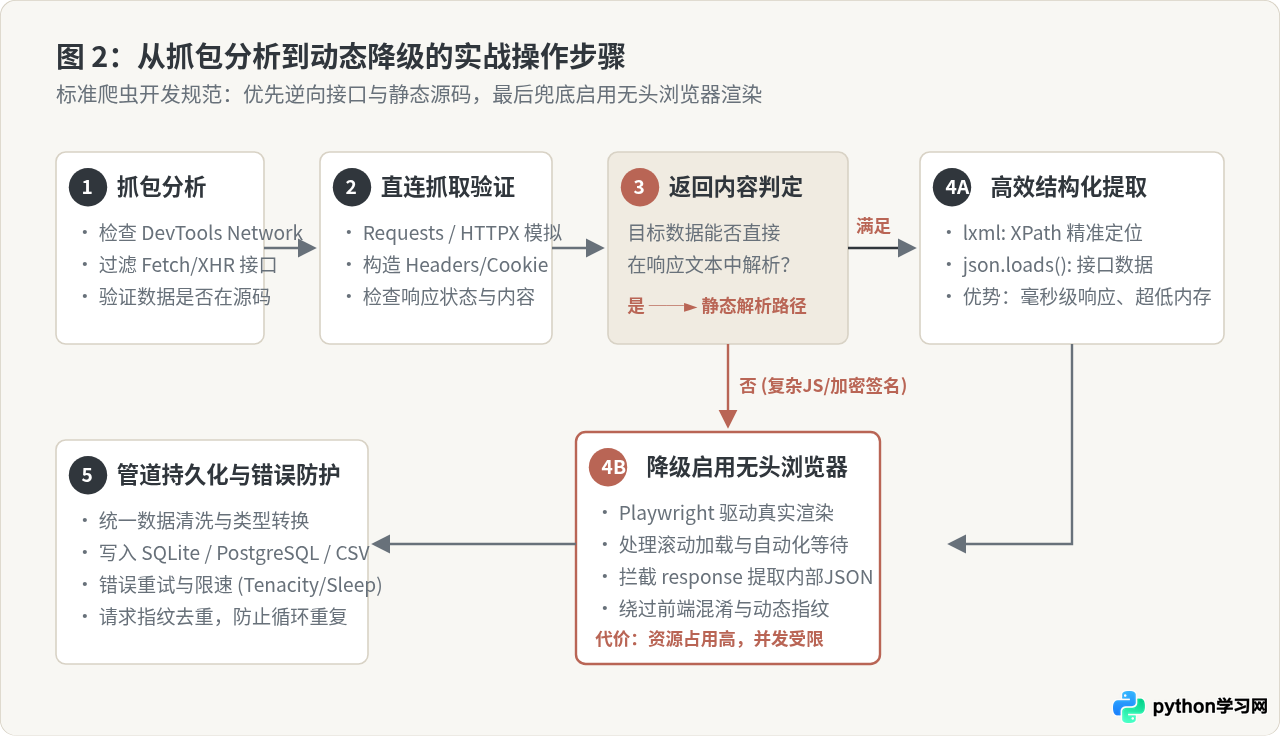
在必须使用真实浏览器内核解析时,以往主流是 Selenium,但现代 Python 爬虫界更倾向于选择 Playwright:
- 真正的原生自动等待(Auto-waiting):在执行点击或内容获取前,Playwright 会自动等待元素挂载、可见、可交互,极大降低了因网络微延迟导致的
ElementNotFoundException。 - 更轻量的浏览器上下文(BrowserContext):无需为每个并发任务冷启动一个全新的重量级 Chrome 进程,Playwright 可以在单个浏览器进程内创建数个相互完全隔离的无痕上下文,内存节约显著。
- 直接的网络请求拦截与路由:可以直接阻断
.png、.css、.woff等不影响业务数据的资源加载,大幅提升爬取速度;同时能直接挂钩网络响应,直接截获后端发给前端的解密 JSON 数据。
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # 启动 Chromium 无头浏览器
    browser = p.chromium.launch(headless=True)
    # 创建独立上下文,可注入 Cookie 或伪装指纹
    context = browser.new_context(viewport={"width": 1280, "height": 800})
    page = context.new_page()

    # 路由拦截:过滤图片与字体资源,加速抓取
    page.route("**/*.{png,jpg,jpeg,svg,woff2}", lambda route: route.abort())

    page.goto("https://spa.example.com", wait_until="networkidle")

    # 获取动态渲染后的纯文本内容
    cards = page.locator(".content-card").all_text_contents()
    print(f"提取到动态卡片数量: {len(cards)}")

    browser.close()
五、工程框架层:Scrapy 的工业级不可替代性
很多开发者会问:既然我已经掌握了 Requests + ThreadPool 或者 HTTPX + asyncio,为什么还需要去学笨重、有着一整套命令行动作与目录约定的 Scrapy?
原因在于:单页抓取只是爬虫代码的 20%,剩下的 80% 是工程维护问题。当任务要求在几小时内抓取数十万甚至数百万个页面时,轻量脚本将迅速陷入以下困境:
- 并发度与限速(Politeness):如何根据目标站点的响应延迟动态调整并发请求数,避免触发 429 Too Many Requests?
- 链接去重与生命周期管理:如何保证千万级 URL 不重复请求,且在异常崩溃后能够保存调度指针、断点续爬?
- 管道(Pipelines)解耦:抓取、结构清洗、数据校验与数据库持久化如何分工互不阻塞?
Scrapy 基于 Twisted 异步事件驱动架构,从设计之初就将调度器(Scheduler)、下载器(Downloader)、蜘蛛(Spider)与管道(Pipeline)严格解耦。结合 scrapy-redis 插件,可以非常平滑地扩展为分布式集群架构。当你的采集任务从“一次性测试”演进为“持续运行的数据资产管线”时,Scrapy 是唯一被验证过工业可靠性的事实标准。
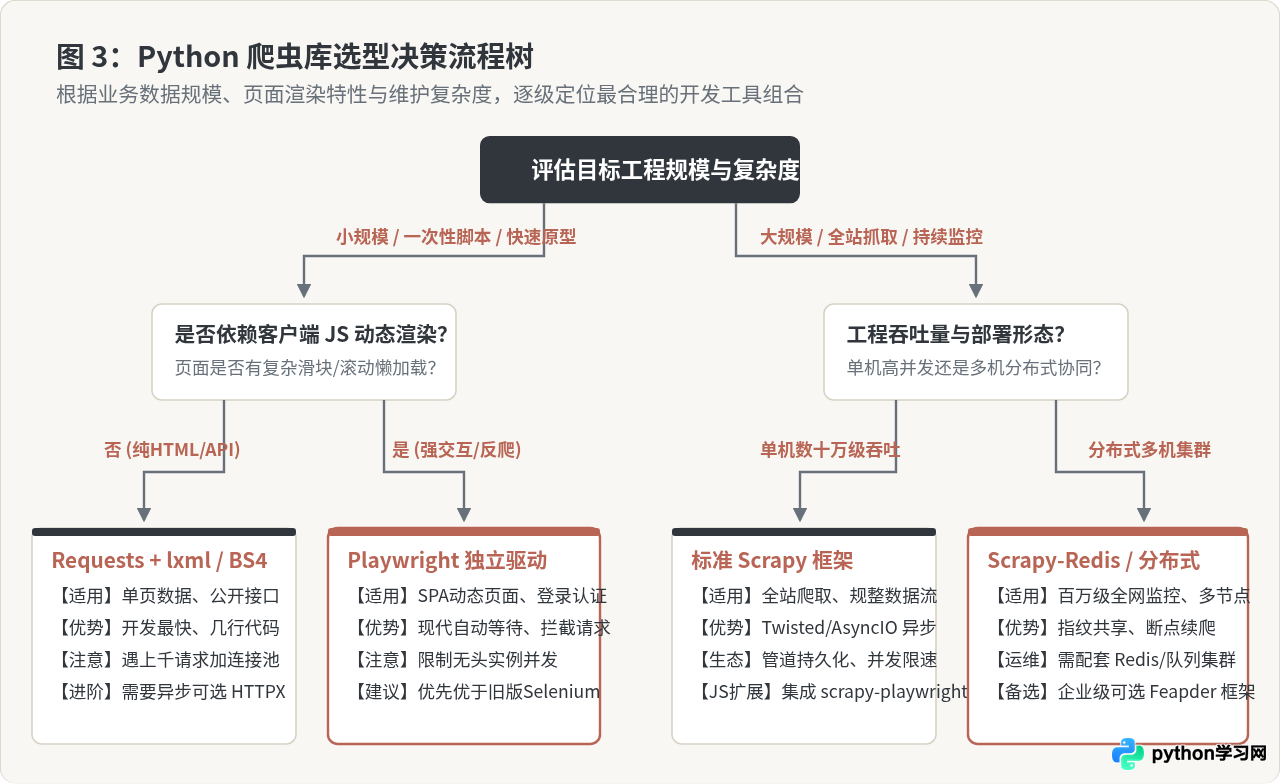
六、综合选型决策:如何选出最适合当前任务的方案
针对常见场景,以下提供具体的条件判断依据:
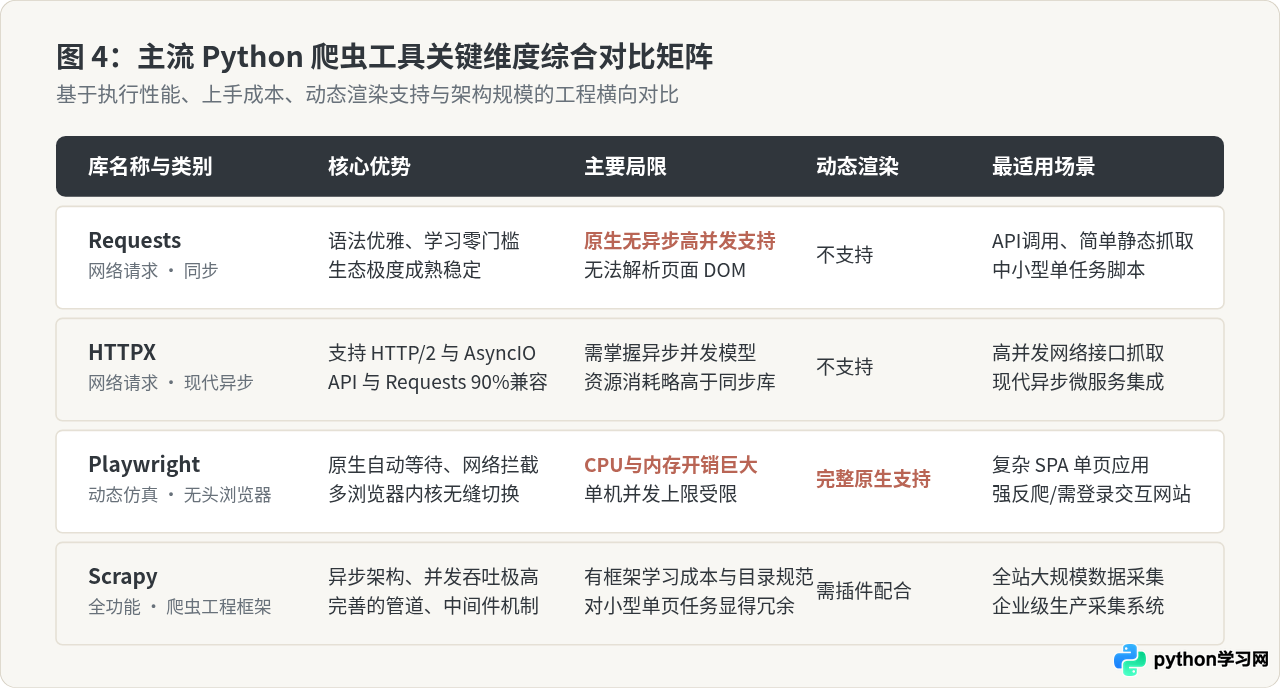
| 业务场景 | 推荐组合 | 核心理由与判断依据 |
|---|---|---|
| 临时性单次采集 / 学习测试 | Requests + BeautifulSoup4 / lxml | 开发周期最短,无需配置项目工程结构,50 行内代码解决战斗。 |
| 高频纯 API 抓取 / 微服务内嵌 | HTTPX (Async) + 对应 JSON 解析 | 充分利用事件循环并发,吞吐量远胜同步 Requests,同时代码比 Scrapy 轻快。 |
| 强前端反爬 / 复杂 SPA / 登录态交互 | Playwright (无头浏览器模式) | 真实执行 JS,绕过复杂签名与混淆加密;自动等待减少脚本断裂。 |
| 全站型大规模周期监控(十万至千万级) | Scrapy (+ scrapy-playwright / scrapy-redis) | 内置重试、排队、限速与去重调度;支持横向挂载 Redis 构成集群。 |
七、生产环境必须遵守的实践准则
明确了库的选择之后,要让爬虫稳定、合规且不破坏目标服务器环境,还应当建立以下底线防线:
- 严格设置超时限制(Timeout):无论使用哪个库,网络请求都必须显式传入
timeout=(connect_timeout, read_timeout),杜绝默认无超时导致的线程/协程永久挂起。 - 尊重服务端的承载能力:合理配置并发数与休眠间隔,不以打垮目标服务器为目的;在合法授权范围内采集公开数据。
- 解耦数据存储与网络 I/O:不要在抓取的回调函数中执行耗时漫长的数据库写入或磁盘密集操作,使用缓冲队列(Queue)将采集与入库隔离开来。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















