


文职人员学Python自动化办公对职业发展有帮助吗?
深入探讨文职人员学习Python自动化办公的实际收益、适用边界与潜在阻力,分析如何从编写基础脚本走向业务流程优化,实现真实的职业发展跃迁。
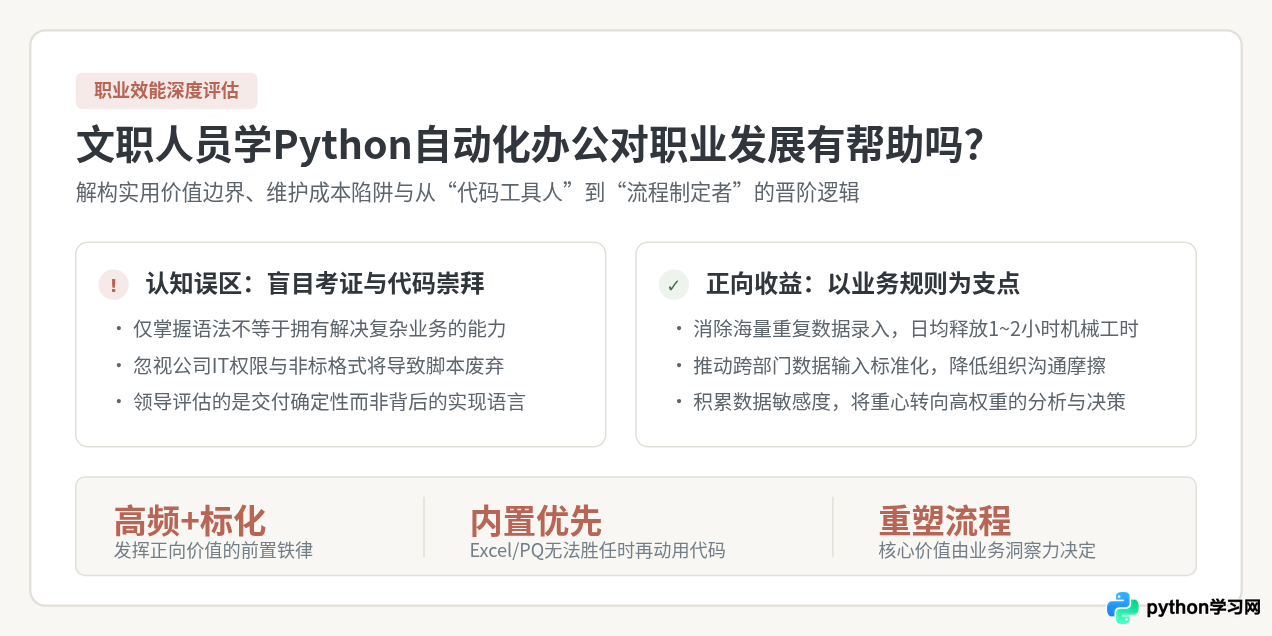
一、价值判断:什么情况下真正有帮助,何时只是无效内耗?
许多文职人员在被繁重的复制粘贴、表格汇总与格式调整压得喘不过气时,往往容易将编程语言寄托为“一劳永逸”的解脱工具。然而在真实的组织环境中,一项技能能否带来职业发展,核心标准不是技术的先进性,而是投入产出比(ROI)以及组织对交付成果的认可方式。
学习 Python 对文职人员的收益并非线性增长,而是由以下两个客观维度共同决定:
- 任务发生频率与数据规模:如果是每周、每日发生且涉及几十甚至上百个分发文件的场景,编写脚本是一次性投资、长期享受复利;如果只是每季度或每年发生一次的临时报表,编写、调试与环境维护的时间往往远大于手动操作耗时。
- 源数据的结构化与规则明确度:如果所有部门提交的报表字段严格一致、列名规范且没有随意的合并单元格,自动化脚本极易稳定运行;反之,若输入文件全凭个人喜好随意书写,任何自动化脚本都会频繁因为“KeyError”或类型不匹配而报错崩溃,最终耗费大量精力用于人工修代码。
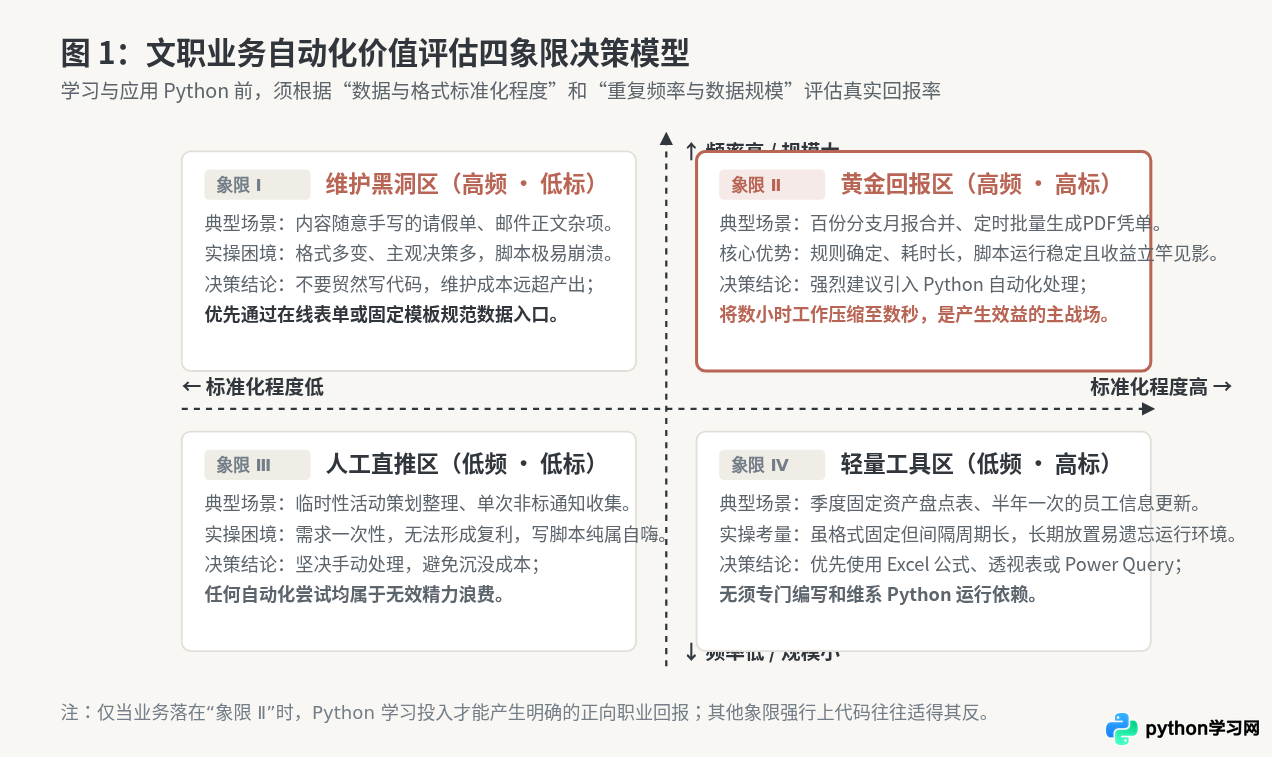
如上图所示,文职人员只有在自己的核心职责落在象限 Ⅱ(高频 · 高标准化)时,学习 Python 才能带来高确定性的职业助力。在象限 Ⅰ 中,当务之急是通过管理手段规范业务表单输入,而非硬写复杂代码去适应混乱的数据;而在象限 Ⅲ 与 Ⅳ 中,手动处理或使用现成软件功能才是最理性的选择。
二、工具生态位:Python 与 Excel、Power Query 的边界对比
文职人员最常见的技术选型误区,是用 Python 去重做 Excel 早已内置且极其擅长的事情。例如对一个仅有几百行的单表进行求和、筛选、分类汇总,或者画一个临时的柱状图,在 Excel 界面中仅需几次点击或一条快捷键,而编写 Python 脚本却需要配置运行环境、导入库、指定文件绝对路径并输出保存,这属于典型的“高射炮打蚊子”。
我们必须理清日常办公软件与 Python 的核心分工:
| 工具维度 | Excel 原生函数与透视表 | Power Query / VBA 宏 | Python 自动化工程 |
|---|---|---|---|
| 学习门槛 | 极低(开箱即用,所见即所得) | 中等(界面化ETL / 基础VB代码) | 中高(需掌握基本编程逻辑与语法) |
| 核心优势 | 灵活性高,零环境配置,全员通用 | 内置于Office,多表刷新极快,无安全限制 | 跨格式(PDF/Word/Excel/网页/邮件)全联动 |
| 数据处理上限 | 数十万行开始卡顿,超百万行无法打开 | 可处理数百万行级本地建模 | 依托内存与算法,可轻松处理千万级数据流 |
| 团队交接难度 | 无缝交接,任何同事均可直接编辑 | 较低,只要不损坏底层步骤即可刷新 | 较高,接手人员须懂代码或预留参数入口 |
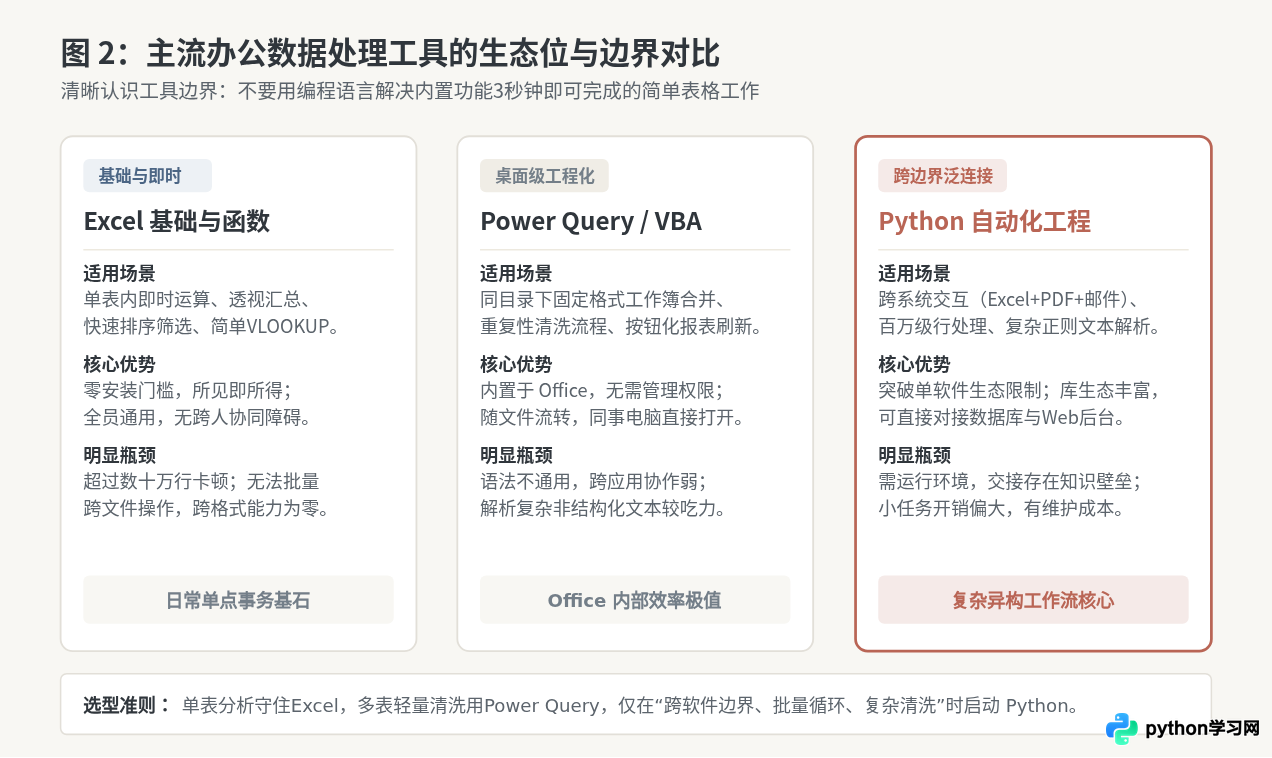
由图 2 可以看出,Python 的不可替代性并不在于表格内部的简单计算,而在于“打破应用之间的壁垒”。当面对以下典型场景时,Python 具有绝对优势:
- 海量批量操作:将某个文件夹内 500 个格式相同的月度报表批量提取特定字段并合并为总表。
- 异构格式流转:从企业内部 Web 审批系统定时爬取导出的非标准 HTML/CSV,结合扫描版 PDF 电子发票提取关键金额,最终匹配生成标准财务凭证。
- 无人值守与系统集成:在每天清晨自动从服务器提取最新库存,生成异常预警 Excel,并通过邮件服务自动分发给各区域负责人。
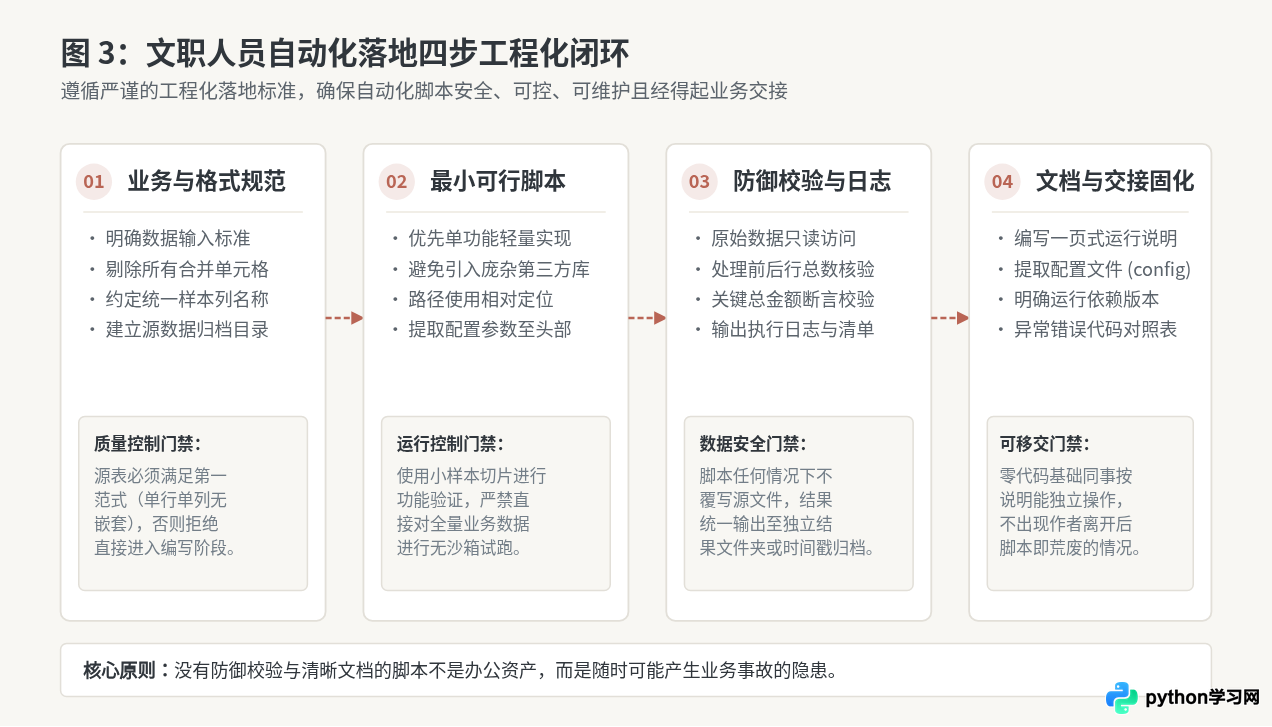
三、实操规范:文职人员落地自动化的四步工程化闭环
许多文职人员学习编程中途放弃,或者写出的脚本在公司引发数据灾难,根本原因在于缺乏基本的工程化与防御性思维。在正式工作中,编写脚本绝不是“能跑通就行”,必须建立一套标准化的交付流程。
第 1 步:业务规则与输入标准化
自动化运行的前提是数据输入的确定性。在动笔写代码前,必须建立源数据提交标准:
- 禁止源数据中存在跨行或跨列的合并单元格。
- 首行必须是清晰且唯一的列字段名(如
员工编号、报销金额、发生日期),禁止出现空列名或重复列名。 - 日期统一为
YYYY-MM-DD格式,避免出现类似“5月3号”、“5.3”等混合文本。
第 2 步:最小可行脚本(以批量合并多分支月报为例)
以最常见的场景为例:总部行政每月需要汇总来自 12 个分公司的月度办公耗材支出表(.xlsx 格式),所有文件存放在同级目录 reports/ 下。我们需要将它们合并为一个总表 summary_2026.xlsx,并追加一列“来源分公司”。
首先确保安装所需依赖库(执行于终端):
编写标准规范的自动化脚本 merge_reports.py:
# -*- coding: utf-8 -*-
"""
脚本名称: merge_reports.py
功能描述: 自动读取 reports 目录下所有分公司 Excel 报表,清洗后合并输出为总表
运行依赖: pandas, openpyxl
"""

import os
import glob
import pandas as pd
from datetime import datetime

# ==================== 1. 配置参数与路径定义 ====================
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
INPUT_DIR = os.path.join(BASE_DIR, "reports")
OUTPUT_DIR = os.path.join(BASE_DIR, "dist")
OUTPUT_FILE = os.path.join(OUTPUT_DIR, f"summary_{datetime.now().strftime('%Y%m')}.xlsx")

# 必须包含的基准列名(用于校验文件合规性)
REQUIRED_COLUMNS = ["部门名称", "费用科目", "发生金额", "经办人员"]

def validate_and_merge():
    # 确保输出目录存在
    os.makedirs(OUTPUT_DIR, exist_ok=True)

    # 检索所有 Excel 文件
    file_pattern = os.path.join(INPUT_DIR, "*.xlsx")
    file_list = glob.glob(file_pattern)

    if not file_list:
        print("[警告] 未在目标文件夹中找到任何 .xlsx 文件,程序终止。")
        return

    merged_records = []
    total_source_rows = 0

    print(f"[开始处理] 共发现 {len(file_list)} 个待合并报告...")

    # ==================== 2. 遍历读取与防御校验 ====================
    for file_path in file_list:
        file_name = os.path.basename(file_path)

        # 忽略 Excel 自动生成的临时缓存文件
        if file_name.startswith("~$"):
            continue

        try:
            # 读取第一个 Sheet,将所有列均设为安全类型
            df = pd.read_excel(file_path, sheet_name=0)

            # 校验关键列是否存在
            missing_cols = [col for col in REQUIRED_COLUMNS if col not in df.columns]
            if missing_cols:
                print(f"[校验失败] 文件 {file_name} 缺少关键列 {missing_cols},已跳过!")
                continue

            # 基础数据清洗:剔除全空行,清除金额前后空格
            df = df.dropna(how="all").copy()
            df["发生金额"] = pd.to_numeric(df["发生金额"], errors="coerce").fillna(0.0)

            # 追加来源标记,便于追溯核对
            df["来源文件"] = file_name

            total_source_rows += len(df)
            merged_records.append(df)
            print(f"  √ 已解析: {file_name},有效记录: {len(df)} 行")

        except Exception as err:
            print(f"[严重错误] 读取文件 {file_name} 失败,原因: {err}")

    # ==================== 3. 汇总与结果断言校验 ====================
    if not merged_records:
        print("[错误] 未成功读取到任何有效数据,不生成总表。")
        return

    final_df = pd.concat(merged_records, ignore_index=True)

    # 完整性校验:合并后的行数必须等于各明细表行数之和
    assert len(final_df) == total_source_rows, "数据整合完整性校验失败:行数不一致!"

    # ==================== 4. 安全输出与归档 ====================
    # 使用 openpyxl 引擎写出,不覆盖原始数据文件
    final_df.to_excel(OUTPUT_FILE, index=False, engine="openpyxl")

    print("-" * 50)
    print(f"[处理成功] 总表生成完毕: {OUTPUT_FILE}")
    print(f"汇总记录总行数: {len(final_df)} 行 | 累计涉及总金额: {final_df['发生金额'].sum():,.2f} 元")

if __name__ == "__main__":
    validate_and_merge()
dist/ 文件夹,并且加入 assert 校验总行数。一旦发现上游文件列名缺失,优雅跳过并打印醒目标记,绝不让程序隐蔽报错或静默吞并错误数据。
四、现实阻力:必须直面的组织环境与维护隐患
很多技术类文章只描绘代码运行成功的理想状态,却刻意回避了企业现实中的阻力。文职人员若想让 Python 真正服务于职业发展,必须清醒预判并应对以下三大障碍:
1. 企业 IT 安全红线与受限权限
在大型企业、外企、金融机构或体制内单位,办公电脑通常受到严格的安全组策略限制。员工往往没有管理员权限(Admin),无法随意执行 pip install,甚至无法运行未签名的可执行文件(.exe)或脚本解释器。如果你的工作环境存在强内网隔离与严格合规审查,强行绕过规则私自配置开发环境往往会触碰信息安全红线。在开始学习前,务必先向公司IT部门了解第三方脚本与开源工具的使用合规边界。
2. 脚本维护成本与“业务格式变动”
文职工作的一个核心特征是规则与格式具有动态性。领导上周要看A维度,这周可能要求增加B字段;合作部门可能突然将原本统一的“员工姓名”改成了“姓名(中文)”。人工在 Excel 里调整只需一秒钟,但脚本却可能因此直接报错崩溃。如果没有建立良好的代码解耦与容错机制,作者就会沦为“天天帮同事修脚本的救火员”,原本用于提效的时间全被脚本维护所反噬。
3. 团队知识孤岛与交接风险
在全是文职人员的部门中,往往只有你一人懂 Python。这会带来两面性:一方面你展现了差异化能力;但另一方面,如果流程被你完全黑盒化,一旦你休假、出差或离职,团队将完全无法接管这一工作。领导最关心的永远是业务连续性与确定性。若无法交付连零基础同事都能操作的一键脚本和说明文档,这种技术能力反而会被管理层视为团队风险因素。
五、长期复利:如何将“会写代码”转化为“晋升加薪”?
在职场中,“会写几行 Python 脚本”本身并不能构成核心竞争力。在程序员眼中,文职自动化的语法甚至不如大一新生的作业复杂;而在部门主管眼中,他们也并不关心你在底层用的是 Python、VBA 还是手动快捷键。职业发展的关键,在于你能否将自动化节省下来的工时转化为业务增量价值。
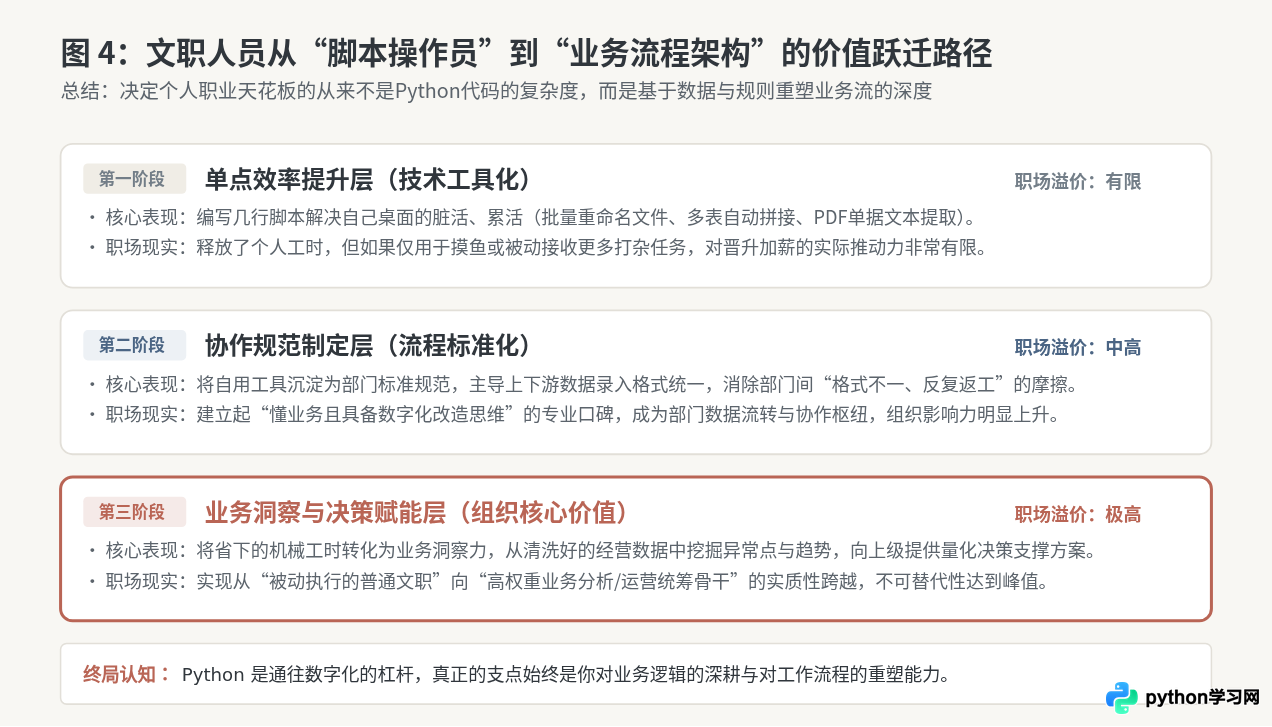
要实现从普通文职向高价值岗位的跃迁,建议沿着以下三条路径推进:
- 从“解决个人任务”走向“输出部门标准”:不要把脚本藏着自己用,而是主动向主管提出改善方案,把规范好的模板和一键清洗工具提供给全组使用,使整组的工作效率提升 30% 以上。此时你的身份从“一个动作快的员工”变成了“推动部门数字化转型的骨干”。
- 把工时盈余转化为“业务洞察”:以前由于整天忙于复制粘贴,报表做完已经到了下班时间,无暇思考数据背后的逻辑;现在几秒钟跑完数据,你就有充裕的时间去分析:“为什么华东分部的办公耗材同比增加了45%?”并在提交报表时附带一份 300 字的精炼归因分析与控制建议。能提出业务洞察的文职人员,其薪酬与晋升空间远超只会汇总数据的操作员。
- 汇报时讲“业务收益”而非“技术细节”:在年终总结或晋升答辩时,切忌罗列“我学习了 Pandas 库、掌握了正则表达式”,领导对这些技术术语并不感冒;必须量化业务贡献:“本年度梳理并重构了跨分支月度核算流程,实现数据处理耗时由每月 16 小时缩短至 15 分钟,人工核对差错率从 3.2% 归零,释放全组工时并承接了新的运营支持项目。”
六、文职人员常见疑问解答(FAQ)
openpyxl 或 pandas 基础操作)。掌握这些内容只需 1~2 周,其余高级特性在遇到具体业务卡点时查阅文档即可。本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















