


Python for循环遍历字典时修改数据报错的解决方法
深入解析在Python中for循环遍历字典时修改数据报RuntimeError的原因,提供静态快照遍历、字典推导式、键缓存队列等高效可行的解决方法与详细代码示例。
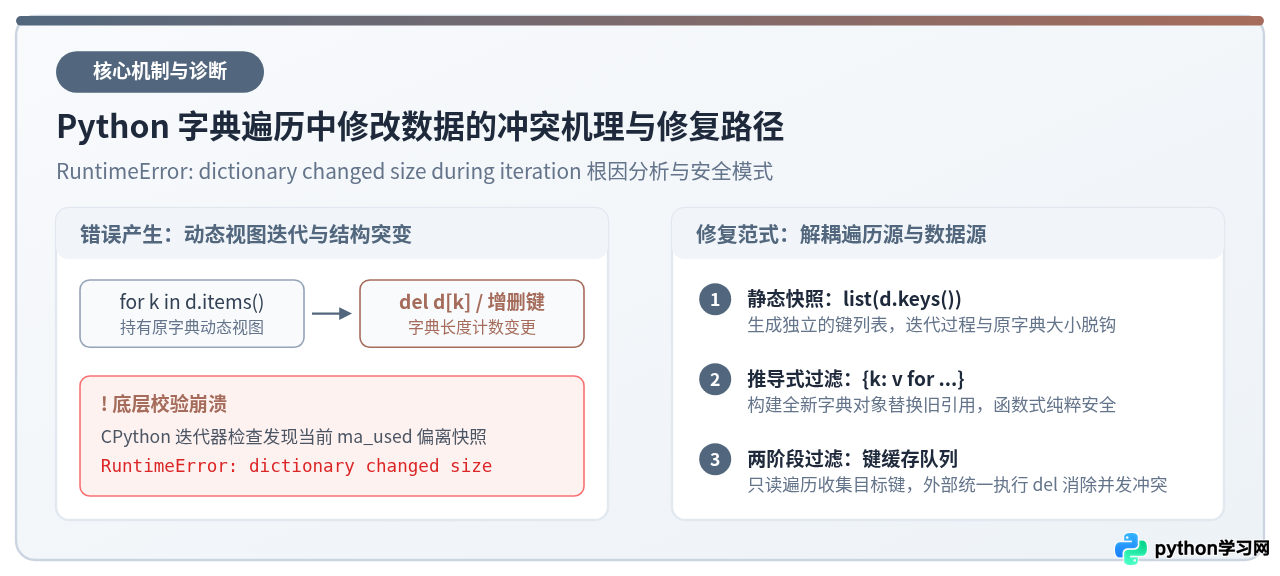
在 Python 中使用 for 循环直接遍历字典并对其执行 del 删除键或新增键操作时,解释器会立即抛出 RuntimeError: dictionary changed size during iteration 错误。这一异常的核心原因在于 Python 3 的字典迭代器依赖底层的动态视图(View),迭代过程中一旦检测到字典实际长度(大小计数器)发生变化,安全机制便会主动终止循环。最直接且通用的修复方式是使用 list(d.keys()) 构造键的静态列表快照进行遍历;在需要批量筛选过滤的场景下,使用字典推导式则是性能更好且更符合 Python 惯用表达的解决方案。
一、报错复现与典型症状
许多开发者在清洗数据或过滤字典键值对时,会下意识地写出如下代码:希望在遍历的同时,顺便把不符合业务要求(例如数值为 0 或空字符串)的键清理掉。
# 示例:遍历字典同时删除满足条件的键
scores = {'math': 95, 'history': 0, 'physics': 88, 'chemistry': 0}

for subject, score in scores.items():
    if score == 0:
        del scores[subject]  # 触发异常
运行上述代码后,程序在删除第一个符合条件的键后并不会继续执行,而是直接崩溃并输出如下错误堆栈:
Traceback (most recent call last):
  File "clean_data.py", line 4, in <module>
    for subject, score in scores.items():
RuntimeError: dictionary changed size during iteration
同样的错误不仅发生在 scores.items() 上,在 for key in scores 或者 for key in scores.keys() 甚至 scores.values() 中添加或删除键,都会产生完全相同的异常。
二、为什么会报错:CPython 底层迭代机制解析
要彻底解决这个问题,首先需要理解 Python 字典在底层的数据结构和迭代运行方式。
在 Python 2 中,d.keys() 和 d.items() 会直接生成一个包含所有键或元组的独立列表(List),因此当时直接遍历 d.keys() 并不容易报错(尽管直接遍历 d 依然会报错)。但在 Python 3 中,为了提升内存效率,keys()、values() 与 items() 改为返回字典视图(Dictionary View)。视图并不拥有独立的数据副本,而是直接透传底层字典的数据状态。
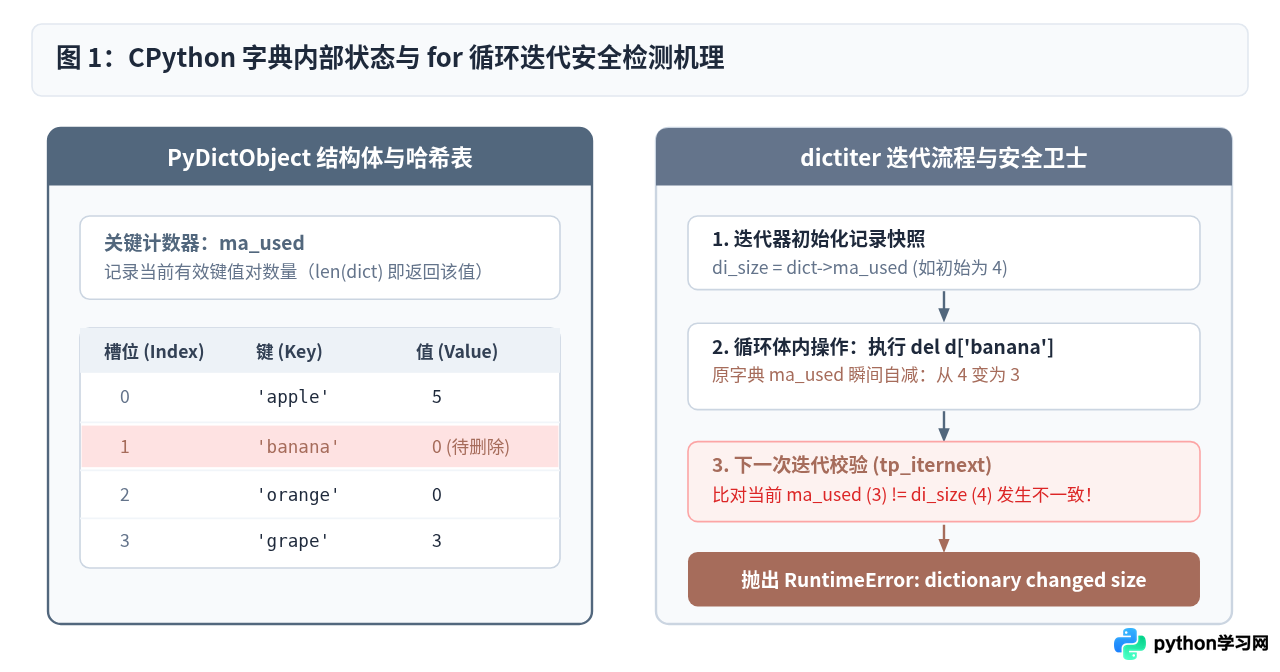
当 for 循环启动时,CPython 内部会创建一个字典迭代器对象 dictiter。在该对象初始化的瞬间,它会记录当前字典的条目总数(即结构体内的 ma_used 字段)。在每一次调用 tp_iternext 准备获取下一个元素时,迭代器都会严格比对此时字典的 ma_used 是否等于最初记录的值。一旦你在循环体内执行了 del scores[subject] 或 scores['new_key'] = 1,底层字典的长度计数瞬间发生变化,迭代器在下一次推进时发现数值不符,便断定“字典在迭代过程中发生了尺寸变动”,出于防止哈希表扩缩容引发游标紊乱与死循环的考虑,强制抛出 RuntimeError。
答案是完全不会。如果是执行
scores[subject] = score + 10 这类仅仅修改已有键对应数值的操作,字典的总长度(ma_used)并没有增加或减少,哈希表内部的键布局未受破坏,因此迭代器能平稳完成遍历。只有新增键(增加尺寸)或删除键(缩减尺寸)才会触发此报错。
三、排查与修复步骤:三种标准解决方案
根据具体的业务诉求(例如是否必须在原有字典对象上原地修改、需要删除的键占总体比例大小、代码可读性要求等),可以选择不同的处理策略。
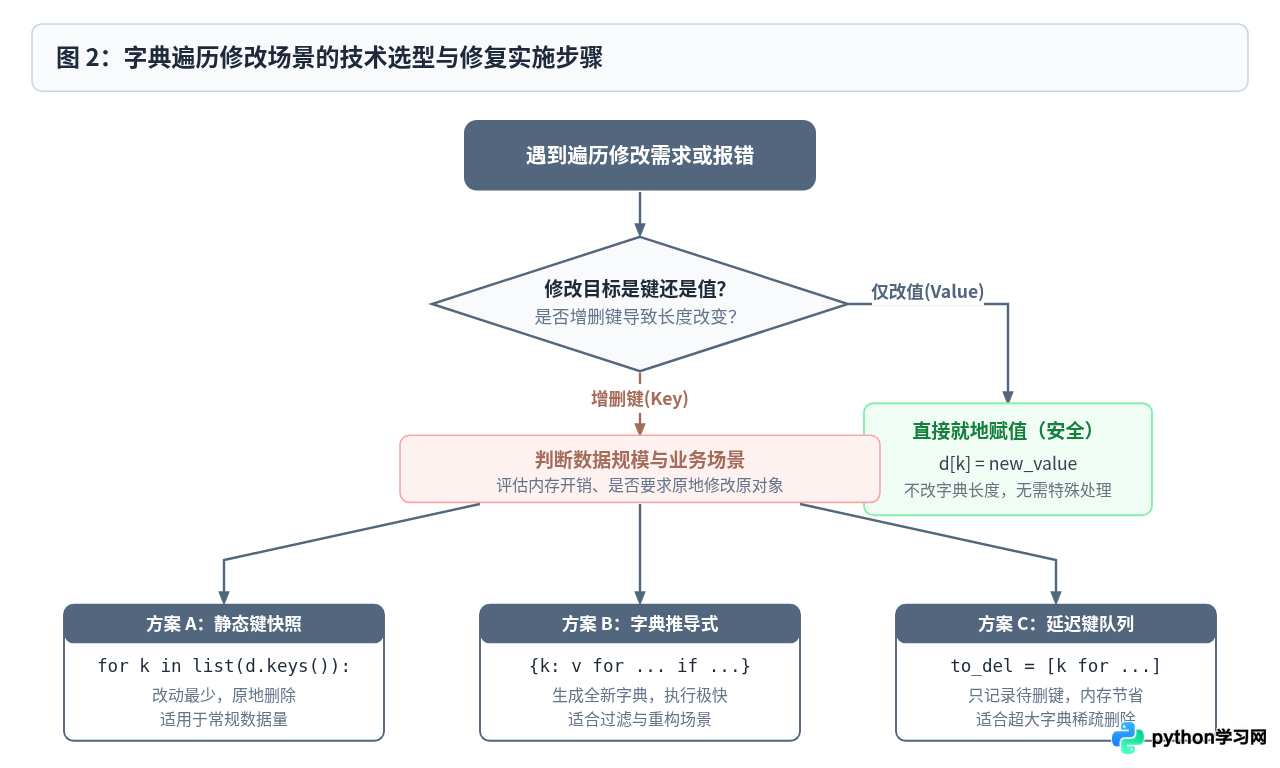
方法 1:使用 list() 创建静态快照(改动最少,原地修改)
如果希望保持原有代码的结构不变,且必须原地修改已有字典,最推荐的做法是用 list() 将字典的键转换为一个静态的临时列表。由于遍历的是列表本身,原字典在循环体内的删除操作完全不会波及列表迭代器。
# 正确做法:使用 list(scores.keys()) 或 list(scores) 建立快照
scores = {'math': 95, 'history': 0, 'physics': 88, 'chemistry': 0}

for subject in list(scores.keys()):
    if scores[subject] == 0:
        del scores[subject]

print("清理后的字典:", scores)
# 示例输出:清理后的字典: {'math': 95, 'physics': 88}
原理说明:list(scores.keys()) 会在进入 for 循环之前一次性开辟内存,将字典此时所有的键提取为一个独立的列表对象。随后的 for 循环直接对这个独立的列表进行步进,del scores[subject] 只是修改了 scores 字典,完全不会影响正在被迭代的临时列表。
方法 2:使用字典推导式(性能更优,语法简洁)
如果业务逻辑只是为了“过滤掉不想要的键值对”,并且调用方不需要保留原字典在内存中的物理地址引用,那么使用字典推导式(Dict Comprehension)是业界最推崇的写法。
# 正确做法:使用字典推导式生成符合要求的新字典
scores = {'math': 95, 'history': 0, 'physics': 88, 'chemistry': 0}

# 仅保留分数不为 0 的项
scores = {subject: score for subject, score in scores.items() if score != 0}

print("过滤后的字典:", scores)
# 示例输出:过滤后的字典: {'math': 95, 'physics': 88}
原理说明:字典推导式在底层由高度优化的 C 代码完成新哈希表的构建,省去了在 Python 层频繁执行单次哈希查找和单个删除的指令开销。它符合“不可变数据转换”的函数式编程思想,逻辑一目了然。
方法 3:两阶段延迟删除(读写分离,超大字典首选)
在面对数十万乃至数百万级规模的大字典时,如果仅有极少数键(例如千分之一)需要删除,采用 list(d.keys()) 会全量复制所有的键指针,造成不必要的内存开销。此时推荐采用两阶段模式:第一阶段只读遍历收集要删除的键,第二阶段遍历该待删列表进行统一删除。
# 正确做法:收集待删键缓冲队列,循环后批量删除
large_data = {f"user_{i}": i % 100 for i in range(100000)}

# 第一阶段:只读遍历,仅将满足删除条件的键加入缓冲列表
keys_to_remove = [k for k, v in large_data.items() if v == 0]

# 第二阶段:遍历长度极短的待删列表,就地删除
for k in keys_to_remove:
    del large_data[k]

print("清理完成,删除了键的数量:", len(keys_to_remove))
# 示例输出:清理完成,删除了键的数量: 1000
原理说明:在第一阶段中,整个循环是只读操作,large_data 的大小没有发生变动,因此迭代安全。第二阶段中,待删列表的长度远小于原字典全量键的长度,内存和 CPU 损耗都降至最低。
四、方案对比与技术权衡
在实际项目工程中,不同方案在内存占用、原对象引用维持和开发效率上各有侧重。下表详细列出了三种主流方法的对比维度:
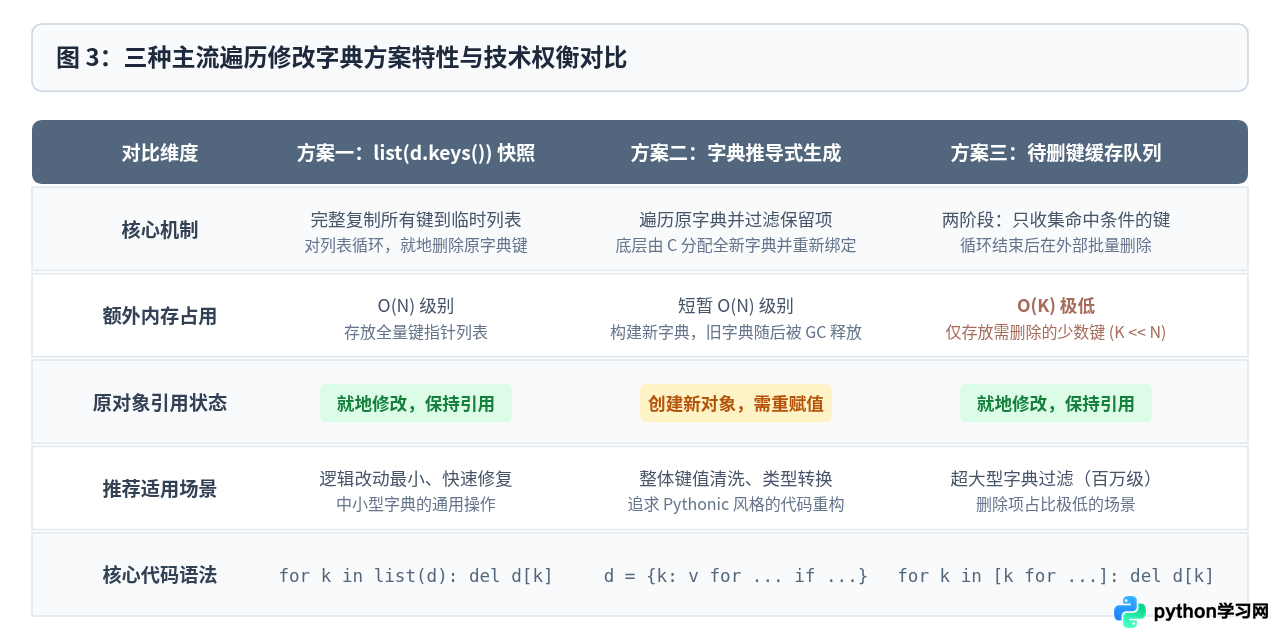
- 原对象引用维持:若该字典作为参数传递给多个函数、类属性或全局模块,重新赋值(如字典推导式
d = {...})只会改变当前局部变量的绑定指向,而不会改变其他模块持有的原字典对象。如果必须让外部共享持有者同时看到改动,应优先选用list(d.keys())或两阶段延迟删除。 - 执行效率与内存:对于百万级以内的常见数据,字典推导式运行最快;对于超大内存字典中少量删除场景,两阶段延迟删除的内存峰值最低。
五、常见衍生场景与注意事项
除了单线程下的常规 del 操作外,还有以下几个容易引发隐蔽错误或逻辑偏差的场景需要格外留意:
1. 遍历时动态新增键
如果在遍历过程中需要向字典添加新键,使用 list(d.keys()) 虽能避免 RuntimeError,但需要注意:循环中新添加的键不会被当前的 for 循环访问到,因为快照列表在循环启动前就已经固定。如果业务场景需要新加入的键也被后续循环处理,应使用队列(如 collections.deque)来管理待处理任务,而不是依赖字典迭代器。
2. 多线程并发修改引发的假象
有时代码明明写成只读遍历(循环体内没有调用任何 del 或赋值),但在高并发环境下却偶尔崩出 RuntimeError: dictionary changed size during iteration。这是因为其他工作线程正在对该共享字典执行写入或删除操作。对于多线程共享字典,必须使用互斥锁进行同步,或者在进入只读循环前对字典建立局部浅拷贝:
import threading

shared_dict = {'status': 1, 'count': 100}
dict_lock = threading.Lock()

# 线程安全遍历方案:加锁或建立局部副本
with dict_lock:
    local_snapshot = shared_dict.copy()

# 在锁外部安全遍历局部副本
for k, v in local_snapshot.items():
    pass
六、核心要点总结
解决 Python 字典遍历修改报错的关键在于理解迭代器与容器大小状态的绑定机制,并在编写循环前根据业务场景明确读写分离策略。
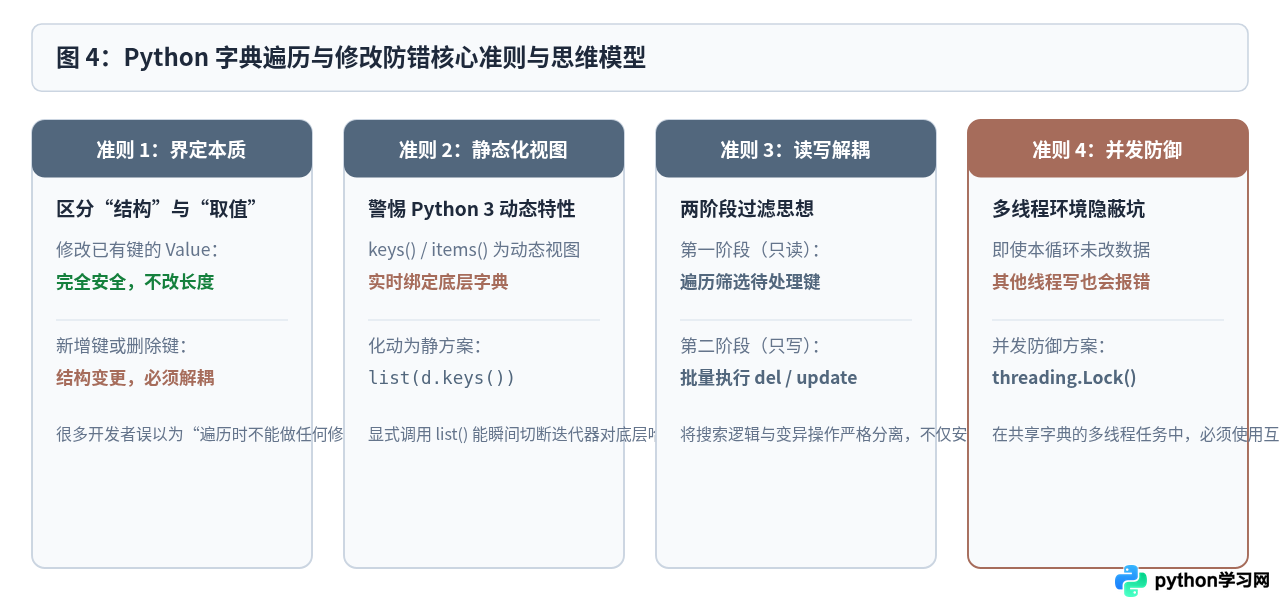
- 仅修改值(Value):无需任何额外包装,直接
d[k] = new_v,安全可靠。 - 需要删除少量键:直接遍历静态键快照
for k in list(d): del d[k]。 - 整表条件过滤:优先使用字典推导式
d = {k: v for k, v in d.items() if ...}。 - 超大型海量数据:使用双阶段队列,先收集待删键再集中删除。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















