


Python字典按值或键排序的几种常用方法
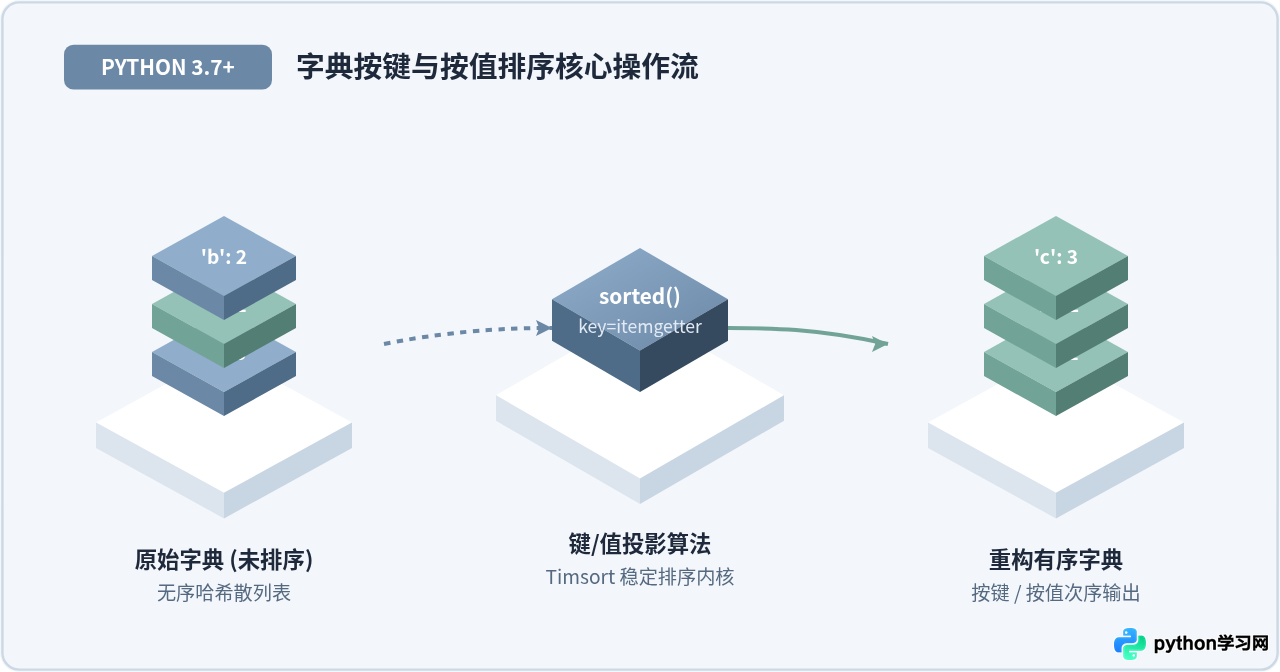
系统介绍Python字典按键或按值排序的核心机制、常用方法与工程实践,涵盖sorted()函数、operator.itemgetter、多条件排序及Top-K局部优化,配有完整代码示例与等距架构图。
dict)底层采用哈希表结构存储,本身不具备类似列表的 .sort() 原地排序方法。在实际开发中对字典排序,核心是调用内置函数 sorted() 提取字典的项视图(items())或键视图(keys()),经过特定规则排序生成有序列表后,再利用 Python 3.7+ 原生字典保持元素插入顺序的特性,通过 dict() 重新组装为有序字典。本文将围绕这一机制,详细解析按键排序、按值排序、多级复合排序以及海量数据局部优化的具体实现与工程选型。
一、为什么字典不能在原地直接排序?
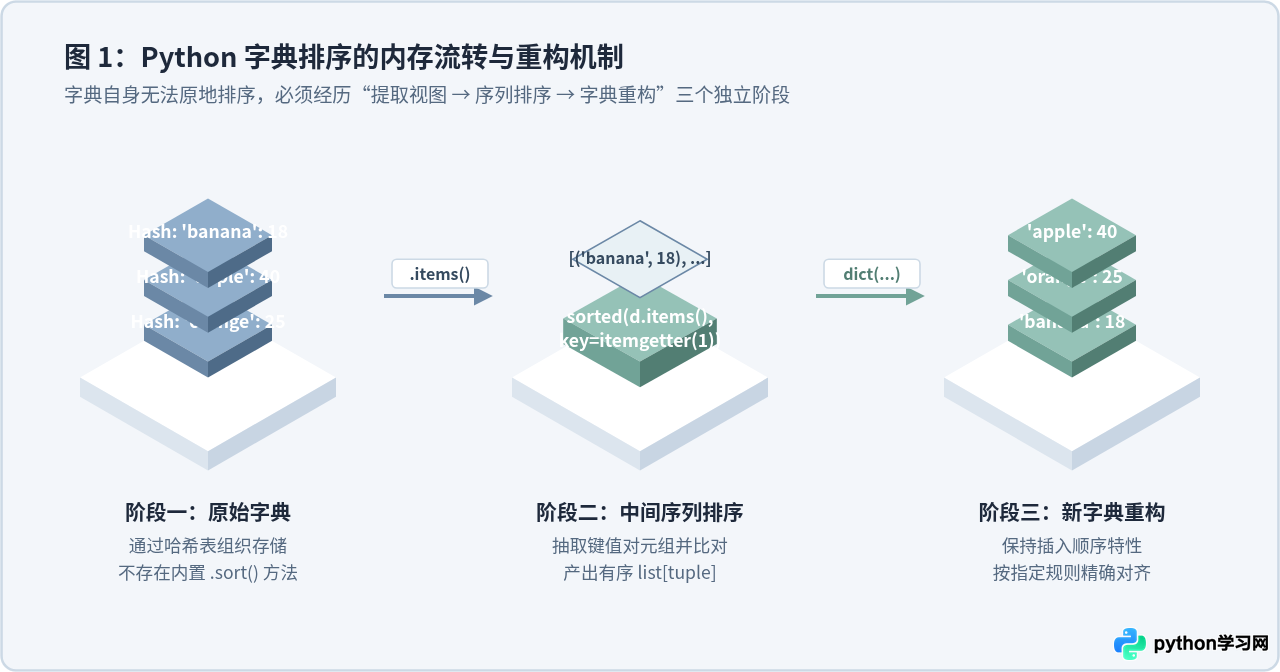
初学 Python 时容易尝试直接调用 my_dict.sort(),但这会立即引发 AttributeError。原因在于字典的本质是基于哈希映射(Hash Table)实现的关联容器,其内部存储主要为了实现接近 \(O(1)\) 时间复杂度的键值查找、插入和删除。散列桶的位置是由键对象的哈希值决定的,而不是由元素大小决定的。
从 Python 3.7 开始(CPython 3.6 作为实现细节),Python 官方正式将“字典保留插入顺序”写入语言规范。但这并不代表字典具有自动按键或按值排列的能力;它仅仅意味着:元素被插入字典时的先后顺序,在遍历 keys()、values() 或 items() 时会得到严格保持。
因此,对字典进行“排序”,本质上是一个三段式的转换过程:首先通过视图方法导出无序键值对,其次借助稳定的通用排序算法生成排好序的临时元组序列,最后将有序序列逐个灌入新字典中重新固定插入顺序。
二、按键(Key)排序的常用方法
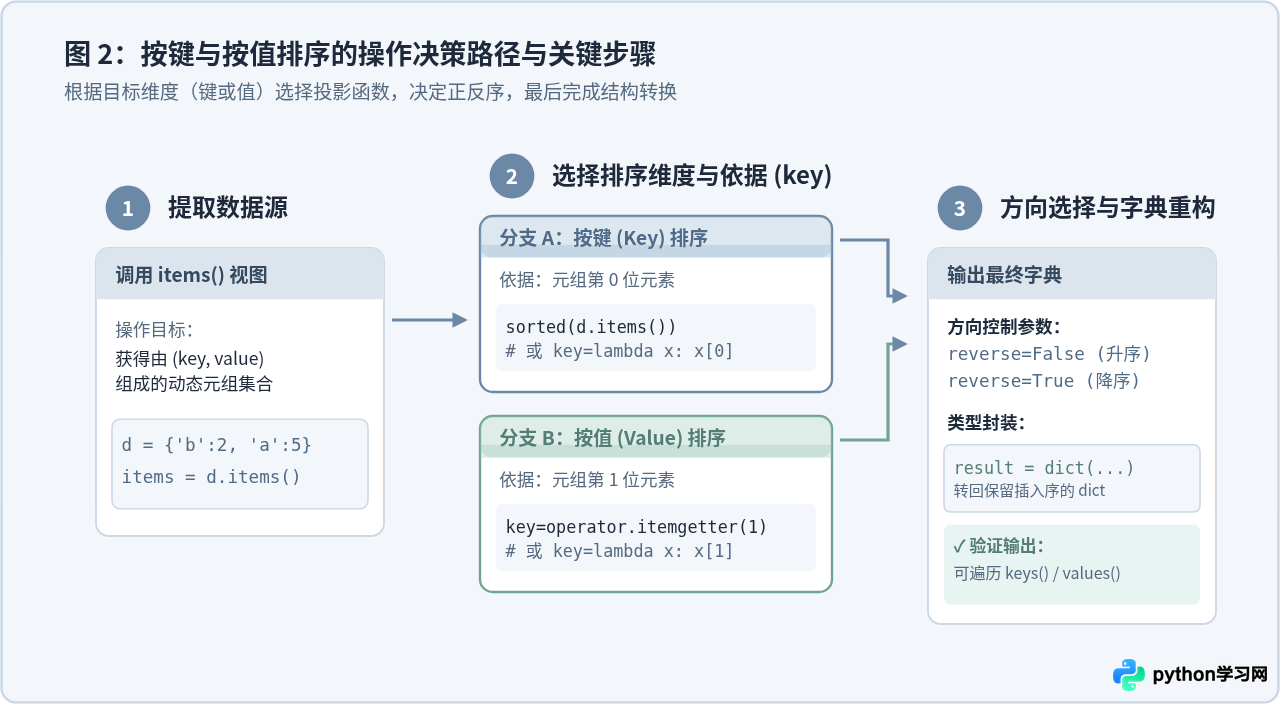
按键排序是指依据字典中键的大小(如数字大小、字符串字典序)重新组织字典条目。根据业务中是否需要保留对应的值,主要有两种常用实现方式。
1. 完整重构:使用 sorted(d.items())
当需要得到一个键排好序、且包含完整对应值的新字典时,最直接的方法是直接将 d.items() 传给 sorted()。因为 d.items() 产生的每一项都是 (key, value) 二元元组,Python 在比较两个元组时,默认首先比较索引为 0 的元素(即 key)。因此无须传入任何额外参数即可默认按键升序排序。
# 定义待排序的无序原始字典
scores = {"orange": 25, "apple": 40, "banana": 18, "pear": 30}

# 按照键升序重新组装字典
sorted_by_key = dict(sorted(scores.items()))
print("按键升序结果:", sorted_by_key)

# 若需要按键降序,添加 reverse=True 参数
sorted_by_key_desc = dict(sorted(scores.items(), reverse=True))
print("按键降序结果:", sorted_by_key_desc)按键降序结果: {'pear': 30, 'orange': 25, 'banana': 18, 'apple': 40}
2. 仅遍历访问:对 sorted(d) 迭代
如果操作目的仅是按顺序打印或依次处理数据,而不需要常驻内存的新字典对象,直接对字典自身调用 sorted() 效率更高。在 Python 中,直接对字典迭代等价于对其键迭代(即 sorted(scores) 与 sorted(scores.keys()) 结果完全一致)。
scores = {"orange": 25, "apple": 40, "banana": 18}

# 仅按排好序的键依次访问,避免构造新字典的内存开销
for k in sorted(scores):
print(f"键: {k:<8} 对应值: {scores[k]}")键: banana 对应值: 18
键: orange 对应值: 25
三、按值(Value)排序的核心实现
在数据统计、排行榜等场景中,绝大多数需求是根据数值(value)来排序。由于元组的默认比对先看第 0 项(键),因此按值排序必须显式通过 key 参数指定比较依据。
1. 使用 lambda 匿名函数指定依据
key 参数接收一个可调用对象。遍历元组 (k, v) 时,lambda item: item[1] 明确告诉排序器以元组的第 1 个元素(即值)作为权值依据。
inventory = {"monitor": 1200, "keyboard": 350, "mouse": 150, "gpu": 4500}

# 使用 lambda 按值升序排序
sorted_by_val = dict(sorted(inventory.items(), key=lambda x: x[1]))
print("按值升序:", sorted_by_val)

# 配合 reverse=True 按值降序排序
sorted_by_val_desc = dict(sorted(inventory.items(), key=lambda x: x[1], reverse=True))
print("按值降序:", sorted_by_val_desc)按值降序: {'gpu': 4500, 'monitor': 1200, 'keyboard': 350, 'mouse': 150}
2. 使用 operator.itemgetter 提升运行效率
虽然 lambda 写法非常直观,但在处理大字典时,每次比对都会产生一次 Python 字节码级别的函数调用开销。Python 标准库提供的 operator.itemgetter(1) 是由 C 语言实现的内置算子,不仅可读性更强,而且在大批量元素排序时性能通常有 15% 到 30% 的提升。
from operator import itemgetter

inventory = {"monitor": 1200, "keyboard": 350, "mouse": 150, "gpu": 4500}

# itemgetter(1) 等价于获取元素[1],由底层C加速
sorted_fast = dict(sorted(inventory.items(), key=itemgetter(1)))
print("itemgetter 排序结果:", sorted_fast)
在生产环境和性能敏感的代码段中,推荐优先导入 operator.itemgetter,避免在排序循环中重复构造 Python 函数调用栈帧。
四、复杂场景:多条件排序与嵌套字典
实际业务往往包含更细致的排序要求。例如在游戏或考试榜单中,要求“首先按成绩从高到低排序;成绩相同时,按姓名的字母升序排列”。
1. 多条件复合排序与权重元组
Python 的 sorted() 支持返回一个元组作为 key。Python 会按照元组元素的先后顺序依次判定优先级。对于数值类型字段,如果希望它降序而其他字段升序,只需在数值前加上负号 -。
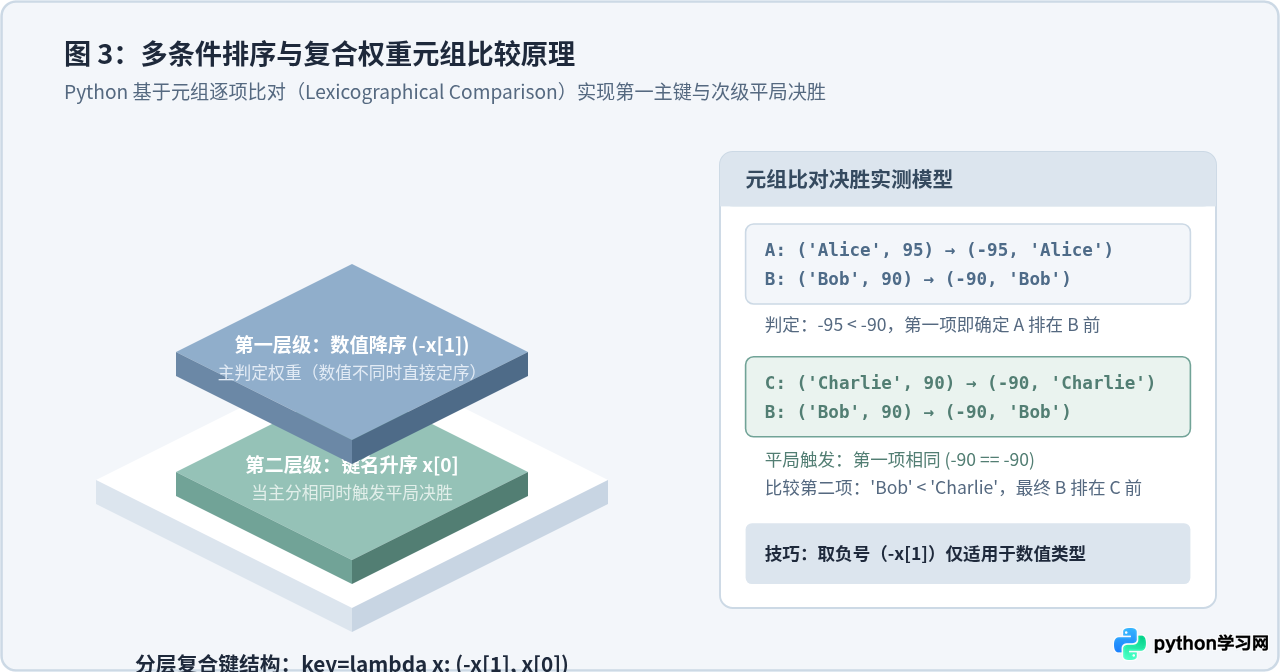
# 学生成绩字典:Bob与Charlie同为90分
exam_scores = {"Alice": 95, "Bob": 90, "Charlie": 90, "David": 85}

# 规则:分数降序(取负号-x[1]),若分数相同则按姓名升序(x[0])
rankings = dict(sorted(exam_scores.items(), key=lambda item: (-item[1], item[0])))
print("双重条件排序结果:", rankings)
在上述输出中,因为 'Bob' < 'Charlie',所以在分数均为 90 时,Bob 排在 Charlie 前面,实现了严谨平局决胜规则。
2. 嵌套字典按内部字段排序
当字典的值本身是一个子字典时,访问方式只需在 key 函数中进一步索引嵌套属性:
employees = {
    "emp_101": {"name": "Zhang", "age": 28, "salary": 18000},
    "emp_102": {"name": "Wang",  "age": 35, "salary": 26000},
    "emp_103": {"name": "Li",    "age": 24, "salary": 12000}
}

# 按照薪资从高到低排序
sorted_by_salary = dict(sorted(employees.items(), key=lambda x: x[1]["salary"], reverse=True))

for emp_id, info in sorted_by_salary.items():
print(f"{emp_id}: {info['name']} - ¥{info['salary']}")emp_101: Zhang - ¥18000
emp_103: Li - ¥12000
3. 海量数据场景:Top-K 局部堆排序
如果原始字典包含几十万甚至数百万个条目,而需求仅是取出“前 5 个最高销售额”或“前 10 名用户”,使用 sorted() 会对全量数据执行 \(O(N \log N)\) 的排序,并完整拷贝一份列表,造成极大的 CPU 与内存浪费。
此时应当采用标准库 heapq.nlargest() 或 heapq.nsmallest()。它在内部维护一个大小为 \(K\) 的最小堆或最大堆,只需单次遍历字典,时间复杂度优化为 \(O(N \log K)\),内存占用也从全量列表降至仅需缓存 \(K\) 个元素。
import heapq
from operator import itemgetter

# 模拟较大的数据集合
big_data = {f"item_{i}": (i * 37) % 1000 for i in range(100000)}

# 仅提取前 3 个最大值,无须对10万项做全量排序
top3 = heapq.nlargest(3, big_data.items(), key=itemgetter(1))
top3_dict = dict(top3)
print("Top 3 提取结果:", top3_dict)五、高频踩坑点与工程注意事项
1. 混杂类型的 TypeError 异常
在 Python 2 中,不同类型(如数字和字符串)之间支持隐式大小比较,但在 Python 3 中严禁跨类型直接比对大小。如果字典的键或值存在类型混杂(例如部分是 int,部分是 str 或 None),调用 sorted() 将直接抛出 TypeError: '<' not supported between instances of 'str' and 'int'。
在数据源不完全受控(如解析未清洗的 JSON 或外部接口)时,务必在 key 转换中做好类型规整,例如统一转为字符串:key=lambda x: str(x[1]),或显式处理 None 值。
2. 版本兼容性与 collections.OrderedDict
虽然现代 Python(3.7+)的原生 dict 已经保证了插入顺序,但如果代码需要向后兼容低版本 Python(如 3.5 或 2.7 环境),必须显式使用 collections.OrderedDict 代替原生 dict。此外,OrderedDict 具备原生字典不具备的双向循环链表专属方法(如 move_to_end() 和更高效的反向弹出操作)。
from collections import OrderedDict
from operator import itemgetter

d = {"c": 3, "a": 1, "b": 2}
# 跨版本兼容标准写法
ordered_res = OrderedDict(sorted(d.items(), key=itemgetter(1)))
3. 内存占用与生成器考量
重构字典意味着系统必须在内存中分配一块全新的哈希表内存。当字典本身极其庞大时,生成新字典会使该数据集的常驻内存直接翻倍。如果后续处理仅是一次性迭代流,应避免调用 dict(...) 进行二次封装,直接在 for k, v in sorted(...) 中消费元组流即可。
六、常用排序方法选型对比与总结
为了便于在实际开发与代码评审中快速选择最合理的方案,下表综合总结了上述各排序途径的语法特征、复杂度与典型适用场景:
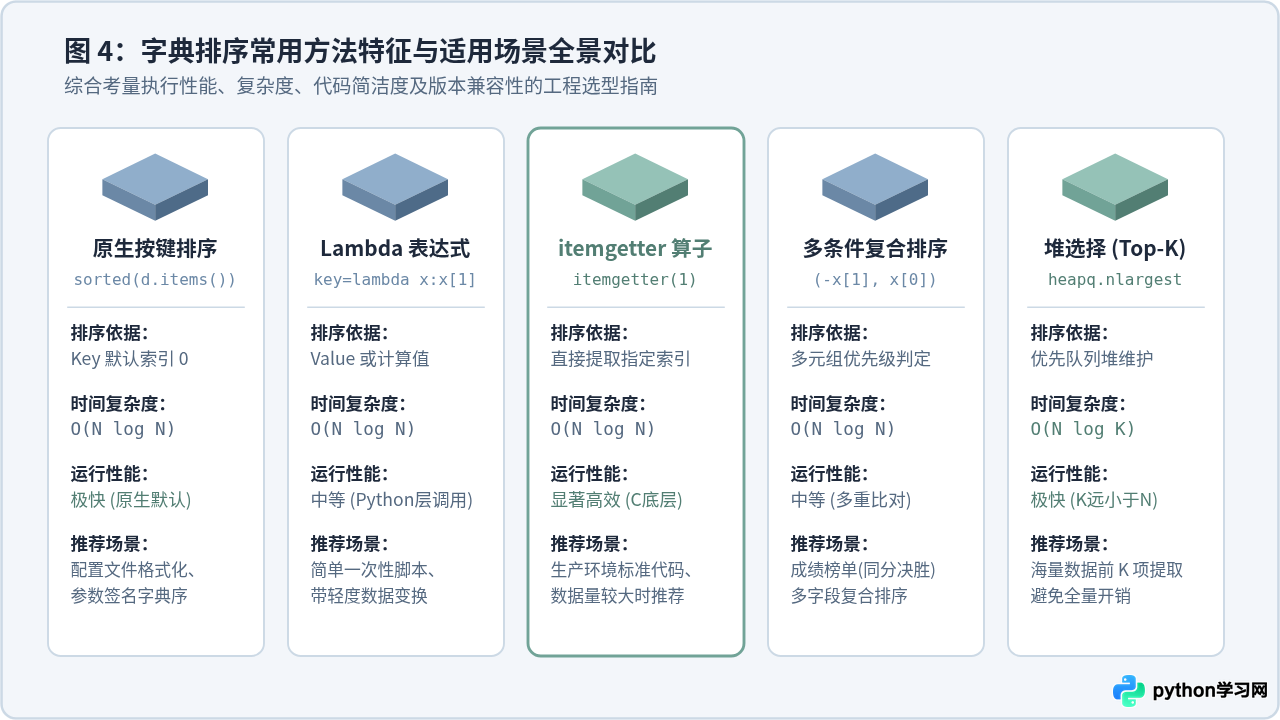
| 排序目标 | 典型代码写法 | 时间复杂度 | 性能评级 | 工程适用场景 |
|---|---|---|---|---|
| 按键升序 (原生) | dict(sorted(d.items())) |
\(O(N \log N)\) | 极快 | API 参数按字典序签名、配置文件规则排序 |
| 按值排序 (简单) | dict(sorted(d.items(), key=lambda x: x[1])) |
\(O(N \log N)\) | 良好 | 临时脚本、带轻量数据转换或条件逻辑 |
| 按值排序 (高性能) | dict(sorted(d.items(), key=itemgetter(1))) |
\(O(N \log N)\) | 极高 (C底层) | 生产环境高频调用的基础模块与海量单键排序 |
| 多条件复合排序 | dict(sorted(d.items(), key=lambda x: (-x[1], x[0]))) |
\(O(N \log N)\) | 良好 | 榜单平局决胜(如分数降序、姓名字典序升序) |
| 提取前 K 项 | dict(heapq.nlargest(k, d.items(), key=itemgetter(1))) |
\(O(N \log K)\) | 极高 (\(K \ll N\)) | 海量键值对排行榜、高频热点指标过滤 |
掌握字典排序的关键在于理解其“抽取 → 排序 → 重组”的核心逻辑。根据实际的数据量规模选择全量排序或堆局部提取,根据性能要求合理选用 operator.itemgetter,即可写出兼具可读性与运行效率的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















