


Python二分查找手写实现:递归与迭代写法详解
深入详解Python手写二分查找的两种标准实现方案:迭代法与递归法。从有序序列的前提判定、双指针闭区间收缩、中间索引计算防溢出,到递归终止条件与调用栈机制,配合完整代码示例与多幅推导流程图,帮助读者掌握算法实现与避坑技巧。
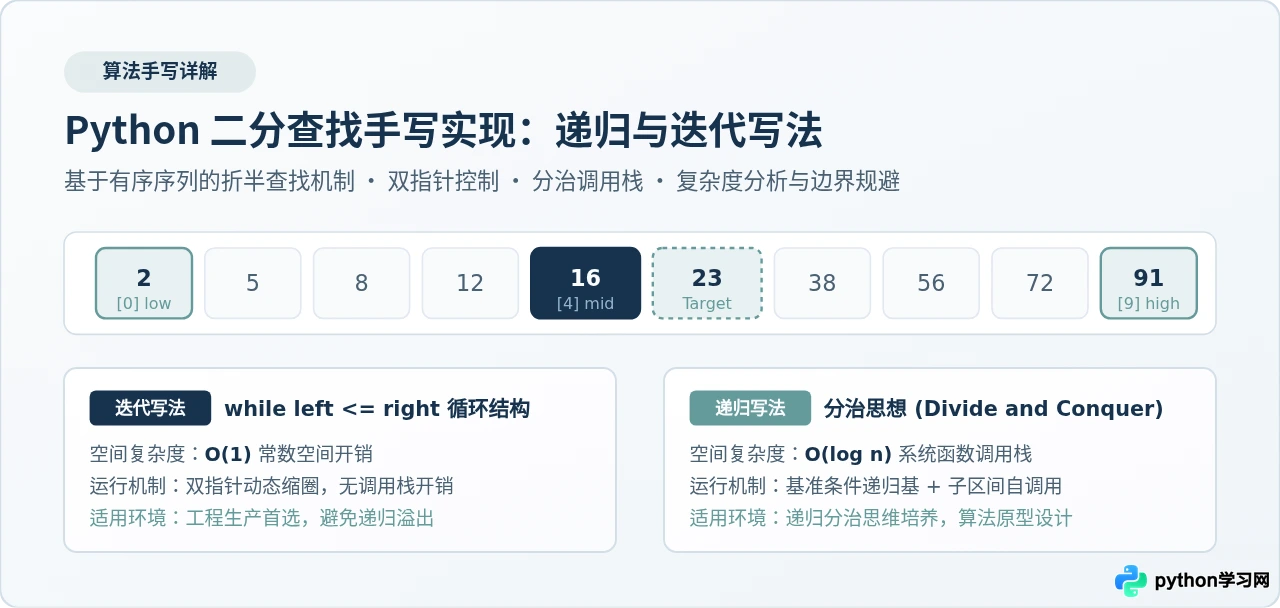
一、二分查找的核心原理与前提条件
二分查找能够成立并保证正确性的根本前提是:目标序列必须满足单调有序性(通常为升序或降序)。如果序列未排序,二分折半的逻辑前提便不复存在,必须先使用排序算法整理序列,或直接采用线性查找。
在升序列表中查找目标值 target 时,算法通过双指针维护一个待查找区间。每一次查找都取当前区间的中间元素 nums[mid] 与 target 比对:
- 若 nums[mid] == target:找到目标,立即返回该元素的下标索引
mid。 - 若 nums[mid] < target:由于数组有序,
mid及其左侧所有元素均小于目标值,目标必定落在右半区间,因此缩小范围至右侧。 - 若 nums[mid] > target:同理,
mid及其右侧所有元素均大于目标值,目标必定落在左半区间,因此缩小范围至左侧。
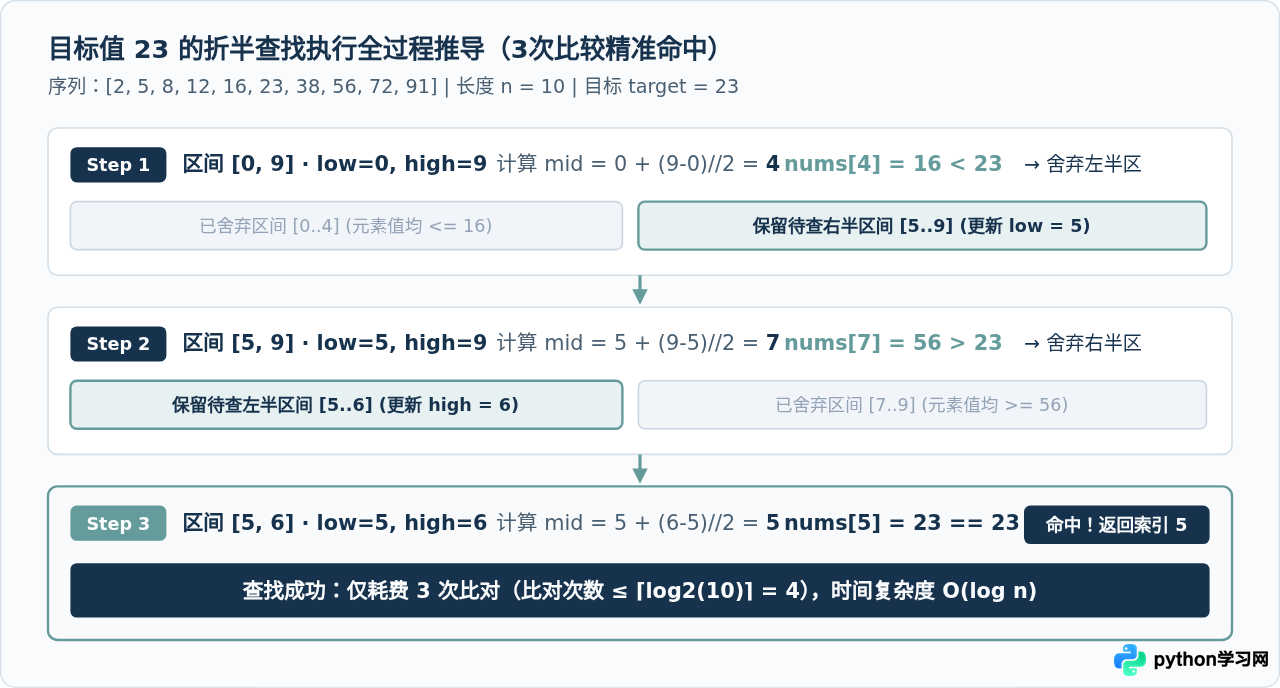 图 1:二分查找在有序数组中检索目标值 23 的推导折半步骤
如上图所示,对于包含 10 个元素的序列,线性查找最坏需要比较 10 次,而二分查找在第 3 次比较时即可准确定位目标索引 5。在含有 100 万个元素的序列中,二分查找最多也仅需大约 20 次比对即可完成检索,展现出对数级增长的显著性能优势。
二、迭代写法手写实现(闭区间方案)
迭代写法通常基于 while 循环与双指针实现。在手写二分查找时,最清晰且最不易出错的模型是闭区间模型(即两端均包含的 [left, right])。
1. 关键边界与变量定义
- 初始化区间:
left = 0,right = len(nums) - 1。这代表待查范围是包含首尾索引的闭区间[left, right]。 - 循环终止条件:
while left <= right:。当left == right时,区间[left, left]依然包含一个合法元素,必须进行最后一次判断。只有当left > right时区间才完全为空,循环方可终止。 - 指针收缩幅度:因为
nums[mid]已经确认不等于target,下一轮区间必须排除mid,即右移写为left = mid + 1,左移写为right = mid - 1。如果写成left = mid或right = mid,会导致区间无法单调缩小而陷入死循环。
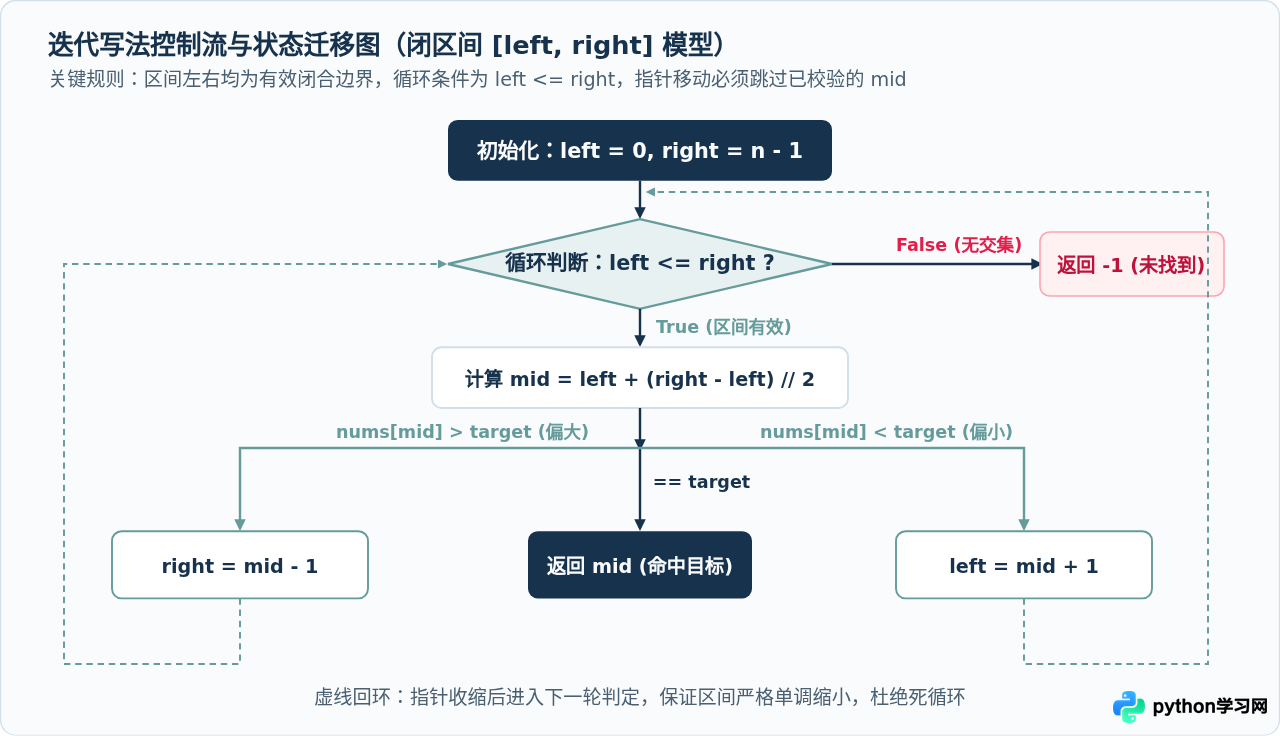 图 2:迭代写法控制流与状态迁移图(闭区间模型)
2. 完整代码示例
def binary_search_iterative(nums: list[int], target: int) -> int:
    # 边界前置检查:若数组为空则直接返回未找到
    if not nums:
        return -1

    left: int = 0
    right: int = len(nums) - 1

    # 闭区间下,left == right 时仍有唯一待检测元素
    while left <= right:
        # 采用防溢出规范写法:left + (right - left) // 2
        mid: int = left + (right - left) // 2

        if nums[mid] == target:
            return mid  # 命中目标,立即返回索引
        elif nums[mid] < target:
            left = mid + 1  # 目标在右侧,收缩左边界
        else:
            right = mid - 1  # 目标在左侧,收缩右边界

    return -1  # 区间交错 (left > right),目标值不存在
在 Python 中,整数类型支持无限精度大整数计算,理论上 (left + right) // 2 不会像 C/C++ 或 Java 那样产生 32 位整型溢出。但在编写算法与工业代码时,推荐统一使用 left + (right - left) // 2,既能保持跨语言编码规范的一致性,也能清晰表达“在左指针基准上增加区间半长”的数学含义。
三、递归写法手写实现(分治与调用栈)
递归写法体现的是典型的分治思想(Divide and Conquer):将大区间的查找问题拆解为结构相同但规模折半的子区间查找问题,直至触发递归基准条件(Base Case)。
1. 递归设计三大要素
- 参数定义:除了序列
nums和目标target外,需要显式传递当前子区间的边界left和right。通常对外暴露一个无多余边界参数的主函数,内部调用辅助函数。 - 基准终止条件(Base Case):
- 若
left > right:说明区间已无有效元素,直接返回-1。 - 若
nums[mid] == target:找到目标值,直接返回mid。
- 若
- 单层递推与结果透传:根据比较结果,向左半区间或右半区间发起递归调用,并且必须将递归调用的返回值通过
return向上层逐级透传。
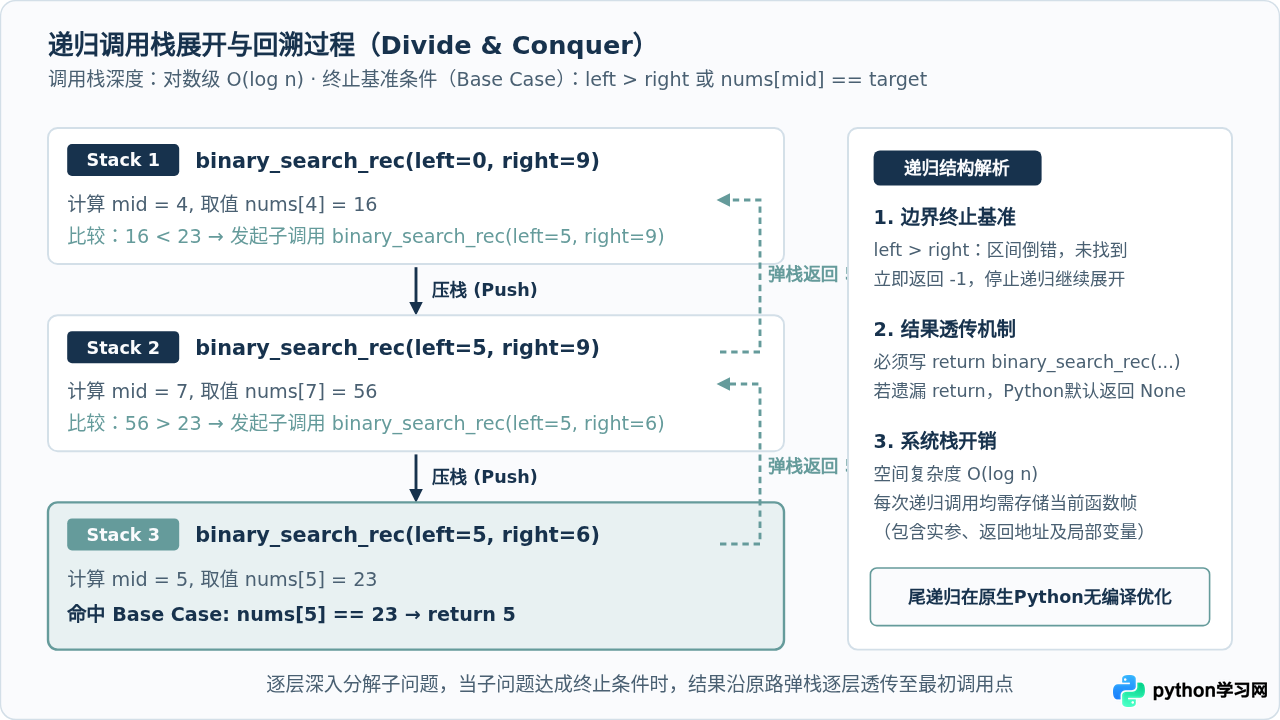 图 3:递归调用栈展开、子问题递归及逐层弹栈回溯过程
2. 完整代码示例
def binary_search_recursive(nums: list[int], target: int) -> int:
    if not nums:
        return -1

    # 内部辅助函数,携带闭区间指针参数
    def _helper(left: int, right: int) -> int:
        # 基准条件 1:区间无效,查找失败
        if left > right:
            return -1

        mid: int = left + (right - left) // 2

        # 基准条件 2:命中目标
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            # 向右半区间递归,注意务必 return 结果
            return _helper(mid + 1, right)
        else:
            # 向左半区间递归,注意务必 return 结果
            return _helper(left, mid - 1)

    # 初始调用:闭区间覆盖 0 至 len(nums) - 1
    return _helper(0, len(nums) - 1)
四、迭代与递归的深度对比与性能分析
在时间复杂度层面,两种写法的渐近效率完全相同:最好情况下第 1 次比对即命中目标,耗时 O(1);最坏与平均情况下,每次比较都剔除一半候选元素,总比对次数上限为 ⌈log2(n)⌉,时间复杂度均为 O(log n)。
然而在空间效率与底层执行机制上,二者存在根本性区别:
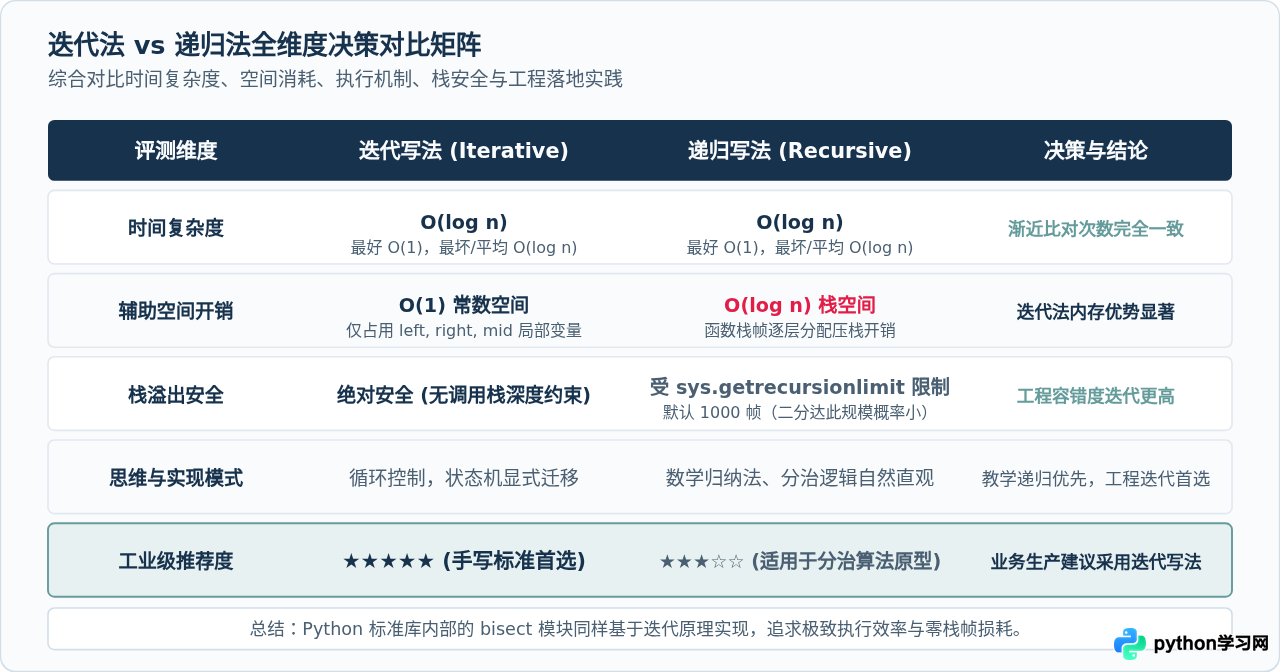 图 4:二分查找迭代法与递归法全维度决策对比矩阵
1. 内存开销与调用栈深度
迭代法仅在内存中分配 left、right、mid 三个局部整型变量,整个循环过程中空间占用恒定,空间复杂度为 O(1)。
递归法在每次调用 _helper 时,Python 解释器都需要在系统栈上新建一个函数调用栈帧(Stack Frame),用来保存形参、局部变量及上一层函数的返回地址。虽然二分查找的调用树高度仅为 O(log n),即使对于 1 亿规模的数据,调用深度也仅有约 27 层,但相比于纯循环,函数调用与压栈弹栈的系统开销仍然客观存在。
2. Python 递归深度限制(RecursionError)
Python 解释器为了防止 C 语言级别系统调用栈耗尽导致崩溃,默认设定了递归深度上限(通过 sys.getrecursionlimit() 可查看,通常为 1000)。虽然二分查找的 O(log n) 栈深几乎不可能突破 1000(21000 是一个天文数字),但由于 CPython 原生并不对尾递归进行优化,在大型工程与性能敏感路径上,迭代写法依然是绝对的工业级首选。
五、手写二分查找的高频陷阱与避坑清单
二分查找思路清晰,但极容易在细节上出现边界纰漏(即著名的“思路 5 分钟,调边界 2 小时”)。手写时需特别留心以下四大陷阱:
如果右指针初始化为 right = len(nums) - 1(闭区间),但循环条件误写成 while left < right:,当待查找元素恰好位于数组末尾(如 nums = [1, 3, 5] 查找 5)时,循环会在 left == right == 2 时提前退出,导致返回 -1 漏查目标。
当更新边界时,如果误写成 left = mid 或 right = mid,在区间收窄到 2 个元素(例如 left=0, right=1)且向下取整时,mid 计算结果始终为 0。若此时 nums[0] < target,left = mid 使得 left 继续为 0,区间无法缩小,程序将彻底陷入死循环。每一次收缩必须严格加 1 或减 1:left = mid + 1 / right = mid - 1。
初学者手写递归二分时,有时会直觉使用 Python 切片语法传递子数组:binary_search(nums[:mid], target)。在 Python 中,列表切片操作会进行浅拷贝,复制 k 个元素耗时 O(k)。这种写法不仅消耗大量内存,而且会让总时间复杂度从 O(log n) 退化为 O(n),彻底丧失二分查找的性能优势。正确做法是始终传递原列表引用,仅通过索引指针指定边界。
在递归分支中,如果写成 _helper(mid + 1, right) 而遗漏了 return,即便底层的 Base Case 成功匹配并返回了索引,该值也无法回传给上层函数,最终顶层调用将默认返回 None。
六、总结与手写速查表
为了在算法面试或日常工程开发中做到一次性无 Bug 手写二分查找,可以牢记以下这套“闭区间心智模型”:
| 关键要素 | 标准闭区间配置 [left, right] | 设计意图与避坑原因 |
|---|---|---|
| 右指针初值 | right = len(nums) - 1 |
涵盖最后一个有效元素下标,区间双向闭合。 |
| 循环条件 | while left <= right: |
确保单个元素构成的区间 [left, left] 能被正常比对。 |
| 中点防溢出 | mid = left + (right - left) // 2 |
跨语言通用规范,避免大数相加溢出,保持规范整洁。 |
| 左指针移动 | left = mid + 1 |
排除已校验且偏小的 mid,严格收缩区间。 |
| 右指针移动 | right = mid - 1 |
排除已校验且偏大的 mid,严格收缩区间。 |
| 未找到返回值 | return -1 |
区间错位(left > right)时退出,标识目标值不存在。 |
在实际项目编码中,如果你只需要直接使用二分查找功能,可以直接利用 Python 内置标准库中的 bisect 模块(如 bisect.bisect_left、bisect.insort),其底层经过精心优化,具有极佳的稳定性;但当面对具有特殊业务判断条件的变种查找问题(如寻找左侧边界、旋转排序数组查找、二分答案等)时,熟练掌握手写迭代与递归的边界控制逻辑是解决复杂问题的核心基本功。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















