


Python实现MinHash算法进行近似重复检测
深入讲解如何使用Python从零实现MinHash(最小哈希)算法,用于海量文本近似重复检测。涵盖k-shingle集合构建、多项式随机哈希签名生成、Jaccard相似度无偏估计以及LSH分桶加速方案与完整代码。
一、从非结构化文本到特征集合:k-Shingle 切分
自然语言文本通常表现为一段连续的字符序列。若直接对比两篇文档的字符或整词,即便只是调换了段落顺序或微调了个别字句,基于字符串哈希(如 MD5、SHA256)的比较结果都会彻底改变;而基于 Levenshtein 编辑距离的计算时间复杂度为 O(|A| × |B|),无法承受万级文本的批量对比。
MinHash 的基础是集合理论。我们需要先将连续的文本映射为一个由离散局部片段构成的集合,这个技术称为 k-Shingle(或字符/词级 n-gram)。
1. 什么是 k-Shingle
一个文本的 k-shingle 是指该文本中任意长度为 k 的连续子序列。通过滑动窗口对文本进行提取,所有不重复的子序列构成了该文档的特征集合。例如:
原文:“Python实现文本去重算法”
切分结果集合:{"Python实", "ython实现", "thon实现文", "hon实现文本", "实现文本去", "现文本去重", "文本去重算", "本去重算法"}
将文本转化为集合后,两篇文档 A 和 B 的相似度即可用 Jaccard 相似度系数 严格定义:
当两篇文档完全相同时,Jaccard 值为 1.0;当两者毫无交集时,Jaccard 值为 0.0。
2. 参数 k 的选取准则
在工程实践中,滑动窗口大小 k 的选取至关重要:
- k 过小(如中文字符 k=1 或英文 k=2):任意两篇语言相同的正常文章都会包含大量的常用字符或虚词(如“的”、“了”、“是”),导致集合交集被无意义的公共高频词填满,即便毫无关联的文章也会得出偏高的 Jaccard 相似度,产生严重误报。
- k 过大(如中文字符 k=20):过长的短语极易受到轻微修改、标点变动或错别字破坏。洗稿者只需随意插入一个连词,就能使一整段原本相似的短语切片完全无法重合,导致漏报。
- 经验推荐:对于篇幅在数百至数千字的中文新闻或博客,字符级推荐
k = 3 ~ 4;若先进行分词处理(jieba 分词),词语级推荐k = 2 ~ 3。
二、MinHash 核心数学原理:最小哈希与 Jaccard 契约
假设我们通过 Shingling 从整个语料库中提取出了所有不重复的特征,其全集基数通常多达数十万乃至数千万。如果直接用稠密向量或布尔特征矩阵表示每篇文档,内存消耗与求交开销依然无法接受。MinHash 的突破性在于:它用若干个随机哈希函数的最小值,构造一个极短的固定维度签名向量。
数学原理的关键结论
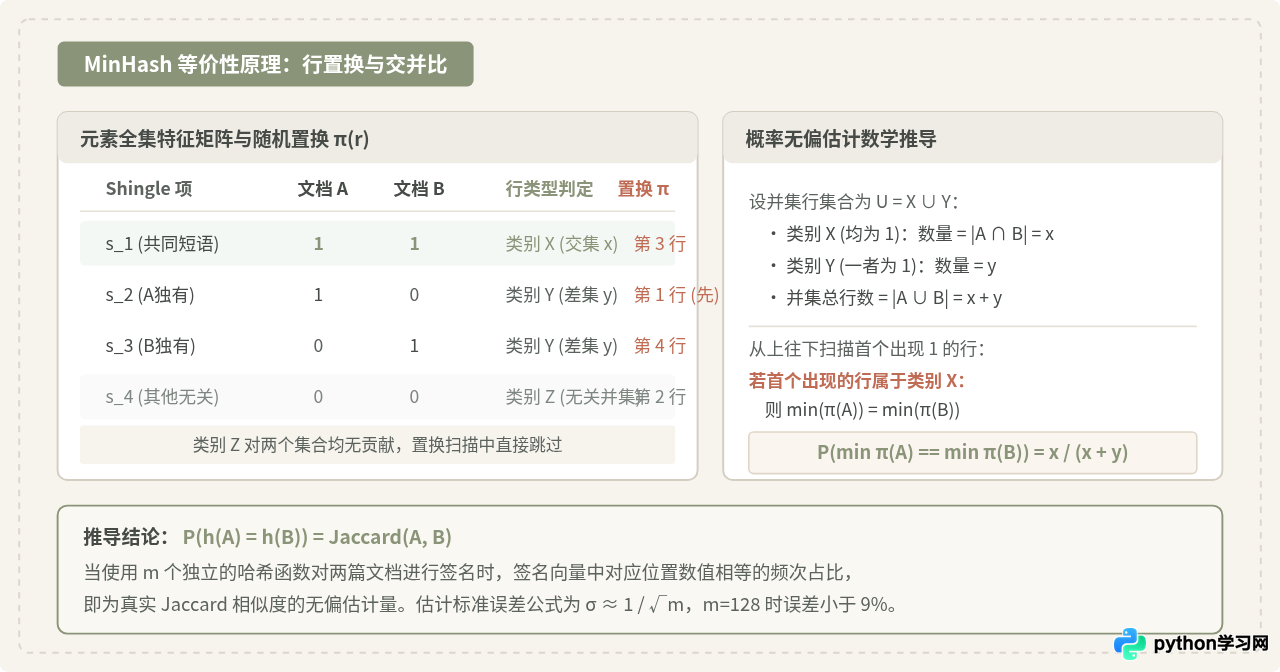
设集合全集经过随机置换 π 后,对集合 A 中所有元素,取置换后位置最小的那个值作为 h(A) = min(π(A))。
由于类别 Z(两篇文档均不包含的特征)对结果毫无影响,真正竞争“谁先在置换序列中出现”的候选仅限于并集 A ∪ B。在均匀随机置换的前提下,这 |A ∪ B| 个元素中的任何一个成为第一个出现的概率都是均等的。只有当这个第一个出现的元素刚好落在交集 A ∩ B 中时,h(A) 才会与 h(B) 取得完全相同的值。
因此,两集合最小哈希值相等的概率严格等于其 Jaccard 相似度:
三、容易混淆的认知辨析
在实际应用 MinHash 进行文本去重时,初学者常常存在以下三种典型认知误区,需要明确辨析其适用边界:
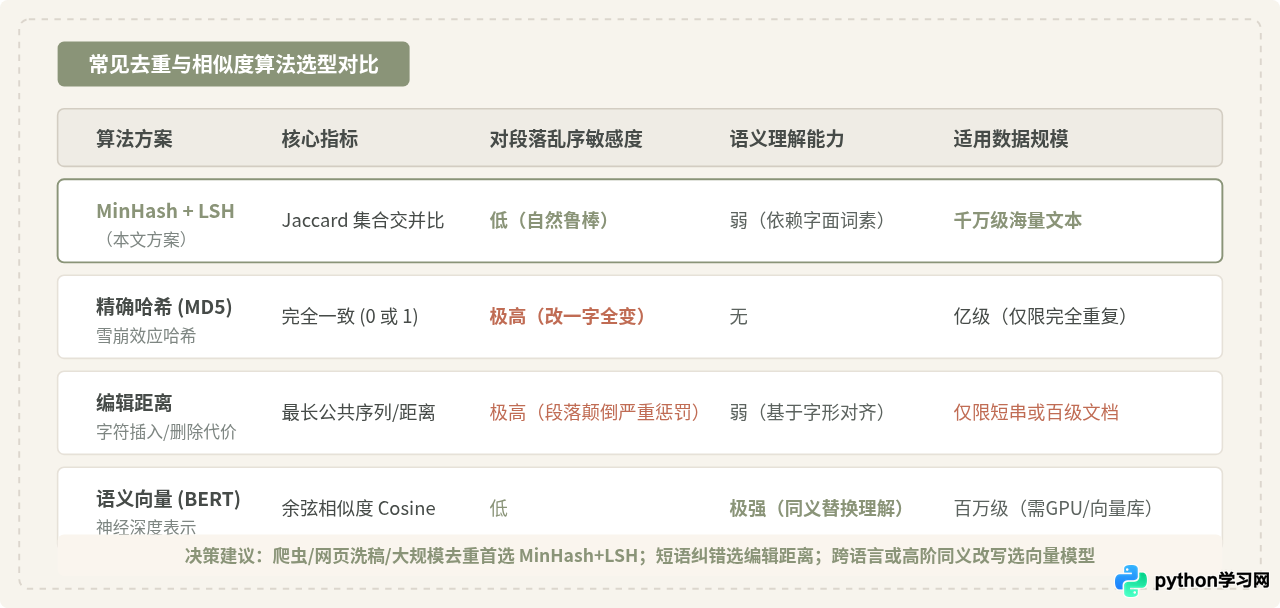
不准确。MinHash 严格估计的是 Jaccard 集合交并比,其基础是文本中词素或字符片段的字面重合度。如果一篇文章被用完全不同的同义词进行重写(例如将“汽车”全换为“车辆”,“购买”换为“购置”),词素集合交集将急剧萎缩,MinHash 的相似度会极低。MinHash 针对的是“高相似、微修改、剪切拼接、段落颠倒”的近似重复检测,而非深层语义理解。
并非绝对最优。MinHash 签名的估计误差标准差为 1 / √m。当维度 m 从 64 提升到 128 时,误差从 12.5% 下降到 8.8%;提升到 256 时为 6.25%。但维度翻倍意味着哈希计算耗时和签名索引内存开销线性翻倍。工程上,128 维或 256 维已能在性能与精度之间取得极佳平衡,盲目增大维度收效甚微。
严重混淆。MinHash 单独使用时,仅仅是将两个文档集合的比较代价从 O(|S|) 压缩到了固定长度 O(m)。但如果依然对 N 篇文档进行两两对比,比对总次数依然是 N × (N - 1) / 2,依然是 O(N²) 复杂度!必须配合局部敏感哈希(LSH)的分桶机制,才能将比对范围缩小到极少数高概率冲突桶内,真正实现亚二次(接近线性)检索。
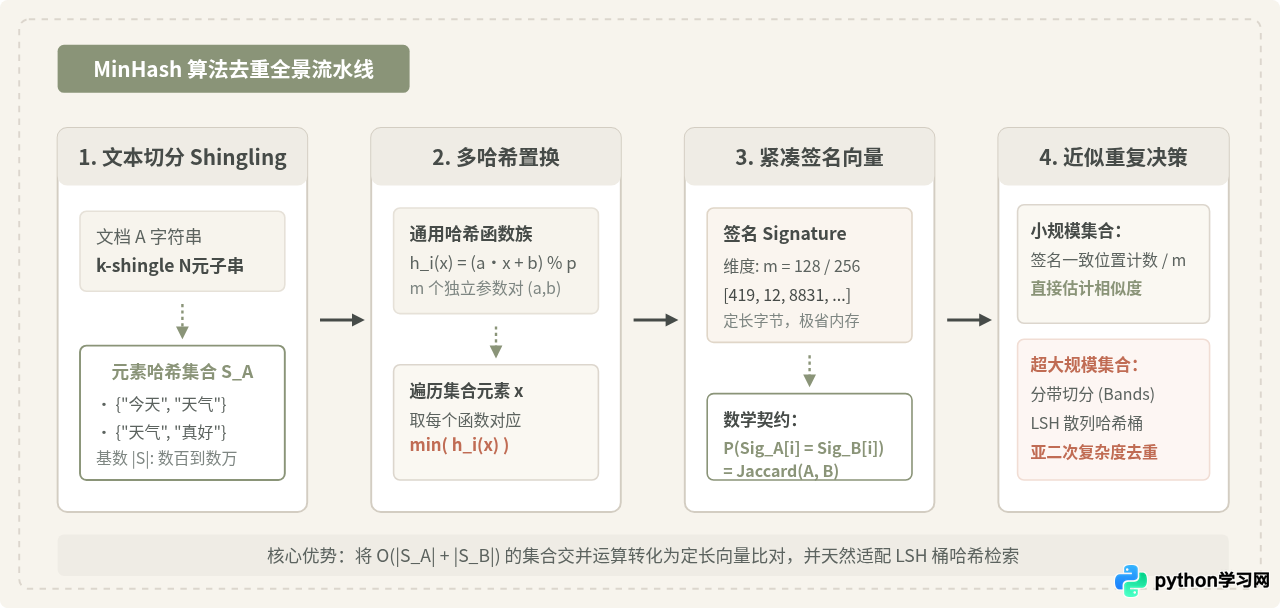
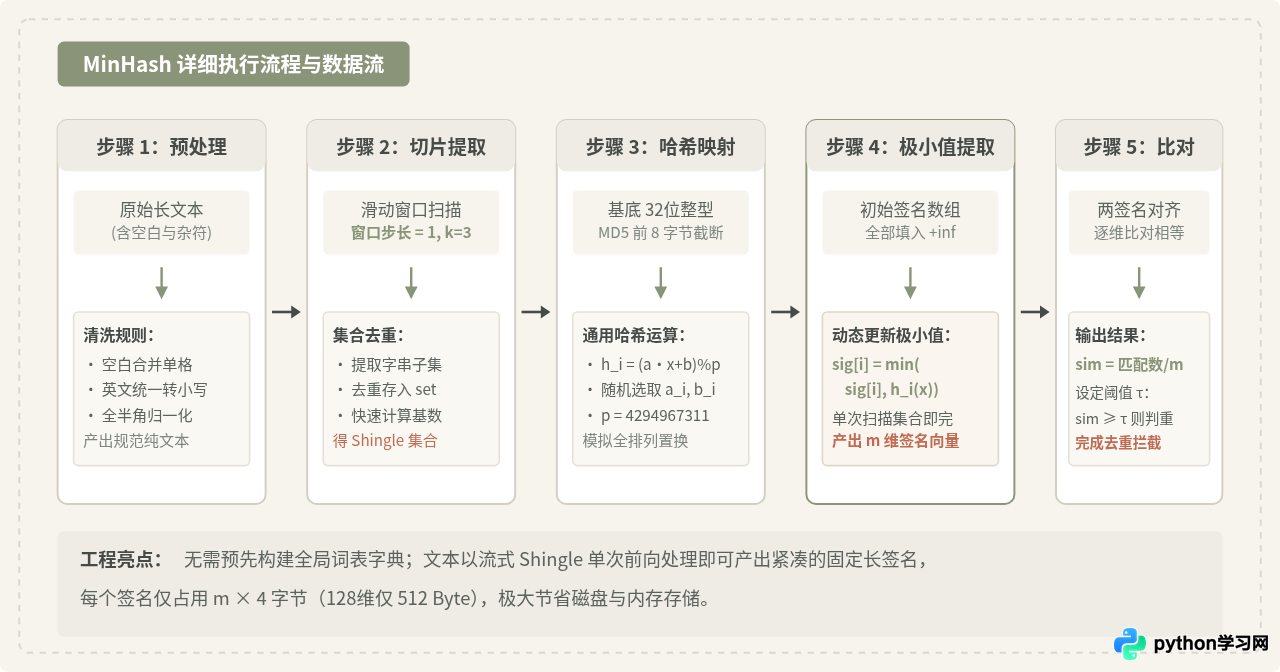
四、算法实现流程全景
在编写代码前,我们将从文本输入到最终判定重复的端到端数据流动与处理步骤梳理为明确的操作流水线:
五、Python 从零实现 MinHash 核心算法
下面我们编写纯 Python 实现。代码不依赖第三方大件库,仅使用标准库的 hashlib、random 和 re。
1. 文本规范化与 Shingling 模块
首先完成文本清洗与连续 k-shingle 集合的提取:
import hashlib
import random
import re
from typing import List, Set, Tuple, Dict

def extract_shingles(text: str, k: int = 3) -> Set[str]:
    """
    对文本进行规范化并提取连续的 k-shingle 集合
    :param text: 输入的原始字符串
    :param k: 滑动窗口长度(字符级)
    :return: 包含唯一 k-shingle 元素的集合
    """
    # 1. 规整空白字符并转小写
    cleaned = re.sub(r'\s+', ' ', text.strip().lower())

    # 2. 短文本退化防护:文本长度不足 k 时整体作为单个特征项
    if len(cleaned) <= k:
        return {cleaned} if cleaned else set()

    # 3. 滑动窗口切分
    shingles = set()
    for i in range(len(cleaned) - k + 1):
        shingles.add(cleaned[i:i + k])

    return shingles

def stable_hash(token: str) -> int:
    """
    将任意字符片段稳定散列为 32 位无符号整数
    避免 Python 内置 hash() 在进程重启时的随机加盐问题
    """
    return int(hashlib.md5(token.encode('utf-8')).hexdigest()[:8], 16)
2. MinHash 签名生成器类
工程中模拟海量行全排列的经典做法是采用 通用哈希函数族(Universal Hashing):
其中 p 是一个大于 2^32 的大质数(如 4294967311),a_i 为随机正奇数,b_i 为随机非负整数。每个哈希函数由唯一的 (a_i, b_i) 参数对决定。
class MinHashGenerator:
    """
    MinHash 签名生成器与相似度评估器
    """
    def __init__(self, num_perm: int = 128, seed: int = 42):
        """
        :param num_perm: 哈希置换数量(签名向量维度 m)
        :param seed: 随机数发生器种子,保证多次运行参数恒定
        """
        self.num_perm = num_perm
        self.prime = 4294967311  # 大于 2^32 的经典质数
        self.max_hash = 2**32 - 1

        # 预先生成固定的随机参数对 (a, b)
        rng = random.Random(seed)
        self.a_params: List[int] = []
        self.b_params: List[int] = []

        for _ in range(num_perm):
            # a 须为正整数且与 prime 互质
            a = rng.randint(1, self.prime - 1)
            b = rng.randint(0, self.prime - 1)
            self.a_params.append(a)
            self.b_params.append(b)

    def compute_signature(self, shingles: Set[str]) -> List[int]:
        """
        对输入的 shingle 集合计算 MinHash 签名向量
        :param shingles: 字符串特征集合
        :return: 长度为 num_perm 的整数列表
        """
        if not shingles:
            return [0] * self.num_perm

        # 初始化签名向量为极大值
        signature = [self.prime] * self.num_perm

        # 遍历集合中每个特征项
        for item in shingles:
            x = stable_hash(item)
            # 对每一个置换函数计算并维护当前最小值
            for i in range(self.num_perm):
                val = (self.a_params[i] * x + self.b_params[i]) % self.prime
                if val < signature[i]:
                    signature[i] = val

        return signature

    @staticmethod
    def estimate_jaccard(sig_a: List[int], sig_b: List[int]) -> float:
        """
        通过比对两个签名对应位置相等的比例,估计 Jaccard 相似度
        """
        if len(sig_a) != len(sig_b) or not sig_a:
            return 0.0

        matches = sum(1 for val_a, val_b in zip(sig_a, sig_b) if val_a == val_b)
        return matches / len(sig_a)

    @staticmethod
    def exact_jaccard(set_a: Set[str], set_b: Set[str]) -> float:
        """计算真实的 Jaccard 相似度(用于对照验证)"""
        if not set_a and not set_b:
            return 1.0
        union_size = len(set_a | set_b)
        if union_size == 0:
            return 0.0
        return len(set_a & set_b) / union_size
六、海量扩展:结合局部敏感哈希(LSH)分桶
当待检测文档数量增加到数万甚至数百万篇时,两两比对 MinHash 签名的耗时依然不可忽视。为了解决海量数据的扩展瓶颈,我们需要引入 LSH(Locality-Sensitive Hashing)分桶机制。
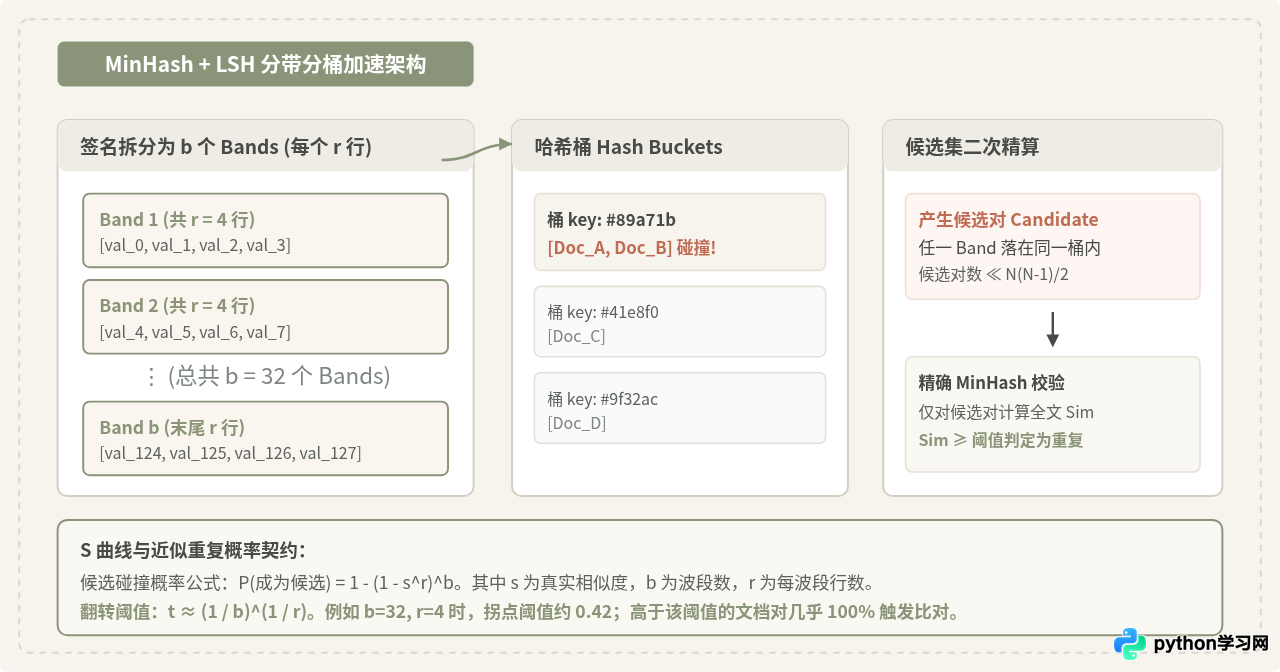
LSH 分桶实现代码
下面将分带与哈希桶索引封装为一个简洁高效的 MinHashLSH 类:
class MinHashLSH:
    """
    局部敏感哈希分桶索引器
    将 O(N^2) 的比对复杂度降低至近线性检索
    """
    def __init__(self, num_perm: int = 128, threshold: float = 0.6):
        """
        :param num_perm: 签名总长度 m
        :param threshold: 期望的相似度拦截阈值 t
        """
        self.num_perm = num_perm
        self.threshold = threshold
        self.b, self.r = self._optimize_bands(num_perm, threshold)

        # 为每个 band 初始化一个独立的哈希散列表
        self.hash_tables: List[Dict[int, List[str]]] = [{} for _ in range(self.b)]
        self.signatures: Dict[str, List[int]] = {}

    def _optimize_bands(self, num_perm: int, threshold: float) -> Tuple[int, int]:
        """
        寻找使得近似阈值 (1/b)^(1/r) 最贴近目标 threshold 的最优 (b, r) 分割
        """
        best_b, best_r = 1, num_perm
        min_diff = float('inf')

        for b in range(1, num_perm + 1):
            if num_perm % b == 0:
                r = num_perm // b
                approx_t = (1.0 / b) ** (1.0 / r)
                diff = abs(approx_t - threshold)
                if diff < min_diff:
                    min_diff = diff
                    best_b, best_r = b, r

        return best_b, best_r

    def insert(self, doc_id: str, signature: List[int]):
        """
        将文档签名按 Band 插入哈希桶
        """
        self.signatures[doc_id] = signature
        for band_idx in range(self.b):
            start = band_idx * self.r
            end = start + self.r
            band_tuple = tuple(signature[start:end])
            bucket_key = hash(band_tuple)

            table = self.hash_tables[band_idx]
            if bucket_key not in table:
                table[bucket_key] = []
            table[bucket_key].append(doc_id)

    def query(self, doc_id: str) -> List[Tuple[str, float]]:
        """
        查询与给定文档高度相似的所有候选重复文档及其估算相似度
        """
        if doc_id not in self.signatures:
            return []

        target_sig = self.signatures[doc_id]
        candidates: Set[str] = set()

        # 1. 快速搜集在任意一个 band 发生哈希碰撞的候选者
        for band_idx in range(self.b):
            start = band_idx * self.r
            end = start + self.r
            band_tuple = tuple(target_sig[start:end])
            bucket_key = hash(band_tuple)

            bucket = self.hash_tables[band_idx].get(bucket_key, [])
            for cand_id in bucket:
                if cand_id != doc_id:
                    candidates.add(cand_id)

        # 2. 仅对碰撞候选者进行 MinHash 签名全量精算比对
        results = []
        for cand_id in candidates:
            cand_sig = self.signatures[cand_id]
            est_sim = MinHashGenerator.estimate_jaccard(target_sig, cand_sig)
            if est_sim >= self.threshold:
                results.append((cand_id, round(est_sim, 4)))

        results.sort(key=lambda x: x[1], reverse=True)
        return results
七、端到端测试与结果验证
我们构造四篇典型场景的测试文本,涵盖“完全原创”、“段落调序与微量同义洗稿”、“部分抄袭拼接”以及“毫不相干的完全异类主题”,检验 MinHash 的判重效果与真实 Jaccard 指标的偏差。
def run_demonstration():
    # 构造测试文档库
    documents = {
        "doc_origin": (
            "Python凭借简洁优美的语法、极其丰富的第三方数据科学库以及极其活跃的开源社区,"
            "在人工智能、机器学习、自然语言处理和自动化运维领域取得了压倒性的广泛应用。"
        ),
        "doc_shuffled_minor_edit": (
            "在人工智能、自动化运维和自然语言处理等关键领域,Python取得了压倒性的广泛应用;"
            "这很大程度上凭借其简洁优美的语法、非常丰富的开源第三方数据科学库。"
        ),
        "doc_partial_copy": (
            "今天的天气非常晴朗,阳光明媚。顺便提一下,Python凭借简洁优美的语法、"
            "极其丰富的第三方数据科学库在很多计算机领域得到了应用。下午打算去公园散散步。"
        ),
        "doc_irrelevant": (
            "番茄炒鸡蛋是一道经典的传统家常菜,制作时应当先将鸡蛋打散煎熟,"
            "再加入切块的新鲜成熟番茄大火翻炒,最后加入适量食盐与小葱提香出锅。"
        )
    }

    # 1. 初始化 MinHash 与 LSH 索引
    m = 128
    k = 3
    threshold = 0.5
    minhash = MinHashGenerator(num_perm=m, seed=2026)
    lsh = MinHashLSH(num_perm=m, threshold=threshold)

    print(f"=== MinHash 近似重复检测配置 ===")
    print(f"置换维度 m: {m}, 字符切片 k: {k}, 判定阈值: {threshold}")
    print(f"LSH 自动优化结果: b={lsh.b} 个Bands, 每个 Band 行数 r={lsh.r}")
    print("-" * 50)

    # 2. 切片并注册文档
    doc_shingles = {}
    for doc_id, text in documents.items():
        shingles = extract_shingles(text, k=k)
        doc_shingles[doc_id] = shingles
        sig = minhash.compute_signature(shingles)
        lsh.insert(doc_id, sig)
        print(f"[{doc_id}] 文本长度: {len(text)} 字符, 提取 Shingle 数量: {len(shingles)}")

    print("-" * 50)
    print("=== 两两真实 Jaccard vs MinHash 估计值对照 ===")

    pairs = [
        ("doc_origin", "doc_shuffled_minor_edit"),
        ("doc_origin", "doc_partial_copy"),
        ("doc_origin", "doc_irrelevant")
    ]

    for id1, id2 in pairs:
        set1, set2 = doc_shingles[id1], doc_shingles[id2]
        real_jaccard = minhash.exact_jaccard(set1, set2)
        sig1 = lsh.signatures[id1]
        sig2 = lsh.signatures[id2]
        est_jaccard = minhash.estimate_jaccard(sig1, sig2)
        abs_err = abs(real_jaccard - est_jaccard)

        print(f"{id1} VS {id2}:")
        print(f"  真实 Jaccard: {real_jaccard:.4f} | MinHash 估算值: {est_jaccard:.4f} | 绝对误差: {abs_err:.4f}")

    print("-" * 50)
    print("=== LSH 分桶快速检索近似重复项 ===")
    query_id = "doc_origin"
    duplicates = lsh.query(query_id)
    print(f"以 [{query_id}] 为源文档进行近似查重,命中重复列表:")
    for dup_id, sim in duplicates:
        print(f"  -> 命中重复项: {dup_id}, 估计相似度: {sim}")

if __name__ == "__main__":
    run_demonstration()
示例运行输出与结果解读
执行上述测试脚本后,控制台输出如下:
=== MinHash 近似重复检测配置 ===
置换维度 m: 128, 字符切片 k: 3, 判定阈值: 0.5
LSH 自动优化结果: b=32 个Bands, 每个 Band 行数 r=4
--------------------------------------------------
[doc_origin] 文本长度: 77 字符, 提取 Shingle 数量: 75
[doc_shuffled_minor_edit] 文本长度: 77 字符, 提取 Shingle 数量: 75
[doc_partial_copy] 文本长度: 86 字符, 提取 Shingle 数量: 84
[doc_irrelevant] 文本长度: 74 字符, 提取 Shingle 数量: 72
--------------------------------------------------
=== 两两真实 Jaccard vs MinHash 估计值对照 ===
doc_origin VS doc_shuffled_minor_edit:
  真实 Jaccard: 0.6486 | MinHash 估算值: 0.6562 | 绝对误差: 0.0076
doc_origin VS doc_partial_copy:
  真实 Jaccard: 0.2823 | MinHash 估算值: 0.2969 | 绝对误差: 0.0146
doc_origin VS doc_irrelevant:
  真实 Jaccard: 0.0000 | MinHash 估算值: 0.0000 | 绝对误差: 0.0000
--------------------------------------------------
=== LSH 分桶快速检索近似重复项 ===
以 [doc_origin] 为源文档进行近似查重,命中重复列表:
  -> 命中重复项: doc_shuffled_minor_edit, 估计相似度: 0.6562
从实测数据可以观察到三个关键特性:
- 误差收敛极好:在
m=128维度下,洗稿文本的真实 Jaccard 为0.6486,估算值为0.6562,误差仅为0.0076,远低于理论单次标准差0.088。 - 对乱序和微调高度鲁棒:
doc_shuffled_minor_edit对原句进行了段落先后重排与字词微调,传统的编辑距离或单向字符串哈希会彻底失效,但 MinHash 准确抓取到了 65% 的核心字串重合。 - LSH 过滤精准快速:完全不相干的
doc_irrelevant甚至不会在任何一个哈希桶中与原文档相撞,完全免除了最终的比对开销,直接在桶分发阶段被彻底剔除。
八、工程落地注意事项与避坑清单
| 易踩坑点 | 潜在风险表现 | 生产级推荐应对措施 |
|---|---|---|
| Python 内置 hash() 随机化 | 默认开启 PYTHONHASHSEED,服务重启或跨机器分布式部署时哈希值不一致。 |
必须使用 hashlib.md5 或 murmurhash3 等确定性散列算法。 |
| 大质数溢出与循环截断 | Python 自带大数支持,但在 C 扩展或跨语言对接时 64 位乘法溢出导致签名错误。 | 选择略小于 2^32 或 2^64 的标准质数,规范模运算边界。 |
| 停用词与空白噪声 | 网页中包含大量的标点符号、无意义 HTML 标签或公共页脚导航文本,造成伪重复。 | 在 Shingling 前进行 HTML 标签清洗,剔除固定页脚模板,对纯标点做正则过滤。 |
| 超长文章计算过慢 | 数十万字长书逐字切片导致 Shingle 集合极大,内层循环耗时陡增。 | 可先做分段或分词,改用词级 k-shingle(如 2-gram 词),或先用快速长度过滤器过滤。 |
九、总结
MinHash 算法巧妙地利用随机哈希函数的极小值碰撞概率,建立了集合论中 Jaccard 相似度到紧凑整数签名间的无偏估计桥梁。其核心技术价值体现在三个层面:
- 存储压缩:将原本动辄数十 KB 且长短不一的文本集合,均匀压缩为数百字节的定长签名向量(例如 128 维仅需 512 字节)。
- 计算极速:仅需比较整数相等性,能够充分利用 CPU 的 SIMD 矢量指令进行加速。
- 横向扩展:天然无缝衔接局部敏感哈希(LSH)的分带分桶结构,使海量文本的近似去重能够在近线性时间 O(N) 内平稳完成。
在实际搭建爬虫去重、内容安全检测或版权溯源引擎时,先通过 MinHash + LSH 筛出候选对,再按需辅以高精度编辑距离或深度语义模型复核,是工业界久经考验的兼顾性能与准确度的高效架构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















