


怎么写出地道的Python代码:语法糖与Pythonic风格详解
深入解析地道Python代码的核心特质,从语法糖与底层数据模型协议出发,详解解包、推导式、上下文管理器、数据类等常用特性的正确用法与反模式重构。
一、什么是“Pythonic”:不仅是简短,更是直观与契约
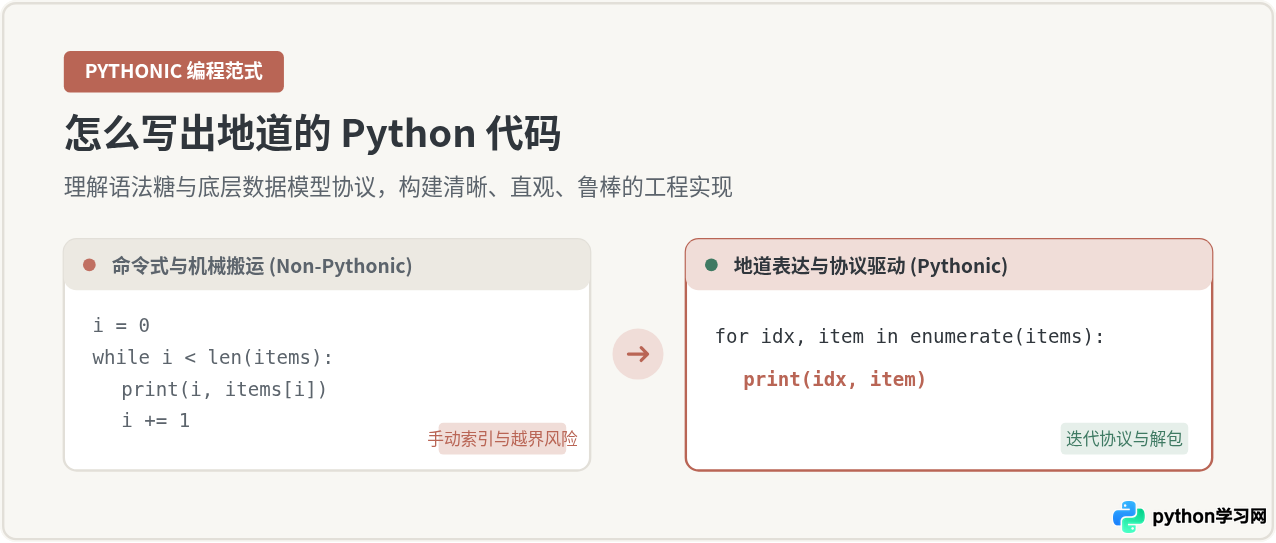
许多初学者常把“地道”误认为“炫技”或“把五行代码硬塞进一行”。在实际工程中,真正符合 Pythonic 风格的代码绝不鼓励晦涩的单行压缩,而是追求意图显式化与认知负担最小化。
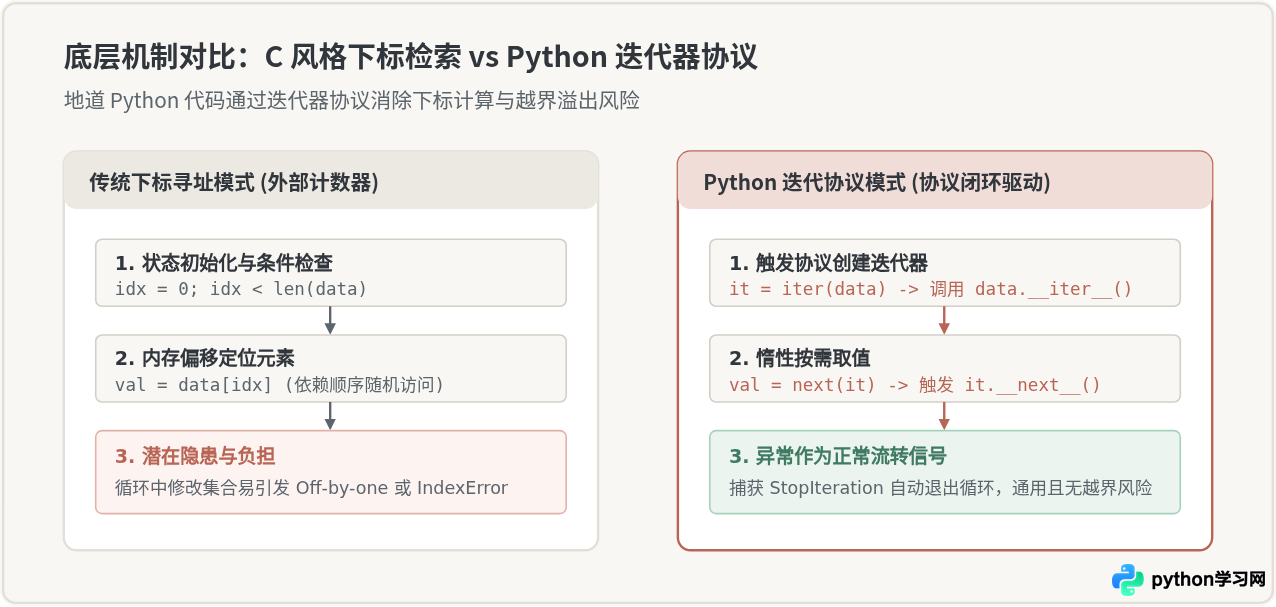
Python 内部拥有严密的“数据模型”(Data Model)规范。所谓“语法糖”,表面上是语言提供的简写形式,底层往往精确映射到一个或多个双下划线协议(Magic Methods / Dunder Methods)。例如:
for x in obj底层依赖对象的__iter__()或__getitem__()契约;with ctx:语法糖严格依托__enter__()与__exit__()构成的上下文协议;len(container)直接读取对象内部由 C 结构体或__len__()维护的确定字段,而非像其他语言那样遍历计算。
理解这种“语法糖与底层协议挂钩”的关系,是写出地道 Python 代码的思维分水岭。脱离底层协议去生搬硬套语法,容易写出脆弱且难以维护的伪优雅代码。
二、常用语法糖的重构实践与反模式
1. 结构化解包与星号扩展操作
解包是 Python 最强大的语法糖之一。它不仅能让变量交换免除中间变量,还能大幅精简从列表、元组或函数返回值中提取字段的样板代码。
# 繁琐且易数错索引
user_data = ["admin", "Tokyo", "2026-05", "Active"]
role = user_data[0]
city = user_data[1]
remaining_info = user_data[2:]

# 变量交换使用中间变量
temp = role
role = city
city = temp# 星号解包清晰分离首尾字段
user_data = ["admin", "Tokyo", "2026-05", "Active"]
role, city, *remaining_info = user_data
# 单行对称解包互换
role, city = city, role
在 Python 3.8+ 及 3.10+ 中,还可以利用合并运算符 | 替代冗长的字典更新:
base_config = {"host": "localhost", "port": 8080, "debug": False}
custom_config = {"port": 9000, "debug": True}

# 地道合并方式:生成全新字典且右侧覆盖左侧
active_config = base_config | custom_config
# 结果: {'host': 'localhost', 'port': 9000, 'debug': True}
2. 列表推导式、生成器表达式与适用边界
推导式(Comprehensions)以数学集合的声明方式重构了传统的累加循环。然而,很多开发者走向另一个极端:在推导式中嵌套三层循环与条件分支。这严重背离了 Pythonic 的初衷。
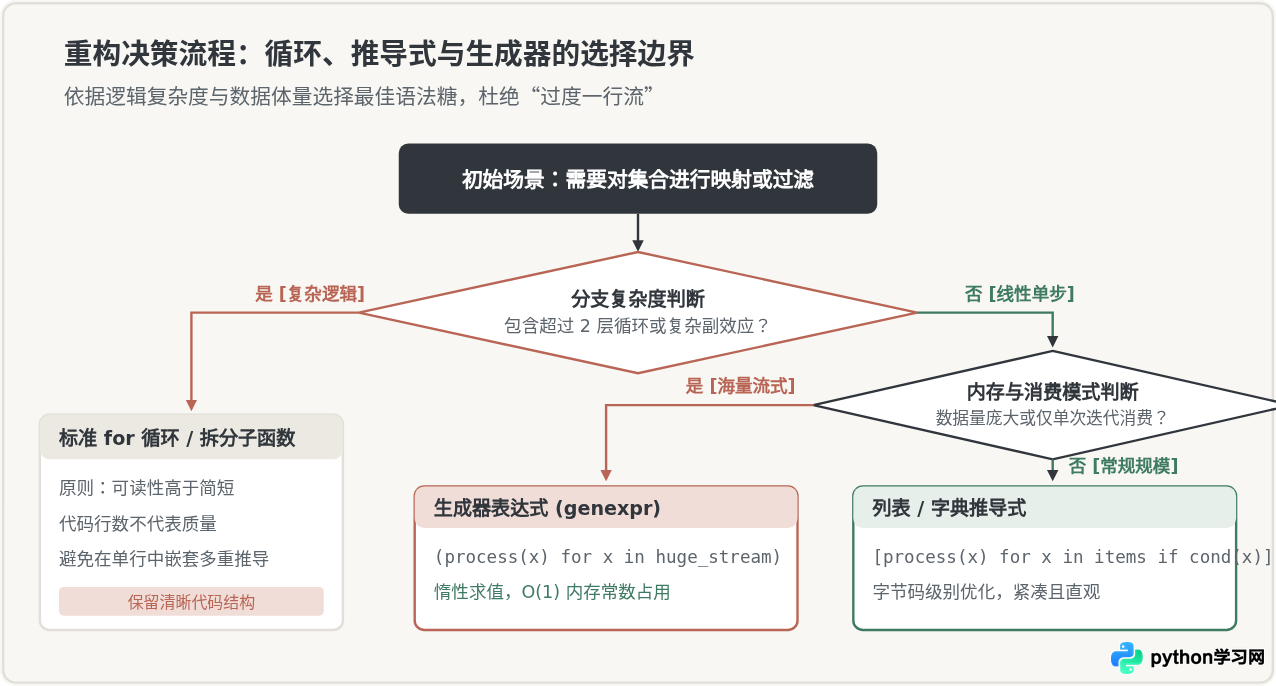
判断准则非常明确:
- 若仅需要一个紧凑的过滤与映射结果,优先使用列表推导式
[f(x) for x in s if cond(x)]; - 若数据规模未定(如读取千万行日志、读取数据库流),采用圆括号生成器表达式
(f(x) for x in s),实现惰性流式计算; - 若循环内部有明显的异常处理分支或状态变更操作,请使用标准
for循环,不要为了追求单行而强行嵌套。
三、核心机制:上下文管理器与装饰器的标准化封装
1. 资源安全守护:上下文协议
地道的 Python 代码几乎不出现手动的 file.close() 或 lock.release()。with 语句通过上下文管理协议,确保无论中间是否发生致命异常,收尾逻辑都必然被执行。
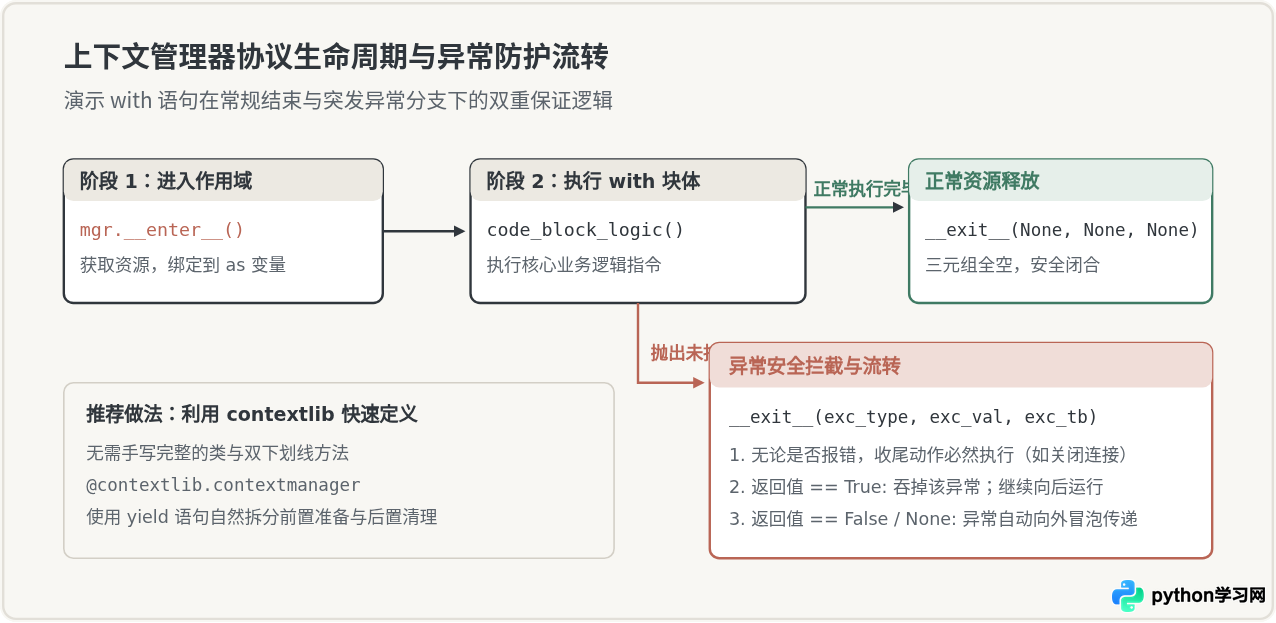
实现自定义上下文管理器时,若无需维护复杂类状态,使用标准库的 contextlib.contextmanager 是最精简地道的方式:
import time
from contextlib import contextmanager

@contextmanager
def timer_scope(task_name: str):
    start_time = time.perf_counter()
    try:
        # yield 前为 __enter__ 执行逻辑
        yield
    finally:
        # finally 保证收尾耗时统计必然执行,即 __exit__ 逻辑
        elapsed = time.perf_counter() - start_time
        print(f"[耗时统计] {task_name}: {elapsed:.4f} 秒")

# 实际调用:整洁无杂质
with timer_scope("批量解析日志"):
    # 业务操作...
    time.sleep(0.05)
2. 编写装饰器时切勿丢失函数元数据
装饰器在日志切面、鉴权、缓存等横切逻辑中极为常用。初学者写装饰器经常犯的低级错误是忘记使用 @functools.wraps,导致被装饰函数的名称、文档注释及签名被内部闭包覆盖,严重影响调试和自动化工具。
from functools import wraps

def validate_token(func):
    # 必须使用 wraps 保留原始函数的 __name__ 和 __doc__
    @wraps(func)
    def wrapper(*args, **kwargs):
        # 模拟前置鉴权检查
        return func(*args, **kwargs)
    return wrapper
四、现代 Python 特性注入:dataclass 与类型提示
在 Python 3.7+ 之后,编写纯粹作为数据容器的类时,仍手写 def __init__、__repr__ 和 __eq__ 属于典型的过时反模式。内置的 dataclasses.dataclass 能够通过装饰器语法糖自动生成这些常规样板:
from dataclasses import dataclass, field
from typing import List

@dataclass(frozen=True)  # frozen=True 自动赋予对象不可变性与 hash 能力
class EndpointMetric:
    path: str
    status_code: int
    latencies: List[float] = field(default_factory=list)

    @property
    def is_success(self) -> bool:
        return 200 <= self.status_code < 300
配合现代类型标注,代码在兼顾动态灵活性的同时,能获得 IDE 静态分析与静态类型检查(如 mypy / pyright)的即时保障。
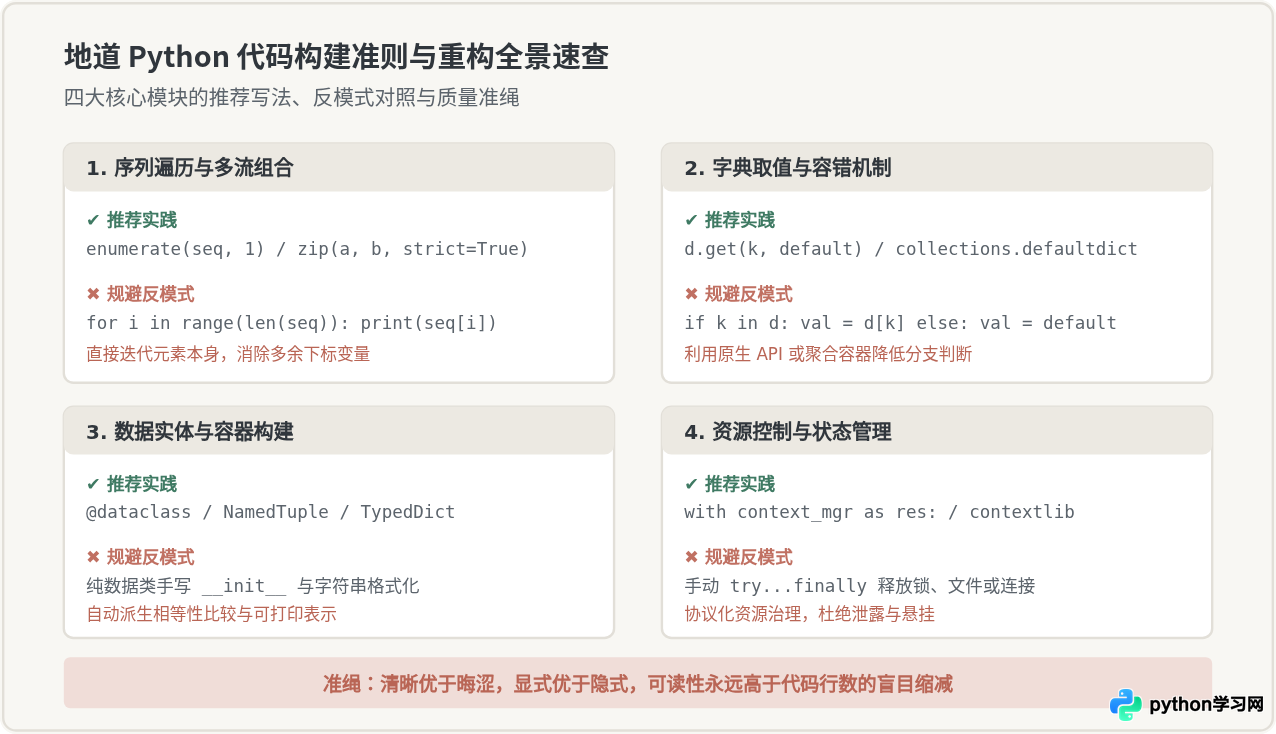
五、地道 Python 核心准则速查矩阵
为了帮助读者在日常开发中形成快速反射,下表系统总结了 Pythonic 核心规范、推荐语法糖与反模式警示:
六、总结与权衡边界
写出地道的 Python 代码,并不是要求我们在每一行都必须塞入高阶特性。真正的成熟风格往往表现出以下克制与自觉:
- 当性能瓶颈出现时,适度退让:生成器和推导式适合业务逻辑流转,但在大规模数值计算场景,直接调用成熟的底层向量化库(如 NumPy)或专用 C 扩展,远比写一段“自以为很 Pythonic”的推导式高效得多。
- 团队可维护性永远在个人偏好之上:如果一段语法糖需要团队其他成员查阅语言参考手册才能看懂,那么它就不是地道,而是多余的负担。
- 尊重习惯用法(Idioms):遵循社区长期积累的约定(如使用
is None代替== None判断单例对象,使用snake_case命名函数),这种一致性是代码可读性的基石。
将语言特有的语法糖建立在对底层协议契约的深刻理解之上,在适度与清晰中寻求平衡,才能持续写出兼具可读性与健壮性的优质 Python 工程代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















