


Python列表推导式与生成器表达式专项练习题
本篇针对Python列表推导式与生成器表达式提供由浅入深的专项练习题,包含基础清洗映射、双层嵌套展开、千万级数据内存对比及管道流式计算,配以完整的执行机制图解与避坑指南。
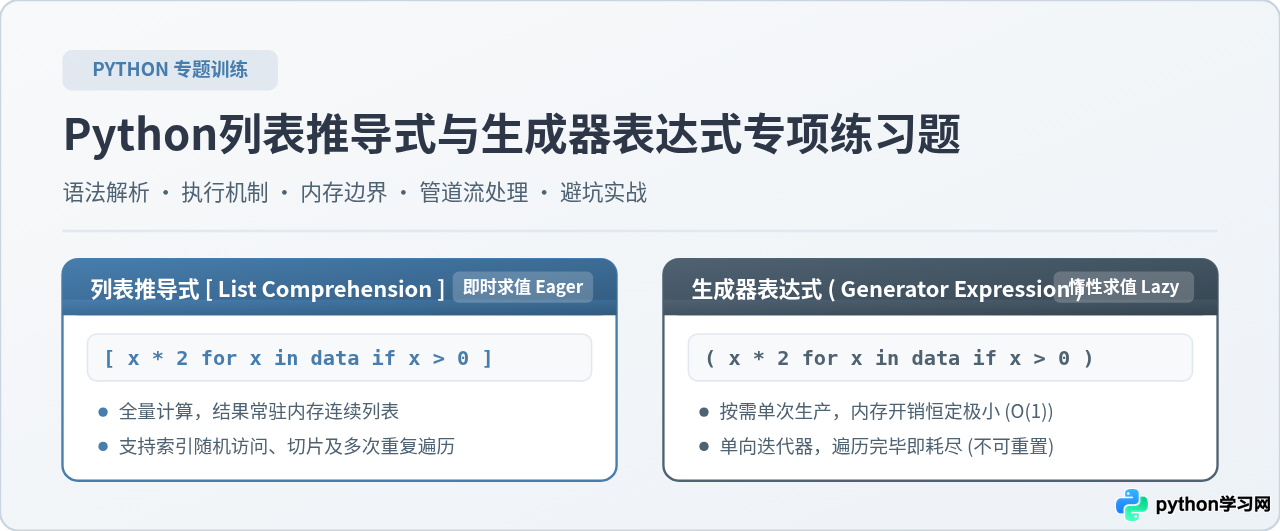
[] 与圆括号 (),但底层运算机制却有本质不同:列表推导式是一次性计算并分配完整内存的即时求值(Eager Evaluation),而生成器表达式则是按需产出、几乎零内存驻留的惰性求值(Lazy Evaluation)。本文通过 5 组由浅入深的专项练习题,从基础过滤映射、多层嵌套展开,到千万级数据内存压测与流式管道计算,带领读者逐一剖析两者的语法规则、性能边界与典型避坑细节。
一、核心机制回顾:即时计算 vs 惰性求值
在进入具体练习题之前,首先需要厘清两者的执行模型差异。列表推导式的核心使命是“快速构建一个装满计算结果的新列表”,而生成器表达式的核心使命是“构造一个按需生成数据的状态迭代器”。
从语法结构来看,两者均遵循由“输出表达式”、“迭代源”与“条件过滤”组成的三段论规则。其执行逻辑并非从左往右线性阅读,而是先定位循环源,再进行条件裁定,最后执行转换。
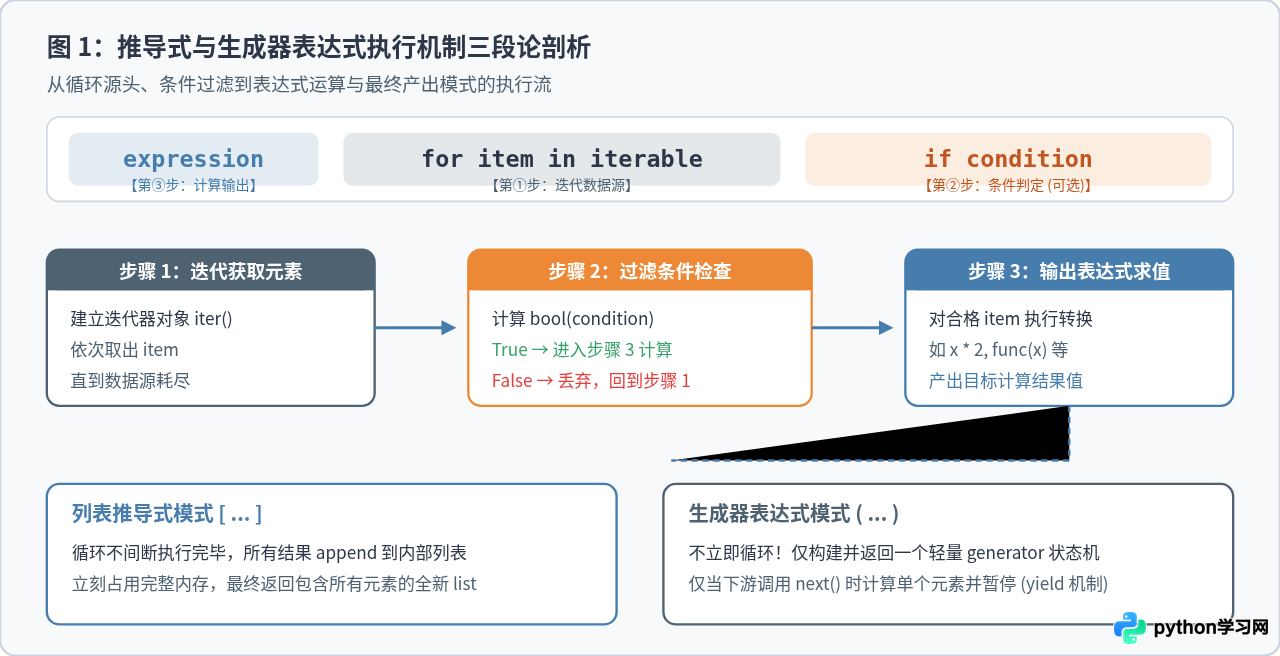
如图 1 所示,执行引擎首先调用 iter(iterable) 获取迭代器,每当取出一个元素后,立即交由 if condition 进行真值判定。若不满足条件,该元素直接被丢弃;若满足条件,才交给最左侧的 expression 计算目标值。两者的关键分水岭在于后续动作:列表推导式会持续循环直至迭代源耗尽,把全部计算值填入堆内存分配的连续列表中;生成器表达式则在得到首个计算值时立即将执行权挂起(Yield),等待外部调用者通过 next() 或循环主动请求下一个值。
二、专项练习一:基础数据清洗与格式规整
题目要求:现有包含杂乱用户输入数据的原始列表 raw_data = [" alice ", "", " ", "BOB", "chArlie", " david ", " "]。请编写单行推导式,剔除所有空字符串及仅由空格组成的无效项,去除首尾空白字符,并将有效用户名统一转换为首字母大写(Title Case)形式。随后给出对应的生成器表达式写法。
1. 解题代码与对比实现
初学者往往习惯先写传统的 for 循环配合 append(),随后再改写为推导式。以下分别呈现传统写法与推导式写法:
# 传统循环写法
raw_data = ["  alice ", "", "  ", "BOB", "chArlie", "  david  ", " "]
cleaned_list = []
for item in raw_data:
    stripped = item.strip()
    if stripped:  # 过滤掉 strip 后的空串
        cleaned_list.append(stripped.capitalize())

# 列表推导式单行解法
clean_list_comp = [item.strip().capitalize() for item in raw_data if item.strip()]

# 生成器表达式解法
clean_gen_expr = (item.strip().capitalize() for item in raw_data if item.strip())2. 深度解析与优化提醒
在上述推导式 [item.strip().capitalize() for item in raw_data if item.strip()] 中,item.strip() 被调用了两次:一次在 if 判定中,另一次在输出表达式中。当清洗逻辑计算成本较高(例如复杂的正则表达式匹配)时,重复计算会导致性能损耗。
在 Python 3.8+ 中,可以利用海象运算符
:= 在条件过滤子句中缓存清洗后的局部变量,避免重复执行:[s.capitalize() for item in raw_data if (s := item.strip())]。
三、专项练习二:字典与集合的派生推导
题目要求:给定一组包含交易信息的字典元组:
records = [{"user": "U101", "amount": 150, "status": "success"}, {"user": "U102", "amount": 0, "status": "failed"}, {"user": "U101", "amount": 320, "status": "success"}, {"user": "U103", "amount": 210, "status": "success"}]。
请完成两个任务:
1. 使用集合推导式提取所有成功交易的唯一样本用户 ID。
2. 使用字典推导式构建一个以 user_id 为键,成功交易总额为值的字典。
1. 解题代码实现
records = [
    {"user": "U101", "amount": 150, "status": "success"},
    {"user": "U102", "amount": 0, "status": "failed"},
    {"user": "U101", "amount": 320, "status": "success"},
    {"user": "U103", "amount": 210, "status": "success"}
]

# 任务 1:集合推导式(天然去重)
valid_users = {r["user"] for r in records if r["status"] == "success"}

# 任务 2:结合生成器与字典推导式进行分组汇总
user_totals = {
    user: sum(r["amount"] for r in records if r["user"] == user and r["status"] == "success")
    for user in valid_users
}2. 核心考点与注意事项
集合推导式使用花括号 {expr for item in iterable},它与列表推导式的唯一区别在于底层哈希去重;字典推导式则使用键值对语法 {key: value for item in iterable}。
切忌在推导式内部调用修改外部变量、记录日志或发出网络请求的函数(例如
[send_request(x) for x in urls])。推导式的本质是“纯数据转换与构造”,如果为了单行缩减代码而忽视副作用,会导致代码极难调试并破坏可读性。
四、专项练习三:多层嵌套与矩阵扁平化
题目要求:给定一个表示坐标网格或嵌套矩阵的二维列表:
matrix = [[1, -2, 3], [-4, 5, 0], [7, -8, 9]]。
请编写单行列表推导式,将该二维矩阵展平为一维列表,并仅保留其中的正整数,将其放大 2 倍。请准确安排多层 for 与 if 的前后次序。
1. 解题代码与语法映射
很多开发者在书写双层嵌套推导式时容易混淆外层与内层的排列顺序。牢记黄金法则:推导式中多个 for 子句的从左至右顺序,完全对应传统多层缩进循环的从外至内顺序。
matrix = [
    [1, -2, 3],
    [-4, 5, 0],
    [7, -8, 9]
]

# 单行双层嵌套列表推导式
flat_positive_doubled = [
    val * 2
    for row in matrix       # 外层循环:遍历每一行
    for val in row          # 内层循环:遍历行内的每个元素
    if val > 0              # 条件过滤:仅保留正整数
]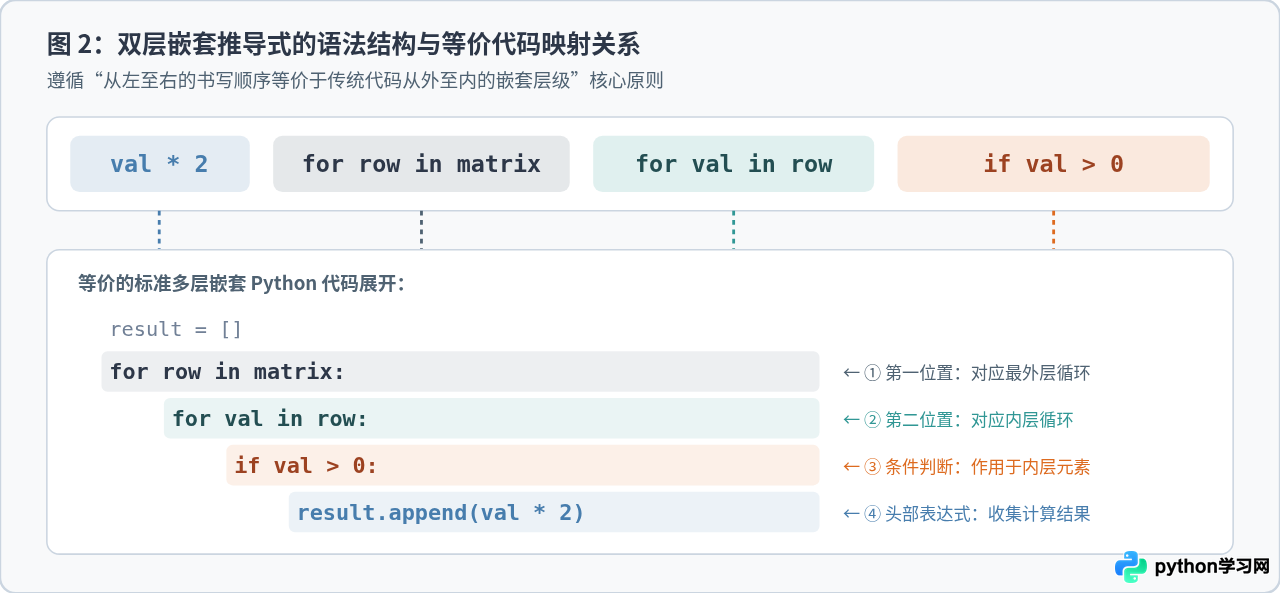
如图 2 所示,如果将 for val in row 写在 for row in matrix 前面,Python 解释器在编译该语法树时会直接抛出 NameError: name 'row' is not defined。因为左侧的子循环依赖右侧更外层循环所定义的变量。
五、专项练习四:大数据量内存压测与流式解析
题目要求:假定需要处理包含 10,000,000(一千万)个整数的序列,计算其中所有偶数的平方和。请分别使用“列表推导式配合 sum”和“生成器表达式配合 sum”两种方案,借助 sys.getsizeof() 观测对象本身的内存开销,并解释为何生成器能够避免内存耗尽(OOM)。
1. 实验代码与测试指标
import sys

# 设定数据规模:1000 万
N = 10_000_000

# 1. 列表推导式方案(注意:为了展示内存分配,我们生成前 100 万项作为代表)
sample_list = [x**2 for x in range(1_000_000) if x % 2 == 0]
list_mem = sys.getsizeof(sample_list)

# 2. 生成器表达式方案(直接处理全量 1000 万项)
sample_gen = (x**2 for x in range(N) if x % 2 == 0)
gen_mem = sys.getsizeof(sample_gen)

print(f"50万个元素的列表对象内存占用: {{list_mem / 1024 / 1024:.2f}} MB")
print(f"1000万级生成器对象内存占用: {{gen_mem}} 字节")

# 3. 流式聚合计算(直接在 sum 内传入生成器表达式,可省略外层括号)
total_sum = sum(x**2 for x in range(N) if x % 2 == 0)
print(f"最终计算和值: {{total_sum}}")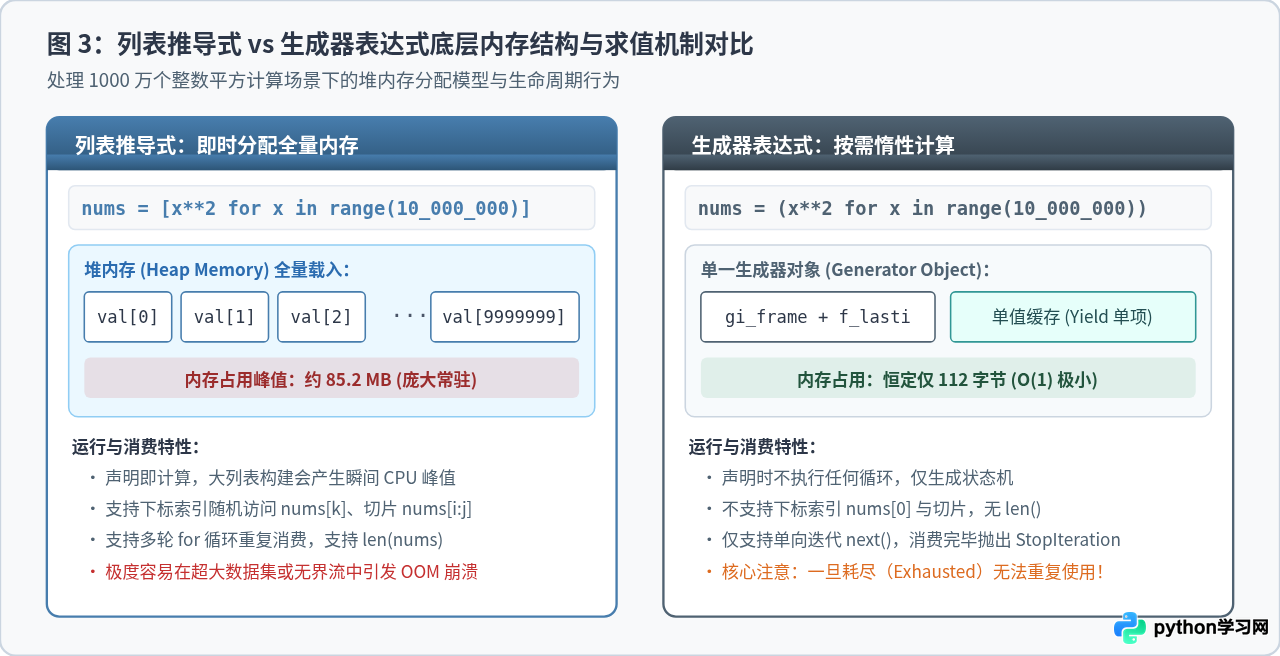
2. 底层运行原理深度解析
如图 3 所示,列表推导式在执行时必须一次性在进程堆内存中为所有结果分配连续的指针数组。如果直接对 1000 万个整数使用列表推导式,仅列表本身的数组结构就需要消耗约 85 MB 内存,再加上每个整数对象(约 28 字节)的引用,瞬时内存消耗将逼近数百兆甚至数吉字节。
反观生成器表达式,它创建的仅仅是一个带有代码指针(gi_code)和执行帧(gi_frame)的迭代器控制块。无论上游迭代源是 100 项还是 10 亿项,生成器对象本身的尺寸始终恒定为 112 字节左右。下游的 sum() 函数每调用一次内置的 next(),生成器才计算并产出一个数字,随后该数字被累加并从内存中释放。这种 O(1) 的空间复杂度是处理超大文件、日志流和数据库游标的唯一可行范式。
六、专项练习五:管道式数据流处理(Pipeline)
题目要求:模拟一段 Web 访问日志流文本,每一行为格式如 "IP [STATUS] LATENCY_MS URL" 的记录。
请利用多个生成器表达式串联构建一条流式处理管道:
第 1 阶段:提取每一行文本并去除空白行;
第 2 阶段:解析并过滤出状态码为 200 的成功请求;
第 3 阶段:提取响应耗时浮点数;
第 4 阶段:计算这些请求的平均响应耗时与最大耗时。要求全程无任何中间列表产生。
1. 管道流水线代码实现
log_lines = [
    "192.168.1.10 [200] 35.4 /api/v1/user",
    "192.168.1.11 [404] 12.1 /api/v1/unknown",
    "",
    "   ",
    "192.168.1.12 [200] 105.8 /api/v1/order",
    "192.168.1.13 [500] 240.2 /api/v1/pay",
    "192.168.1.14 [200] 48.6 /api/v1/goods"
]

# 阶段 1:去除首尾空格并剔除空白行
clean_lines = (line.strip() for line in log_lines if line.strip())

# 阶段 2:拆分字段并过滤 HTTP 200 响应
success_records = (
    parts for line in clean_lines
    if len(parts := line.split()) >= 4 and parts[1] == "[200]"
)

# 阶段 3:提取耗时数值(转换为 float)
latencies = (float(parts[2]) for parts in success_records)

# 阶段 4:流式聚合计算(将耗时转换为列表仅用于同时计算均值与最大值)
latency_list = list(latencies)
if latency_list:
    avg_latency = sum(latency_list) / len(latency_list)
    max_latency = max(latency_list)
print(f"成功请求数: {{len(latency_list)}}, 平均耗时: {{avg_latency:.2f}}ms, 最大耗时: {{max_latency:.2f}}ms")通过生成器链式串联,各个计算阶段像水流经过滤网一样依次发生,前一阶段产出的元素立刻进入后一阶段消费,各阶段之间不需要将中间结果落盘或缓冲到大列表中,这正是 Unix 哲学在 Python 编程中的典型实践。
七、高频陷阱排查与避坑指南
在实际工程开发中,开发者在享受推导式与生成器便捷性的同时,常常踩入以下三类典型误区:
1. 陷阱一:生成器耗尽(Exhaustion)导致的“幽灵空集”
生成器表达式是一次性的单向迭代器。一旦被完全遍历(例如执行了 for、list() 或 sum()),生成器内部游标便到达末尾,再次对其遍历将不会产出任何数据,且不会引发任何异常。
gen = (x * 2 for x in [1, 2, 3])
print(sum(gen))   # 输出 12(正确消费)
print(max(gen)) # 抛出 ValueError: max() arg is an empty sequence!因为 gen 已被耗尽data = list(gen)。
2. 陷阱二:闭包延迟绑定(Late Binding)问题
在推导式或生成器内部定义匿名函数(lambda)时,变量的查找是在函数被调用时发生,而非函数定义时。这会导致所有 lambda 函数共享同一个循环变量的最终值。
# 错误示例:闭包延迟绑定
funcs = [lambda: i for i in range(3)]
print([f() for f in funcs])  # 输出 [2, 2, 2],而非预期的 [0, 1, 2]!

# 修复方案:利用参数默认值进行早期即时绑定
fixed_funcs = [lambda i=i: i for i in range(3)]
print([f() for f in fixed_funcs])  # 正确输出 [0, 1, 2]
3. 陷阱三:过度嵌套导致的可读性灾难
推导式设计初衷是为了表达简单直观的过滤与映射。一旦推导式包含两层以上的循环,或者 if-else 条件分支超过 2 个,推导式单行代码就会极其臃肿晦涩。代码不仅应当被机器执行,更重要的是应当被人类读者阅读。当发现推导式长度超过 80 字符或嵌套层次加深时,应当果断退回为传统的 for 循环,或封装为标准的生成器函数(使用 def 和 yield)。
八、技术选型决策与全景总结
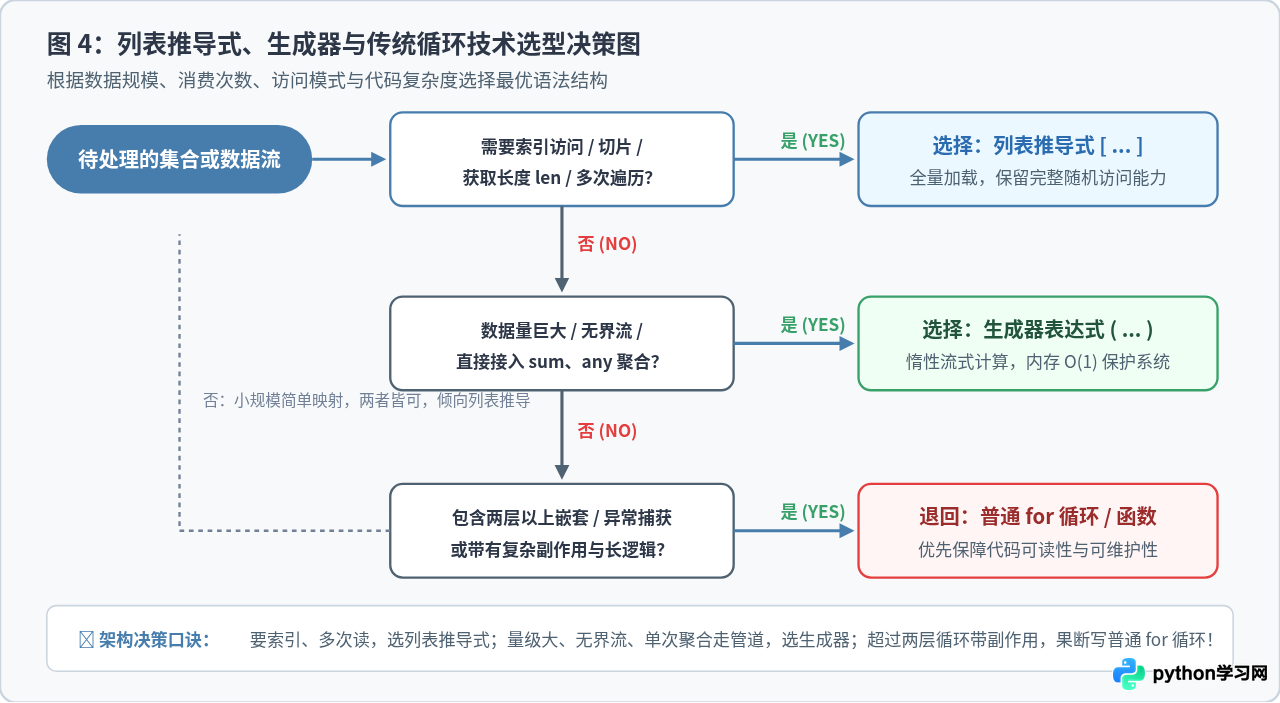
为了帮助读者在日常开发中准确做出技术决策,下方的决策流程图与特性对照表系统总结了两者的选型判断标准:
| 对比维度 | 列表推导式 (List Comprehension) | 生成器表达式 (Generator Expression) | 标准 for 循环 / yield 函数 |
|---|---|---|---|
| 语法标识 | 中括号 [expr for x in seq] |
小括号 (expr for x in seq) |
多行缩进结构块 / yield 语句 |
| 求值时机 | 即时求值(声明时立即执行全量计算) | 惰性求值(调用 next() 时按需计算) |
按语句顺序即时或流式执行 |
| 内存开销 | \(O(N)\)(随数据量线性增长,全量驻留) | \(O(1)\)(恒定小对象,单值流动) | 视数据存储逻辑决定 |
| 访问模式 | 支持下标索引、切片、重排、多次遍历 | 仅支持单向迭代,一次性消费(耗尽不可逆) | 高度自由灵活 |
| 首选适用场景 | 中小规模数据清洗、必须保留完整列表以备后续多处使用的场景 | 海量数据聚合(sum/max/any)、无限数据流、多阶段管道计算 | 嵌套超过 2 层、包含异常处理或长分支副作用的复杂业务逻辑 |
掌握列表推导式与生成器表达式,不仅是掌握一种简洁优雅的语法糖,更是建立“内存敏感度”与“流式思维”的重要标志。在实际项目中,根据数据的生命周期和内存约束灵活选型,才能写出兼具可读性与高吞吐性能的高质量 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















