


Python常用实用代码片段:文件批量重命名与Excel读取
针对日常办公与数据清洗中的高频需求,提供基于Python的高鲁棒性代码范式:涵盖基于pathlib的文件批量重命名、前缀序号格式化、重名碰撞检测,以及基于pandas和openpyxl的Excel表格读取、类型精度锁死与超大文件流式处理。
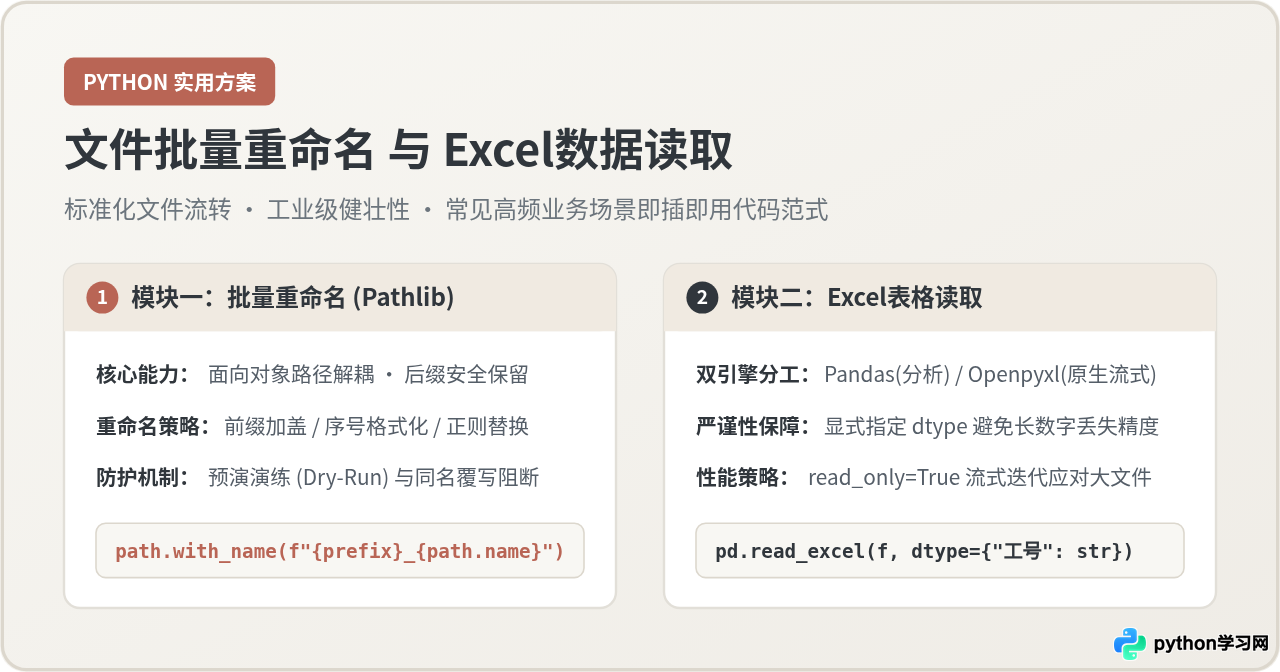
pathlib 与成熟生态库 pandas、openpyxl,提供可直接复用的工业级代码模板,并深入剖析路径解构、同名碰撞拦截、长文本长数字精度保留以及大文件流式加载等边界条件。
第一部分:文件批量重命名的工业级方案
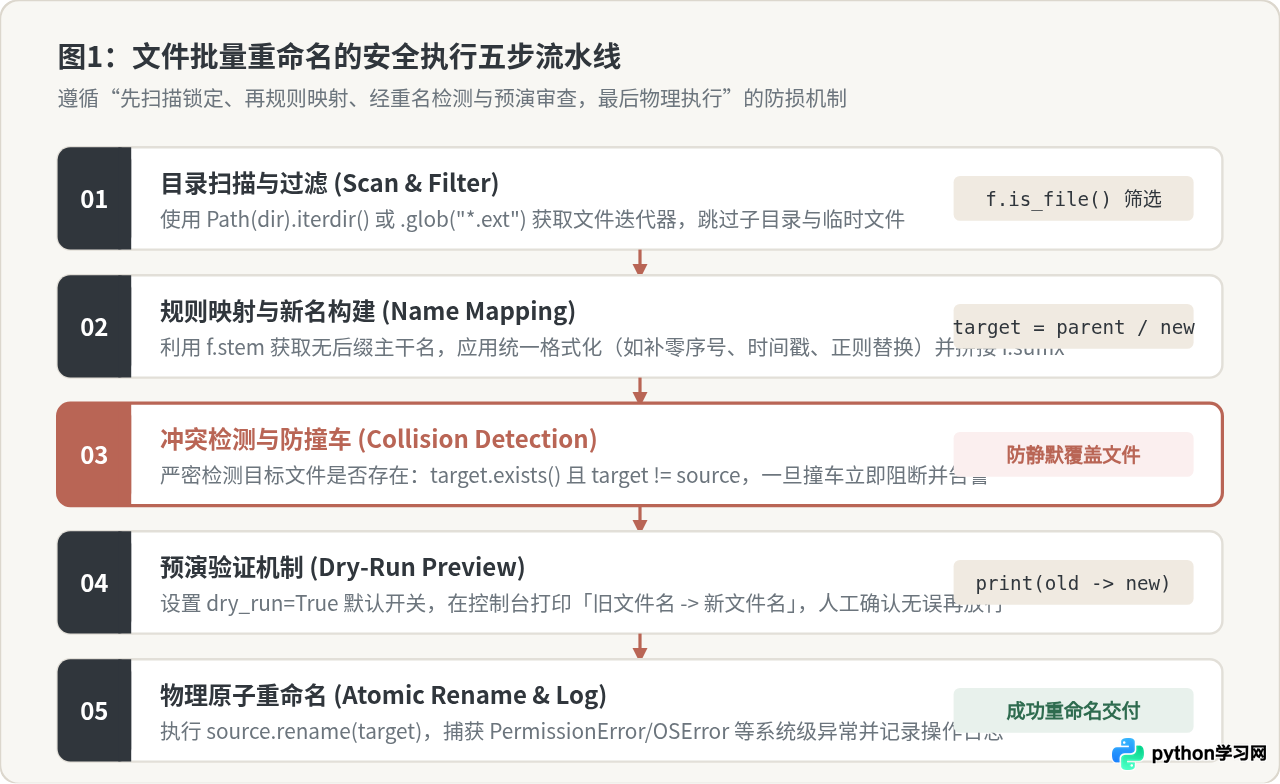
文件批量重命名的常见诉求包括:统一前缀与序号格式化、按规则清洗特殊字符、根据正则提取特定字段重组文件名等。传统脚本常因缺乏校验机制,在遇到文件名冲突、跨平台路径分隔符或特殊字符时静默覆写,导致不可逆的数据损毁。
1. 为什么优先使用 pathlib 而非 os.path?
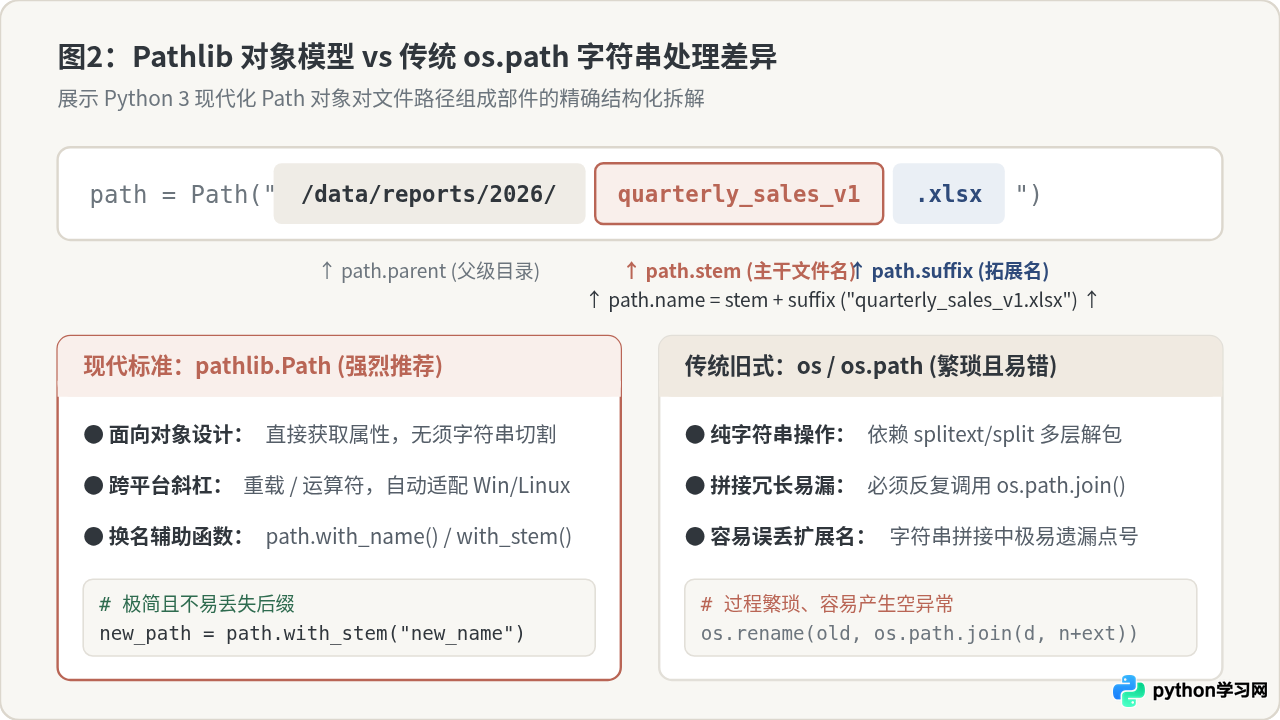
在 Python 3.4 之后引入的 pathlib.Path 采用了面向对象的路径抽象。与传统 os.path 依靠纯字符串操作相比,Path 对象清晰地解耦了文件的父级目录(parent)、文件名主干(stem)与扩展名(suffix),能从根本上消除字符串切分时漏掉点号或破坏原有扩展名的隐患。
2. 实战场景 A:批量补零编号与时间戳加盖
当处理扫描件或导出的销售凭证时,经常需要统一更名为形如 202611_Report_001.pdf 的标准化格式。必须先使用 list() 固化文件遍历列表,防止在原目录边遍历边更名造成迭代游标错乱或死循环。
# 场景一:批量格式化编号并添加前缀
from pathlib import Path
from typing import List, Tuple

def batch_rename_sequential(
    target_dir: str,
    extension: str,
    prefix: str,
    digits: int = 3,
    dry_run: bool = True
) -> List[Tuple[Path, Path]]:
    """
    对指定目录下的特定格式文件按顺序编号重命名。
    :param target_dir: 目标文件夹路径
    :param extension: 目标扩展名(如 '.pdf' 或 'pdf')
    :param prefix: 新文件名前缀
    :param digits: 序号补零位数,如 3 表示 001, 002
    :param dry_run: 演练模式。为 True 时仅打印映射关系,不修改实际文件
    :return: [(原路径, 新路径)] 的映射清单
    """
    dir_path = Path(target_dir)
    if not dir_path.is_dir():
        raise FileNotFoundError(f"目录不存在: {dir_path}")

    # 规范化扩展名格式
    ext = extension if extension.startswith('.') else f".{extension}"

    # 关键点 1:必须使用 list() 固化迭代器,避免更名后影响原目录遍历顺序
    files = sorted([f for f in dir_path.iterdir() if f.is_file() and f.suffix.lower() == ext.lower()])

    plan: List[Tuple[Path, Path]] = []

    for idx, file_path in enumerate(files, start=1):
        # 生成形如 Prefix_001.pdf 的新名称
        new_filename = f"{prefix}_{idx:0{digits}d}{file_path.suffix}"
        new_path = file_path.with_name(new_filename)
        plan.append((file_path, new_path))

    # 关键点 2:冲突拦截检查(防止原先就存在同名文件,导致物理覆写)
    planned_destinations = set()
    for old_p, new_p in plan:
        if new_p.exists() and new_p != old_p:
            raise FileExistsError(f"重名冲突警告: 目标文件 {new_p.name} 已存在,更名操作已终止!")
        if new_p in planned_destinations:
            raise ValueError(f"命名规划冲突: 多个文件映射到了相同的目标文件名 {new_p.name}")
        planned_destinations.add(new_p)

    # 关键点 3:Dry-Run 演练审查
    if dry_run:
        print(f"--- [DRY-RUN 演练模式] 共扫描到 {len(plan)} 个文件 ---")
        for old_p, new_p in plan:
            print(f"[预演] {old_p.name}  ->  {new_p.name}")
        print("--- 演练结束:实际文件未发生任何修改。确认无误后设置 dry_run=False 执行物理重命名 ---")
        return plan

    # 关键点 4:正式物理原子重命名
    for old_p, new_p in plan:
        if old_p != new_p:
            old_p.rename(new_path)
            print(f"[已重命名] {old_p.name} -> {new_p.name}")

    return plan
A.jpg 改为 B.jpg,同时把 B.jpg 改为 A.jpg)或进行序号重排(如 1.jpg->2.jpg, 2.jpg->3.jpg)时,直接线性顺序重命名会立即触发已存在冲突。此时必须引入带有随机 UUID 或临时前缀的中间态过渡(如 file.with_name(f"__temp_{uuid}_{file.name}")),分两阶段完成重命名。
第二部分:Excel 数据的工业级读取范式
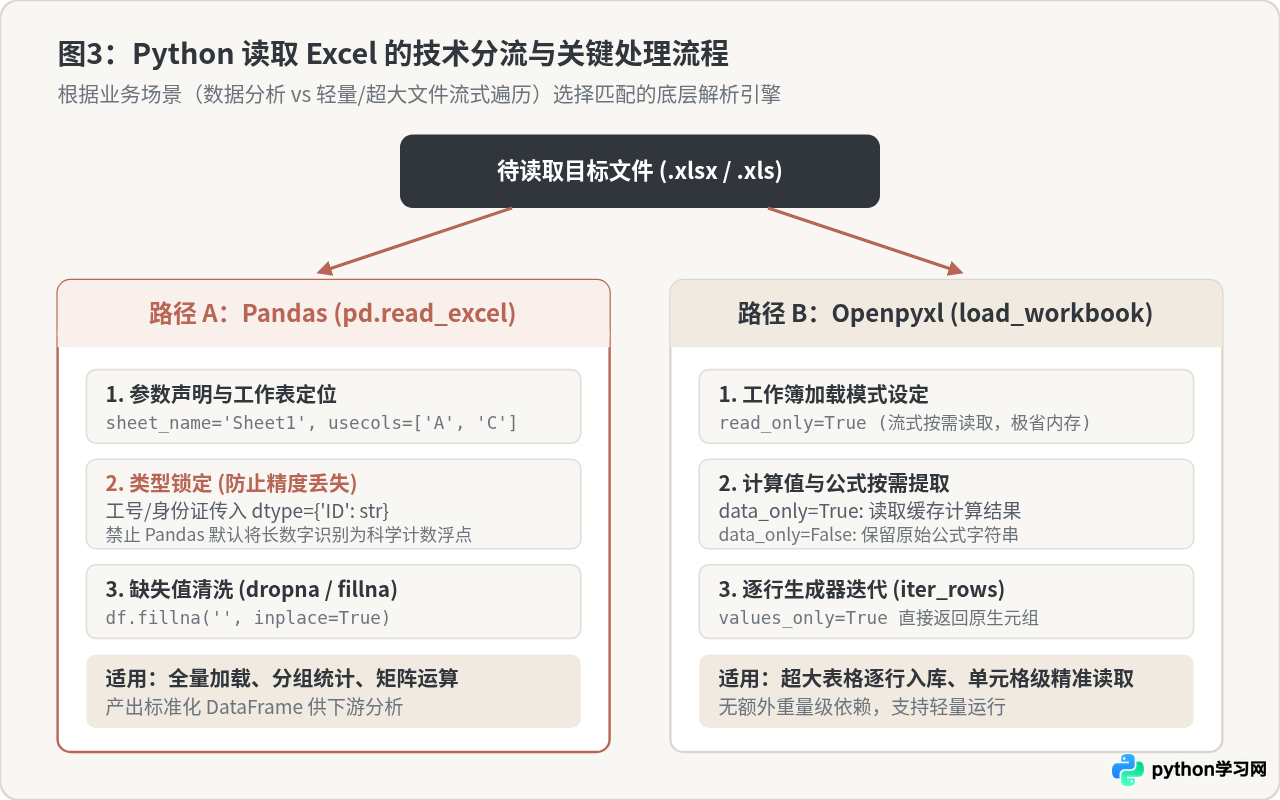
Python 读取 Excel 表格时,最容易出现两类故障:一是数据类型静默失真(如身份证号、工号、电话号码被转换为浮点数并以科学计数法展示,末位精度被抹去);二是超大文件内存溢出(加载数十万行含复杂格式的表格直接导致系统 OOM)。
1. 方案一:基于 Pandas 的快速表格提取与类型锁死
在数据科学与常规业务分析场景中,pandas.read_excel 是首选工具。为了规避纯数值字符串被强制转为浮点数,必须使用 dtype 参数强制指定列的数据类型,同时指定 parse_dates 确保时间列按日期时间对象解析。
# 场景二:使用 Pandas 读取 Excel 并锁死数据类型
import pandas as pd
from pathlib import Path

def read_excel_safely(file_path: str, sheet_name: str = 0) -> pd.DataFrame:
    path = Path(file_path)
    if not path.exists():
        raise FileNotFoundError(f"Excel 文件未找到: {path}")

    # 关键点 1:通过 dtype 明确声明长编码字段为字符串,杜绝科学计数法丢失末位
    type_spec = {
        "员工工号": str,
        "身份证号": str,
        "订单编号": str,
        "邮编": str
    }

    # 关键点 2:指定引擎与需要解析的日期时间列
    df = pd.read_excel(
        path,
        sheet_name=sheet_name,
        dtype=type_spec,
        parse_dates=["入职日期", "操作时间"],  # 自动解析为 datetime64[ns]
        engine="openpyxl",                  # 显式声明解析 .xlsx 的后端引擎
        na_values=["N/A", "NULL", "-"]       # 统一将特定占位符标记为缺失值 NaN
    )

    # 关键点 3:规范化列名,剔除可能误输入的首尾不可见空格
    df.columns = [str(col).strip() for col in df.columns]

    return df

# 示例调用说明(示例输出:不会把 00123 读成 123,也不会把 110101199003072345 转换为 1.10101e+17)
2. 方案二:基于 Openpyxl 的流式读取与超大文件优化
当 Excel 记录超过数万行、文件大小达到数十兆甚至上百兆时,Pandas 会尝试将所有样式、格式与元数据全量载入内存,引发明显的系统卡顿。此时应使用底层库 openpyxl 的 read_only=True 流式模式,它通过逐行生成器返回单元格数据,内存占用恒定在几兆级别。
# 场景三:基于 Openpyxl 流式读取巨型 Excel 表格
from openpyxl import load_workbook
from typing import Generator, Dict, Any, List

def stream_large_excel(
    file_path: str,
    sheet_name: str = None,
    data_only: bool = True
) -> Generator[Dict[str, Any], None, None]:
    """
    流式读取大体积 Excel 文件,逐行产出字典数据,内存开销恒定。
    :param file_path: 文件路径
    :param sheet_name: 工作表名,默认取第一个工作表
    :param data_only: 为 True 时返回公式的计算缓存值,为 False 时返回公式字符串
    """
    # 关键点 1:read_only=True 启用按需惰性解析流,关闭样式与格式加载
    wb = load_workbook(filename=file_path, read_only=True, data_only=data_only)

    ws = wb[sheet_name] if sheet_name else wb.active

    # 关键点 2:使用 iter_rows(values_only=True) 直接获取行原生值元组
    row_iterator = ws.iter_rows(values_only=True)

    try:
        headers = next(row_iterator)  # 提取首行表头
    except StopIteration:
        wb.close()
        return

    # 清理表头中的空白与空列
    clean_headers = [str(h).strip() if h is not None else f"col_{i}" for i, h in enumerate(headers)]

    for row in row_iterator:
        # 过滤完全为空的无效行
        if all(cell is None for cell in row):
            continue
        # 组装为字典产出
        record = dict(zip(clean_headers, row))
        yield record

    # 关键点 3:只读工作簿使用完毕后必须显式关闭以释放文件句柄
    wb.close()
=SUM(A1:A10))在 Python 脚本中本身不具备计算引擎。参数 data_only=True 读取的是上次在 Microsoft Excel 或 WPS 中保存文件时缓存的计算结果。如果该文件是由其他自动化程序生成且从未在办公软件中打开保存过,读取到的结果将为 None。
第三部分:场景选型对照与避坑总结
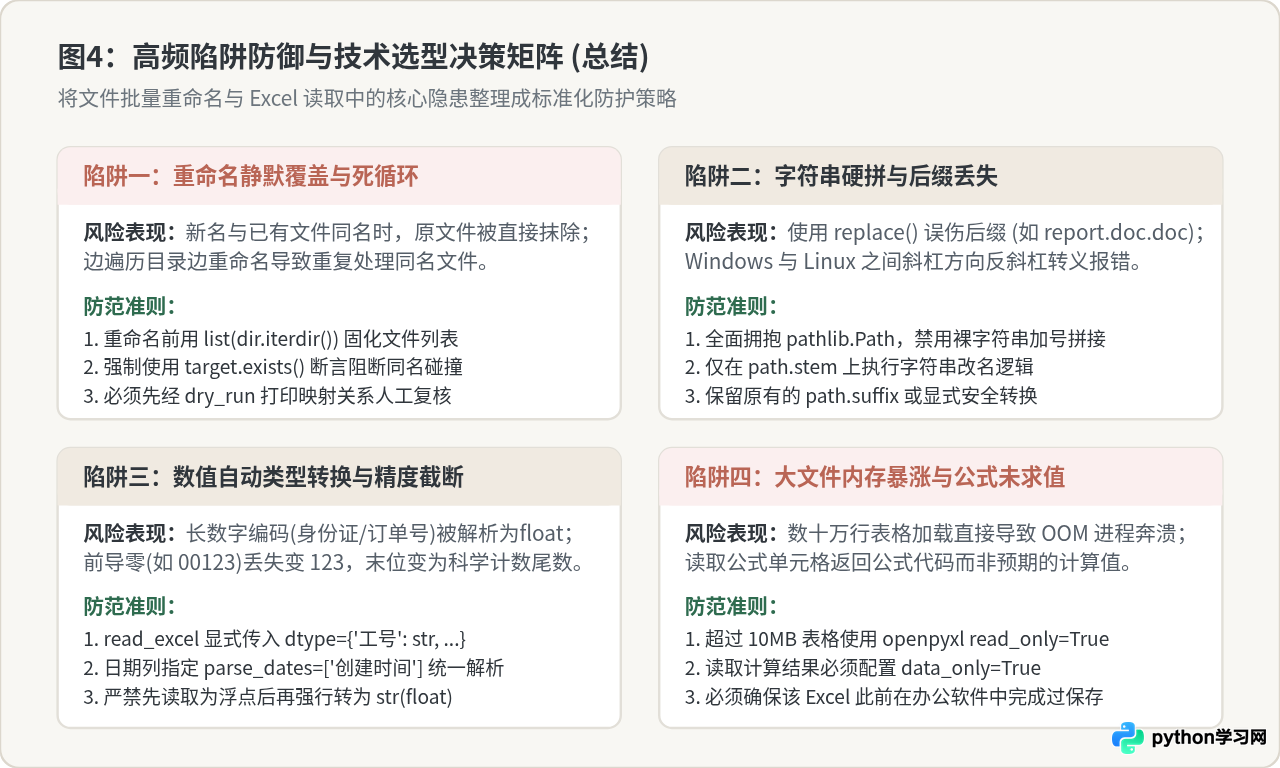
在构建数据流转与自动化批处理管道时,应结合数据规模、操作目的和依赖成本来权衡选型。下表与图4汇总了关键技术选型依据与高频陷阱的排查路径。
| 业务任务 | 推荐方案 | 核心参数 / 方法 | 关键防御点 |
|---|---|---|---|
| 跨目录 / 多扩展名批量重命名 | pathlib.Path |
path.with_stem(), path.rename() |
先使用 list() 固化迭代集;强制执行 target.exists() 冲突阻断;先演练(Dry-Run)后执行。 |
| 常规报表读取与多维分析 | pandas |
pd.read_excel(..., dtype={...}) |
必须对数字编码类字段显式声明 dtype=str,防止首位 0 丢失与尾数精度被浮点截断。 |
| 超大表格逐行流式提取或入库 | openpyxl |
load_workbook(read_only=True) |
使用生成器逐行处理,保持恒定极低内存占用;处理完成后必须显式执行 wb.close()。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















