


Python办公自动化案例:批量处理Excel数据与文件重命名
针对日常办公中多部门Excel报表分散、数据结构混乱及附件命名不规范等痛点,本文以完整的工程案例讲解如何利用Python的pandas与pathlib库实现多表格自动汇总与附件文件的安全批量重命名。
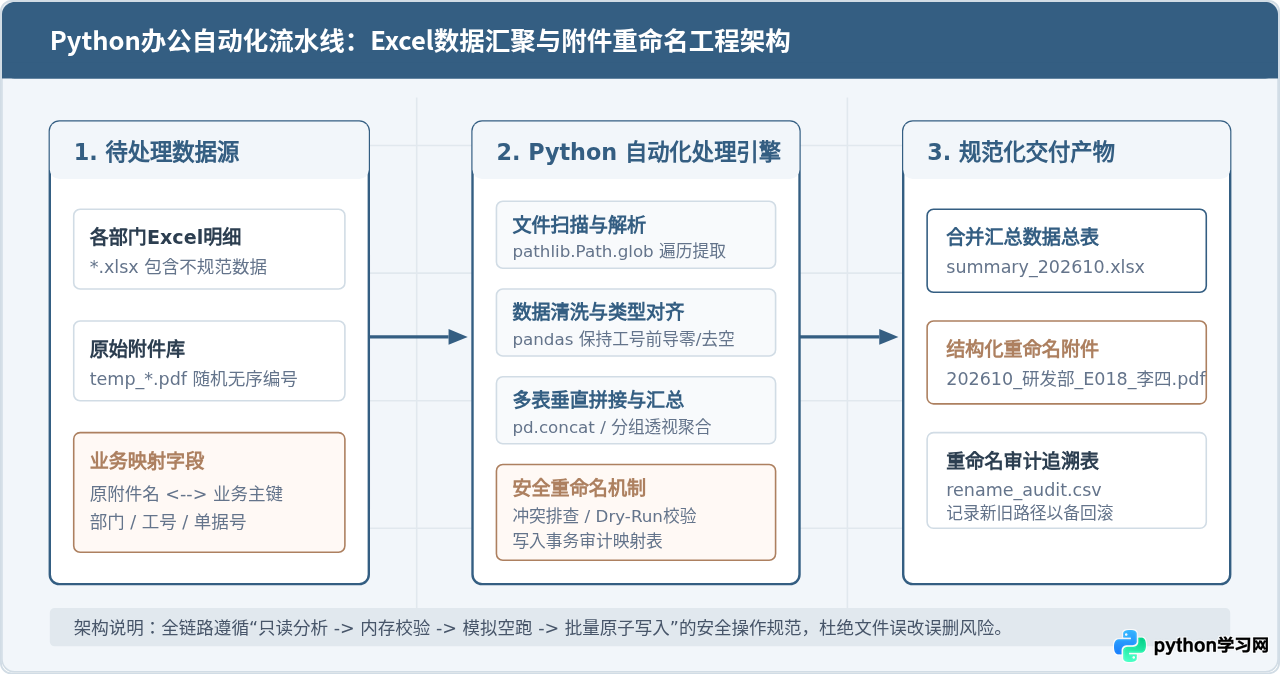
在企业日常管理与协同办公场景中,多部门分散提交的业务明细表往往格式相近但数据散落,与之伴随的扫描件、发票或报销单等附件文件,其初始命名也常处于混乱无序状态。手动逐一打开表格复制粘贴、重命名几十上百个附件,不仅耗费工时,还极易发生数据遗漏与同名覆盖灾难。本文以实际综合业务为例,直接讲解如何使用 Python 的 pandas 与 pathlib 库,实现多张 Excel 表格的数据自动读取、清洗与汇总,并基于整理后的结构化字段完成关联附件文件的批量安全重命名。
一、业务场景与工作流规划
假设企业总部需要汇总各分支机构提交的月度差旅费用表。每个分支机构提交了一份名为 费用报销_部门名_202610.xlsx 的工作簿,同时在附件目录中存有对应人员的凭证扫描件,初始文件名为员工上传时的临时哈希或编号(例如 temp_img_1001.pdf)。我们的自动化目标包含两部分:一是汇总所有部门的报销明细并生成一张标准化总表;二是依据表格中的“员工工号”、“姓名”与“报销单号”,将散乱的附件规范重命名为 202610_销售一部_E1001_张三_差旅发票.pdf。
二、前置环境准备与目录规范
执行该任务需要安装数据处理核心库 pandas 以及支持 .xlsx 读写的解析引擎 openpyxl。标准库 pathlib 提供了面向对象的跨平台路径操作支持,无需额外安装。
在终端或命令行执行如下安装命令:
pip install pandas openpyxl建议将工作目录规范规划如下,避免不同类型文件混杂造成误读:
workspace/
├── data/
│   ├── excels/               # 存放待汇总的各部门原始Excel报表
│   │   ├── 报销明细_销售一部.xlsx
│   │   └── 报销明细_技术中心.xlsx
│   └── attachments/          # 存放待重命名的初始附件文件
│       ├── doc_001.pdf
│       └── doc_002.pdf
├── output/                   # 存放生成的汇总表与审计文件
└── batch_process.py          # 自动化主程序脚本
三、核心环节一:多张 Excel 表格的批量加载、清洗与合并
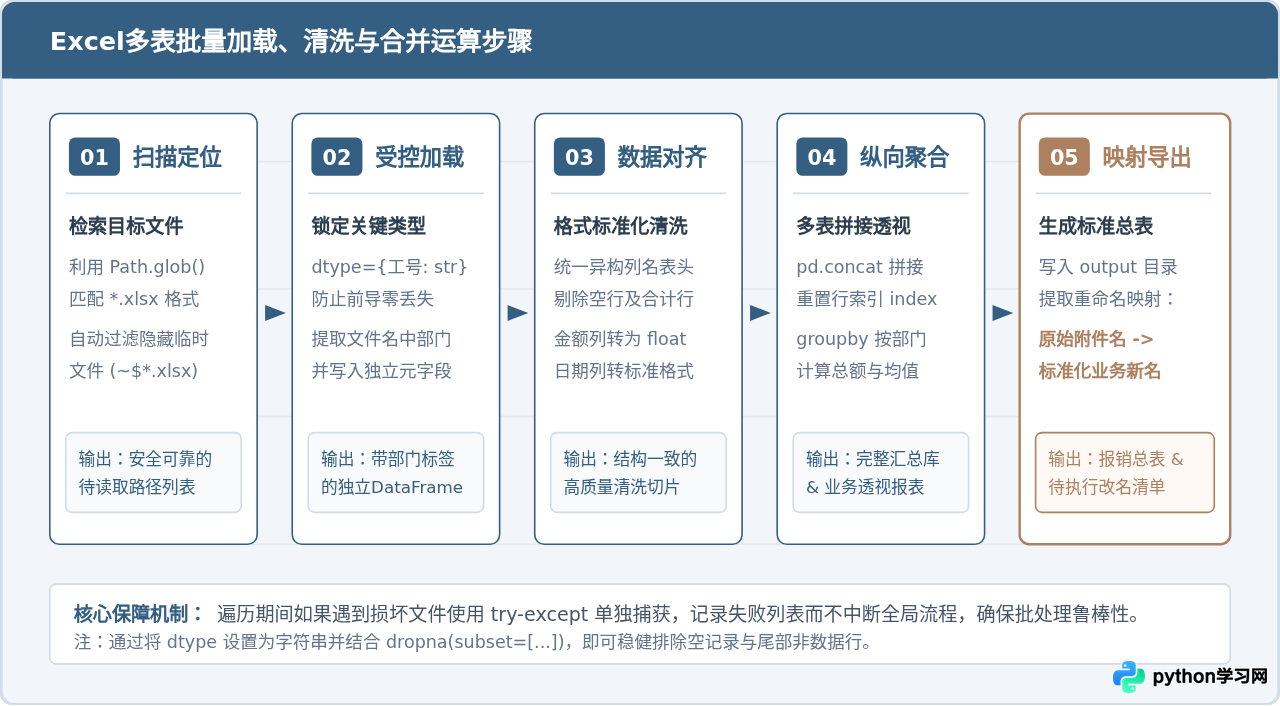
处理多张外部收集的表格时,通常会遇到以下三类关键问题:
- 前导零截断问题:员工工号如
00812常被 Excel 识别为数值并自动转为812。必须显式指定数据类型为字符串。 - 无效行干扰:表格末尾常有制表人留存的“合计”、“备注”或空行,需要预先定义有效过滤条件。
- 来源追溯缺失:多表纵向堆叠合并后,单凭明细无法断定属于哪个部门,必须在读取每个单表时注入来源元信息。
下面是实现这一过程的完整 Python 示例代码:
import pandas as pd
from pathlib import Path

def process_excel_files(input_dir: Path, output_file: Path) -> pd.DataFrame:
    """
    遍历指定目录中的所有Excel文件,清洗并合并为一张总表。
    """
    excel_files = list(input_dir.glob("*.xlsx"))

    # 过滤掉Excel打开时产生的临时隐藏文件(以~$开头)
    valid_files = [f for f in excel_files if not f.name.startswith("~$")]
    if not valid_files:
        raise FileNotFoundError(f"目录 {input_dir} 中未找到有效的 .xlsx 文件")

    data_frames = []

    # 规定统一的数据类型,确保工号和单据号不丢失前导零
    column_types = {
        "员工工号": str,
        "报销单号": str,
        "原始附件名": str
    }

    for file_path in valid_files:
        # 从文件名解析所属部门,例如从 "报销明细_销售一部.xlsx" 中提取 "销售一部"
        dept_name = file_path.stem.replace("报销明细_", "")

        try:
            df = pd.read_excel(file_path, dtype=column_types)
        except Exception as e:
            print(f"[警告] 无法读取文件 {file_path.name},原因: {e}")
            continue

        # 清洗步骤1:剔除关键标识字段为空的无效行
        df = df.dropna(subset=["员工工号", "报销单号", "报销金额"])

        # 清洗步骤2:剔除金额为非数值或统计汇总行
        df["报销金额"] = pd.to_numeric(df["报销金额"], errors="coerce")
        df = df.dropna(subset=["报销金额"])

        # 清洗步骤3:注入部门元数据
        df["所属部门"] = dept_name
        data_frames.append(df)

    if not data_frames:
        raise ValueError("未能解析出任何有效的报销数据")

    # 纵向拼接全部数据
    combined_df = pd.concat(data_frames, ignore_index=True)

    # 格式化日期字段(如果存在)
    if "报销日期" in combined_df.columns:
        combined_df["报销日期"] = pd.to_datetime(combined_df["报销日期"]).dt.strftime("%Y-%m-%d")

    # 输出合并后的 Excel 总表
    output_file.parent.mkdir(parents=True, exist_ok=True)
    combined_df.to_excel(output_file, index=False)
    print(f"[成功] 汇总数据已保存至: {output_file} (共 {len(combined_df)} 条记录)")

    return combined_df
四、核心环节二:基于数据驱动的文件安全重命名
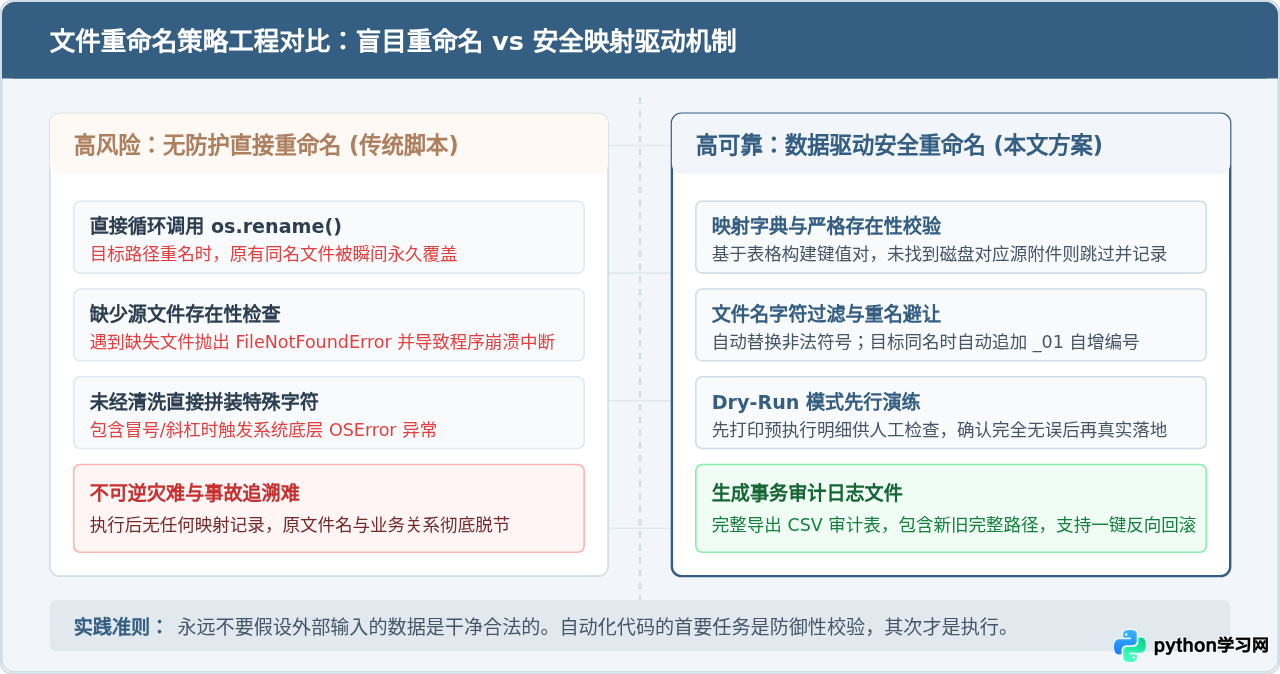
获得汇总数据表后,下一步是将附件目录下的散乱文件按照业务字段进行批量重命名。在很多初级脚本中,开发者往往直接使用 os.rename 硬性重命名,这在真实生产环境中极具风险。如果目标文件已存在,直接重命名会导致原文件被无提示覆盖,且一旦报错没有任何回滚记录。
一个成熟的工程级自动化重命名方案必须包含以下四个防护层:
- 映射合法性校验:检查 Excel 中登记的“原始附件名”是否存在于磁盘目录中。
- 非法字符清洗:防止员工在名字或单据号中输入操作系统禁止的文件名字符(例如
\ / : * ? " < > |)。 - 冲突检测与去重机制:若出现同名目标文件,自动追加自增序号(如
_01),严禁无感知覆盖。 - 空跑演练(Dry-Run)与事务日志:先模拟执行输出比对日志,确认无误再落盘,同时记录新旧文件名映射到 CSV 审计表中。
下面给出具备冲突检测、字符过滤与审计日志导出的批量安全重命名代码:
import re
import csv
from pathlib import Path
import pandas as pd

def clean_filename(filename: str) -> str:
    """清理文件名中的非法字符,避免因操作系统限制报错"""
    return re.sub(r'[\\/*?:"<>|]', '_', filename).strip()

def get_unique_target_path(target_path: Path) -> Path:
    """如果目标文件已存在,自动追加自增序号以避免覆盖"""
    if not target_path.exists():
        return target_path

    stem = target_path.stem
    suffix = target_path.suffix
    counter = 1

    while True:
        new_name = f"{stem}_{counter:02d}{suffix}"
        new_path = target_path.with_name(new_name)
        if not new_path.exists():
            return new_path
        counter += 1

def batch_rename_attachments(
    df: pd.DataFrame,
    attachment_dir: Path,
    audit_file: Path,
    dry_run: bool = False
):
    """
    根据汇总DataFrame中的数据重命名附件,并记录审计日志。
    :param df: 包含业务数据的汇总 DataFrame
    :param attachment_dir: 附件所在目录
    :param audit_file: 审计结果保存路径
    :param dry_run: 若为 True,仅打印演练日志,不进行真实重命名
    """
    audit_records = []
    success_count = 0
    skip_count = 0

    print(f"\n--- 开始批量重命名流程 (Dry Run: {dry_run}) ---")

    for _, row in df.iterrows():
        orig_name = str(row.get("原始附件名", "")).strip()
        dept = clean_filename(str(row.get("所属部门", "未知部门")))
        emp_id = clean_filename(str(row.get("员工工号", "无工号")))
        emp_name = clean_filename(str(row.get("员工姓名", "匿名")))
        bill_no = clean_filename(str(row.get("报销单号", "无单号")))

        if not orig_name or orig_name.lower() == "nan":
            continue

        src_file = attachment_dir / orig_name
        if not src_file.exists():
            print(f"[跳过] 磁盘上未找到原始附件: {orig_name}")
            skip_count += 1
            continue

        # 构造统一规范的目标文件名:部门_工号_姓名_单号_原名后缀
        file_suffix = src_file.suffix
        new_name_base = f"202610_{dept}_{emp_id}_{emp_name}_{bill_no}{file_suffix}"
        target_file = attachment_dir / new_name_base

        # 检查重名并获取安全路径
        final_target_file = get_unique_target_path(target_file)

        audit_records.append({
            "原始文件名": orig_name,
            "原始路径": str(src_file),
            "重命名后文件名": final_target_file.name,
            "重命名后路径": str(final_target_file),
            "状态": "待执行" if dry_run else "已完成"
        })

        if dry_run:
            print(f"[模拟] {orig_name} -> {final_target_file.name}")
        else:
            try:
                src_file.rename(final_target_file)
                success_count += 1
            except Exception as e:
                print(f"[失败] 重命名 {orig_name} 时发生错误: {e}")
                audit_records[-1]["状态"] = f"失败: {e}"

    # 保存审计日志
    audit_file.parent.mkdir(parents=True, exist_ok=True)
    with open(audit_file, mode="w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=["原始文件名", "原始路径", "重命名后文件名", "重命名后路径", "状态"])
        writer.writeheader()
        writer.writerows(audit_records)

    print(f"--- 处理完成: 成功 {success_count} 个, 跳过 {skip_count} 个,审计日志已输出至 {audit_file} ---")
五、完整主流程串联执行
将上述数据合并与文件重命名封装并置于主执行块中,即可实现一键式自动化流水线:
def main():
    base_dir = Path(__file__).resolve().parent
    excel_dir = base_dir / "data" / "excels"
    attach_dir = base_dir / "data" / "attachments"
    summary_path = base_dir / "output" / "2026年10月报销费用汇总表.xlsx"
    audit_log_path = base_dir / "output" / "rename_audit_log.csv"

    # 步骤 1:批量汇总各部门 Excel 数据
    summary_df = process_excel_files(input_dir=excel_dir, output_file=summary_path)

    # 步骤 2:先进行 Dry-Run 演练,确保无误
    batch_rename_attachments(
        df=summary_df,
        attachment_dir=attach_dir,
        audit_file=audit_log_path,
        dry_run=True
    )

    # 步骤 3:正式执行重命名 (确认演练结果符合预期后再开启)
    # batch_rename_attachments(
    #     df=summary_df,
    #     attachment_dir=attach_dir,
    #     audit_file=audit_log_path,
    #     dry_run=False
    # )

if __name__ == "__main__":
    main()
六、高频疑难问题排查与避坑指南
在日常批量处理 Excel 和重命名作业时,有以下三个典型问题容易引发故障:
问题一:Excel 中包含多重表头或顶端有空行导致列名错位
排查与修复:某些部门制作表格时习惯在顶部放置“XXX公司费用申报表”等合并单元格标题,导致直接使用 pd.read_excel 时将标题当成了列名。可以在调用 pd.read_excel 时增加参数 header=1 或 header=2 跳过前缀无关行,确保数据列精准对齐。
问题二:文件被 Windows 办公软件占用引发 PermissionError
排查与修复:当用户或后台程序已经使用 Excel 或 PDF 浏览器打开了某个附件时,直接调用 rename 会报错拒绝访问。工程中的解决策略是在执行重命名前进行句柄探测,或者将附件集中复制到独立的临时运行沙箱(Staging Area)中处理,待处理完毕后再同步回目标存储。
问题三:中文字符编码与路径长度超限(Windows MAX_PATH)
排查与修复:深度嵌套的目录下,由于拼接了较长的部门名称与人员姓名,容易超出 Windows 系统的 260 字符路径限制。建议在 Python 脚本中优先采用 Path 对象的解析方法,或在 Windows 注册表中启用长路径支持(LongPathsEnabled),输出 CSV 审计表时始终指明 encoding="utf-8-sig",防止 Excel 双击打开乱码。
七、总结与落地保障架构
自动化办公的核心价值在于将机械化的人工重复劳动转变为确定性、高一致性的代码流程。从单表处理迈向批量工程化落地的过程中,保障业务安全永远先于执行效率。
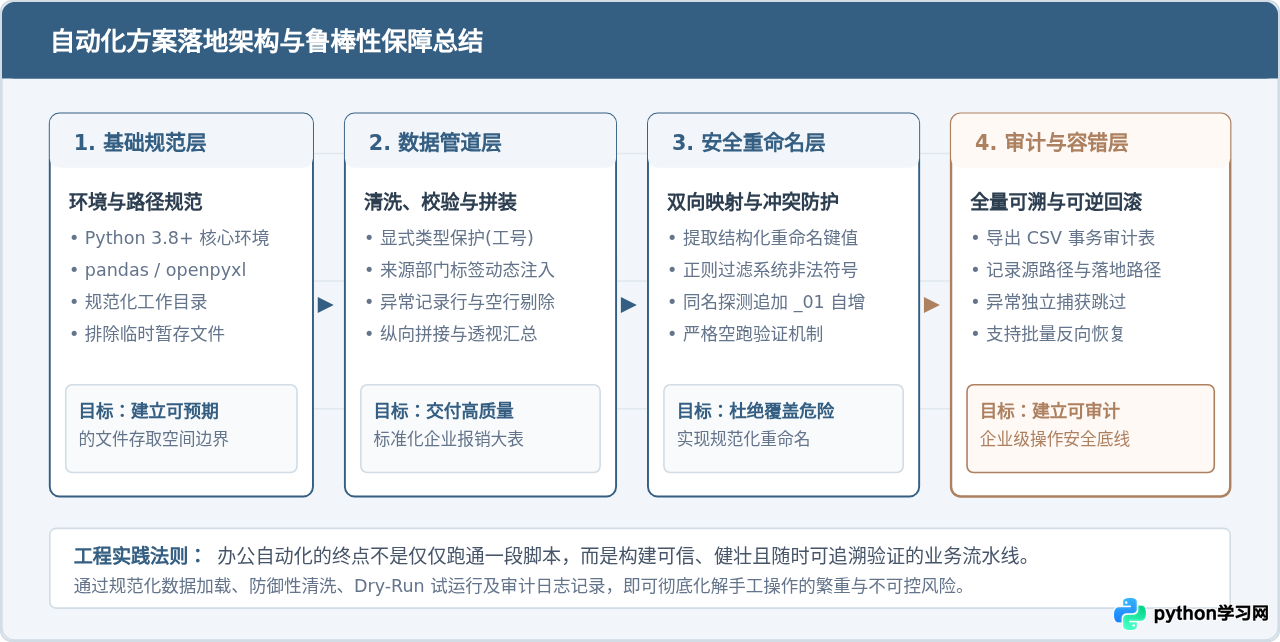
综上所述,将 pandas 的结构化处理能力与 pathlib 的文件系统操作能力相结合,并辅以严格的防重名与审计机制,不仅能极大提升办公数据流转效率,更能为企业沉淀稳定、可重复调用的数据处理资产。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















