


Python适合做什么?数据分析、Web开发与自动化脚本入门场景
针对初学者深入解析Python适合做什么,全面梳理数据分析、Web开发与自动化脚本三大核心入门场景的具体问题、技术栈选型、代码范式与操作步骤,并深度对比代码化与手工处理的关键差异。
一、Python 的能力定位与核心技术支撑
在计算机编程语言生态中,不同语言有着天然的分工与取向。C/C++ 强调极低运行开销与硬件底层掌控,Java 强于大型企业级高并发系统与强类型架构,JavaScript 牢固占据浏览器交互的主导地位。而 Python 从诞生之初,其核心设计哲学就是“代码可读性”与“开发者的生产力”。
对于需要快速验证想法、处理具体业务的初学者而言,Python 具有三项决定性的工程优势:
- 直观简洁的语法结构:省去了复杂的指针管理、繁复的样板代码以及冗长的类型声明,读者可以将注意力集中在业务逻辑本身,而不是语言本身的语法仪式。
- “胶水语言”的连接能力:能够无缝调用由 C 或 Fortran 编写的高性能底层计算库,在兼顾编写速度的同时保证了底层运算效率。
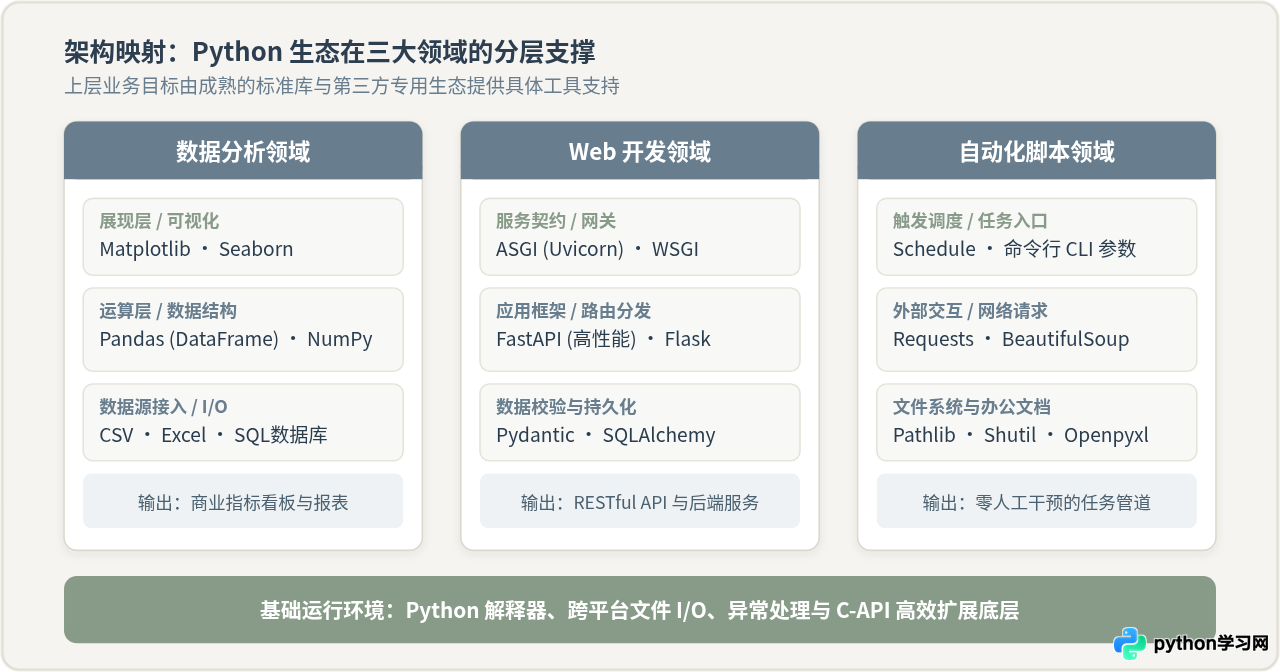
- 完善且活跃的标准库与第三方库:无论是处理本地表格、向服务器发送网络请求,还是构建 HTTP 服务,都有久经工业界检验的现成轮子可用。
二、场景一:数据分析入门实战
在数据分析领域,Python 已经成为行业标准工具之一。它主要解决日常办公软件在处理复杂条件过滤、跨多文件批量合并以及超大规模数据量时的性能与维护瓶颈。
1. 适合解决的具体问题
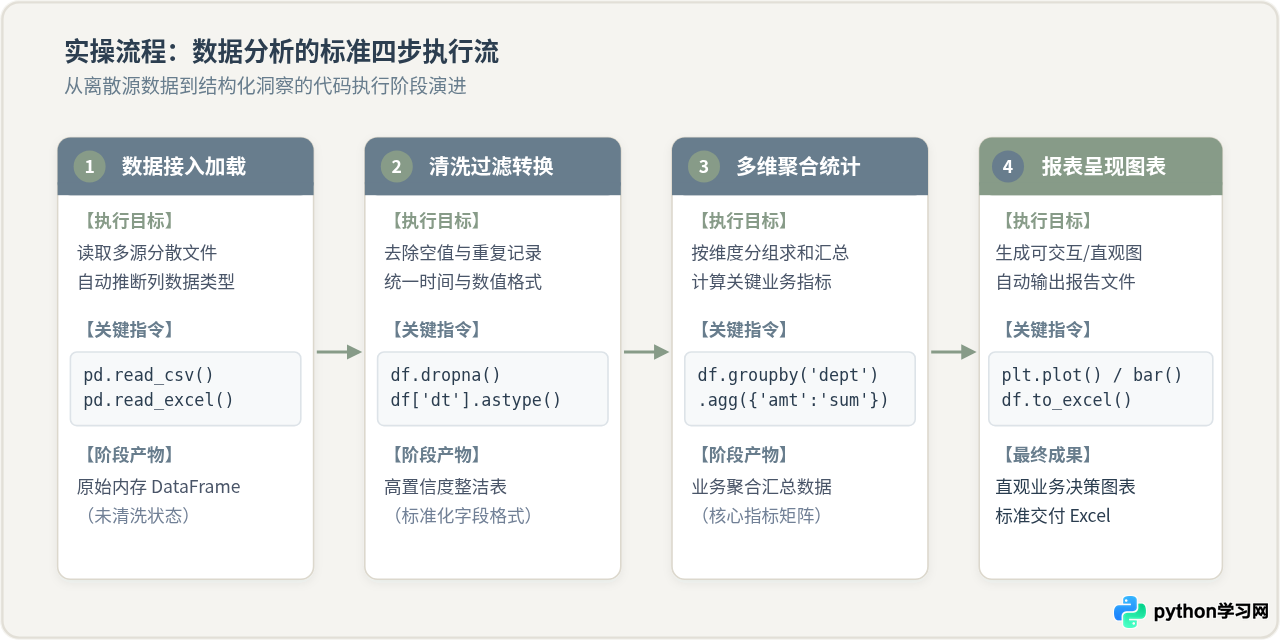
当面对几十个来源不同、格式略有偏差的原始数据文件(如销售账单、用户行为流水、库存盘点表)时,Python 可以通过程序化手段完成以下具体任务:
- 多源数据融合:自动遍历并合并多个 Excel 或 CSV 文件,统一表头与字段格式。
- 数据清洗与规整:自动处理空值、剔除重复订单、修剪前后空格并将文本型日期转换为标准时间对象。
- 多维指标聚合:按照部门、品类、地域等维度分组计算总量、均值、客单价及环比增长。
- 可视化报告输出:将统计结果生成折线趋势图、分布柱状图,并导出为标准格式的汇总 Excel 报告。
2. 核心工具与完整代码示例
该场景的核心第三方库是 pandas(用于表格结构化计算)与 matplotlib(用于图表绘制)。以下是一个完整的端到端示例代码,演示如何读取离散订单、清洗异常并统计品类营收:
# -*- coding: utf-8 -*-
# 执行环境说明:需在终端执行 pip install pandas matplotlib 安装依赖
import pandas as pd
import matplotlib.pyplot as plt

# 1. 模拟生成原始分散数据(实际场景中替换为 pd.read_csv('orders.csv'))
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "category": ["办公用品", "数码配件", "办公用品", "家具软装", "数码配件", None],
    "amount": [128.5, 450.0, None, 1200.0, 320.0, 99.0],
    "status": ["已支付", "已支付", "已退款", "已支付", "已支付", "未付款"]
}
df = pd.DataFrame(raw_data)

# 2. 清洗过滤:剔除非有效订单与空值记录
df_cleaned = df.dropna(subset=["category", "amount"]).copy()
df_valid = df_cleaned[df_cleaned["status"] == "已支付"].copy()

# 3. 聚合计算:按商品品类分组,汇总总营收与有效订单数量
category_summary = df_valid.groupby("category").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count")
).reset_index()

# 4. 输出统计表格结果
print("【各品类销售统计汇总】")
print(category_summary.to_string(index=False))

# 5. 生成可视化柱状图并保存为本地图片
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

plt.figure(figsize=(7, 4))
plt.bar(category_summary["category"], category_summary["total_sales"], color="#687D8D", width=0.5)
plt.title("各品类已支付销售额统计")
plt.xlabel("商品品类")
plt.ylabel("总销售额(元)")
plt.tight_layout()
plt.savefig("sales_summary.png", dpi=200)
print("可视化图表已保存为 sales_summary.png")
for 循环逐行遍历 DataFrame。Pandas 的计算优势建立在底层 C 语言连续内存向量化操作之上,使用 df['col'] * 2 的速度通常比循环快数十倍乃至上百倍。
三、场景二:Web开发入门实战
在 Web 开发领域,Python 并不直接运行在用户的浏览器前端,而是作为后端服务(Backend)的大脑。它负责接收前端或移动端的网络请求,执行业务逻辑运算,读写数据库,并将数据以结构化的形式返回。
1. 适合解决的具体问题
现代 Web 开发高度推崇“前后端分离”模式。Python 特别适合快速搭建以下服务形态:
- RESTful API 数据接口:为 Vue/React 网页应用、移动端 App 或小程序提供标准化 JSON 数据通道。
- 内部管理后台与中台系统:结合数据库实现员工权限、库存查询、订单审批等业务流系统。
- 轻量级微服务与数据服务网关:将数据分析模型或业务计算封装为 HTTP 接口,供其他系统调用。
2. 框架选型:为什么入门首推 FastAPI?
在 Python Web 框架中,传统老牌框架有 Django(全功能“大而全”框架)和 Flask(微内核极简框架)。而在构建现代 API 场景中,FastAPI 已经成为当下的首选入门框架。其原因在于:
- 基于 Python 原生类型提示(Type Hints),代码具备强类型自动校验,减少运行时低级错误;
- 开箱即用自动生成标准交互式 Swagger API 文档,无需手动编写接口说明;
- 基于异步 ASGI 标准,拥有极高的并发吞吐能力。
3. 完整代码示例:构建一个任务状态查询服务
以下是一个使用 FastAPI 编写的完整独立接口服务。代码实现了一个任务状态查询与创建接口:
# -*- coding: utf-8 -*-
# 执行环境说明:需在终端执行 pip install fastapi uvicorn 安装依赖
# 启动命令:uvicorn main:app --reload --port 8000
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from typing import Dict, Optional

app = FastAPI(title="任务状态监控服务", description="轻量级后端 API 接口示例")

# 定义数据传输模型(带字段类型验证)
class TaskItem(BaseModel):
    title: str
    owner: str
    completed: bool = False

# 模拟持久化存储(内存字典)
database_store: Dict[int, TaskItem] = {
    1: TaskItem(title="整理年度对账单", owner="张工", completed=True),
    2: TaskItem(title="服务器日志归档脚本", owner="李工", completed=False)
}

@app.get("/")
def read_root():
    return {"status": "online", "message": "任务监控服务正常运行"}

@app.get("/tasks/{task_id}")
def get_task(task_id: int):
    if task_id not in database_store:
        raise HTTPException(status_code=404, detail="未找到对应编号的任务")
    return {"task_id": task_id, "data": database_store[task_id]}

@app.post("/tasks/{task_id}")
def create_or_update_task(task_id: int, task: TaskItem):
    database_store[task_id] = task
    return {"message": "任务更新成功", "task_id": task_id, "data": task}
运行验证方法:在终端启动服务后,使用浏览器访问 http://127.0.0.1:8000/docs,即可直接看到系统自动生成的交互式 API 测试界面,并可在线点击发送请求验证返回数据。
四、场景三:自动化脚本入门实战
自动化脚本是 Python 对日常工作效率提升最立竿见影的场景。任何在电脑前需要“打开软件 -> 复制粘贴 -> 重命名保存 -> 定时发送”的机械重复流程,都属于自动化脚本的施展舞台。
1. 适合解决的具体问题
- 文件系统批量整理:按扩展名或文件修改时间将杂乱的“下载”文件夹分类归类至对应目录。
- 网络结构化数据定时抓取:利用
requests定时抓取行业公开行情并记录入库。 - 跨软件数据流转:读取本地 Excel 数据,通过网络 Webhook 发送给飞书/企业微信机器人进行实时通知。
2. 完整代码示例:下载目录自动分类归档脚本
以下脚本利用 Python 内置的标准库 pathlib 与 shutil,无需安装任何第三方库即可在 macOS、Windows、Linux 跨平台运行:
# -*- coding: utf-8 -*-
# 执行环境:Python 3.6+ 内置标准库,开箱即用,无需额外 pip 安装
import os
import shutil
from pathlib import Path

def organize_directory(target_folder_path: str):
    base_dir = Path(target_folder_path)
    if not base_dir.exists() or not base_dir.is_dir():
        print(f"指定的目录不存在: {target_folder_path}")
        return

    # 定义后缀分类规则
    extension_map = {
        "文档资料": [".pdf", ".docx", ".doc", ".xlsx", ".csv", ".txt"],
        "图片素材": [".png", ".jpg", ".jpeg", ".gif", ".webp"],
        "安装安装包": [".zip", ".tar", ".gz", ".dmg", ".exe"],
        "源码脚本": [".py", ".sh", ".json", ".sql"]
    }

    moved_count = 0
    # 遍历当前目录下的所有普通文件
    for file_path in base_dir.iterdir():
        if file_path.is_file() and not file_path.name.startswith("."):
            ext = file_path.suffix.lower()
            target_category = "其他杂项"
            for category, suffixes in extension_map.items():
                if ext in suffixes:
                    target_category = category
                    break

            # 目标文件夹路径
            dest_dir = base_dir / target_category
            dest_dir.mkdir(exist_ok=True)

            # 移动文件至对应分类目录
            target_dest = dest_dir / file_path.name
            # 若目标存在同名文件则防重命名
            if not target_dest.exists():
                shutil.move(str(file_path), str(target_dest))
                print(f"已移动: {file_path.name} -> {target_category}/")
                moved_count += 1

    print(f"整理完成!共计归档文件 {moved_count} 个。")

# 示例调用:整理当前工作目录下的 test_downloads 文件夹
if __name__ == "__main__":
    organize_directory("./test_downloads")
五、深度对比:传统手工 Excel 处理 vs Python 脚本化处理
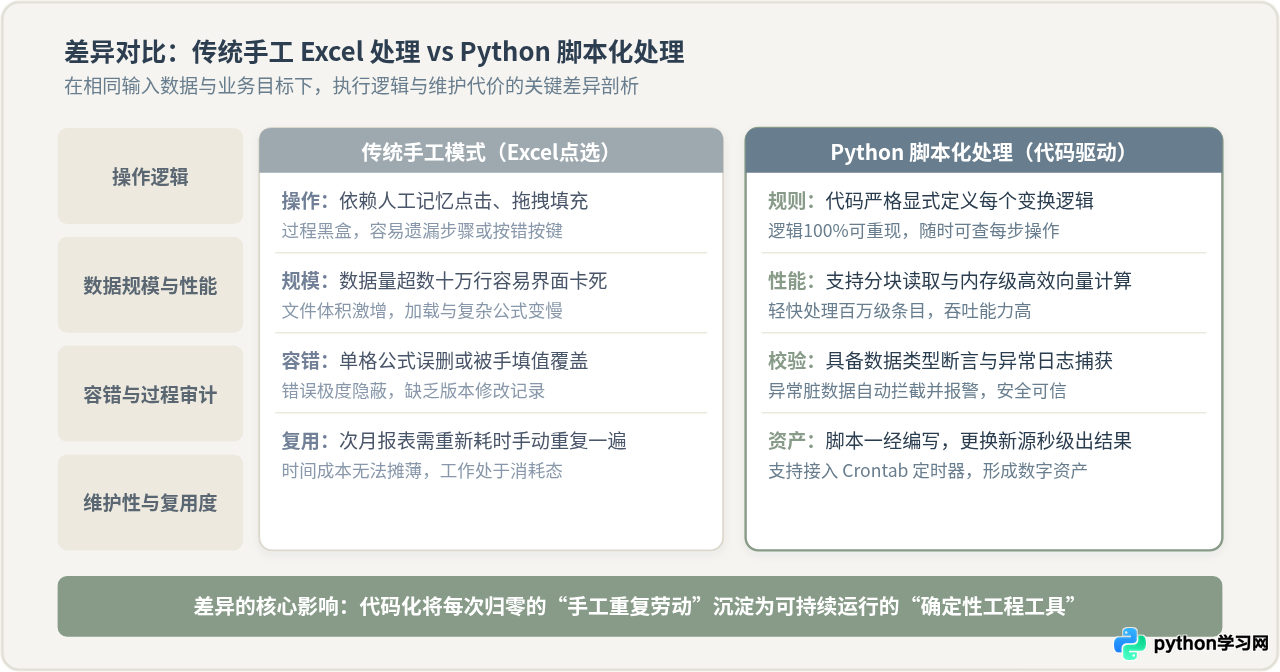
为了帮助读者清晰理解为什么以及在何种条件下应当转向 Python,我们选取办公中最常见的“跨门店月度销售对账与合并报表”作为同一基准场景,全面拆解两种处理方式的关键差异。
| 对比维度 | 传统手工模式(Excel点选) | Python 脚本化模式(代码驱动) |
|---|---|---|
| 操作逻辑 | 依赖人工记忆在图形界面中点击菜单、拖拽单元格,操作过程不可见且不可追溯。 | 通过代码明确声明每一步转换规则,处理逻辑公开透明,随时可审计与版本回溯。 |
| 数据吞吐与性能 | 文件数据达到几十万行时,打开与复杂函数运算极其缓慢,甚至引发程序假死。 | 利用连续内存块与分块技术(Chunking),单机可轻快吞吐数百万行明细,资源消耗受控。 |
| 容错与异常校验 | 公式被意外删除或覆盖后极难被察觉,最终生成的错误数字往往只能靠人工肉眼排查。 | 可在脚本中内置类型断言与数据校验逻辑,遇到脏数据主动拦截并输出精准错误日志。 |
| 长期维护与复用 | 下个月报表到达后,必须由员工重新投入同等的人工工时重新做一遍,属于消耗性劳动。 | 脚本编写一次即成为数字化资产,更新源文件后仅需数秒即可全自动生成次月完整成果。 |
差异为什么重要?手工方式在处理临时、一次性、几十行的微型表格时确实直观灵活;但只要任务具备“周期性重复”或“数据规模持续增长”这两个特征中的任意一个,传统手工模式的人工时间成本就会线性增加,而 Python 脚本化处理能将边际执行成本降至趋近于零。
六、适用边界:什么场景不适合使用 Python?
一个成熟的开发者不仅知道工具能做什么,更要清楚它的局限性。Python 并非万能钥匙,在以下场景中,通常存在比 Python 更加合适的专门工具:
- 极度严苛的毫秒/微秒级低延迟系统:例如高频交易引擎内核、实时音视频解码渲染管线。Python 的全局解释器锁(GIL)和垃圾回收(GC)机制会带来不可控的微小停顿,这类任务属于 C、C++ 或 Rust 的专长。
- 原生移动端 App 开发:虽然有 Kivy 等跨平台尝试,但在 iOS 与 Android 原生开发中,界面的流畅度、系统权限调用与生态规范决定了 Swift、Kotlin 或 Flutter 才是主流正解。
- 复杂的浏览器前端富交互应用:浏览器渲染引擎只直接执行 JavaScript/WebAssembly,网页端的动态动效与复杂用户界面应使用 TypeScript 配合现代化前端框架完成。
七、场景选型决策与入门行动路径
初学者切忌在没有实际需求驱动的情况下,试图把 Python 所有领域的库一股脑全部学完。最高效的入门方法是:识别你当前最迫切的单个痛点,选择对应场景完成一个完整的小闭环。
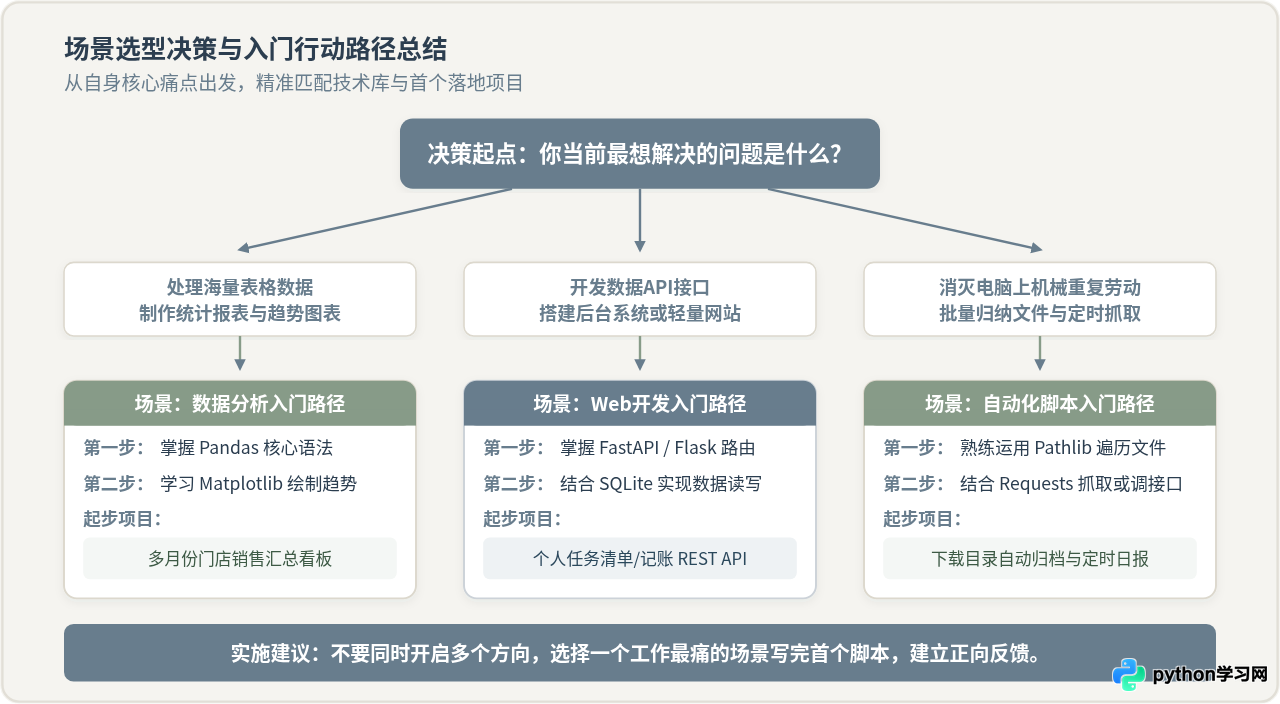
根据上图的决策树,你可以对照下述三种常见的工作或学习状态启动实践:
- 如果你手头有堆积如山的统计报表:从安装
pandas开始,先写一段 20 行的脚本,读取一个真实的业务表格,滤除空行并输出汇总总额。 - 如果你希望为前端或移动端提供数据支撑:从安装
fastapi和uvicorn开始,搭建一个只返回当前时间和状态的简单 GET 接口,并在本地浏览器中跑通测试。 - 如果你每天在电脑前重复机械性的文件移动或下载:从标准库
pathlib开始,写一个 15 行的自动整理脚本,让繁琐的文件归纳在后台一秒完成。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















