


Python有哪些应用场景:Web开发、数据分析与人工智能
深入解析Python在Web开发、数据分析与人工智能三大核心领域的实际应用场景、技术生态、典型工作流与技术选型建议。
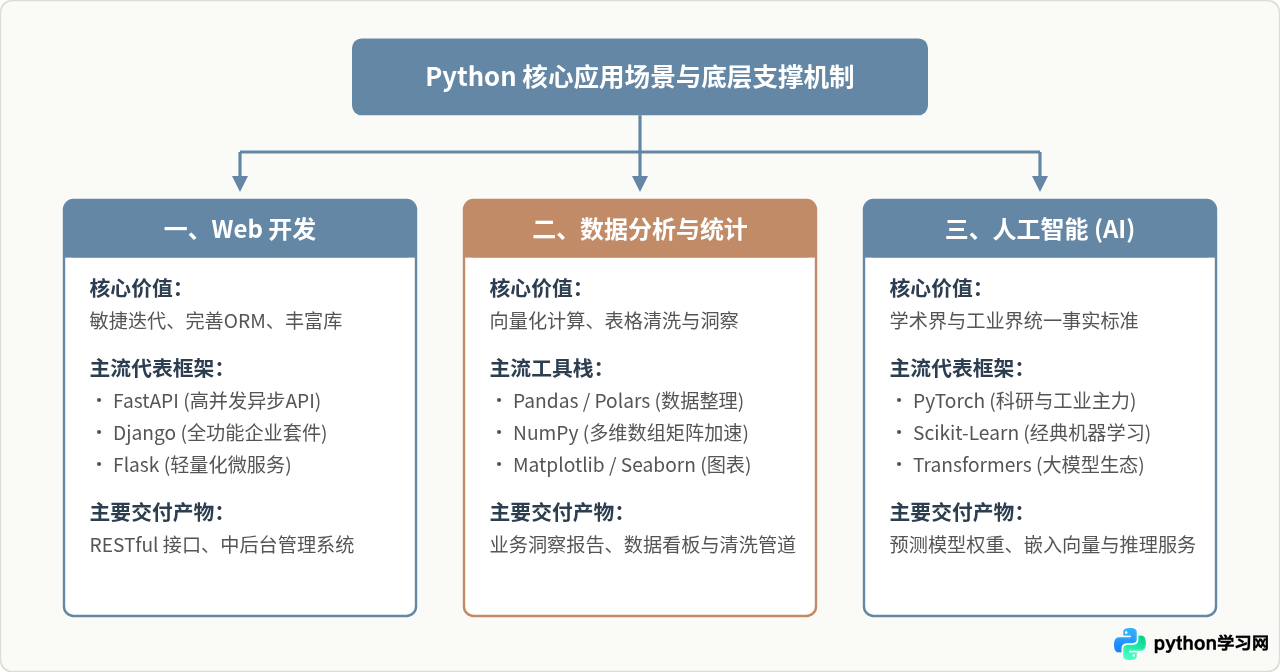
Python作为一门通用高级编程语言,其设计哲学强调代码的可读性与简洁的语法表达。在工业界与工程落地中,Python并非面面俱到地适用于所有开发领域(如高性能系统内核或移动端原生GUI开发),但在以下三大领域中构建了稳固的竞争优势与生态护城河:服务端Web应用开发、数据分析与统计处理,以及人工智能与机器学习算法落地。理解这三大场景的技术栈、典型工作流和工程边界,有助于在技术选型与学习实践中做出合理的判断。
场景一:Web开发——构建现代化API与企业级服务端
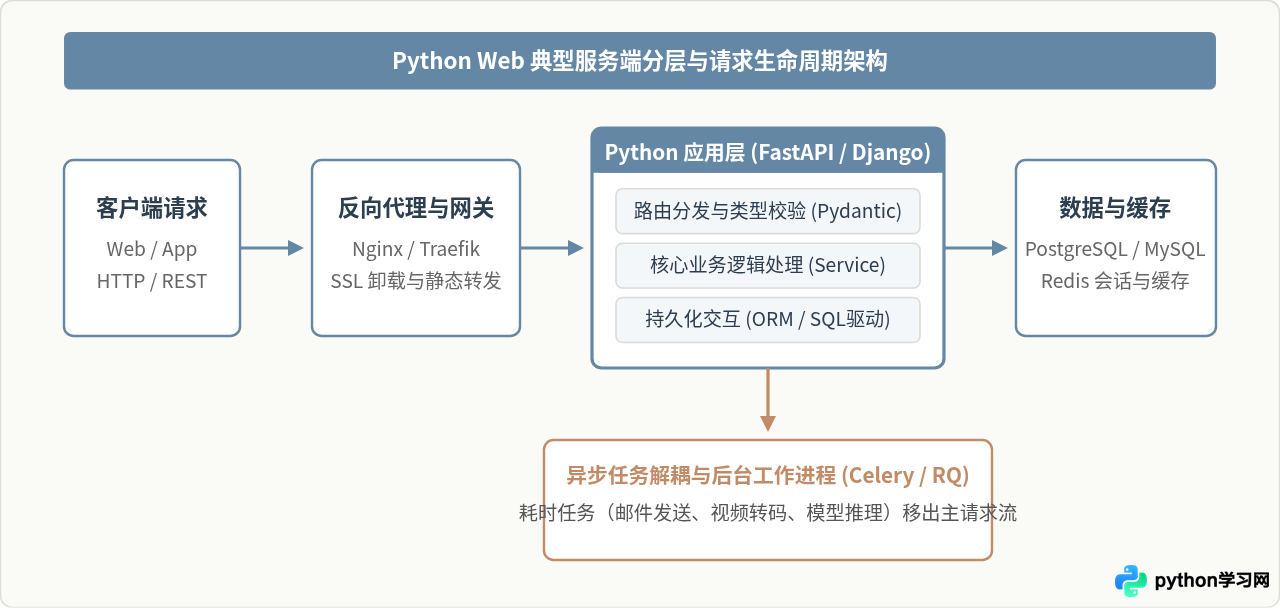
在服务端开发中,Python因原型设计快速、框架开箱即用而广泛应用于企业内部中后台、自动化运维控制台,以及面向前后端分离架构的微服务API构建。
1. 主流框架选型边界
- Django:采用“全功能内置(Batteries-Included)”理念,自带完善的ORM数据库映射、权限认证机制与管理后台(Django Admin)。当项目需要在短时间内完成完整的企业后台或具备复杂关系型数据库结构的内容平台时,Django能节省大量基础架构搭建时间。
- FastAPI:现代化的高性能异步Web框架,基于ASGI协议规范和Python类型注解(Type Hints)。通过Pydantic进行入参强类型自动校验,同时原生支持
async/await协程并发处理,非常契合高并发I/O密集型的RESTful接口或AI推理网关服务。 - Flask:极简微框架,核心仅保留路由和请求上下文分发,其余数据库ORM、表单验证均通过第三方扩展(如Flask-SQLAlchemy)自由组装,适用于小型工具或轻量服务。
2. 典型工程示例:FastAPI 接口实现
下面是一个使用FastAPI构建用户查询接口的代码示例,展示了类型安全校验与异步处理机制:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="用户数据服务", version="1.0.0")

class UserProfile(BaseModel):
    user_id: int = Field(gt=0, description="用户唯一编号")
    username: str = Field(min_length=2, max_length=50)
    email: str
    is_active: bool = True

# 模拟内存数据库
FAKE_DB = {
    101: {"user_id": 101, "username": "zhangsan", "email": "zhangsan@example.com", "is_active": True}
}

@app.get("/api/v1/users/{user_id}", response_model=UserProfile, status_code=status.HTTP_200_OK)
async def get_user_profile(user_id: int):
    # 模拟异步I/O查询
    user_data = FAKE_DB.get(user_id)
    if not user_data:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"未找到编号为 {user_id} 的用户记录"
        )
return user_data场景二:数据分析——从非结构化清洗到业务洞察
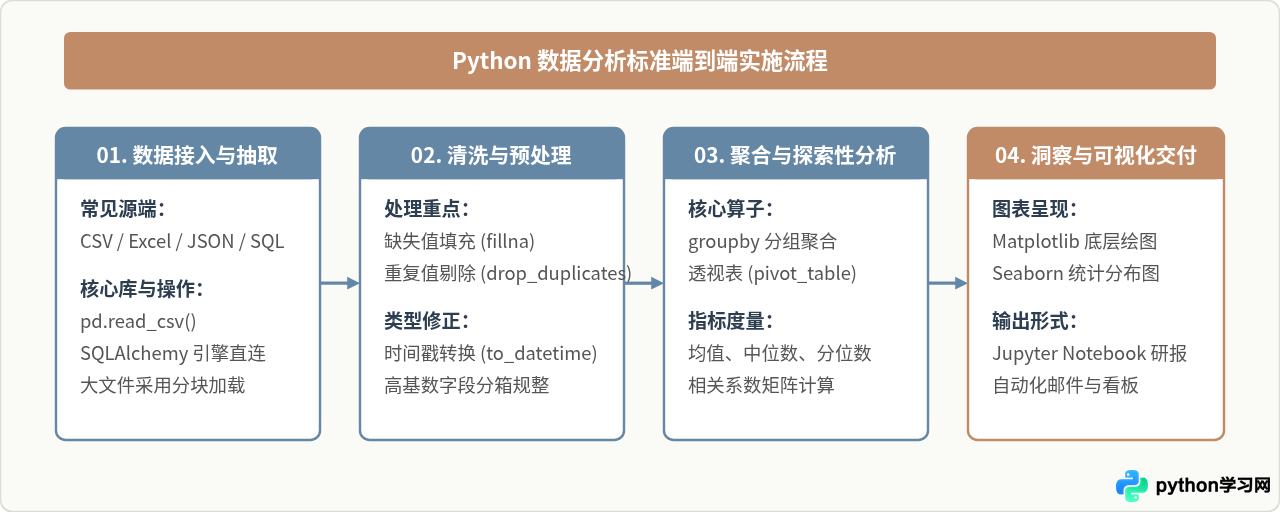
数据分析是Python应用最为成熟的领域之一。Python之所以在数据分析中替代传统Excel和部分专用统计软件,核心原因在于其形成了以NumPy和Pandas为轴心的完整工具链,能够通过代码精确沉淀分析逻辑,实现流程自动化复用。
1. 核心库分工协作
- NumPy:提供高性能的N维数组对象(
ndarray),其核心计算逻辑由C语言编写,支持连续内存布局与SIMD指令集加速,是几乎所有Python数据科学库的基石。 - Pandas:在NumPy之上封装出
Series与DataFrame二维表格结构,专门解决真实业务场景中脏数据清洗、空值对齐、分组汇总(GroupBy)与时间序列重采样问题。 - Matplotlib 与 Seaborn:Matplotlib提供细粒度的图元控制能力,Seaborn在此基础上提供高级统计图表接口(如箱线图、热力图、分布密度图),直观呈现数据离散程度与相关性。
2. 典型工程示例:销售数据清洗与聚合统计
import pandas as pd
import numpy as np

# 1. 模拟业务原始数据(含缺失值与异常格式)
raw_data = {
    "order_id": ["A1001", "A1002", "A1003", "A1004", "A1005"],
    "region": ["华东", "华北", "华东", np.nan, "华南"],
    "sales_amount": ["1250.5", "830.0", "2100.0", "450.0", "1680.0"],
    "quantity": [5, 2, np.nan, 1, 4]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗与格式转换
# 字段类型转换
df["sales_amount"] = pd.to_numeric(df["sales_amount"])
# 填充缺失值:地区填为"未知",购买数量填为中位数
df["region"] = df["region"].fillna("未知")
df["quantity"] = df["quantity"].fillna(df["quantity"].median())

# 3. 计算衍生指标:客单价
df["unit_price"] = df["sales_amount"] / df["quantity"]

# 4. 分组聚合统计各区域销售总额与平均客单价
summary = df.groupby("region").agg(
    total_sales=("sales_amount", "sum"),
    order_count=("order_id", "count"),
    avg_unit_price=("unit_price", "mean")
).reset_index()

# 示例输出:展示汇总指标
print(summary.to_string(index=False))for index, row in df.iterrows()循环逐行处理数据,这种方式完全放弃了底层C语言的向量化运算,会导致执行速度下降数十倍甚至上百倍。在数据量超过百万行时,必须优先使用Pandas内置的向量化操作或apply函数;当单文件体积接近机器物理内存时,应采用chunksize按批次读取或改用内存更高效的Polars。
场景三:人工智能——算法建模与深度学习工程落地
如果说数据分析是对过去数据的挖掘与复盘,那么人工智能(AI)则是基于历史数据训练特征规律,对未知输入进行预测、推理或生成。在AI领域,Python处于无可替代的统一标准地位,其上游承载学术前沿论文代码开源,下游支撑工业界算法工程落地。
1. 经典机器学习与深度学习的技术分工
- 经典机器学习(Scikit-Learn):适用于结构化表格数据。包含逻辑回归、随机森林、支持向量机(SVM)以及梯度提升树(XGBoost/LightGBM)。当特征维度清晰、数据量在数十万行以内且要求较强的模型可解释性时,经典机器学习方案训练快、资源消耗小。
- 深度学习与大模型(PyTorch / TensorFlow / Transformers):适用于高维非结构化数据(如图像、语音、自然语言文本)。PyTorch凭借动态计算图机制与优秀的Pythonic调试体验,已成为学术界与大模型研发的首选底层框架;而Hugging Face社区的Transformers库则成为调用和微调开源大语言模型的事实标准。
2. 典型工程示例:基于 Scikit-Learn 的模型训练与评估
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

# 1. 加载标准化数据集并划分训练集与测试集(8:2比例)
dataset = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
    dataset.data, dataset.target, test_size=0.2, random_state=42, stratify=dataset.target
)

# 2. 实例化随机森林模型并执行训练
model = RandomForestClassifier(n_estimators=50, max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 3. 对未知测试集进行预测
predictions = model.predict(X_test)

# 4. 输出评估指标
acc = accuracy_score(y_test, predictions)
print(f"测试集准确率: {acc:.4f}\n")
print("分类报告详情:")
print(classification_report(y_test, predictions, target_names=dataset.target_names))三大应用场景横向对比与技术选型建议
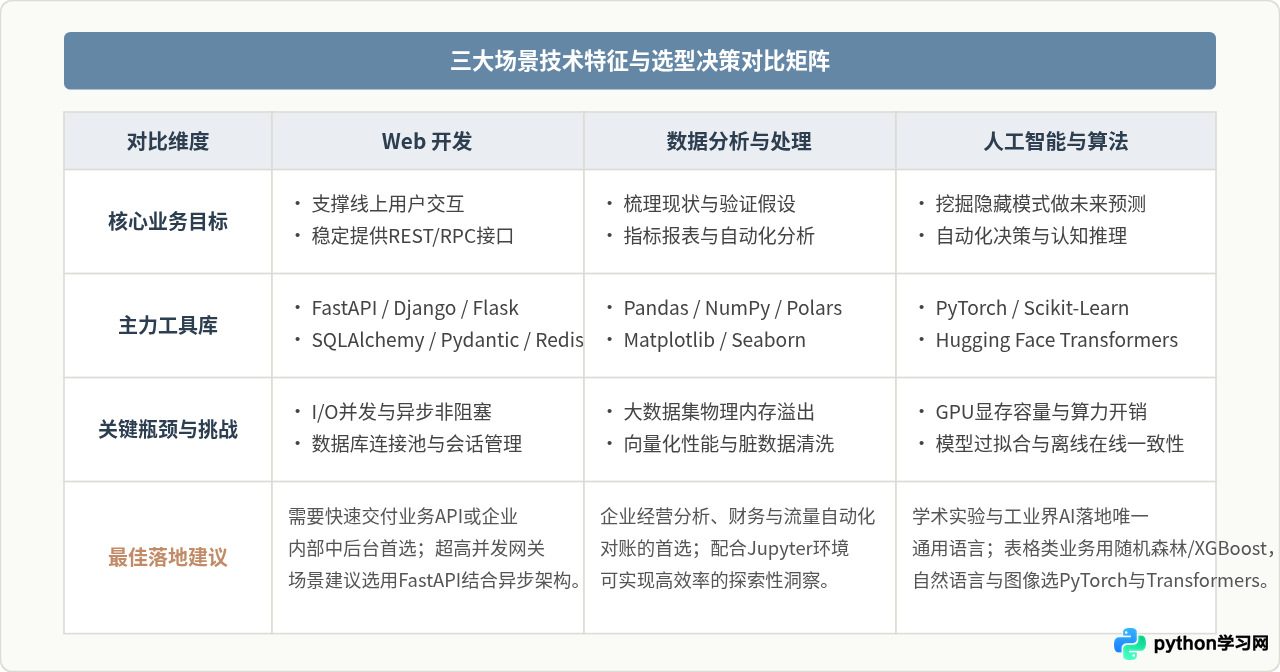
为了帮助读者根据实际业务场景与个人学习规划进行定位,下表通过核心目标、主力工具、工程门槛与选型建议等维度对三大领域进行对比总结:
总结与学习建议
归纳而言,Python在Web开发、数据分析与人工智能这三个方向上展现了各自不同的优势侧重点:
- Web开发侧重于工程敏捷度与研发效率。借助成熟的框架生态,可以在最短时间内完成业务逻辑验证与API服务上线。
- 数据分析侧重于数据整理与决策赋能。借助NumPy和Pandas的向量化底层加速,能够将复杂重复的数据提取与统计流程转变为可靠的代码资产。
- 人工智能侧重于算法创新与生态集成。Python已成为全球深度学习与大模型社区的标准协议,绝大部分前沿技术突破均率先以Python接口交付。
在实际规划学习或技术选型时,无需尝试同时全面掌握所有库。建议根据当前业务痛点或岗位需求,以一个核心领域为抓手(如先掌握Pandas数据分析或FastAPI接口开发),在熟练掌握Python核心语法、数据结构和模块化组织后,再根据需要横向扩展到其余方向。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















