


Python单下划线与双下划线开头变量的区别
深入解析Python中单下划线(_var)与双下划线(__var)开头变量的核心区别、底层实现机制(名称改写Name Mangling)、模块导入控制与继承冲突防护,并提供工程实践选型指南。
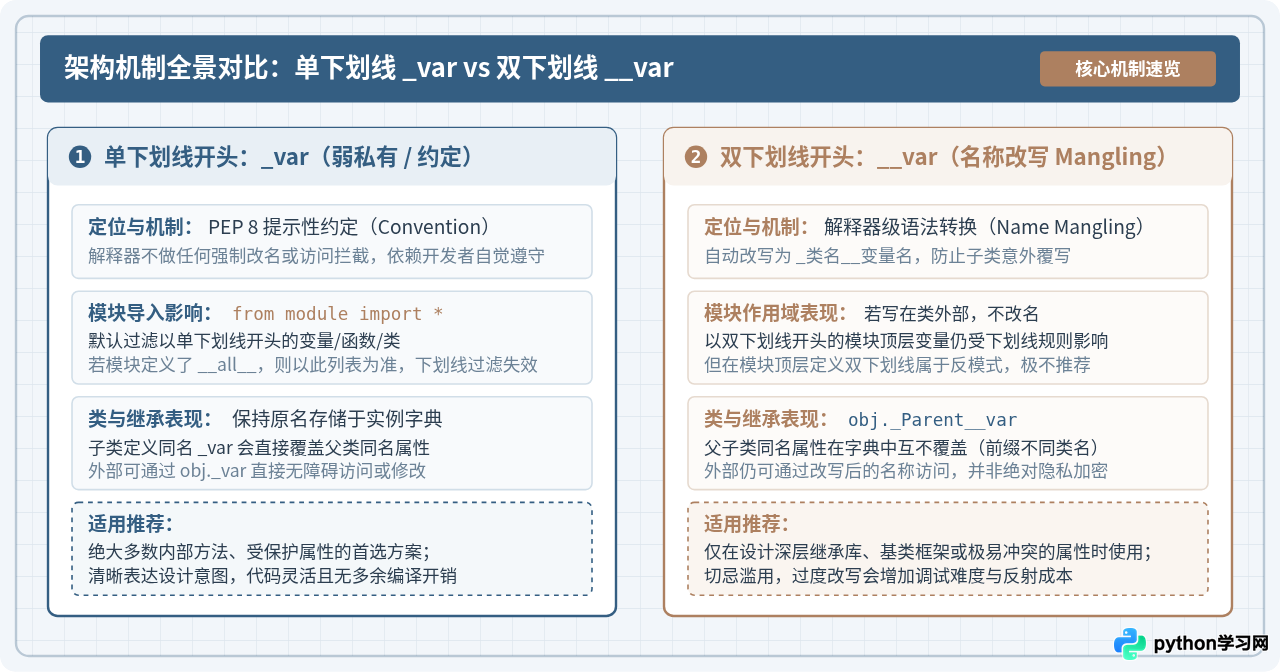
_var)是一种提示性编程规范(PEP 8 约定),用于表明该属性或函数供内部使用,解释器不会做任何强制拦截,仅在 from module import * 时默认不导出;而双下划线开头变量(如 __var,且结尾至多一个下划线)触发的是解释器级别的语法机制——名称改写(Name Mangling),解释器会自动将其重命名为 _ClassName__var,其核心工程目的是避免子类继承时的属性遮蔽与命名冲突,而不是实现不可破解的强私有保护。
一、单下划线开头(_var):约定俗成的“内部属性”
单下划线前缀是 Python 社区中最常见的设计模式之一。它的设计哲学非常明确:依靠程序员之间的约定,而非语言运行时的强制沙箱。
1.1 编程规范与调用约束
根据 Python 官方编码风格指南(PEP 8),以单个下划线开头的变量或方法表示“受保护的”或“仅供内部使用”的实现细节。这相当于给调用者贴上了一张“内部实现,请勿直接依赖”的警示标签。
在类实例化后,解释器不会对 _var 进行任何阻拦或名称篡改,外部代码依然可以像普通属性一样读取和修改它:
class DatabaseConnection:
    def __init__(self, host: str):
        self.host = host          # 公开属性,外部推荐直接使用
        self._retry_count = 3     # 单下划线:内部状态,外部不建议直接修改

conn = DatabaseConnection("127.0.0.1")
# 示例输出:Python 允许直接读取,不会抛出任何异常
print(conn._retry_count)  # 输出: 3
虽然技术上可以访问,但合格的开发者应当意识到:带单下划线的属性属于私有实现细节,未来的库升级或内部重构可能会在不发警告的情况下修改或删除它。
1.2 模块级导入导出行机制
单下划线在模块层级具有唯一的“语法级行为影响”:当其他文件使用通配符导入(from module import *)时,解释器会自动跳过所有以单下划线开头的全局变量、函数和类。
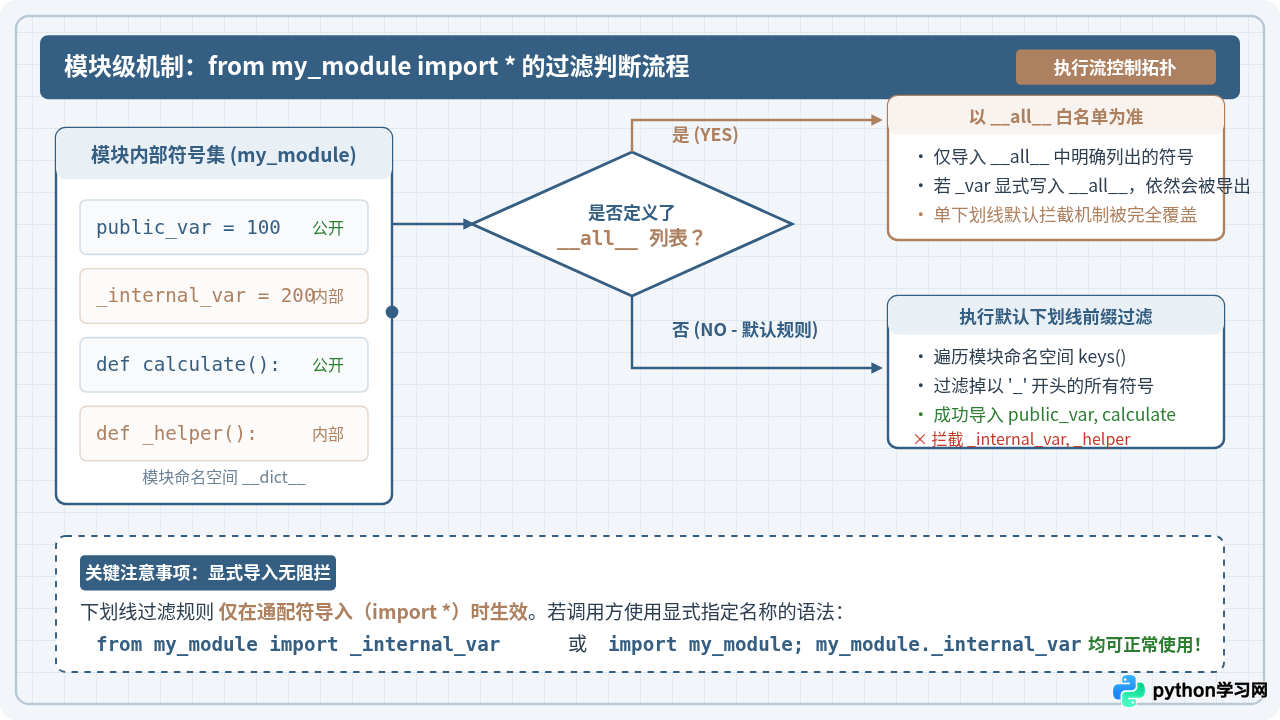
假设我们创建了一个名为 math_utils.py 的模块:
# math_utils.py
pi = 3.1415926535

def add(a, b):
    return a + b

def _internal_normalize(val):
    return round(val, 2)
在另一个脚本中分别使用不同方式导入该模块,其执行表现完全不同:
# main.py
from math_utils import *

print(pi)                      # 正常执行,输出: 3.1415926535
print(add(1, 2))               # 正常执行,输出: 3
# print(_internal_normalize(5)) # 抛出 NameError: name '_internal_normalize' is not defined- 显式导入不受任何限制:如果调用方使用
from math_utils import _internal_normalize或import math_utils; math_utils._internal_normalize(5),依然可以正常访问。下划线仅过滤import *。 __all__具有最高优先级:若模块中显式定义了__all__ = ['_internal_normalize'],那么即使带单下划线,也会被导出;而未在__all__中的普通符号反而不会被导出。
二、双下划线开头(__var):名称改写(Name Mangling)机制
当变量以至少两个下划线开头,且末尾至多一个下划线时(如 __var 或 __var_),Python 解释器在语法解析阶段会触发“名称改写”(Name Mangling)机制。
2.1 名称改写的底层工作原理
名称改写的核心规则非常简单:解释器在将代码编译为字节码时,会在标识符前面自动拼接单个下划线加上当前所在类名,将其重命名为 _类名__变量名(若类名以多个下划线开头,只保留一个前缀下划线)。
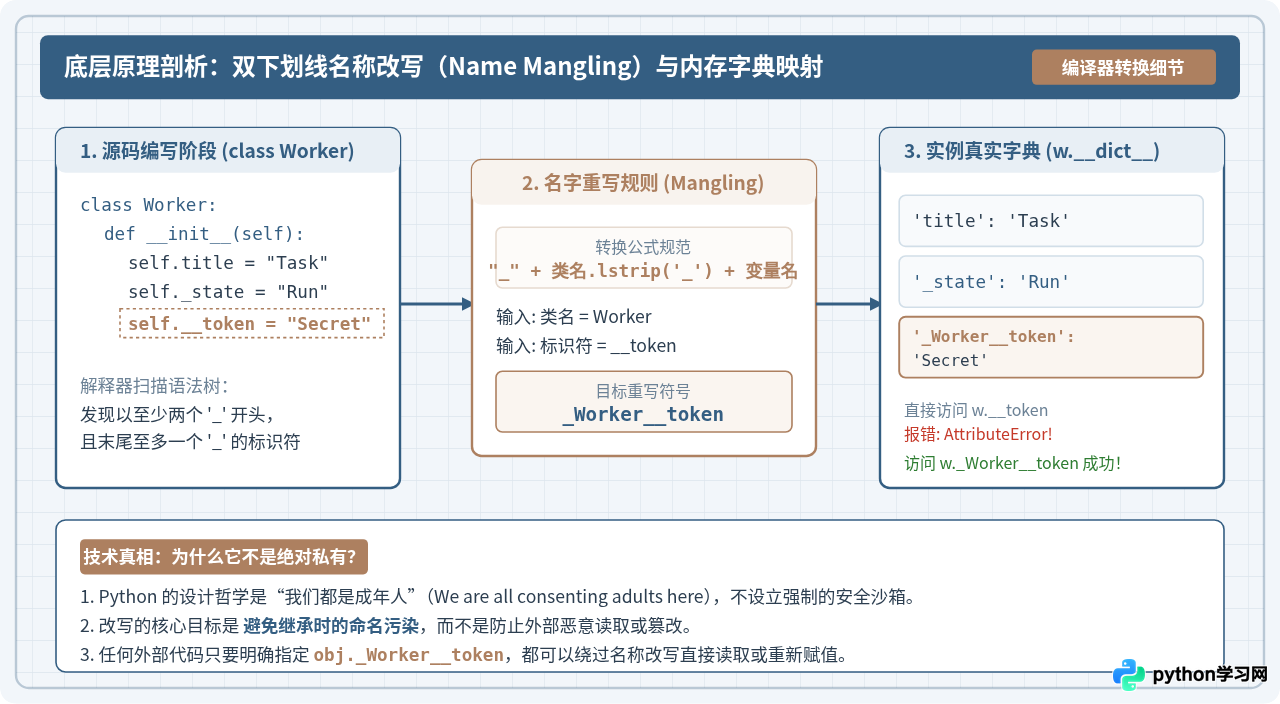
我们通过打印实例的 __dict__ 属性字典,可以清晰观察到解释器的真实内存布局:
class PaymentGateway:
    def __init__(self, api_key: str):
        self._mode = "sandbox"       # 单下划线
        self.__secret_key = api_key   # 双下划线

    def get_masked_key(self):
        # 在类的内部,可以直接使用原名 __secret_key 访问
        return self.__secret_key[:3] + "***"

pg = PaymentGateway("sk_test_987654321")

# 打印实例字典的所有底层键
print(pg.__dict__)
# 示例输出:
# {'_mode': 'sandbox', '_PaymentGateway__secret_key': 'sk_test_987654321'}
此时,如果在类的外部直接调用 pg.__secret_key,Python 解释器会按照常规查找名为 __secret_key 的属性,由于字典中只有 _PaymentGateway__secret_key,因此会立刻抛出异常:
print(pg.__secret_key)
# 抛出异常:AttributeError: 'PaymentGateway' object has no attribute '__secret_key'
2.2 为什么双下划线不是真正的“安全私有”?
很多初学者误以为双下划线等同于 Java 或 C++ 中的 private 访问修饰符。实际上,只要你知道改写规则,依然可以通过重命名后的属性直接访问甚至篡改它:
# 绕过名称改写,直接显式访问
print(pg._PaymentGateway__secret_key)  # 正常输出: sk_test_987654321

# 甚至可以直接外部篡改
pg._PaymentGateway__secret_key = "hacked_key"
print(pg.get_masked_key())             # 输出: hac***
Python 之父 Guido van Rossum 曾明确指出,名称改写的目的是防君子不防小人,防意外不防蓄意。它的真正诞生原因不是为了安全隐私,而是为了解决面向对象继承中的命名污染。
三、核心差异对决:继承体系下的命名碰撞与保护
理解单双下划线区别的最佳舞台是面向对象的多层继承。在大型框架或深层类继承结构中,父类和子类往往由不同的开发者在不同时期编写,极易发生属性同名冲突。
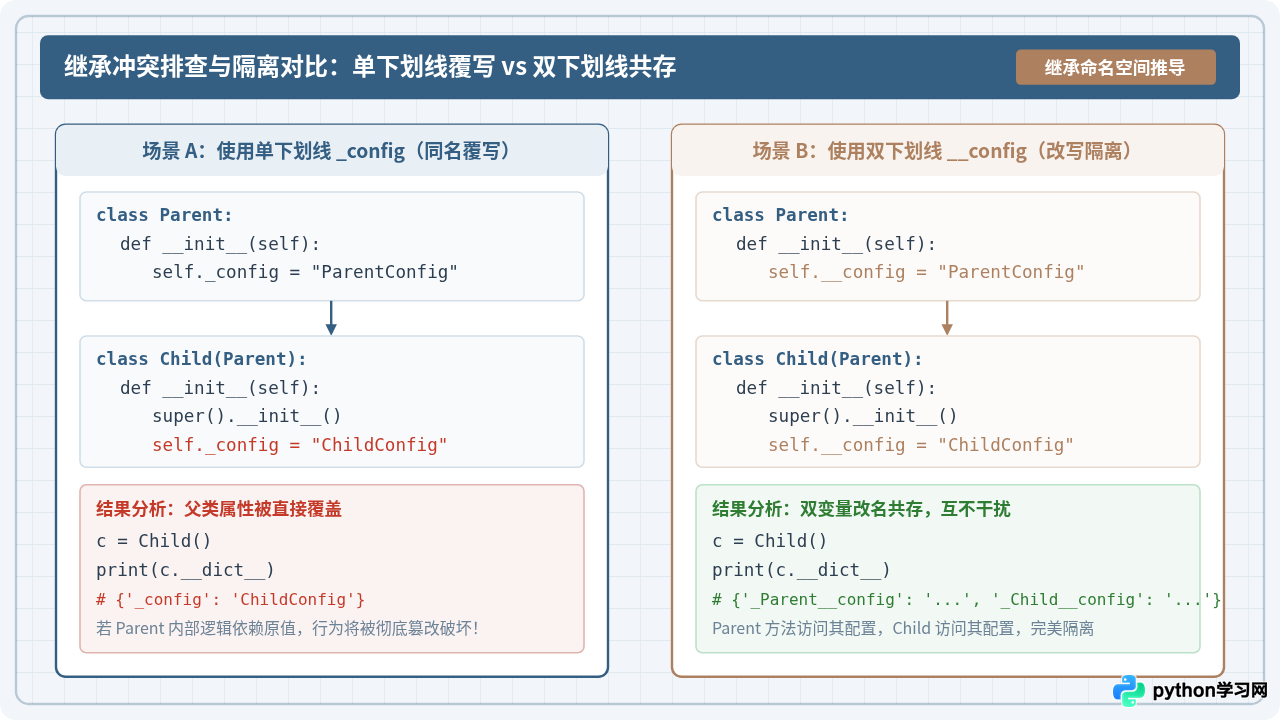
3.1 单下划线在继承中的表现:隐式覆写破坏
如果父类使用了单下划线变量 _state,子类在派生时不小心也定义了 _state,那么子类的赋值将直接覆盖父类的变量。如果父类的方法内部依赖该状态,系统就会产生隐蔽且难以排查的 Bug:
class Engine:
    def __init__(self):
        self._status = "IDLE"

    def start(self):
        self._status = "RUNNING"
        print(f"Engine 状态更新为: {self._status}")

class Car(Engine):
    def __init__(self):
        super().__init__()
        self._status = "PARKED"  # 意外覆盖了父类的 self._status

car = Car()
print(car._status)  # 输出: PARKED
car.start()         # 破坏了 Car 原有的 PARKED 语义,两者共用同一个键
print(car._status)  # 输出: RUNNING
3.2 双下划线在继承中的表现:类名前缀隔离
如果将上述属性改用双下划线 __status,由于解释器分别将它们改写为 _Engine__status 和 _Car__status,两个变量在内存字典中完全独立共存,互不干扰:
class Engine:
    def __init__(self):
        self.__status = "IDLE"  # 改写为: _Engine__status

    def start(self):
        self.__status = "RUNNING"
        print(f"Engine 内部识别状态: {self.__status}")

class Car(Engine):
    def __init__(self):
        super().__init__()
        self.__status = "PARKED"  # 改写为: _Car__status

    def inspect(self):
        print(f"Car 内部识别状态: {self.__status}")

car = Car()
car.start()    # 示例输出: Engine 内部识别状态: RUNNING
car.inspect()  # 示例输出: Car 内部识别状态: PARKED

# 查看底层字典,两个属性各自安好:
print(car.__dict__)
# {'_Engine__status': 'RUNNING', '_Car__status': 'PARKED'}
四、其它容易混淆的下划线形态辨析
在实际编码中,除了单前导与双前导下划线,Python 还存在以下几种常见的下划线用法:
| 形态分类 | 典型示例 | 机制类型 | 使用目的与技术要点 |
|---|---|---|---|
| 单下划线开头 | _variable |
约定规范 | 标记内部使用;阻止 from m import * 导入;子类可自由覆写。 |
| 双下划线开头 | __variable |
语法机制 | 触发名称改写(_Class__var);防止深继承子类命名冲突。 |
| 单下划线结尾 | class_, id_ |
命名避让 | 避免与 Python 内置关键字(如 class, def, type)重名。 |
| 双下划线首尾 | __init__, __len__ |
系统保留 | Python 官方保留的魔术方法或特殊属性,开发者切勿发明自己的 __custom__。 |
| 独立单下划线 | _ |
语义占位 | 表示临时、抛弃型无用变量(如 for _ in range(10)),或交互环境上一计算结果。 |
五、工程实践决策树与选型建议
在日常开发与架构设计中,面对变量与方法的命名选择,可以通过以下决策流快速判断:
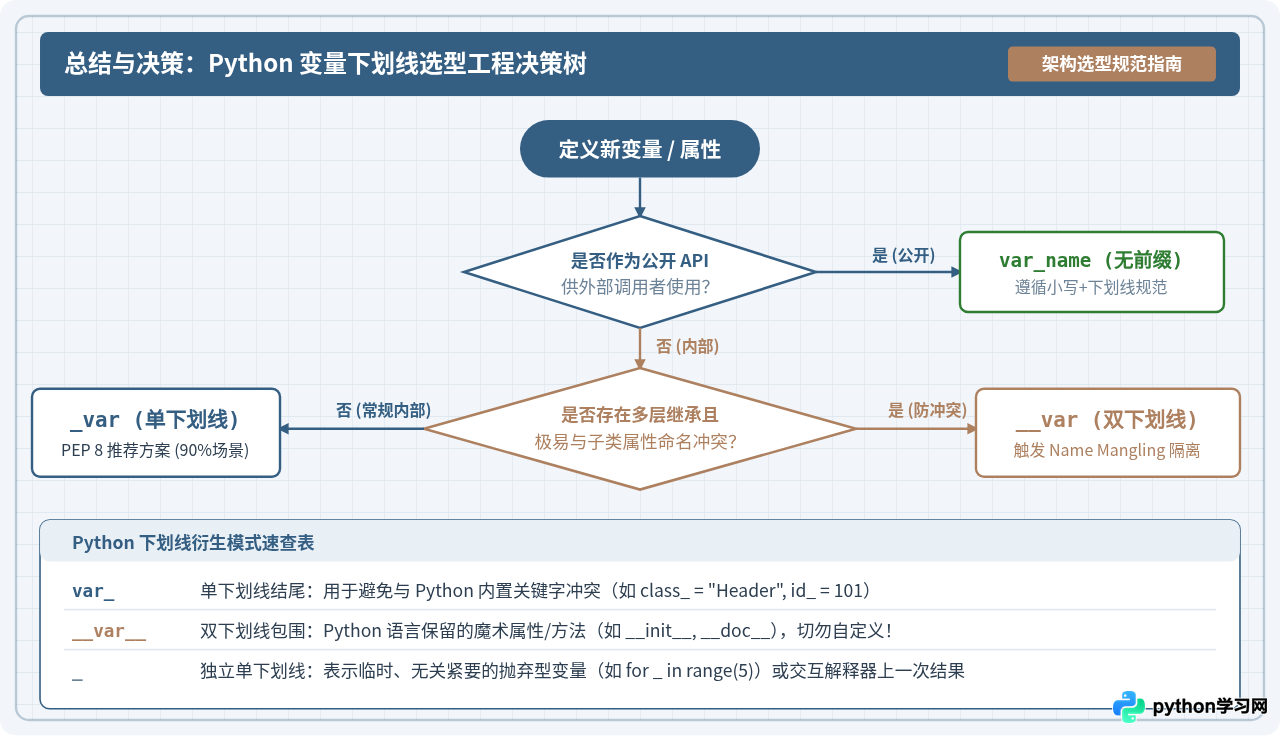
5.1 选型实用原则
- 默认优先选择单下划线
_var:对于类内部的辅助函数、缓存属性、中间状态,95% 以上的场景都应使用单下划线。它既明确告知外部调用者“不要直接依赖”,又保持了代码的清晰与反射灵活性,调试时变量名直观可见。 - 谨慎且克制地使用双下划线
__var:只有在编写可能被深层派生、公开给未知第三方扩展的底层基类库(如大型框架的核心基类)时,且该属性一旦被子类覆盖就会导致系统崩溃时,才考虑使用双下划线。 - 切勿将双下划线用于“安全保密”:如果业务需要防止敏感信息(如密码、私钥)泄露,应通过凭据管理服务、加密哈希或只读属性(
@property)等机制进行控制,依赖名称改写是无法阻挡外部读取的。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















