


Python3中np.matrix已废弃,怎么迁移到np.ndarray

针对Python3中NumPy弃用np.matrix的现状,详细讲解向标准的二维np.ndarray平滑迁移的操作步骤、语法替代对照、行为差异排查及完整验证方法。
NumPy 官方已正式明确不建议在任何新代码中使用 numpy.matrix,并建议现存项目全量迁移至标准的 numpy.ndarray。迁移的核心方案非常清晰:用常规二维数组构造代替矩阵类型,将原本依靠 * 进行的矩阵乘法替换为 Python 3.5 引入的 @ 操作符,并用 .T、np.linalg.inv() 等标准函数接管特殊属性。本文提供完整的语法对照表、改造执行步骤与隐藏降维陷阱的排查方法。
为什么必须弃用 np.matrix
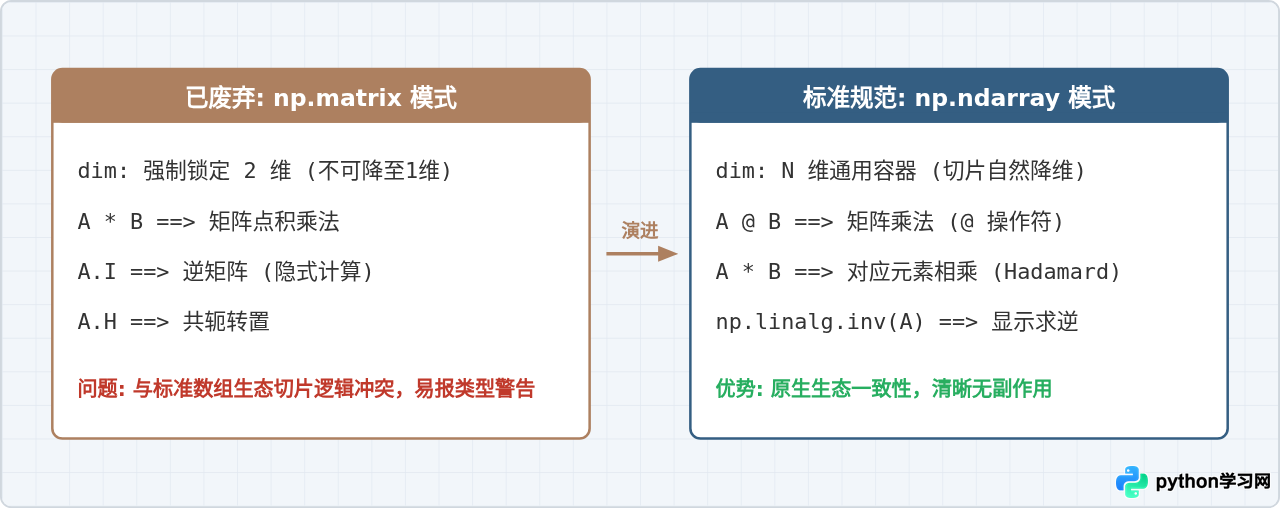
np.matrix 是早期为了方便从 MATLAB 转入 Python 的用户而设计的特殊子类。它强制保持二维形态,并将运算符 * 重写为矩阵乘法(点积)。然而,现代科学计算生态的绝大多数库(如 SciPy、PyTorch、Pandas、TensorFlow、Scikit-learn)都基于通用的多维容器 np.ndarray 构建。
混用 np.matrix 和 np.ndarray 会引发严重的行为割裂。例如,切片取出一行或一列时,ndarray 会降为一维向量,而 np.matrix 仍顽固保持二维,这直接破坏了下游算法库对输入维度的通用假设。此外,Python 3.5 原生支持了矩阵乘法运算符 @,使得保持 np.matrix 存在的语法便利性不复存在。
核心语法与操作替代对照表
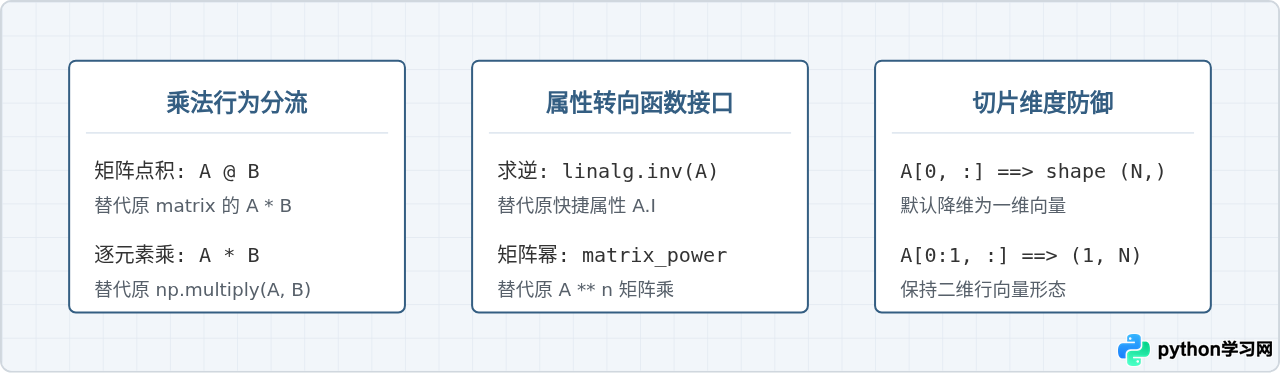
迁移时并不需要推倒既有数学逻辑,只需要按映射规则完成代码语句替换。以下是开发中最常见的写法对照:
| 操作目标 | 旧语法 (np.matrix) | 新语法 (np.ndarray) | 关键说明 |
|---|---|---|---|
| 创建矩阵 | np.matrix([[1, 2], [3, 4]])或 np.mat('1 2; 3 4') |
np.array([[1, 2], [3, 4]]) |
停用 MATLAB 风格的字符串解析方式,改用标准列表构造。 |
| 矩阵乘法 | A * B |
A @ B 或 np.matmul(A, B) |
ndarray 中 * 表示逐元素相乘,@ 才是点积矩阵乘法。 |
| 元素对应相乘 | np.multiply(A, B) |
A * B |
ndarray 默认就是逐元素运算(Hadamard积)。 |
| 转置 | A.T |
A.T |
两者保持一致,但在 1D 数组上 .T 不改变形状。 |
| 逆矩阵 | A.I |
np.linalg.inv(A) |
ndarray 没有 .I 快捷属性,须调用线性代数模块。 |
| 共轭转置 | A.H |
A.conj().T |
实数矩阵等同于 A.T;复数时需结合 .conj()。 |
| 指数幂运算 | A ** 2 (矩阵自身点乘二次) |
np.linalg.matrix_power(A, 2) |
ndarray 的 A ** 2 表示对每个元素平方。 |
项目改造的四个执行步骤
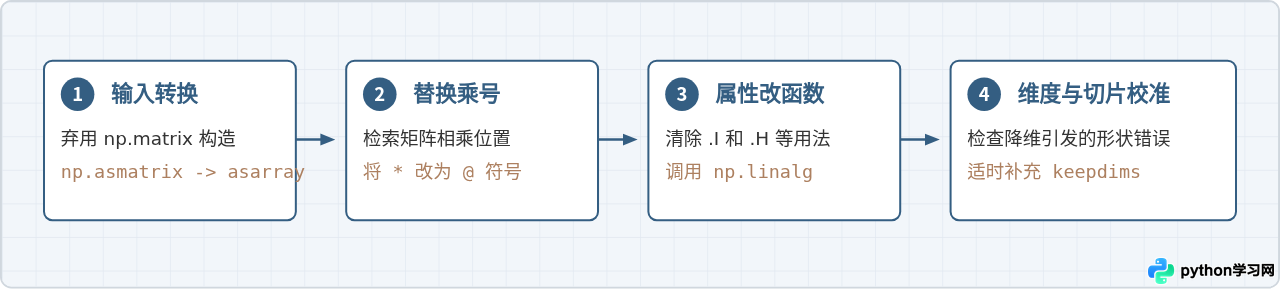
为了避免在重构过程中引发连锁错误,建议按照“类型安全转换、运算符修正、函数补全、维度校对”四步流程有序改造。
步骤一:清洗输入与初始化代码
排查所有使用了 np.matrix()、np.mat() 以及 np.asmatrix() 的地方。如果函数接收外部传入的未知数组类型,不要再调用 np.asmatrix() 做强制转换,而应使用 np.asarray() 确保它是标准数组。
# 改造前
m = np.matrix([[1.0, 2.0], [3.0, 4.0]])
safe_input = np.asmatrix(data)

# 改造后
m = np.array([[1.0, 2.0], [3.0, 4.0]])
safe_input = np.asarray(data)
步骤二:精确转换乘法符号
这是迁移中最关键也最容易出错的一步。在原代码中,两个 np.matrix 相乘用的全是 *。在全面改用 np.ndarray 后:
- 所有的矩阵点积乘法(行乘列),必须将
*逐一换成@。 - 原本为了避开矩阵乘法而特别写的
np.multiply(A, B),现在可以直接简化为A * B。
步骤三:替换特殊快捷属性
np.ndarray 没有内置诸如 .I(求逆)这类针对方阵的专用属性。搜索项目中所有的 .I,改用标准库 np.linalg.inv();如果有复数矩阵使用了 .H,改写为 A.conj().T。
步骤四:排查一维降维(常见陷阱)
np.matrix 无论怎么切片取数,其 shape 始终保持 (1, N) 或 (N, 1) 的二维状态。但是 np.ndarray 在单行切片时会默认降为 (N,) 的一维向量。如果后续代码严格依赖二维结构(比如需要与列向量进行广播运算),就必须主动保留维度:
arr = np.array([[10, 20, 30], [40, 50, 60]])

# 方式 A:常规单索引切片,得到一维数组
row_1d = arr[0, :]      # shape 是 (3,)

# 方式 B:范围切片,保留二维形态(等价于 matrix 行为)
row_2d = arr[0:1, :]    # shape 是 (1, 3)

# 方式 C:使用 np.newaxis 显式升维
row_col = arr[0, :, np.newaxis] # shape 是 (3, 1)ndarray 沿某个轴进行 np.sum(arr, axis=0) 计算时,默认也会降维成一维。如果你需要维持原本 np.matrix.sum() 产出的二维行向量,请在调用时显式指定参数 keepdims=True,即 np.sum(arr, axis=0, keepdims=True)。
完整对比重构示例
下面是一个常见的数学运算场景(定义特征矩阵、计算矩阵逆、线性方程组变换并统计列均值),展示了改造前后的完整代码映射。
重构前代码(基于已废弃的 np.matrix)
import numpy as np

# 1. 构造矩阵 (2x2 方阵 与 2x1 列向量)
A = np.matrix([[3.0, 1.0], [1.0, 2.0]])
B = np.matrix([[9.0], [8.0]])

# 2. 运算:利用 .I 求逆,利用 * 进行矩阵乘法求解 X = A^(-1) * B
X = A.I * B

# 3. 统计结果均值 (得到仍为 1x1 的 matrix 对象)
col_mean = X.mean(axis=0)

print("解 X:\n", X)
print("X 的 shape:", X.shape)
print("列均值:", col_mean)
重构后代码(符合规范的 np.ndarray 方案)
import numpy as np

# 1. 使用标准 ndarray 构造
A = np.array([[3.0, 1.0], [1.0, 2.0]])
B = np.array([[9.0], [8.0]])

# 2. 调用 linalg.inv 计算逆矩阵,使用 @ 操作符做矩阵点乘
X = np.linalg.inv(A) @ B

# 3. 求解统计量时,通过 keepdims=True 维持输出为二维形态
col_mean = X.mean(axis=0, keepdims=True)

print("解 X:\n", X)
print("X 的 shape:", X.shape)
print("列均值:", col_mean)运行结果说明:两段代码计算得出的数值完全相同(X 为 [[2.], [3.]]),但第二段代码产出的是标准 np.ndarray,不仅完全消除了 NumPy 运行时的废弃警示(PendingDeprecationWarning),而且可以直接无缝传给 PyTorch、TensorFlow 等深度学习框架或 Pandas 进行后续分析。对于线性方程组求解,更高效稳健的做法是直接调用 np.linalg.solve(A, B),连显式求逆都可以省去。
改造后验证与总结
完成代码重构后,请通过以下两步验证迁移质量:
- 断言类型:对关键输出执行
assert type(res) is np.ndarray,确保代码中没有漏网的np.matrix。 - 形状验证:在调用了切片、求和或广播运算的下游代码处打印
.shape,验证结果是否因一维降维导致了意外的形状广播(例如期望两个二维向量相加,却由于一维降维变成了标量外积广播)。
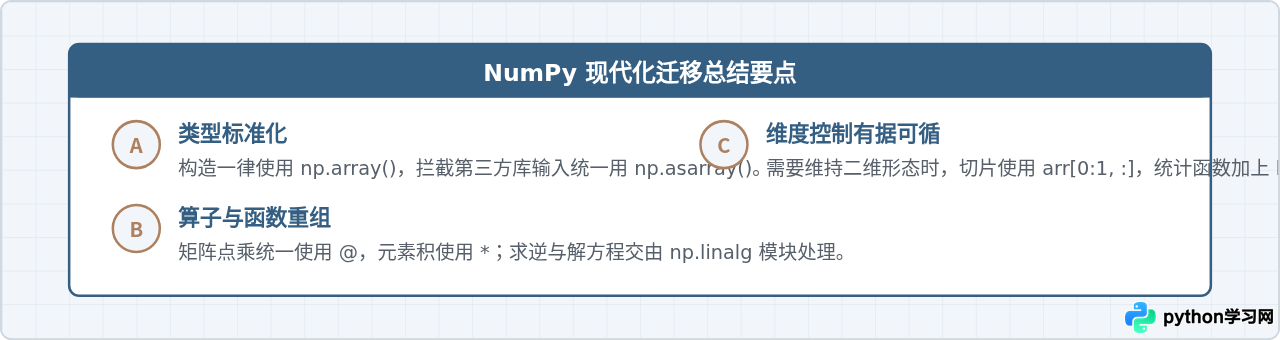
将代码从 np.matrix 迁移到 np.ndarray 虽是一项破坏性改动,但整体重构逻辑非常直观。依托 Python 3 的 @ 符号支持与 NumPy 丰富的线性代数子模块,重构后的代码能消除语法隐患,并完美适配现代 Python 科学计算的标准生态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















