


写Python爬虫会违法吗?robots.txt协议与数据采集法律边界

深入解析编写Python爬虫的法律边界、技术合规要点,详解robots.txt协议的约束力与解析方法,以及合法采集中断与防护红线。
单纯编写和运行 Python 爬虫代码本身并不违法,技术本身是中立的;真正决定行为是否触犯法律的,是你“爬取了什么数据”、“采用了什么技术手段”以及“将抓取的数据用于什么目的”。本文将围绕数据抓取的红线、robots.txt 协议的实际效力、合规采集的技术实现以及风险判断方法,做一次系统、具体的梳理。
一、爬虫违法的判定核心:技术中立与行为边界
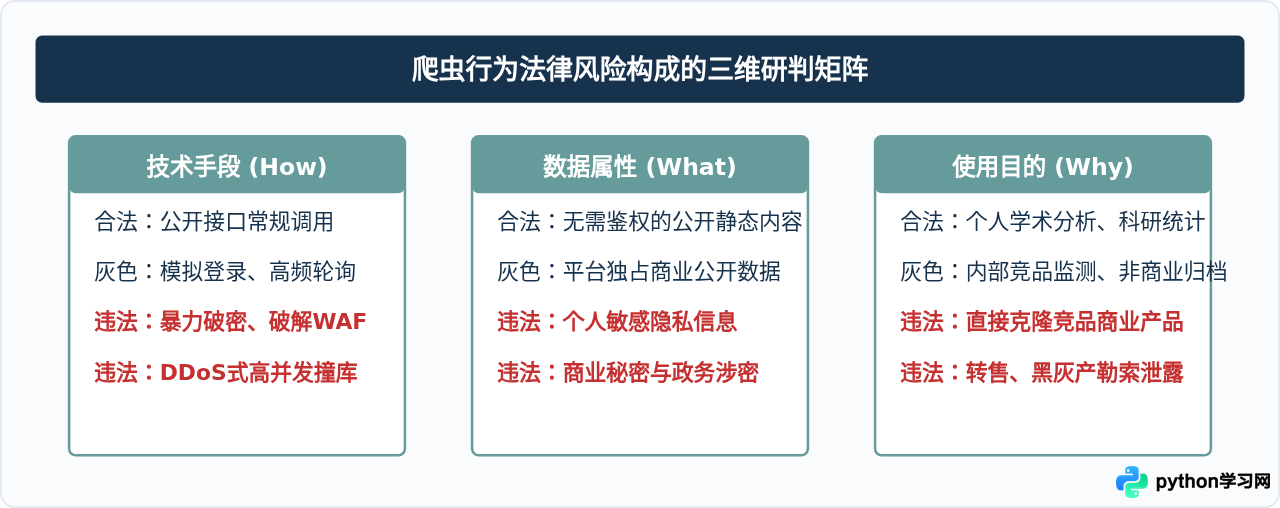
搜索引擎的检索机制(例如百度、Google、必应)本质上都是超大规模的网络爬虫。如果“写爬虫”本身违法,现代互联网的信息索引将不复存在。但在实际工程开发中,开发者因爬虫获罪或承担民事赔偿的案件屡见不鲜,核心原因在于越过了以下三道底线:
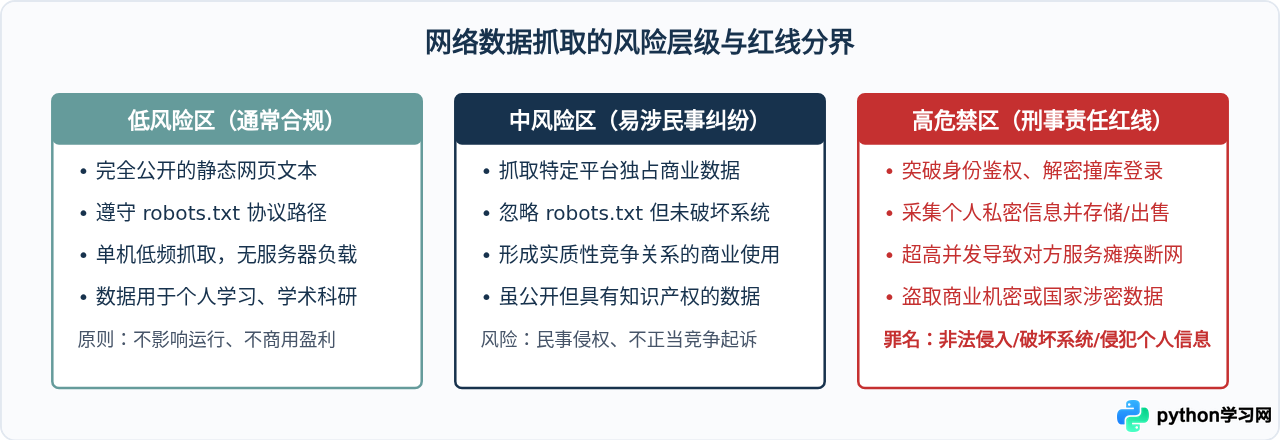
- 破坏计算机信息系统:高并发、无节制的抓取导致目标网站服务器过载、服务瘫痪,可能触犯刑法中的“破坏计算机信息系统罪”。
- 非法侵入与避开安全措施:强行绕过验证码、逆向解密签名机制、盗用他人授权 Token 或 Session 越权提取未公开数据,可能触犯“非法获取计算机信息系统数据罪”。
- 侵犯知识产权与商业秘密:抓取具有独创性的内容、用户评论集合或商业付费数据库,并在未经授权的情况下打包转售或用于直接竞品运营,构成不正当竞争或著作权侵权。
- 侵犯公民个人信息:未经授权采集用户真实姓名、手机号、家庭住址、身份证号、面部特征等敏感隐私数据,极易触犯“侵犯公民个人信息罪”。
二、深入理解 robots.txt:技术契约还是法律契约?
robots.txt(机器人排除协议)是网站存放在其根目录下的纯文本文件,用于指示网络爬虫哪些页面可以抓取,哪些路径禁止访问。
在技术层面上,robots.txt 没有任何强制拦截能力。它不是防火墙,也不包含任何阻断流量的代码,完全依赖爬虫程序自觉读取并解析执行。
在法律层面上,robots.txt 本身不是成文法,但违反它会成为法庭认定“主观恶意”与“不正当竞争”的核心事实证据。在司法实践中(例如早期的“百度诉360爬虫案”),法院认定 robots.txt 是互联网行业公认的商业道德准则。如果网站在 robots.txt 中明确禁止特定爬虫访问,而爬虫通过伪造 User-Agent 强行抓取,法院通常会据此判定抓取方具有主观过错,违反《反不正当竞争法》中的商业诚信原则。
robots.txt 的标准语法结构
# 允许所有正常爬虫访问除 /private/ 和 /api/ 以外的所有资源
User-agent: *
Disallow: /private/
Disallow: /api/
Allow: /api/public-docs/

# 单独禁止名为 BadBot 的爬虫访问任何内容
User-agent: BadBot
Disallow: /

# 指定抓取延迟为 2 秒
Crawl-delay: 2

# 提供网站地图地址
Sitemap: https://example.com/sitemap.xml
三、在 Python 中正确解析 robots.txt 的标准操作
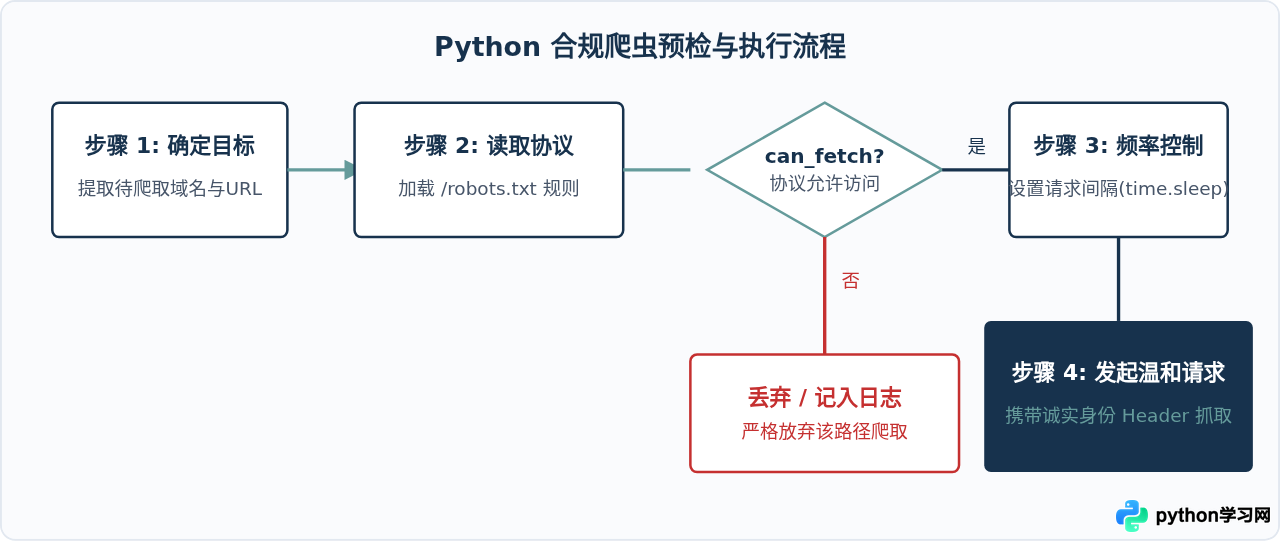
编写工业级或严谨学术爬虫时,不应主观臆测路径是否公开,程序启动时先读取目标域名的 robots.txt 并完成路径权限校验,是合规采集的标准流程。
Python 标准库内置了 urllib.robotparser 模块,无需额外安装第三方库即可完成解析工作。
操作步骤:利用 RobotFileParser 验证采集 URL
- 实例化
RobotFileParser对象。 - 通过
set_url()指定目标站点的robots.txt地址。 - 调用
read()方法读取并解析规则(内部处理网络请求与语法拆解)。 - 在发送真实抓取请求前,调用
can_fetch(user_agent, target_url)判断当前请求是否合规。
完整示例代码:Python 协议校验与请求执行
import urllib.robotparser
import urllib.parse
import time
import requests

def check_and_crawl(target_url: str, custom_user_agent: str = "MyResearchBot/1.0"):
    # 1. 解析目标 URL 的协议与域名
    parsed = urllib.parse.urlparse(target_url)
    base_url = f"{parsed.scheme}://{parsed.netloc}"
    robots_url = f"{base_url}/robots.txt"

    # 2. 读取并解析 robots.txt
    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)
    try:
        rp.read()
    except Exception as e:
        print(f"无法读取 robots.txt ({e}),按照保守原则审慎抓取。")
        return

    # 3. 校验权限
    can_fetch = rp.can_fetch(custom_user_agent, target_url)
    print(f"检查 URL: {target_url}")
    print(f"User-Agent [{custom_user_agent}] 抓取权限: {'[允许]' if can_fetch else '[禁止]'}")

    if not can_fetch:
        print("根据目标站点 robots.txt 协议,该路径被显式禁止,程序终止该任务。")
        return

    # 4. 获取爬取延迟要求(如果声明了 Crawl-delay)
    delay = rp.crawl_delay(custom_user_agent)
    if delay:
        print(f"站点要求抓取延迟: {delay} 秒")
        time.sleep(delay)
    else:
        # 即使未指定,也应设置 1-2 秒的默认保护延迟
        time.sleep(1.0)

    # 5. 执行真实采集
    headers = {
        "User-Agent": f"{custom_user_agent} (+https://example.com/bot-info)"
    }
    response = requests.get(target_url, headers=headers, timeout=10)
    print(f"采集完成,状态码: {response.status_code},获取字节数: {len(response.content)}")

if __name__ == "__main__":
    # 示例:检测公开路径
    test_target = "https://www.python.org/blogs/"
check_and_crawl(test_target)User-Agent 伪装成桌面版 Chrome 浏览器。如果是个人学习抓取公开页面,这通常不会引起麻烦;但如果是自动化、长周期的采集任务,伪装客户端不仅破坏了 robots.txt 的辨别机制,在面临法律纠纷时还会直接削弱“技术中立”的抗辩说服力。
四、避开法律风险的四个技术规范
要让你的 Python 爬虫安全运行在法律红线之内,代码中需要落实以下四项技术防范:
| 控制维度 | 危险操作(易引发纠纷/违法) | 合规安全实践 |
|---|---|---|
| 访问频次 | 并发几十上百线程、无 sleep、轮询重试造成服务端高负载 | 单 IP 严格限速(如每秒不超过 1 次),优先遵循 Crawl-delay |
| 身份认证 | 逆向解密登录签名、撞库扫号、盗用他人 Session 或授权 Token | 只爬取游客态或开放公开内容,需要登录的数据严格使用官方 API 授权 |
| 数据清洗 | 完整入库包含手机号、身份证号、私人通信记录等敏感字段 | 本地管道即时丢弃个人敏感字段,进行哈希脱敏或匿名化处理 |
| 反爬对抗 | 购买代理池暴力对抗 WAF、自动化打码平台强行破除滑块验证 | 遇到明确的 403 阻断或验证码,及时终止流程,不强行实施攻击性对抗 |
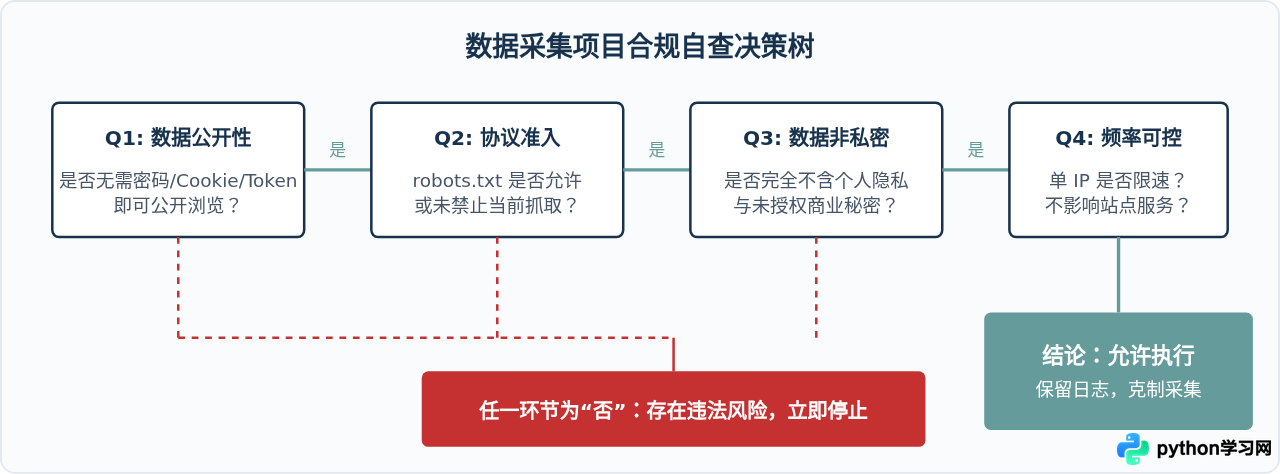
五、数据采集项目自查清单:四步合规验证
在正式启动任何 Python 数据采集脚本前,建议按照以下检查清单自审一遍。只要其中任意一项给出否定答案,都应立刻修正架构或终止项目:
结语
技术是工具,合规是保障。编写 Python 爬虫不是一种高危违法的原罪,但必须时刻牢记:不要抓取不属于公开范畴的数据,不要用攻击性手段突破安全机制,不要给目标服务器造成性能故障,不要将采集的数据用于破坏原作者或原平台的合法权益。在开发爬虫前先检查 robots.txt,将请求控制在低频合理的范围,不仅是工程师职业素养的体现,更是保护自己免受法律纠纷的最有效屏障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















