


做Python数据分析需要学SQL和统计学吗?辅助技能重要性分析
做Python数据分析是否必须掌握SQL与统计学?本文深入分析两项辅助技能在真实业务场景中的职责边界、协作链路与学习路径,给出明确的决策依据与掌握标准。
一、真实工作流中的角色定位
初学者常将“Python数据分析”理解为一个独立闭环:用Pandas读取本地CSV文件,清洗字符串与空值,绘制折线图并输出汇报。但实际企业业务中的数据并非整齐地存放在单台计算机的本地文件夹中,而是分散存储于生产数据库或数据仓库中。
在标准数据分析闭环中,从原始事实到决策依据通常要经过四个阶段,每一项技能在其中承担着不可互相替代的分工:
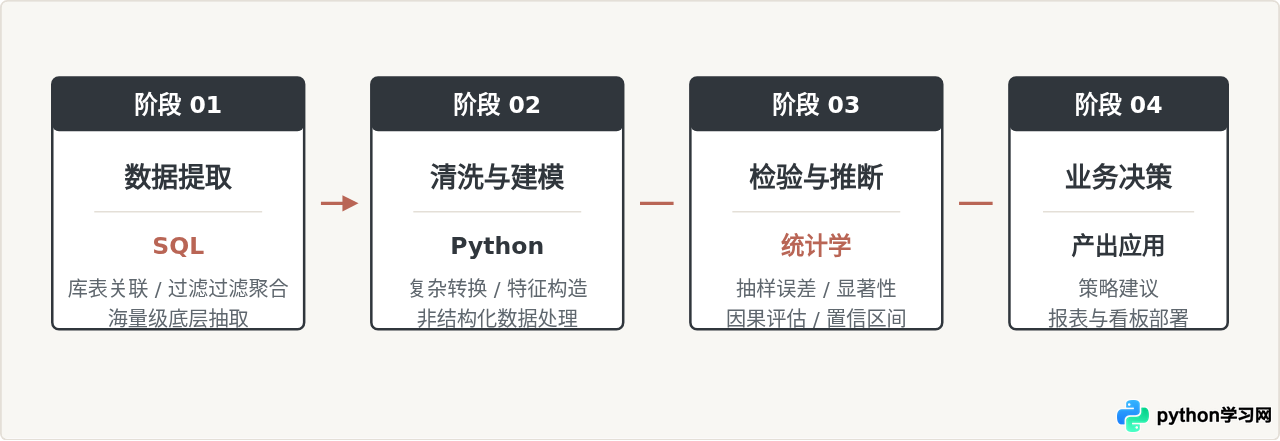
如果把Python看作承载多维分析计算的机体,SQL就是获取原料的抓手,而统计学是辨别结论真伪的校准仪。单纯掌握Python语法,只是拥有了计算工具,并不代表具备完整解决分析问题的能力。
二、SQL:为什么Pandas不能完全替代它?
许多初学者容易产生疑问:既然Pandas拥有强大的 merge()、groupby() 和 query() 函数,能够完成SQL所有的数据过滤和连接操作,为什么还要单独学SQL?
核心原因在于计算发生的位置与内存瓶颈。Pandas依赖本地RAM(内存),当单表达到数千万行甚至上亿行时,将其全部下载至本地内存会导致内存溢出(OOM)。企业级数据库则依靠分布式计算节点或针对磁盘I/O高度优化的查询引擎来处理这些海量数据。
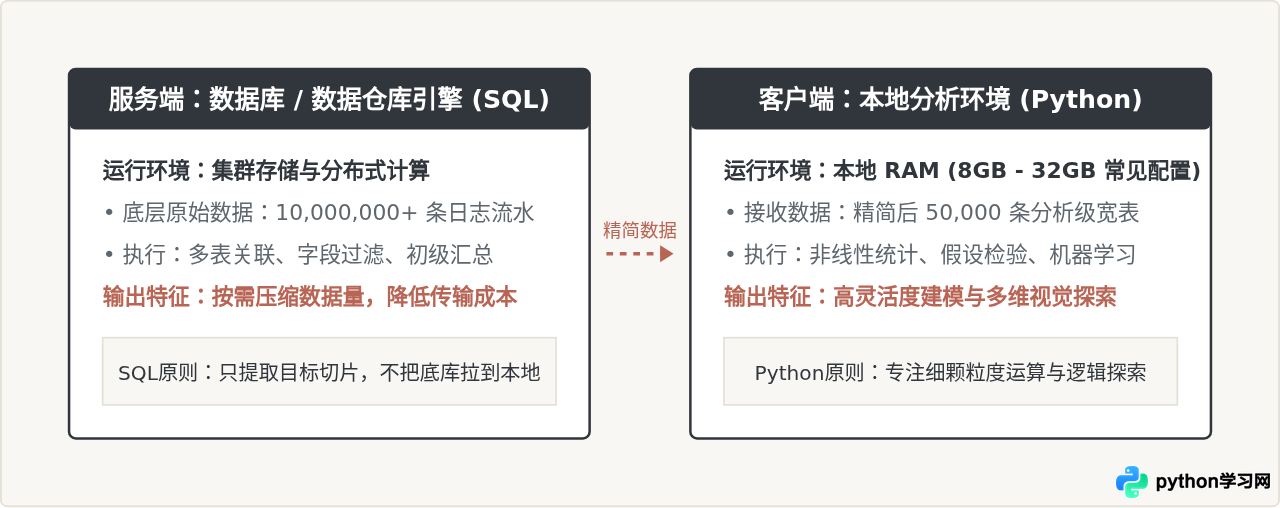
来看一个标准协作代码片段。分析师通常先用SQL在服务端聚合出高质量切片,再交由Python承接深入计算:
import pandas as pd
from sqlalchemy import create_engine

# 1. 建立数据库连接(连接服务端引擎)
engine = create_engine('postgresql://user:password@hostname:5432/analytics_db')

# 2. 在服务端完成初步关联、聚合与过滤
sql_query = """
SELECT
    user_id,
    DATE(order_time) AS order_date,
    COUNT(order_id) AS total_orders,
    SUM(pay_amount) AS total_spent
FROM orders
WHERE order_time >= '2026-01-01'
GROUP BY user_id, DATE(order_time)
HAVING SUM(pay_amount) > 0;
"""

# 3. 将经计算后的结构化数据接入Pandas内存
df = pd.read_sql(sql_query, con=engine)

# 4. 在本地环境进行复合指标计算与概率分布建模
df['avg_order_value'] = df['total_spent'] / df['total_orders']
print(df.describe())
SELECT * FROM orders 之后直接 pd.read_sql() 加载全表的操作。这会在消耗网络吞吐的同时,极易导致分析终端内存溢出崩溃。SQL的基本功底直接影响到提取效率。
三、统计学:防止用代码产出错误结论
如果说SQL解决的是“数据能不能顺利取出来”的问题,统计学解决的就是“得出的结论是否可信”的问题。
在缺乏统计常识的情况下,即使代码编写完全无误,也极易做出误导业务决策的虚假分析:
- 均值陷阱:业务群体的收入、客单价往往呈现右偏分布。直接调用
df['amount'].mean()会被极少数极高消费拉高均值,掩盖绝大多数普通用户的真实消费水平。此时必须使用中位数(Median)与分位数(IQR)评估主体特征。 - 混杂因素与辛普森悖论:在两个维度分组分别对比时,A组转化率均高于B组;但将数据整体合并后,B组转化率反而高于A组。缺乏统计学变量控制意识,会导致归因彻底倒置。
- 假性相关:两个变量的皮尔逊相关系数高达0.9,并不代表存在因果联系。如果没有设计控制实验或掌握基础的回归控制方法,分析产出的策略往往劳而无功。
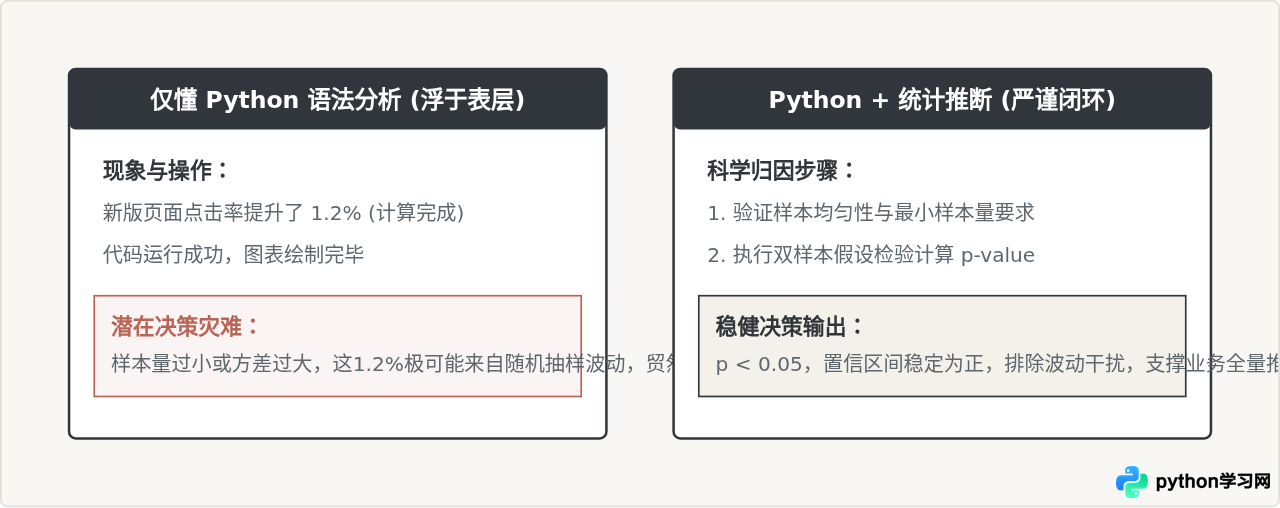
下面的代码展示了统计学概念如何直接介入代码落地。仅靠观察均值无法判断A/B测试方案是否有实质改善,必须通过双样本独立T检验来确认其统计显著性:
import numpy as np
from scipy import stats

# 模拟对照组(A)与实验组(B)的人均停留时长数据(秒)
np.random.seed(42)
group_a = np.random.normal(loc=120, scale=30, size=200) # 均值120
group_b = np.random.normal(loc=125, scale=32, size=200) # 表面均值略高5秒

# 计算均值
mean_a, mean_b = np.mean(group_a), np.mean(group_b)
print(f"对照组均值: {mean_a:.2f}, 实验组均值: {mean_b:.2f}")

# 执行双样本假设检验
t_stat, p_value = stats.ttest_ind(group_a, group_b)
print(f"t统计量: {t_stat:.4f}, p值: {p_value:.4f}")

# 判定统计显著性
alpha = 0.05
if p_value < alpha:
    print("拒绝原假设:两组差异具有统计学显著性,改进有效。")
else:
    print("无法拒绝原假设:差异大概率由随机波动造成,不能断言新方案更优。")
示例输出:
对照组均值: 119.53, 实验组均值: 125.10
t统计量: -1.7946, p值: 0.0735
无法拒绝原假设:差异大概率由随机波动造成,不能断言新方案更优。
如果只看表面数字,实验组增加了5.57秒;但统计推断显示p值为0.0735(高于0.05常用阈值),说明这种涨幅有超过7%的概率纯属随机抽样波动。这就是统计学对于避免错误决策的核心意义。
四、不同业务导向下的技能需求差异
并非所有从事数据分析的人都需要学到相同深度的SQL与统计学。不同工作定位对这三项技能的倾斜程度存在显著分化:
| 分析岗位定位 | SQL 重要程度 | 统计学 重要程度 | Python 主要承担职责 |
|---|---|---|---|
| 商业/业务分析师 (运营/销售/财务方向) |
极高 (必须熟练) 日常取数、临时报表、多维拆解 |
中等 (理解核心) 指标偏态、假设检验、同比环比口径 |
自动化周报、复杂指标合并、数据可视化 |
| 产品/增长数据分析师 (App/Web策略方向) |
极高 (精通) 埋点解析、漏斗转化、用户流失归因 |
高 (熟练运用) A/B测试设计、置信区间、因果推断 |
实验数据清洗、因果评估、留存率深度分析 |
| 数据科学/算法工程师 (建模预测方向) |
中高 (熟练) 特征工程抽取、宽表产出 |
极高 (精通) 概率分布、多元回归、假设检验、矩阵运算 |
模型构建、特征工程、超参数优化与工程部署 |
| 非IT通用职能分析 (办公提效场景) |
低 (基本不需要) 依赖业务系统导出Excel/CSV |
低 (描述统计即可) 均值、总和、占比分布 |
替代VBA处理跨工作簿合并与报表自动化 |
五、循序渐进的学习路径规划
在学习资源和时间有限的情况下,试图同时全面掌握Python生态、深度SQL开发以及高等统计学往往会导致挫败。更合理的做法是按照业务使用的真实紧迫度,分阶段建立协同能力:
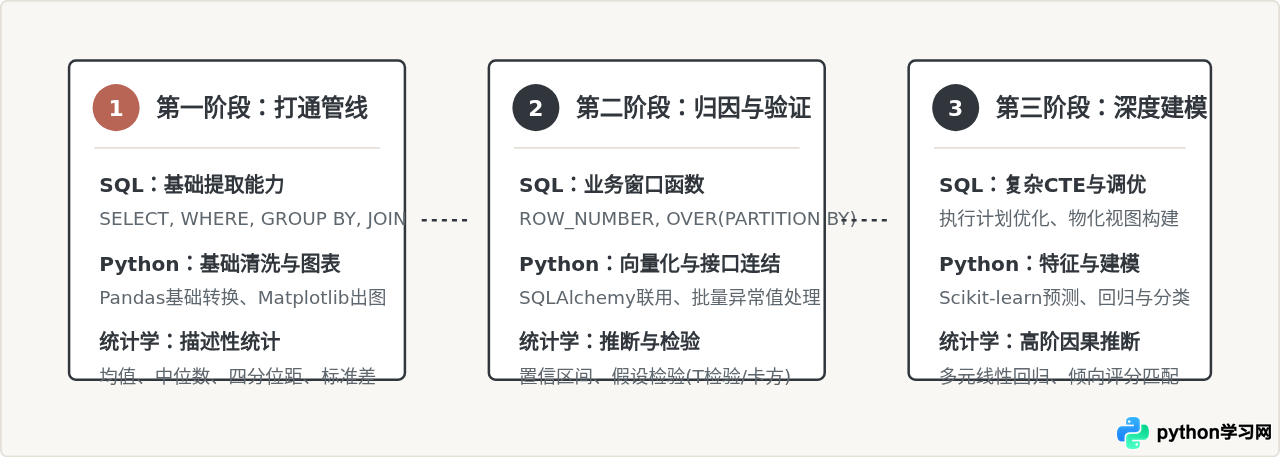
1. 入门阶段:先跑通数据流
在起步阶段,不要一头扎进概率论公式推导或数据库死锁调优中。此时的目标是把“提取-处理-展示”串联起来:
- SQL重点:掌握四类基本句式(
SELECT、WHERE、GROUP BY、JOIN),能够从两三张关联表中筛选并聚合出你所需要的表格。 - Python重点:掌握
pandas.DataFrame的增删改查、缺失值处理(fillna/dropna)以及基础可视化库(Seaborn或Matplotlib)。 - 统计学重点:理解描述性统计量,知道什么时候用平均数、什么时候必须用中位数,理解标准差所代表的波动幅度。
2. 进阶阶段:掌握归因与验证工具
当日常工作开始涉及策略评估、A/B测试或用户行为追踪时,必须补充推断统计能力和进阶SQL技巧:
- SQL重点:窗口函数(
ROW_NUMBER()、LEAD()、LAG())用于计算留存、环比、分组Top N等高频业务场景。 - 统计学重点:掌握两样本T检验、卡方检验(针对分类变量转化率)、置信区间概念,确保你所下的“方案A好于方案B”这一判断具有可验证的数学依据。
- Python重点:利用
scipy.stats库实现自动化统计检验脚本,将检验过程嵌入到日常分析流中。
六、总结与判断清单
回到最初的问题:做Python数据分析需要学SQL和统计学吗?
答案是必然的,但不必盲目求全。你可以用以下三条标准来检视当前的技能需求:
- 你需要从公司业务系统自主获取数据吗?只要数据不是他人整理好发给你的本地文件,SQL就是无法绕过的硬性门槛。
- 你的分析产出是否需要指导真实业务决策?如果结论涉及金钱投放、版本去留或策略上线,统计学是防止得出错误归因的安全网。
- 你的日常任务只是为了整理格式、做做自动化报表?如果只是提升办公效率,熟练掌握Python核心数据处理库即可,SQL和统计学可以作为后续储备。
在学习时,保持三者齐头并进但按需深入:用SQL在服务端精准拉取数据,用Python构建灵活的计算模型,用统计学规范逻辑与结论边界,这才是能够解决实际问题的数据分析知识体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















