


Python注释符号有哪些:单行#与多行三引号用法详解
详解Python中的注释符号与用法,涵盖单行井号(#)规范、多行连续井号、多行三引号字符串作为注释与文档字符串(Docstring)的核心机制差异与避坑指南。
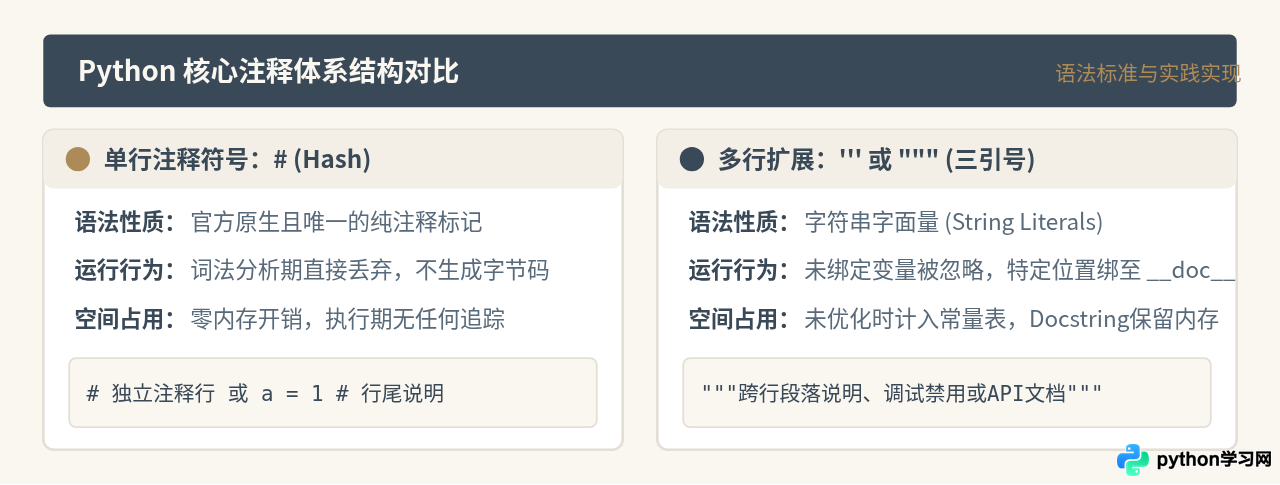
在Python中,用于表达注释的核心符号主要有两种:井号 # 和 成对的三引号(''' 或 """)。严格从语言语法定义来看,Python官方语法中真正的注释符号仅有 #;而三引号本质上是多行字符串字面量,当它不赋值给任何变量、独立存在于代码块中时,解析器会将其载入为常数或直接忽略,因此在工程实践中常被用作多行注释,并在函数、模块首部作为文档字符串(Docstring)。本文将具体拆解这两类符号的标准书写规范、底层运行差异及适用场景。
一、单行注释:井号(#)的基础与排版规范
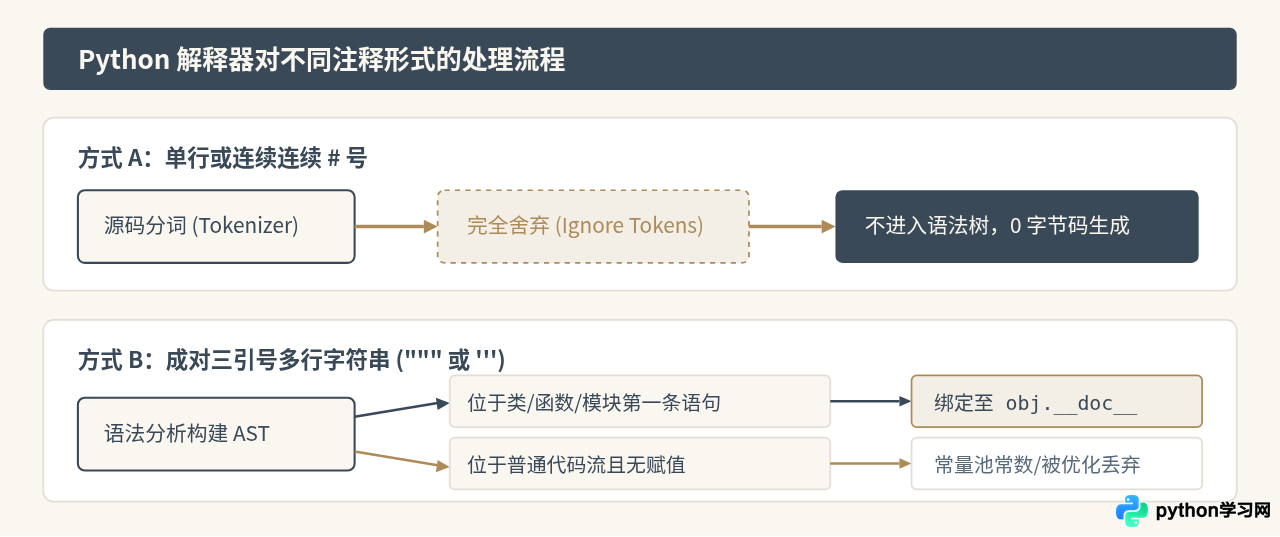
井号 # 是 Python 唯一的单行注释引导符。在代码中的任何非字符串内部位置,凡是遇到 #,从该符号开始直到该行物理结尾的所有字符,都会被 Python 解释器的分词器(Tokenizer)直接跳过,既不进行语法检查,也不编译生成任何字节码指令。
1. 独立行注释(Block Comments)
独立行注释用于给紧随其后的代码段落提供逻辑说明。根据官方风格指南 PEP 8 建议,# 后面应当留出一个半角空格,接着写注释文字;如果是缩进代码块内部的注释,应与该代码块保持相同的缩进深度。
# 计算订单总额,包含折扣与基础运费
base_price = 120.0
discount_rate = 0.85
shipping_fee = 10.0

if base_price > 100:
    # 满百免去基础运费
    shipping_fee = 0.0

total_cost = (base_price * discount_rate) + shipping_fee
2. 行尾注释(Inline Comments)
行尾注释位于单行代码语句的末端。PEP 8 推荐在语句结束与 # 之间保留至少 两个半角空格,并在 # 与文字说明之间保留 一个半角空格。行尾注释应当言简意赅,补充“为什么这样写”,而不是简单复述代码在做什么。
timeout = 5.0  # 容忍内网重连的最长时间(秒)
status_code = 204 # HTTP无内容响应,无需反序列化避坑点:如果 # 包含在用单引号或双引号括起来的字符串内部(如 url = "https://example.com/page#top"),此时 # 仅作为普通字符对待,并不具备注释功能。
二、多行注释实现方式:连续井号 vs 三引号
Python 语言设计者并没有专门提供类似于 C/Java 中的 /* ... */ 块注释符号。在实际开发中,需要多行说明时存在两种做法:连续多行使用 #,或者使用成对的单/双三引号(''' 或 """)。
1. 连续井号(推荐的标准多行注释方式)
根据 PEP 8 约定,针对大段代码逻辑的解释,首选方案是在每一行行首添加 #。目前主流编辑器(如 VS Code、PyCharm)均内置快捷键(Windows 下为 Ctrl + /,macOS 下为 Cmd + /),可以瞬间对选中的整段文本批量切换井号注释,编写与维护效率极高。
# ----------------------------------------------------
# 数据同步校验逻辑:
# 1. 确认本地缓存有效时间戳;
# 2. 对比远程服务器 ETag;
# 3. 仅在存在更新时拉取增量 JSON 报文并反序列化。
# ----------------------------------------------------
def check_sync_state(cache_timestamp, remote_etag):
    pass
2. 三引号作为普通多行注释
三引号由连续三个单引号 ''' 或连续三个双引号 """ 组成。当一段被三引号包裹的文本没有赋值给任何变量,且不是定义在模块、类或函数的首行时,解释器只会把它作为独立表达式语句求值,随后立即丢弃它。因此,开发者常借用这一机制来临时屏蔽大段测试代码或记录临时笔记。
x = 10
y = 20

"""
临时调试代码块:
由于近期上游接口调整,以下加权计算逻辑暂时停用,
等待对方输出字段契约确认后再行启用。
weighted_score = (x * 0.4) + (y * 0.6)
print("Debug Score:", weighted_score)
"""

final_val = x + y
三、三引号的核心使命:文档字符串(Docstring)
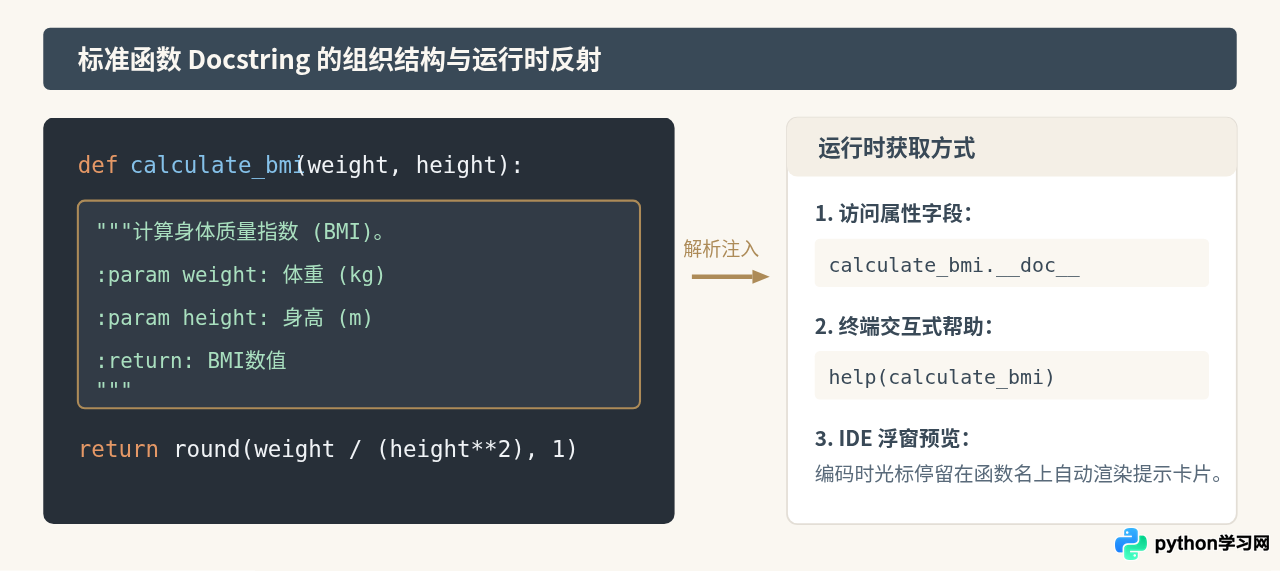
虽然三引号可用于多行屏蔽,但它在 Python 中的正式职责是编写 文档字符串(Docstring)。当三引号紧跟在模块、函数、类或方法的定义下方第一行时,Python 解析器会自动将其编译进目标对象的 __doc__ 特殊属性中,成为运行时可通过反射查看的帮助文档,并能被自动化文档工具(如 Sphinx、pydoc)直接抓取。
Docstring 实用编码规范(PEP 257 标准)
- 单行文档字符串:对于简短函数,三引号的起始符与结束符置于同一行,句尾保留句点。
def is_even(num: int) -> bool: """判断给定整数是否为偶数。""" return num % 2 == 0 - 多行文档字符串:首行编写简明的单行概括,随后空一行,再展开详细的参数、返回值及异常说明,结尾的三引号独占一行。
def connect_database(host: str, port: int = 5432) -> object:
    """初始化数据库连接会话。

    依据传入的主机与端口建立 TCP 套接字,内置 3 次重试。

    :param host: 数据库服务域名或IP地址。
    :param port: 监听端口号,默认为 5432。
    :return: 建立完成的底层连接对象。
    :raises ConnectionTimeoutError: 达到最大重试次数后仍然失败。
    """
    # 实际连接逻辑...
    pass
四、三引号作为注释时的潜在陷阱
用三引号替代 # 进行多行注释虽然输入方便,但因其本质仍是 Python 字符串对象,在语法边界和运行时存在以下三个隐性陷阱:
1. 缩进错误(IndentationError)
三引号无论作为字符串还是作为临时注释,都必须严格遵守 Python 的层级缩进规则。如果在代码块内部使用三引号,却将它的起始或结束符号顶格书写,将直接触发致命的语法错误:
def process_data(items):
    total = 0
# 错误示范:三引号未与当前代码块同级缩进,导致编译中断
"""
for item in items:
    total += item
"""
    return total
执行报错示例:
IndentationError: unexpected indent (或 unindent does not match any outer indentation level)使用 # 则宽松得多:即便 # 顶格写在函数内部,只要后续的代码缩进保持正确,解释器完全不会报错。
2. 内存与字节码损耗
在 Python 3 中,函数或代码块内部的未分配裸字符串会被 CPython 解释器的窥孔优化器(Peephole Optimizer)在一定程度上优化,但它在编译阶段仍会被记入常量表(co_consts)。而 # 在词法切词期就已被彻底抹掉,完全不参与抽象语法树(AST)构建与常量打包。
3. 内部包含转义符导致隐性警告
如果在三引号多行注释中包含形如正则表达式或 Windows 路径的字符(例如 """ C:\new_project\tools """),Python 解释器在编译此多行字符串时,会将 \n 识别为换行符,如果遇到非法的转义字符组合(如 \t 以外的未定义组合),在较新版本中会抛出 SyntaxWarning: invalid escape sequence。而 # 后面的任何字符序列都不会触发这类转义解析。
五、两种注释方式的场景决策
在不同工程场景下,选择 # 还是三引号可以依据下表进行快速权衡:
| 对比维度 | 单行 / 连续单行 # |
多行三引号 """ 或 ''' |
|---|---|---|
| 语法实质 | 真正的注释(纯语法糖) | 多行字符串字面量(Str Literal) |
| PEP 8 推荐度 | 所有非文档类的代码注释一律推荐 | 仅推荐作为 Docstring 使用 |
| 缩进敏感度 | 低(任意缩进深度均安全) | 高(必须严格匹配上下文层级) |
| 反射机制 | 不可读取(运行时不存在) | 位于定义首行时可通过 .__doc__ 提取 |
| 最适使用场景 | 行内解释、关键算法步骤、连续排查屏蔽 | API使用说明、函数参数说明、编写长篇模块文档 |
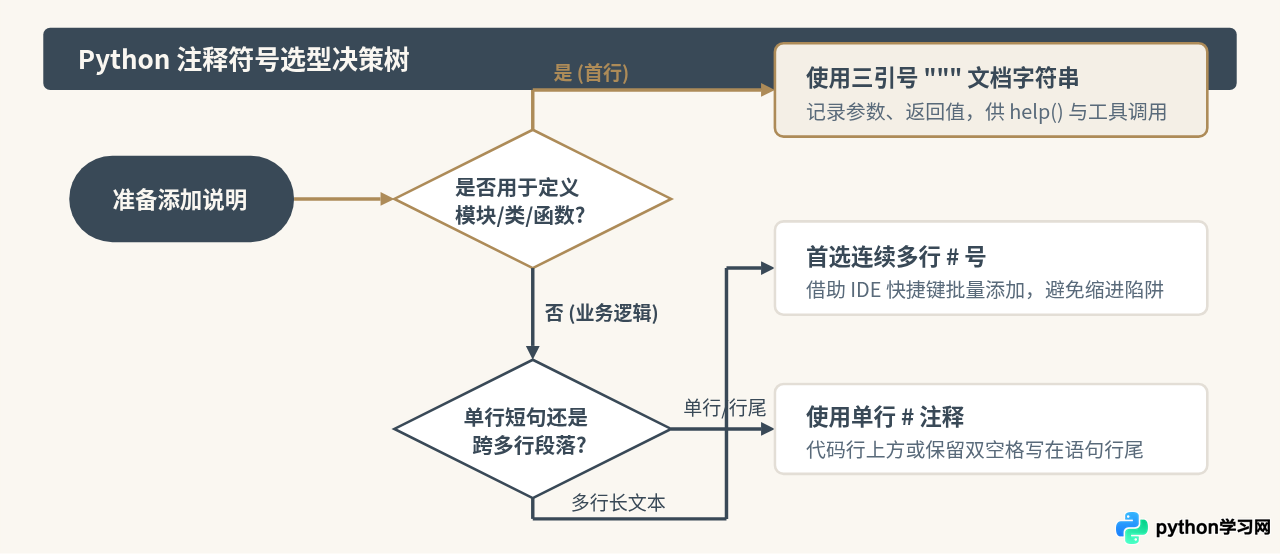
六、总结
理解 Python 的注释符号,关键在于理清“真正的语法注释”与“未分配的字符串字面量”的区别:
- 单行注释:认准井号
#。它是词法分析层面的注释符号,零开销、不参与代码执行,适用于所有单行说明与临时调试屏蔽。 - 多行注释:编写常规工程代码时,建议优先使用 IDE 快捷键生成多行连续
#,逻辑清晰且完全规避缩进错误。 - 三引号规范:三引号(
'''/""")的首要目标是充当模块、类与函数的 Docstring。只有需要向外部输出接口规范或文档时,才应系统化使用它,并在书写时严格对齐缩进。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















