


Python注释有什么用:提升代码可读性与维护效率
深入解析Python注释的核心作用、底层处理机制与书写规范。通过对比分析、步骤示范与生命周期效益图解,帮助开发者掌握编写高质量注释的方法,显著提升代码可读性与长期维护效率。
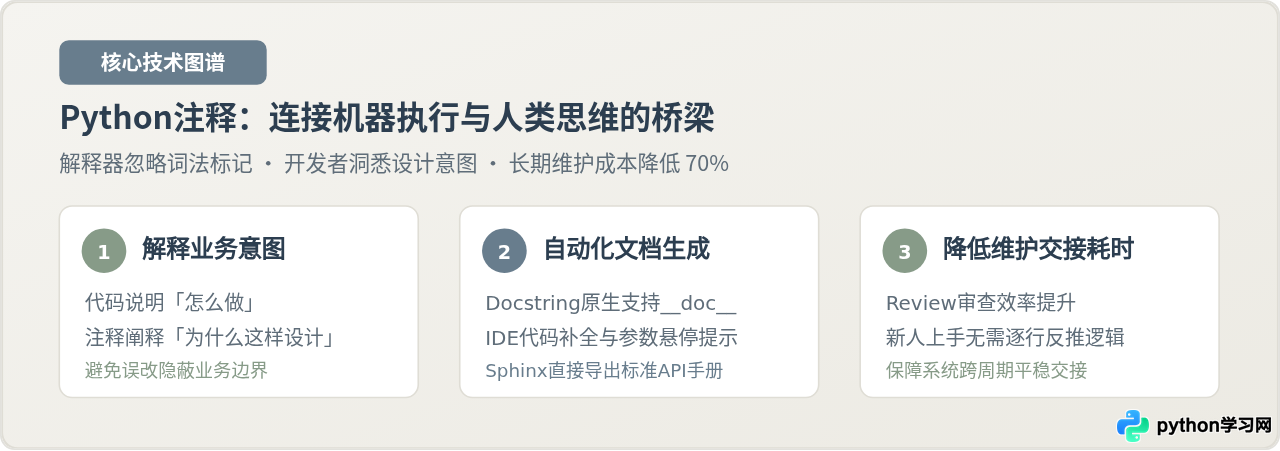
Python注释是编写在代码中供人类阅读、而在程序编译和执行时被解释器完全忽略的文字说明。它的核心作用并非将代码逻辑用自然语言机械地翻译一遍,而是补充代码本身无法直接表达的业务动机、设计考量、边界陷阱与依赖说明。高质量的注释能够消除上下文断层,显著降低团队交接与排障沟通成本,是构建高可维护性软件工程的关键基础设施。
一、底层原理:Python解释器与开发者的双重视角
理解Python注释的第一步,在于区分计算机运行视角与人类阅读视角的本质差异。许多初学者担心“注释写多了会不会拖慢程序运行速度”,答案是完全不会。
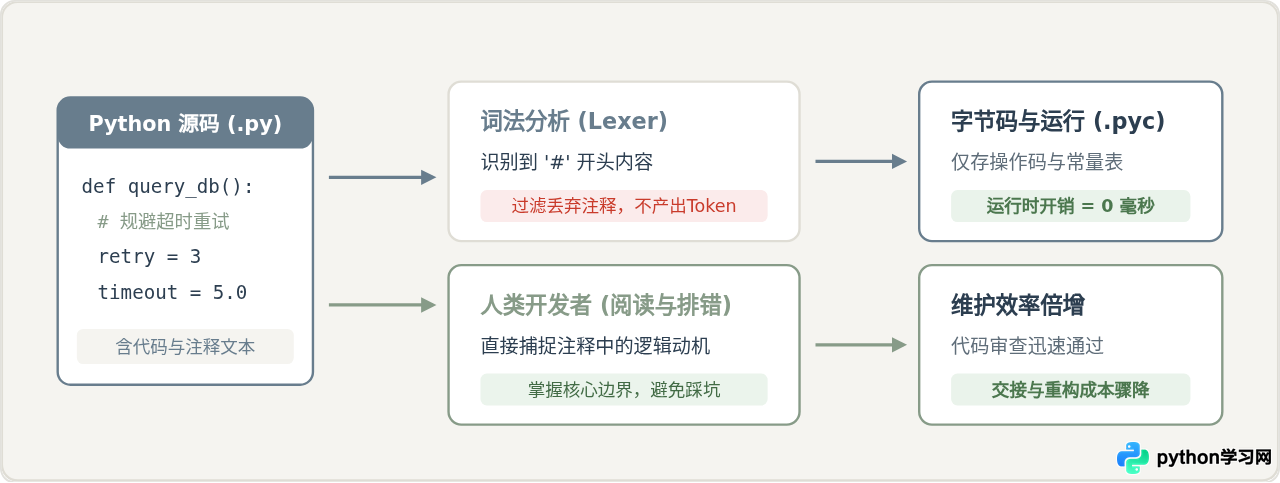
在Python执行源码时,首先通过词法分析器(Lexer/Tokenizer)将源代码切分为词法单元。在此阶段,以井号 # 开头的单行或行尾注释会被直接丢弃,根本不会进入后续的抽象语法树(AST)构建与字节码(Bytecode)生成阶段。因此,生成的 .pyc 文件中不包含任何常规注释,运行时没有任何额外开销。
然而,对于开发者而言,阅读代码的时间往往数十倍于编写代码的时间。即使是自己写的代码,两周后也可能变成陌生的逻辑。注释为人类开发者提供了即时上下文,架起了从“语法实现”通往“业务现实”的高速通路。
二、标准语法与排版操作规范
根据官方 PEP 8 样式指南,Python中主要有三种注释形态:单行独立注释、行尾伴随注释以及文档字符串(Docstring)。规范的书写方式不仅让排版整洁,也能防止IDE误判。
1. 单行注释(Block Comments)
单行注释用于解释其后紧跟的一段代码逻辑。必须以 # 开头,后接一个半角空格,缩进层级必须与所说明的代码块严格对齐。
# 校验用户输入的邮箱格式,若不符合RFC标准则记录告警并阻断提交
if not re.match(r"[^@]+@[^@]+\.[^@]+", user_email):
    logger.warning("Invalid email format received: %s", user_email)
    return False
2. 行尾注释(Inline Comments)
行尾注释与代码位于同一行,仅用于对当前单行语句提供关键补充。PEP 8 规定:行尾注释与代码之间必须至少间隔两个半角空格,井号后同样保留一个空格。
retry_limit = 3 # 网络抖动时的最大容错重试次数,防止线程池耗尽3. 文档字符串(Docstrings)
使用三引号 """...""" 定义。严格来说Docstring属于对象属性而非词法级注释,解释器会将其绑定到模块、类或函数的 __doc__ 属性上,可被 help() 函数查看或被自动化文档工具解析。
def calculate_compound_interest(principal: float, rate: float, periods: int) -> float:
    """计算复合利息的未来终值。

    参数:
        principal (float): 本金金额(须大于0)。
        rate (float): 年化名义利率(例如 0.05 代表 5%)。
        periods (int): 复利计息周期数。

    返回:
        float: 计算后的终值金额,保留两位小数。
    """
    return round(principal * ((1 + rate) ** periods), 2)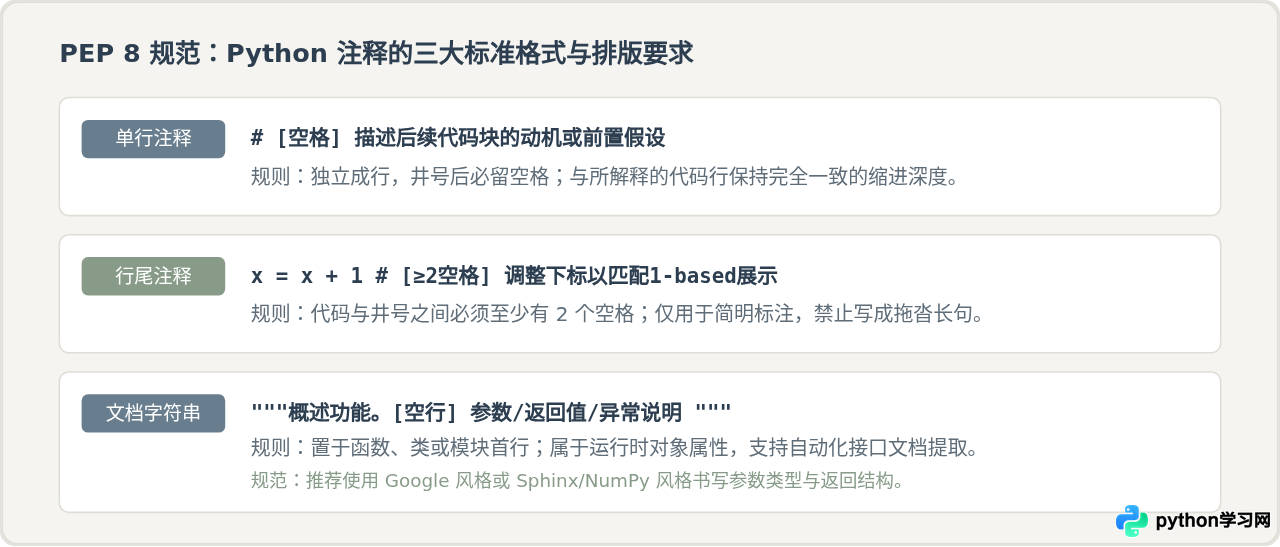
三、核心对比:有效注释与低效冗余注释的关键差异
写了注释并不等同于写好了注释。低质量的注释不仅浪费书写与阅读时间,更会在代码变更后演变为具有欺骗性的“误导炸弹”。
为了直观理解差异,我们以一段典型的订单分账结算逻辑为例,在完全一致的业务代码条件下,对比“低效直译型注释”与“高价值解释型注释”的实际表现:
| 对比维度 | 低效注释(聚焦于“做什么”) | 高效注释(聚焦于“为什么”) |
|---|---|---|
| 关注重点 | 字面复述代码语法和操作行为。 | 阐释业务规则、安全考量与历史背景。 |
| 典型写法 | # 循环遍历列表中的每个项目 |
# 按优先级降序扣减以保证大额优先履约 |
| 维护影响 | 代码重构后注释极易失效,形成维护干扰。 | 帮助后来者理解约束,防止无意破坏商业契约。 |
| 信息增益 | 零增益(熟练程序员看代码即懂)。 | 高增益(传达代码之外的隐性背景知识)。 |
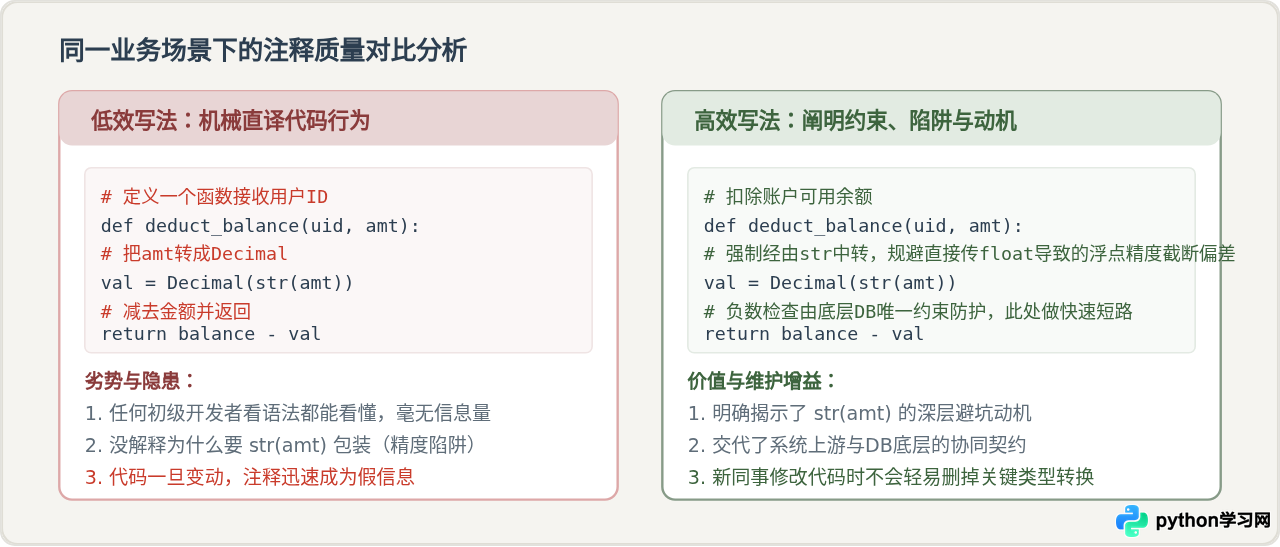
is_user_authenticated),就不需要写 # 判断用户是否已经认证。注释应该出现在仅靠变量名和函数名难以完整传达的逻辑盲区。
四、工程实践:注释如何贯穿软件生命周期提升效率
在团队开发中,注释的作用不仅仅体现在写完代码的当下,更贯穿于代码审查(Code Review)、排错调试(Debugging)与项目交接重构的全流程。
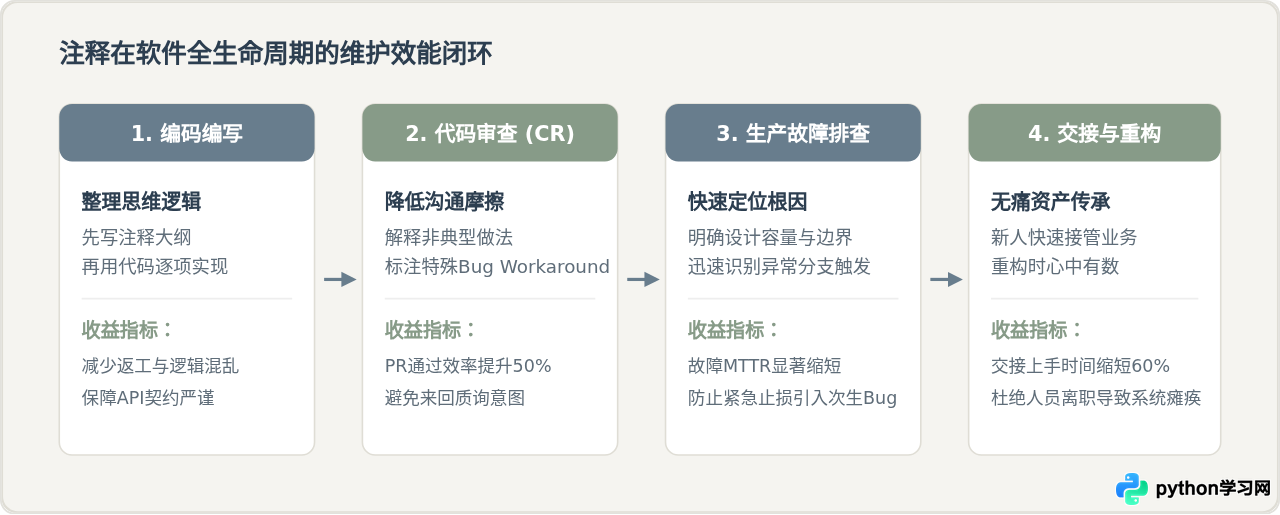
团队维护中的两大禁忌与纠正措施
-
禁忌一:用注释保存废弃的旧代码。
许多开发者习惯把不要的代码注释掉留作“备忘”,长此以往,代码库中充斥着大段失去时效的死代码(Dead Code),严重污染阅读视线。正确做法:依靠 Git 等版本控制系统来追踪历史。无用的代码果断删除,Git 提交记录才是最安全可靠的备忘库。 -
禁忌二:只改代码不改注释。
当业务逻辑发生变更时,若忘记同步更新相关的注释,注释就会变成具有高度迷惑性的谎言。正确做法:将“注释更新”纳入代码审查(Code Review)的强制清单,任何修改了函数签名、返回结构或业务边界的提交,必须同步核验注释一致性。
五、总结:高质量注释编写清单
要在日常开发中平衡编写成本与维护收益,可以牢记以下四项可执行准则:
- 优先清晰命名:让代码尽可能自解释(Self-documenting),减少不必要的字面翻译注释。
- 聚焦核心动机:为所有反直觉的优化算法、针对特定第三方系统 Bug 的规避逻辑(Workarounds)、复杂的正则表达式补充背景动机。
- 规范对外接口:为所有供外部调用的模块、类和公共函数编写标准格式的 Docstring,清晰列出输入类型、输出类型及可能抛出的异常。
- 及时清理沉淀:使用
TODO:或FIXME:明确标记技术债务,并定期集中处理;坚决移除大段注释掉的历史代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















