


怎么用Python DictReader读取带表头的CSV数据
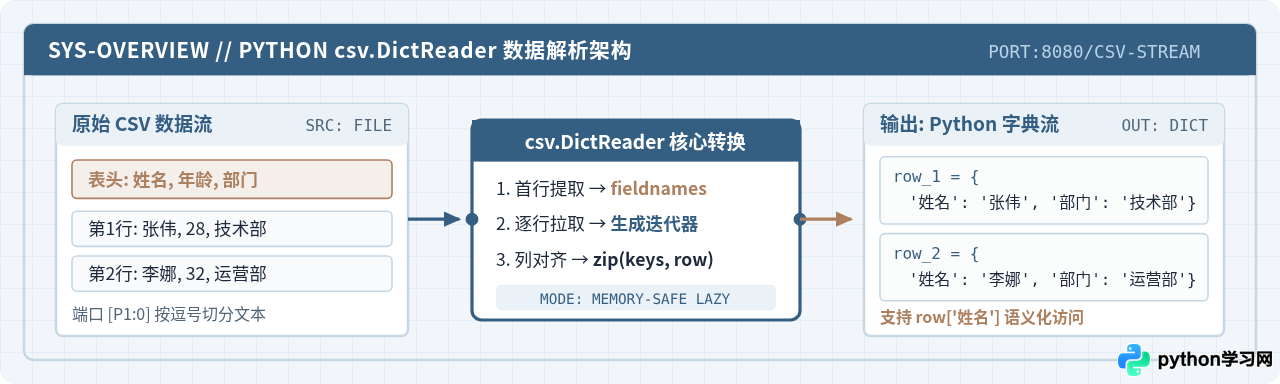
详细讲解如何使用 Python 内置 csv.DictReader 模块读取带表头的 CSV 数据,包含基础用法、底层映射原理、五步操作流、常见编码与列不对齐等避坑技巧。
csv 中的 DictReader 类。与按数字索引提取单元格的普通读取器不同,DictReader 会自动把文件的首行作为键(Key),并将后续的每一行数据封装为以列名为键的字典(Dictionary),让你直接通过 row['列名'] 访问数据,彻底避免因表格列顺序变化或增减列而导致的代码错误。
一、极简上手:5行代码读取带表头CSV
Python 的 csv 模块属于内置标准库,无需使用 pip 额外安装任何第三方依赖。在准备读取前,先准备一个包含标准表头的示例文件 students.csv,内容如下:
name,age,department,score
张伟,21,计算机系,89.5
李娜,22,自动化系,94.0
王强,20,软件工程,78.5
在同一目录下创建 Python 脚本并执行以下代码。通过 with open() 打开文件后,将文件对象传递给 csv.DictReader,即可开始逐行遍历:
import csv

# 使用 utf-8 编码安全打开文件
with open('students.csv', mode='r', encoding='utf-8') as f:
    reader = csv.DictReader(f)
    for row in reader:
        # 直接通过表头列名读取对应单元格数据
print(f"姓名: {row['name']}, 院系: {row['department']}, 得分: {row['score']}")姓名: 李娜, 院系: 自动化系, 得分: 94.0
姓名: 王强, 院系: 软件工程, 得分: 78.5
在这段执行过程中,你不需要手动调用 next(reader) 跳过第一行表头,DictReader 在初始化时会自动读取首行并完成字段注册。
二、底层机制:为什么优先选择 DictReader
很多初学者在处理 CSV 时习惯使用 csv.reader,但普通 reader 与 DictReader 的底层数据结构存在本质差异。理解这两者的映射模型,有助于在实际工程中做出更稳妥的设计。
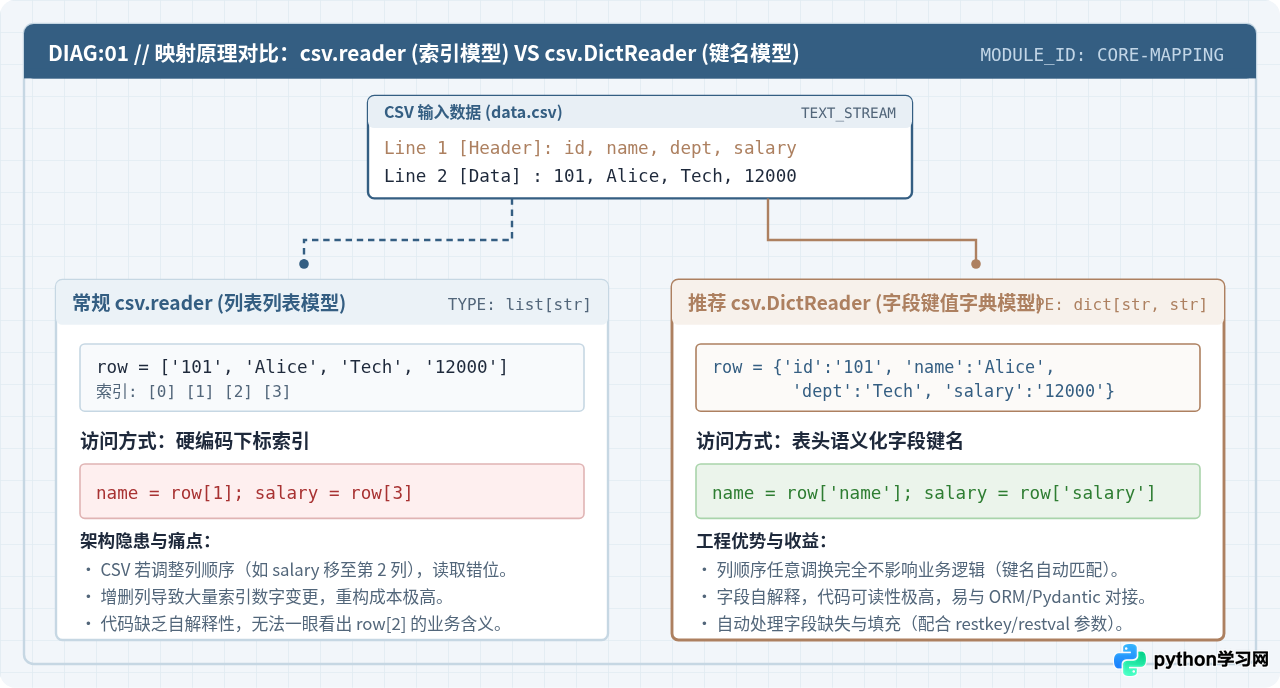
从上图可以看出两者的核心区别:
- 抗变动能力极强:如果业务方在 Excel 中调整了列的先后顺序(例如把
score换到了第二列),csv.reader中写死的row[3]会瞬间读错或导致业务崩溃;而DictReader依据列名映射,列顺序改变丝毫不影响row['score']的正确取值。 - 代码自解释性高:阅读
row['department']能立即明确其业务含义,无需对照原始 CSV 表格逐个核对row[2]到底代表哪个字段。 - 易于对接现代框架:字典结构能够无缝转换为 JSON 字符串,或直接解包传递给 Pydantic 模型、dataclass 以及各类数据库 ORM 实体。
三、标准规范:五步操作流与类型处理
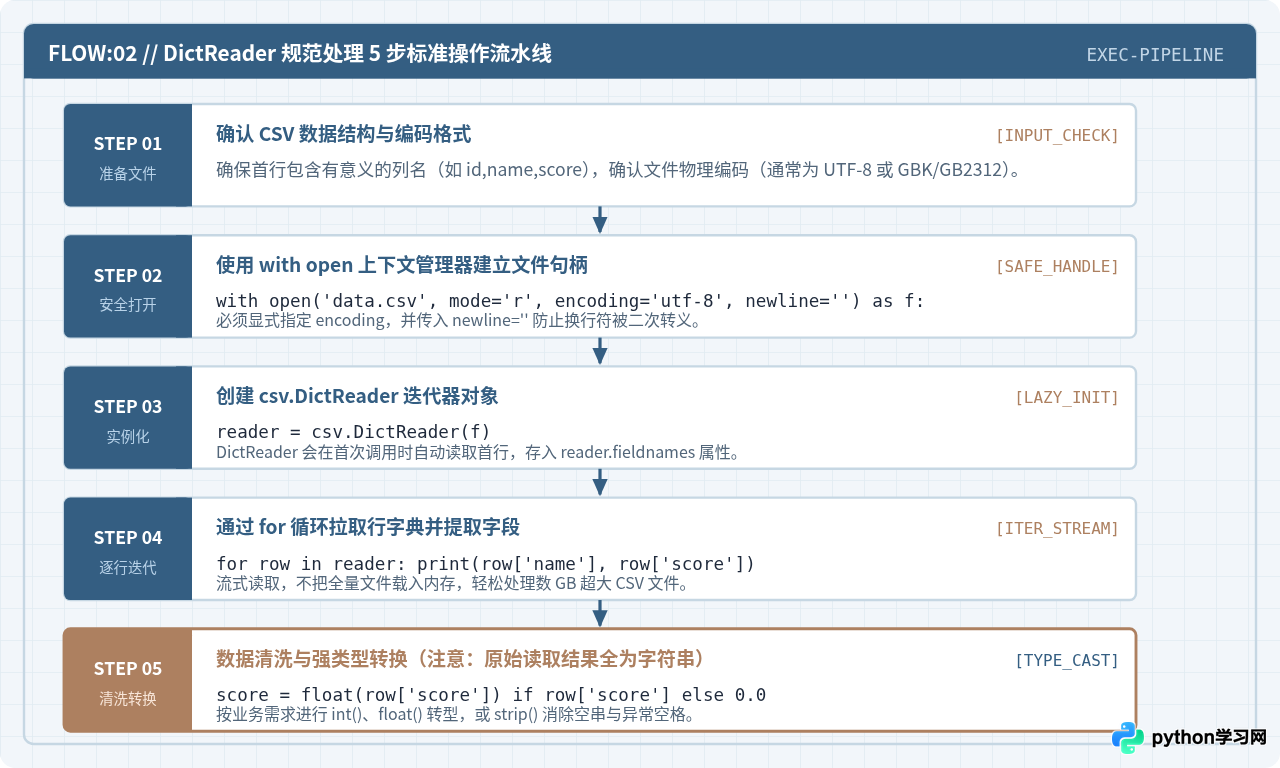
在实际生产开发中,读取 CSV 往往涉及字符编码、换行符处理和数据清洗。按照规范的 5 步流程实施,可以有效规避绝大多数隐蔽缺陷。
步骤详解与关键点
- 步骤 1(文件检查):确认 CSV 文件首行是否存在空列名或重复列名,并了解文件的保存编码。
- 步骤 2(安全打开):在 Python 3 中,调用
open()时建议显式添加参数newline=''。官方文档明确指出,若不指定newline='',CSV 模块内置的通用换行符机制可能与 Python 内部的换行解析产生冲突,特别是在 Windows 环境下可能导致额外的空行解析错误。 - 步骤 3(构造实例):执行
reader = csv.DictReader(f)。你可以随时通过reader.fieldnames查看解析出的表头列表,例如print(reader.fieldnames)会输出['name', 'age', 'department', 'score']。 - 步骤 4(流式迭代):通过
for row in reader进行惰性加载(Lazy Loading)。即使 CSV 文件有数个 Gigabyte 大小,内存中每次也只保留当前一行的字典对象,不会导致内存溢出。 - 步骤 5(类型转换与清洗):必须牢记,CSV 本质是纯文本,DictReader 读取出的所有字段值全为字符串(str)。如果后续需要进行加减乘除计算,必须显式调用
int()或float()进行类型转换。
import csv

total_score = 0.0
valid_count = 0

with open('students.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.DictReader(f)
    for row in reader:
        # 去除字符串首尾可能存在的空白字符
        name = row['name'].strip()

        # 将年龄转换为整型,成绩转换为浮点型
        age = int(row['age'].strip())
        score = float(row['score'].strip())

        total_score += score
        valid_count += 1

avg_score = total_score / valid_count if valid_count > 0 else 0.0
print(f"统计完成:共 {valid_count} 名学生,平均分: {avg_score:.2f}")四、边界与异常场景:核心参数与排查方案
在对接不同系统或用户手动导出的 CSV 时,常会遇到各种不规则格式。掌握 DictReader 提供的控制参数,能够迅速化解这些边界问题。
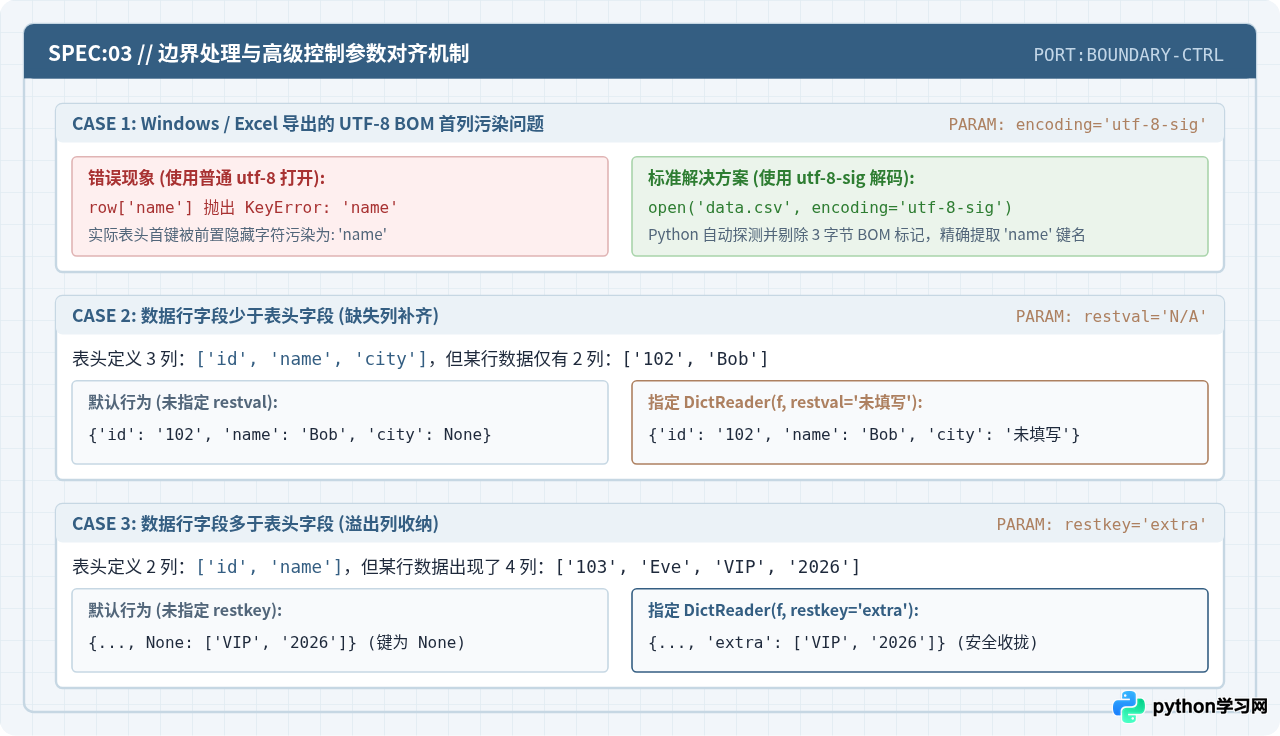
1. 避坑重点:Windows Excel 导出的 UTF-8 BOM 干扰
这是初学者最常遇到的问题:使用 Excel 另存为 CSV(UTF-8)时,Windows 会在文件头部悄悄写入 3 个字节的 BOM 签名(0xEF 0xBB 0xBF)。如果直接使用 encoding='utf-8' 读取,第一个表头键名前面会被附加上 ,导致你执行 row['name'] 时抛出 KeyError: 'name'。
encoding='utf-8' 改为 encoding='utf-8-sig'。Python 解释器会自动侦测并剥离 BOM 头,使首列键名恢复干净正常的字符串。
2. 数据行字段少于表头:使用 restval 设定默认值
如果数据文件中某些行由于导出中断导致末尾缺少了几列,DictReader 默认会给缺失的键赋予 None。如果你希望将其填充为空字符串或特定占位符,可以传入 restval 参数:
# 当某行缺失字段时,自动用 '未知' 填充该键的值
reader = csv.DictReader(f, restval='未知')
3. 数据行字段多于表头:使用 restkey 收集溢出数据
反之,若某行数据的列数超过了表头定义的列数,多出来的字段默认会被归入一个键为 None 的列表中。为防止 row[None] 带来代码异味,可以通过 restkey 为溢出列表指定一个有业务含义的键名:
# 超出表头的多余字段将被收入 row['extra_data'] 的列表中
reader = csv.DictReader(f, restkey='extra_data')
4. 原始文件没有表头:手动注入 fieldnames
如果你拿到的是一份纯数据、无表头的 CSV 文件,但仍希望享受字典访问的便利,可以在创建 DictReader 时显式传入 fieldnames 列表。此时,DictReader 将不再把文件的第一行视为列名,而是从第一行开始就作为实际数据进行解析:
custom_headers = ['user_id', 'user_name', 'role', 'status']

with open('no_header_data.csv', mode='r', encoding='utf-8', newline='') as f:
    # 显式传入自定义表头列表
    reader = csv.DictReader(f, fieldnames=custom_headers)
    for row in reader:
        print(row['user_id'], row['user_name'])
五、选型与工程总结
在 Python 体系中,解析 CSV 有多种工具可供选择。为了避免过度设计或在不适宜的场景下引入沉重依赖,请参考以下选型决策与实践清单:
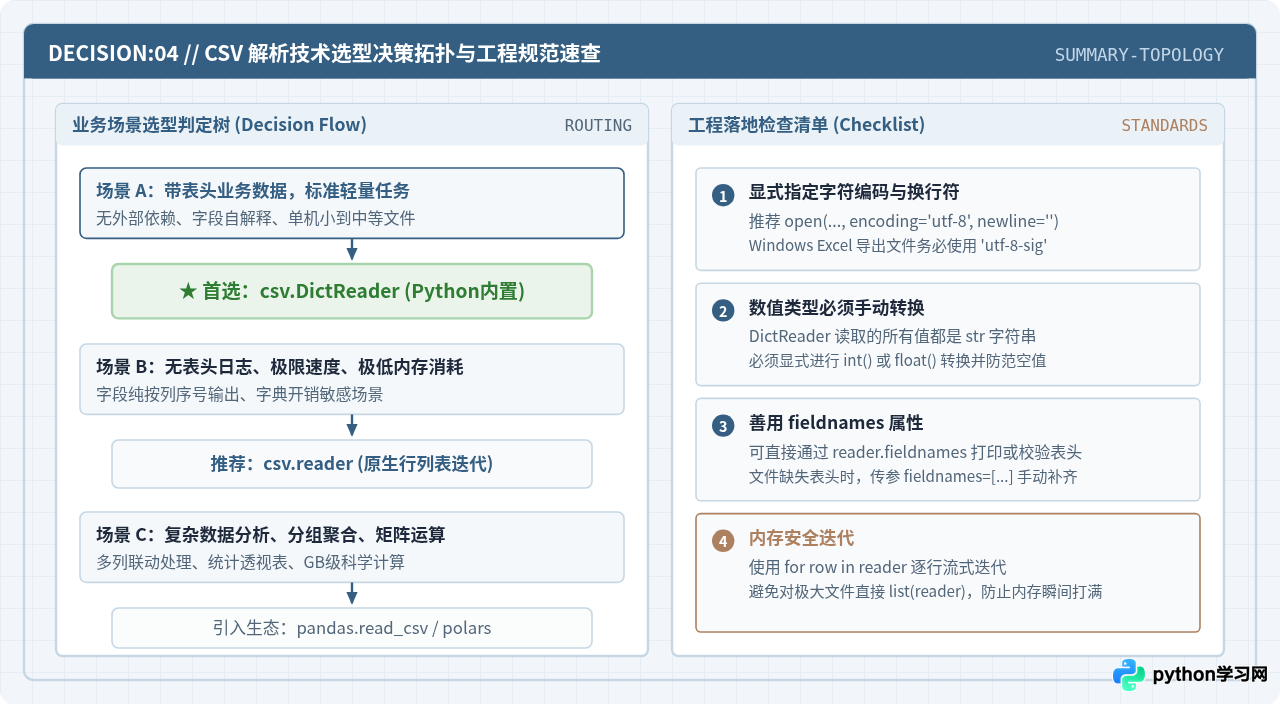
| 方案类型 | 核心优势 | 局限性 | 推荐使用场景 |
|---|---|---|---|
| csv.DictReader | 标准库零依赖、内存占用低、按列名自解释访问、对列顺序变化免疫 | 数据全为文本需手动类型转换,不提供高级统计函数 | 常规业务脚本、数据导入导出、微服务后端、文件格式校验 |
| csv.reader | 极致解析速度、内存开销最小(纯 list 结构) | 按数字下标索引,表头顺序变更极易出错,可读性弱 | 超大数据流管道清洗、简单无表头日志文本按列提取 |
| pandas.read_csv | 自动推断类型、支持复杂矩阵变换与数据透视、向量化计算 | 需安装庞大第三方依赖(Pandas/NumPy),内存开销较高 | 数据挖掘、机器学习特征工程、多表 Join 与统计报表制作 |
csv.DictReader 是性价比最高、维护成本最低的选择。只需谨记:配合 with open(..., encoding='utf-8-sig', newline='') 使用,根据业务按需进行 int/float 显式转换,即可写出健壮可靠的数据读取程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















