


Python循环中使用append构建列表的正确方式
深入讲解在Python循环中使用append构建列表的正确姿势,解析空列表初始化位置、对象引用覆盖陷阱、浅拷贝与深拷贝处理,以及与列表推导式的合理选型。
在 Python 中,通过 for 循环配合 list.append() 动态累加元素是处理批量数据最直接的范式。表面上看,这只是“创建空列表、遍历计算、追加进去”三步,但初学者极容易在两处隐蔽位置出错:一是初始化容器的位置放错导致数据被循环清空,二是追加可变对象(如列表或字典)时引发的“引用覆写陷阱”。本文将梳理标准操作链路,拆解内存中的引用机制,并提供严谨的防御式代码写法与替代选型依据。
标准构建流程与执行闭环
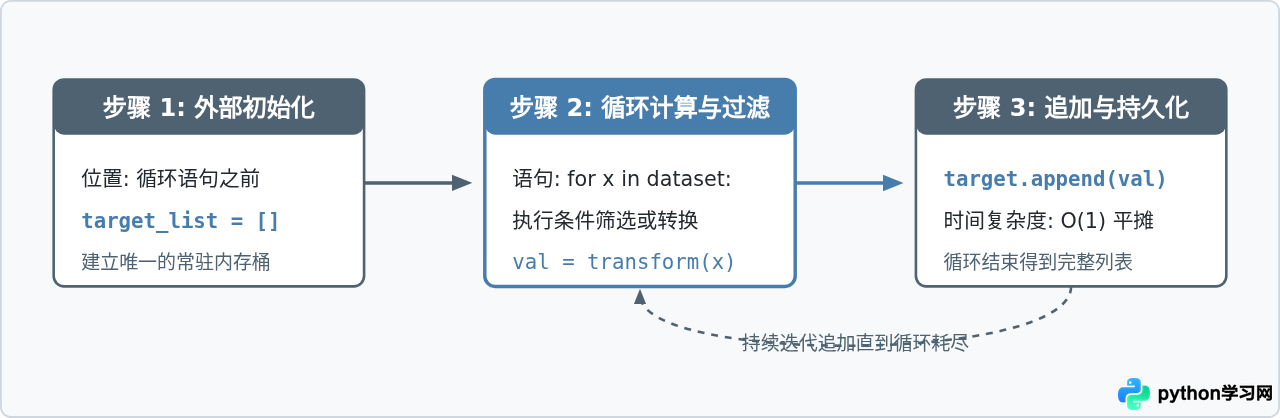
在循环中构建列表的标准结构只有三步:在循环外部初始化目标容器、在迭代内部生成或转换元素、调用 append() 将新元素推入容器末端。这确保了容器生命周期贯穿整个处理过程,而不是在每次迭代开始时被重建。
# 标准示范:提取偶数并计算其平方
raw_numbers = [1, 2, 3, 4, 5, 6, 7, 8]
result = []  # 步骤 1:循环外部完成初始化

for item in raw_numbers:
    if item % 2 == 0:
        squared = item ** 2      # 步骤 2:数据变换处理
        result.append(squared)   # 步骤 3:追加至列表尾部

print("最终处理结果:", result)
# 示例输出:
# 最终处理结果: [4, 16, 36, 64]
这一过程的执行逻辑可用如下结构化操作流程进行追踪。在实际编写代码时,必须保证空列表的声明发生在迭代语句之前。
初始化作用域错误:列表被反复重置
最容易忽视的基础错误是把初始化语句 target_list = [] 写进了 for 循环体内。这种情况下,每一次迭代都会强制将变量重新绑定到一个刚开辟的空列表上,前序积累的数据被彻底覆盖,最终列表里永远只有最后一次循环追加的内容。
# 错误示例:将定义放在循环内
data = [10, 20, 30]

for x in data:
    bad_list = []      # 致命错误:每次循环都生成新列表
    bad_list.append(x * 2)

print("错误写法结果:", bad_list)
# 示例输出:
# 错误写法结果: [60]  (前序运算出的 20, 40 已随迭代丢失)
这种逻辑 Bug 通常不会抛出任何系统异常,在数据量庞大时极具迷惑性。排查方法非常简单:确认承接最终结果的变量在 for 语句上方只出现过一次初始化赋值。
核心陷阱:追加可变对象时的引用覆写
当列表中存放的不仅是数字、字符串等不可变类型,而是子列表、字典或自定义对象等可变类型(Mutable Object)时,初学者几乎都会踩中“引用共享陷阱”:最终产出的列表里每个子项内容竟然完全一模一样,且全都变成了最后一次处理的数据。
现象复现与错误代码
# 常见错误场景:构建坐标点字典列表
raw_coords = [(1, 2), (3, 4), (5, 6)]
point_list = []

# 错误做法:在循环外复用同一个字典对象
temp_point = {"x": 0, "y": 0}

for cx, cy in raw_coords:
    temp_point["x"] = cx
    temp_point["y"] = cy
    point_list.append(temp_point)  # 每次追加的都是同一个对象的内存地址!

print("点集列表:", point_list)
# 示例输出:
# 点集列表: [{'x': 5, 'y': 6}, {'x': 5, 'y': 6}, {'x': 5, 'y': 6}]
原因深度剖析:内存指针与引用
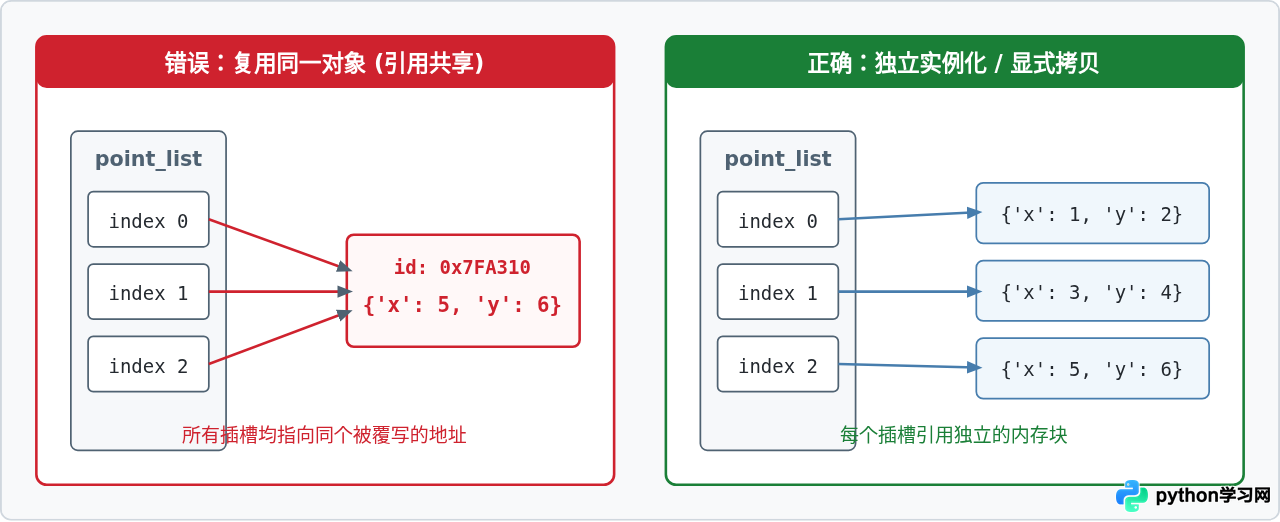
在 Python 中,变量名是对内存中对象的引用,list.append(obj) 追加的并不是该对象的一份完整拷贝,而是该对象在内存中的地址指针。上面的错误代码中,只在内存中通过 temp_point = {...} 实例化了一个字典对象,循环体内每次只是修改这个唯一对象的键值。point_list 中虽然包含 3 个元素,但这 3 个元素指向的物理内存地址完全相同。
解决对象引用覆盖的两种严谨写法
要打破引用的连带篡改,核心思想是保证每次调用 append 压入的对象都拥有全新的物理内存空间。实际工程中有两种标准解决方案:
方案 A:循环内部全新实例化(推荐首选)
不再复用外部变量,把字典或列表的创建动作直接放进循环内部。每次循环由 Python 解释器分配全新的堆内存空间:
raw_coords = [(1, 2), (3, 4), (5, 6)]
point_list = []

for cx, cy in raw_coords:
    # 每次迭代生成全新对象
    point = {"x": cx, "y": cy}
    point_list.append(point)

print("正确列表:", point_list)
# 示例输出:
# 正确列表: [{'x': 1, 'y': 2}, {'x': 3, 'y': 4}, {'x': 5, 'y': 6}]
方案 B:使用浅拷贝或深拷贝切断引用
如果在循环前已经存在一个包含大量默认键的模板对象,需要在循环中基于此模板修改并追加,则必须使用 .copy() 或标准库的 copy.deepcopy() 进行值拷贝:
import copy

base_config = {"timeout": 30, "retry": 3, "tags": ["prod"]}
job_configs = []

for job_id in range(1, 4):
    # 扁平字典使用 .copy(),含有嵌套子列表/子字典的使用 deepcopy()
    current_job = copy.deepcopy(base_config)
    current_job["job_id"] = job_id
    current_job["tags"].append(f"worker_{job_id}")
    job_configs.append(current_job)

print("独立任务配置数量:", len(job_configs))
# 验证首个元素并没有被最后一个元素的 tags 污染
print("Job 1 tags:", job_configs[0]["tags"])
# 示例输出:
# 独立任务配置数量: 3
# Job 1 tags: ['prod', 'worker_1']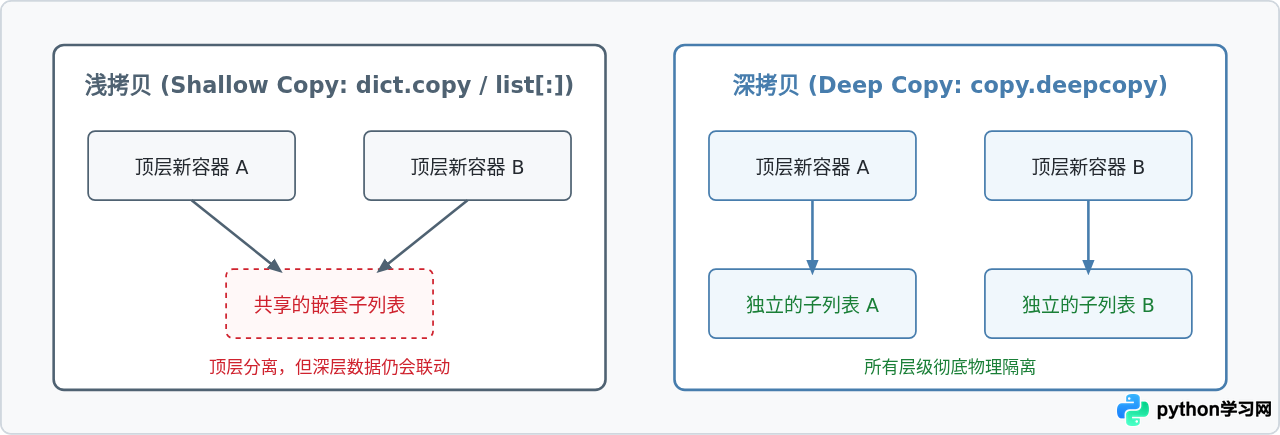
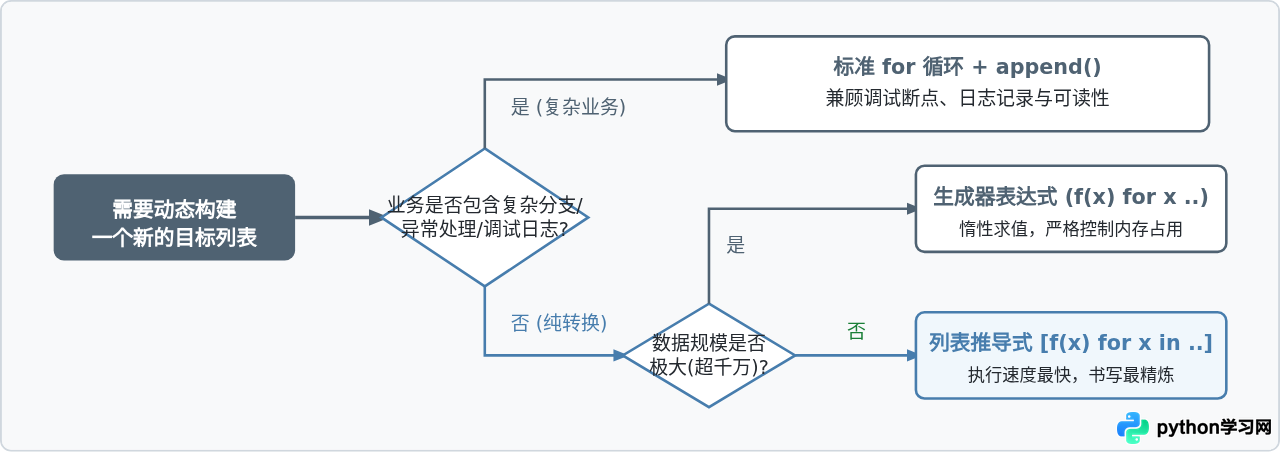
选型决策:什么时候不应该用 for 循环 append
在 Python 中,循环调用 append() 并非构建列表的唯一手段。对于简单的映射和过滤操作,列表推导式(List Comprehension)在执行效率和语法表现力上通常更优:
- 列表推导式底层经过 C 层面优化:避免了 Python 字节码在循环中反复进行方法查找(
LOAD_METHOD与CALL_METHOD),速度通常比显式的for + append快 20% 到 30%。 - 循环 append 适合复杂业务链路:当迭代内部包含多重条件分支、异常捕获(
try...except)、日志记录或复杂的多步骤运算时,显式循环的结构更清晰,更便于调试与下断点。
总结与代码自检清单
在编写任何通过循环追加元素的 Python 代码时,完成编写后建议依次对照以下清单进行自检:
- 初始化位置:确认结果列表
res = []位于for循环的外侧上方,而非循环体内部。 - 对象独立性:如果追加的是字典或子列表,确认该可变对象是在循环体内全新生成的,或者是通过
.copy()/copy.deepcopy()脱敏后追加的。 - 性能边界:如果是单行表达式就能处理的纯计算或简单映射,优先重构成
[expr for x in iterable if cond]形式,提高执行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















