


Python列表尾部添加元素:何时用append,何时用extend?
深入解析Python列表在尾部添加元素时append与extend的核心差异、内部执行机制、常见字符串陷阱以及场景选择指南。
append();如果希望把一个可迭代对象中的每个元素拆包解构、逐一平铺追加到列表尾部,则必须使用 extend()。
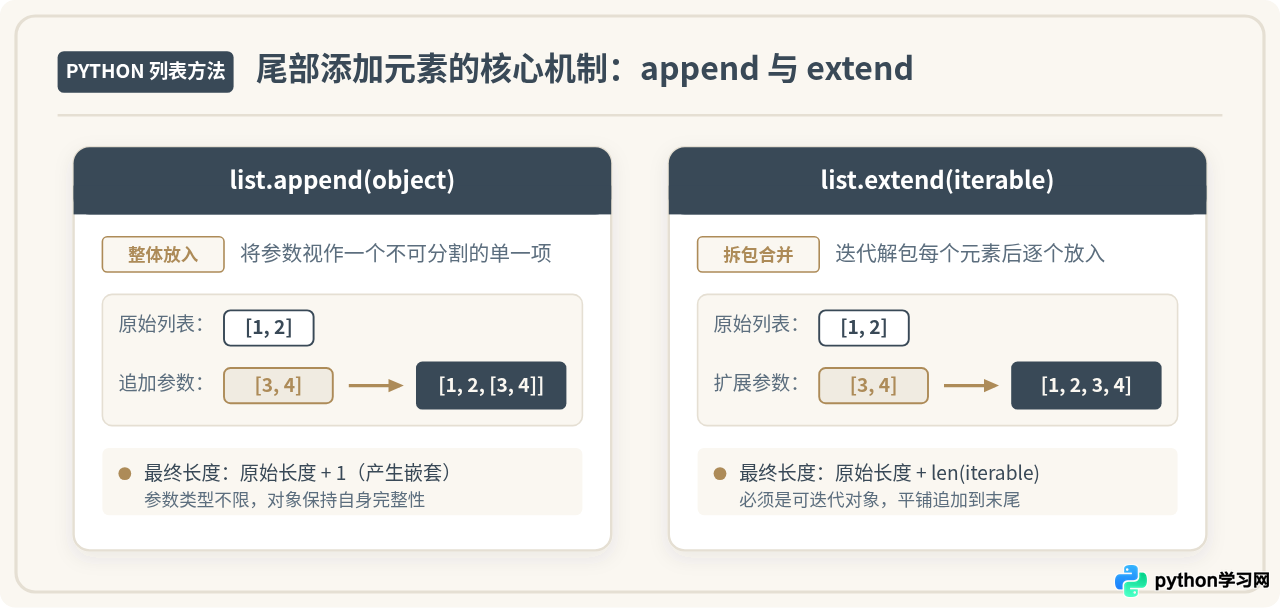
一、两者的核心区别与直观效果
在 Python 的列表操作中,append() 和 extend() 都是专门用于在已有列表末尾追加数据的方法,并且它们都在原地直接修改列表对象本身。两者的根本区别在于对传入参数的封装态度:
list.append(x):接收一个任意类型的参数x,并将它作为一个独立的整体元素塞入列表尾部。调用后,原列表长度永远只增加1。list.extend(iterable):只接收可迭代对象(如列表、元组、集合、生成器等),将其内部包含的元素逐个取出,依次追加到列表尾部。调用后,原列表长度增加len(iterable)。
通过一段最基础的代码对比,可以立刻看到传入同样参数时的截然不同结果:
# 示例 1:传入基础单值
fruits_a = ['apple', 'banana']
fruits_a.append('orange')
print("append 结果:", fruits_a)
# 示例输出:append 结果: ['apple', 'banana', 'orange']

# 示例 2:传入另一个列表
nums_a = [1, 2, 3]
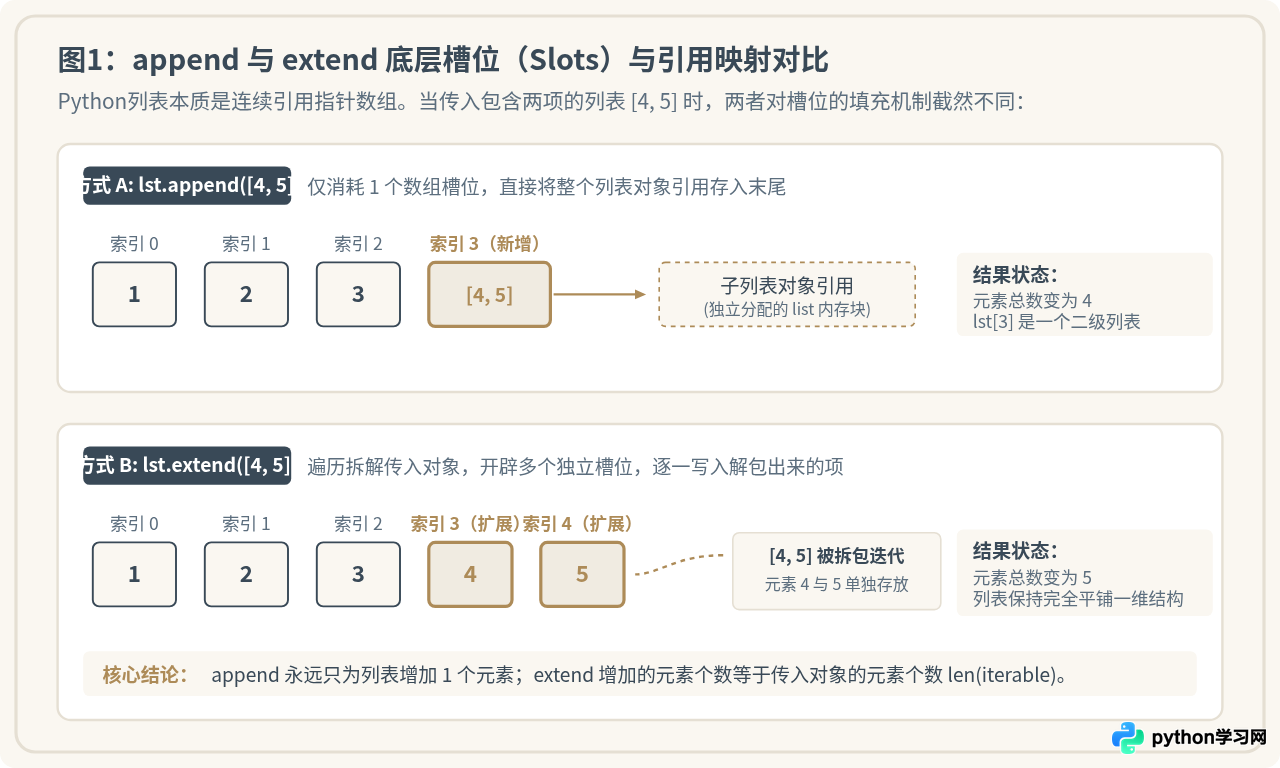
nums_a.append([4, 5])
print("append 嵌套列表:", nums_a)
# 示例输出:append 嵌套列表: [1, 2, 3, [4, 5]]
# 长度只增加了 1,nums_a[3] 变成了一个包含两项的子列表

nums_b = [1, 2, 3]
nums_b.extend([4, 5])
print("extend 展开列表:", nums_b)
# 示例输出:extend 展开列表: [1, 2, 3, 4, 5]
# 长度增加了 2,[4, 5] 被拆开平铺,结构保持一维
二、操作步骤与执行流程:Python 底层是如何处理它们的?
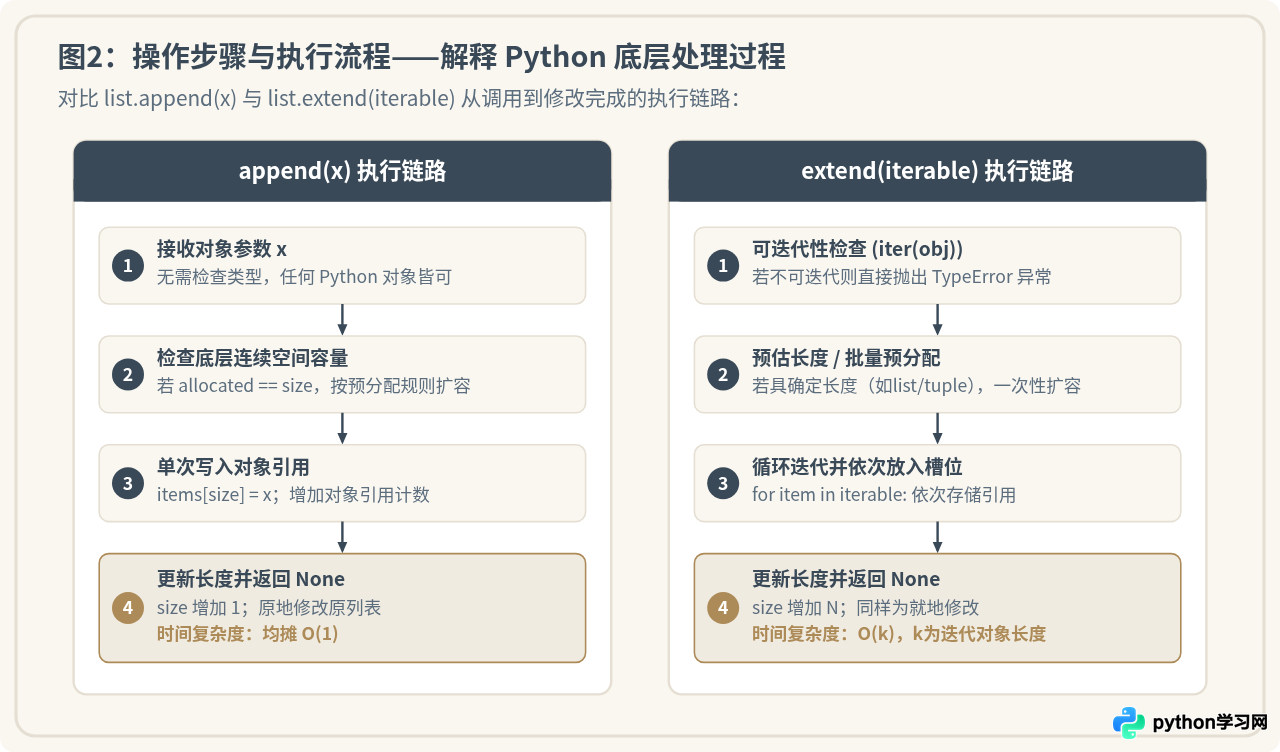
为了在实际编写代码时杜绝混淆,我们需要从 Python 解释器的执行流程来理解两者的内部步骤。Python 中的列表在 CPython 底层表现为 PyListObject,其本质是一个存储对象指针的连续动态数组。
1. append 的执行步骤
当执行 lst.append(x) 时,底层经历以下三个关键动作:
- 接收对象并预留槽位:解释器检查列表当前的底层容量。如果当前底层数组已满,则触发动态扩容算法分配新的连续内存。
- 写入引用指针:将参数
x对应的对象指针直接赋值到底层数组的当前末尾位置items[size],并使x的引用计数自增 1。无论x本身有多庞大、是否可迭代,在append眼中它都只是一个普通的PyObject*指针。 - 更新尺寸并返回:列表的
size属性增加 1,方法执行完毕返回None。整个过程是常数时间均摊复杂度O(1)。
2. extend 的执行步骤
当执行 lst.extend(iterable) 时,底层步骤则明显更加严谨:
- 可迭代性校验:解释器尝试通过
iter(iterable)获取该对象的迭代器。如果传入的是整数、浮点数或布尔值等不支持迭代的对象,在此步骤会立刻抛出TypeError异常终止执行。 - 容量预分配优化:若传入的对象具备已知的长度(如
list或tuple),CPython 会预先计算追加后的总长度并一次性扩容,避免多次重新分配内存;若传入的是生成器等流式对象,则在迭代过程中逐步扩容。 - 循环取值追加:依次调用迭代器的
next()方法取出每个内部元素,将其指针按顺序追加到底层数组中,直到迭代器耗尽。 - 更新尺寸并返回:列表的
size增加了被追加元素的总个数,方法就地修改完成后返回None。其时间复杂度取决于被追加元素的个数,为O(k)。
三、四大高频易错点与典型陷阱
在实际项目开发中,初学者往往会因为对 Python 数据类型的隐式特性理解不深,而踩中以下几个经典陷阱:
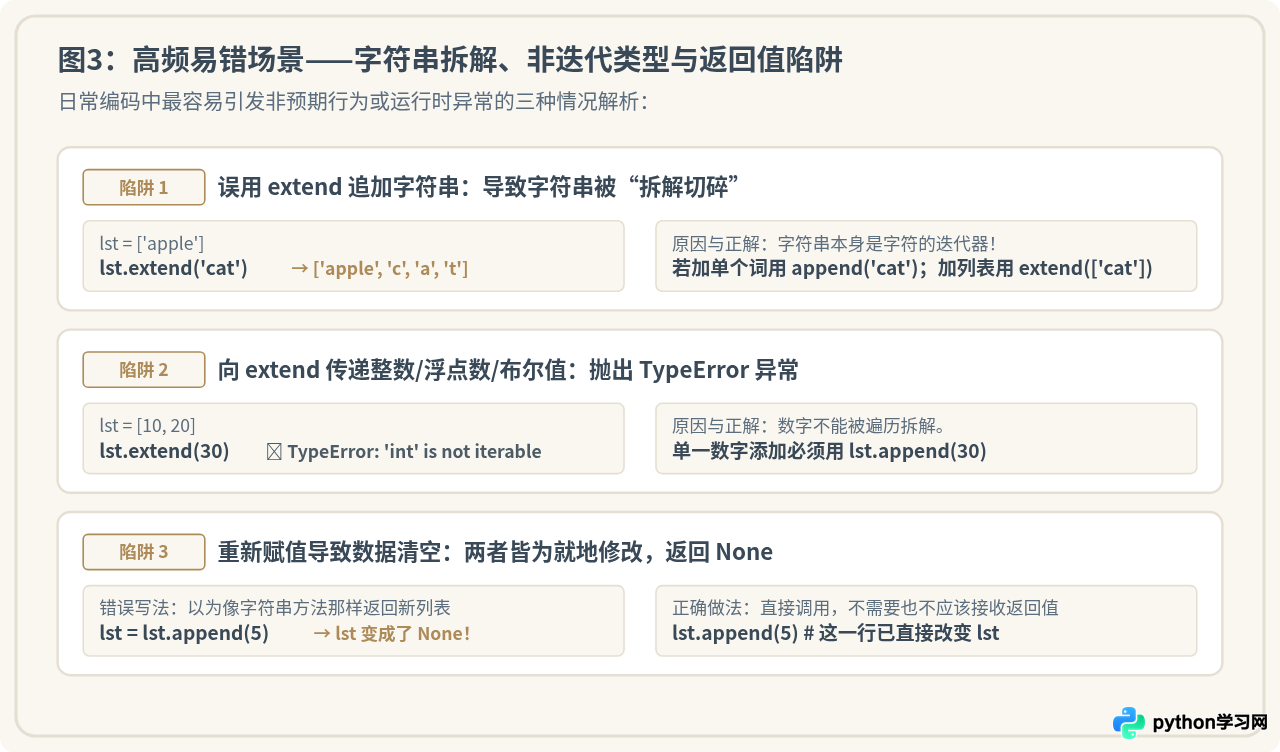
陷阱 1:误将字符串传给 extend,导致单词被切碎成字符
在 Python 中,字符串(str)本身就是一个可迭代对象。如果希望将单词 'cat' 追加到列表尾部,误用了 extend(),Python 会将字符串当作由字符 'c'、'a'、't' 组成的序列进行解包:
tags = ['python', 'backend']

# 错误写法:本意是添加一个标签 'django'
tags.extend('django')
print("切碎后的结果:", tags)
# 示例输出:切碎后的结果: ['python', 'backend', 'd', 'j', 'a', 'n', 'g', 'o']

# 正确写法 A:使用 append 追加单个单词
tags = ['python', 'backend']
tags.append('django')
print("append 正确结果:", tags)
# 示例输出:append 正确结果: ['python', 'backend', 'django']

# 正确写法 B:如果坚持用 extend,必须包装成列表
tags = ['python', 'backend']
tags.extend(['django'])
print("extend 包装列表结果:", tags)
# 示例输出:extend 包装列表结果: ['python', 'backend', 'django']
陷阱 2:向 extend 传递非可迭代对象抛出 TypeError
数字类型(int, float)在 Python 中不是可迭代对象。很多开发者在循环中动态追加统计数值时,误用了 extend:
scores = [90, 85]

# 错误示例:数字无法被迭代
try:
    scores.extend(95)
except TypeError as e:
    print("发生错误:", e)
    # 示例输出:发生错误: 'int' object is not iterable

# 正确写法:单值数字必须用 append
scores.append(95)
print("修正后 scores:", scores)
# 示例输出:修正后 scores: [90, 85, 95]
陷阱 3:试图获取方法返回值(重新赋值得到 None)
由于 append() 和 extend() 都是原地修改列表(in-place mutation),它们执行后的返回值固定为 None。绝不能像调用字符串方法(如 str.replace())那样对原变量重新赋值:
data = [1, 2, 3]

# 严重致命错误:重新赋值让变量变为 None
data = data.append(4)
print("赋值后的变量:", data)
# 示例输出:赋值后的变量: None

# 正确做法:直接调用,不需要也不应该接收返回值
valid_data = [1, 2, 3]
valid_data.append(4)
print("正确使用原变量:", valid_data)
# 示例输出:正确使用原变量: [1, 2, 3, 4]
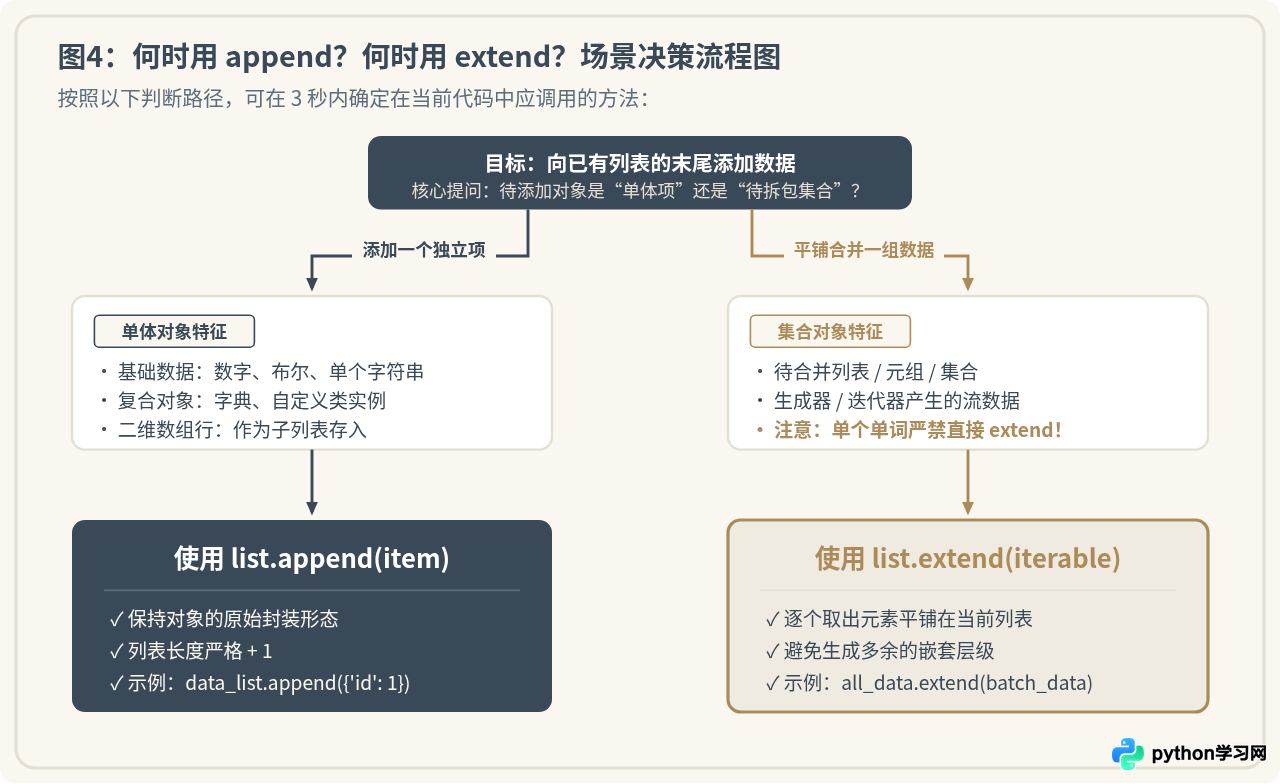
四、何时用 append?何时用 extend?场景决策指南
在面对具体的业务场景时,可以通过一个极简的“两步判断法”快速决策:
第一步看目标结构:你希望列表最终是增加“一个项”还是“多个项”?如果最终列表只应该多出一个新元素,无论它是什么,毫不犹豫选择 append()。
第二步看参数来源:你是否正在从数据库、网络接口或另一个批次中拿到一批数据,并希望将这批数据并入当前列表?如果是,确认它是列表或集合后,毫不犹豫选择 extend()。
经典实战场景对照
- 场景 A:逐行追加日志或数据库单条记录
每条记录通常是一个字典或对象(例如record = {'id': 101, 'status': 'ok'})。需要将整条记录作为一个元素保存,必须使用log_list.append(record)。 - 场景 B:构建二维矩阵或树节点
需要保留行与列的层级关系(例如生成坐标矩阵matrix.append([x, y])),必须使用append()才能形成子列表嵌套。 - 场景 C:分页加载或批量拉取合并
第 1 页拉取了 20 条商品page_1 = [item1, item2, ...],第 2 页拉取了 20 条商品page_2 = [...]。需要平铺为一个包含 40 条商品的总列表,必须使用all_items.extend(page_2)。 - 场景 D:消费生成器或过滤器流
通过生成器表达式过滤得到一批数据gen = (x * 2 for x in raw if x > 0),希望全部装入现有列表中,使用result.extend(gen)能够直接抽干生成器并平铺存入。
五、扩展对比:extend 与 +、+= 操作符的区别
在合并两个列表时,许多开发者常在 extend()、加号 + 和自增赋值 += 之间产生疑惑。了解它们的内存开销差异对于编写高性能代码至关重要:
# 1. 加号运算符 (+):产生新列表,原列表完好无损
a = [1, 2]
b = [3, 4]
c = a + b
print("c:", c)  # [1, 2, 3, 4]
print("a:", a)  # [1, 2],a 没有发生任何改变

# 2. += 运算符:在底层其实就是调用了 extend()
a = [1, 2]
a += [3, 4]
print("+= 后的 a:", a)  # [1, 2, 3, 4],a 被原地修改了!
需要特别注意性能与内存消耗:当两个列表的数据量达到数十万级别时,使用 list_a + list_b 会在内存中完整复制两份数据以创建第三个新列表,内存消耗瞬间翻倍;而 list_a.extend(list_b) 或 list_a += list_b 直接利用 list_a 已经预分配的内存空间进行扩容,内存利用率和执行速度远优于 + 加号运算。
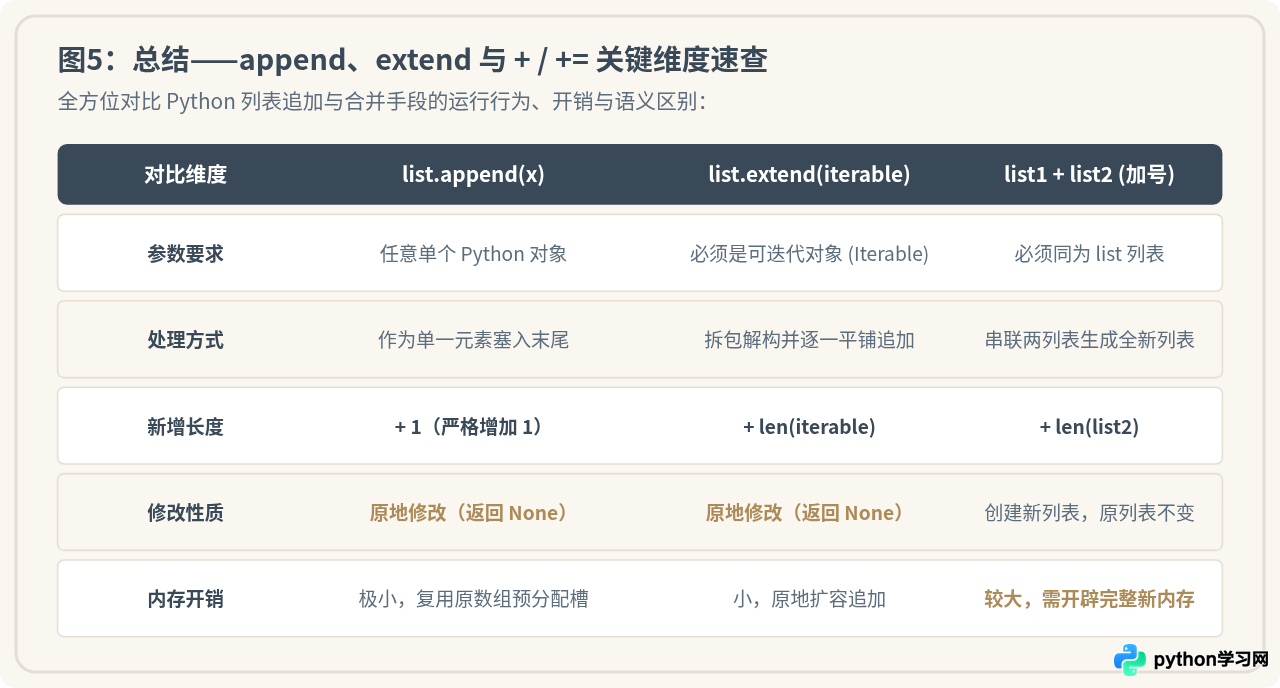
六、快速总结对照表
最后,将本文介绍的核心概念整理为速查表,方便日常编码查阅:
| 方法 / 语法 | 接收参数 | 新增元素数量 | 内部结构变化 | 返回值 | 典型适用场景 |
|---|---|---|---|---|---|
append(x) |
任意单对象(数字、字符串、列表、字典) | 严格为 1 | 保持传入对象的整体封装,若传列表则形成嵌套 | None |
单条记录追加、保留嵌套层级、二维矩阵行填充 |
extend(iterable) |
可迭代对象(列表、元组、集合、生成器) | len(iterable) |
拆散解构内部元素,完全平铺到底层列表 | None |
多批次列表合并、分页数据汇聚、消费生成器流 |
list1 + list2 |
必须均为列表 | len(list2) |
合并并产生全新列表,原列表不受任何影响 | 全新列表对象 | 需要保留原始列表不受污染的纯函数式计算场景 |
list1 += list2 |
任意可迭代对象(底层调用 extend) | len(list2) |
原地修改 list1,拆包平铺 |
自身引用 | 偏好简写语法的列表批量追加场景 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















