


Python多线程与多进程的内存共享及通信机制差异
深入对比Python多线程与多进程在内存空间共享、数据同步以及通信机制上的核心差异、底层实现开销与工程选型指导。
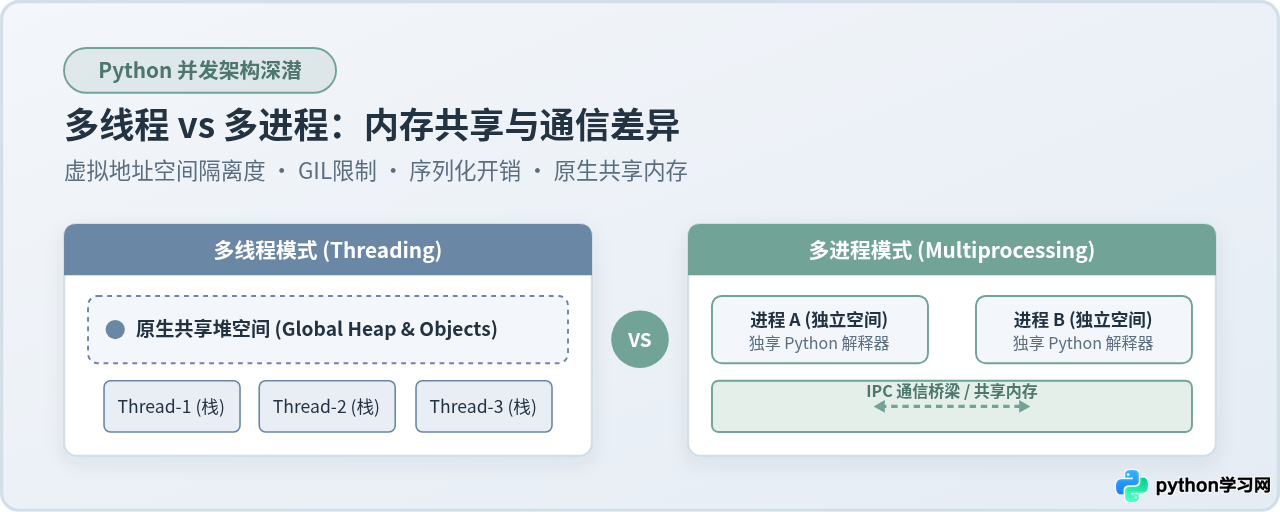
一、内存空间模型:原生共享堆空间 vs 隔离虚拟地址
理解 Python 并发模型的前提,是厘清操作系统为线程与进程分配的内存结构。任何 Python 实例启动时,操作系统都会为其映射一个独立的私有虚拟地址空间。在进程内部,所有由 threading.Thread 衍生出的线程,都驻留在该进程的虚拟内存空间内。
1. 多线程的共享内存机制
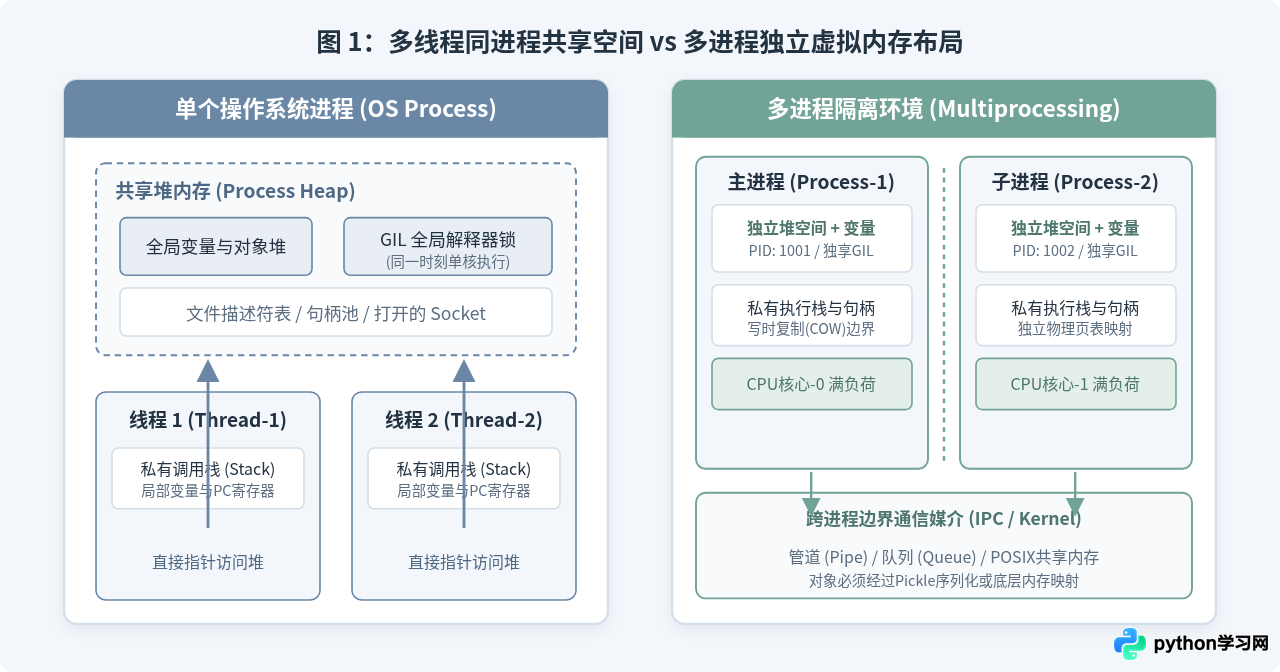
在多线程程序中,所有线程共享进程的代码段、堆内存、全局变量表以及打开的文件描述符。线程间唯一的私有资产是其独立的调用栈(Stack)和程序计数器(PC寄存器),用于记录各自的函数调用链与局部临时变量。
- 极速读写与指针传递:线程 A 在堆中实例化的任何 Python 对象(如列表、字典、自定义类),线程 B 可以直接通过该对象的内存地址引用读写,中间没有任何内存拷贝与数据转换,访问速度仅取决于内存总线速度。
- 缺乏隔离带来的竞态风险:共享堆直接暴露了并发修改的隐患。在没有互斥锁保护的情况下,多个线程对非原子操作(例如简单的
counter += 1)并发写操作会导致字节码级别的插队执行,引发严重的脏读与数据覆盖。 - GIL 的制约:由于所有线程共享解释器内部的内存管理系统与垃圾回收状态(PyObject 的引用计数
ob_refcnt),CPython 引入了全局解释器锁(GIL)。即使系统拥有 16 个 CPU 物理核心,同一时刻也只允许一个线程在解释器中执行 Python 字节码。因此,多线程无法实现 CPU 密集型任务的并行加速。
2. 多进程的内存隔离与写时复制(COW)
而 multiprocessing.Process 则完全不同。每个进程都由操作系统分配完全独立的虚拟页表、私有堆栈和私有全局变量空间,进程之间在用户态下无法直接看到彼此的物理内存。
- 独立的解释器与 GIL:每个 Python 子进程都完整加载自己的 CPython 解释器。进程 A 的 GIL 与进程 B 的 GIL 互不干涉,多进程因此能够均匀分散在操作系统的不同 CPU 物理核心上,实现真正的物理并行运算。
- 写时复制(Copy-on-Write)行为:在 Linux/macOS 的
fork创建模式下,子进程刚诞生时会与父进程共享相同的只读物理内存页;只有当任一进程试图修改某块内存时,操作系统内核才会触发缺页异常并拷贝该内存页。然而,Python 对象的引用计数机制会导致写时复制迅速失效:即使只是读取一个 Python 对象,其ob_refcnt引用计数的增减也会触发内存写操作,导致操作系统将整个内存页复制一份,从而大幅增加内存驻留集。 - 修改互不影响:在子进程中对全局变量执行重新赋值或追加元素,改动的仅仅是子进程私有内存页中的拷贝,主进程的同名变量完全不会发生改变。
下面的简短对比展示了全局变量在多线程与多进程下的截然不同表现:
import threading
import multiprocessing

shared_list = []

def append_item(val):
    shared_list.append(val)

if __name__ == '__main__':
    # 1. 验证多线程共享
    t = threading.Thread(target=append_item, args=(100,))
    t.start()
    t.join()
    print(f"[多线程] 主线程读取 shared_list: {shared_list}")

    # 重置列表
    shared_list = []

    # 2. 验证多进程隔离
    p = multiprocessing.Process(target=append_item, args=(200,))
    p.start()
    p.join()
    print(f"[多进程] 主进程读取 shared_list: {shared_list}")
[多进程] 主进程读取 shared_list: []
运行结果直观地印证了内存模型:线程修改的正是主线程所见的同一个列表;而进程虽然也执行了 append(200),但由于它操作的是独立的地址空间,子进程退出后其私有修改随之销毁,主进程的 shared_list 依然是空列表。
二、通信机制与开销差异:直接引用 vs 序列化IPC管道
正因为多进程的内存互相隔离,进程之间要“交换计算结果”或“分发任务指令”,就必须建立跨进程通信(IPC, Inter-Process Communication)桥梁。
1. 线程间通信:纳秒级的引用转移
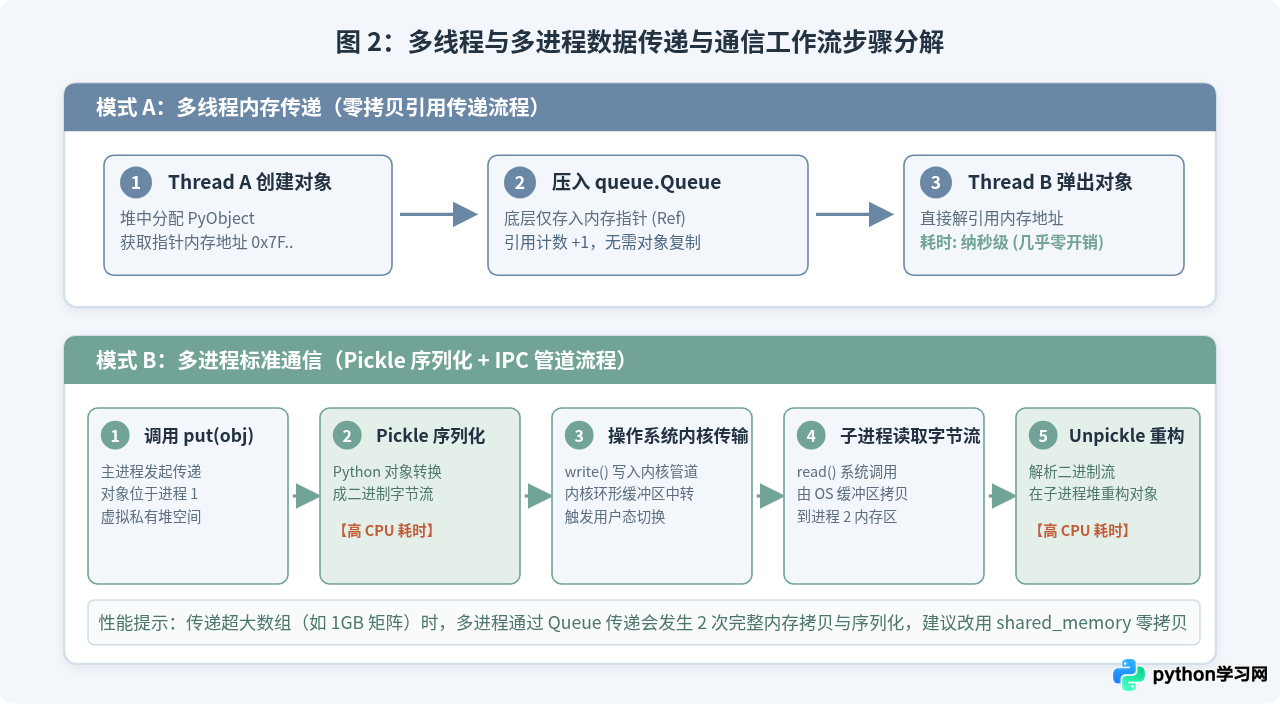
在多线程中,推荐使用标准库 queue.Queue 进行通信。其底层实现极其轻量:
- 本质上是一个由互斥锁(
threading.Lock)和条件变量(threading.Condition)保护的collections.deque双端队列。 - 当生产者线程调用
queue.put(item)时,它传递的仅仅是item对象的 64 位内存指针(同时将其引用计数加 1)。 - 消费者线程调用
queue.get()时直接读取该指针并返回对象。全过程耗时通常在微秒甚至纳秒级别,不会产生任何数据拷贝或编码转换。
2. 进程间通信:重型序列化与内核中转链路
当使用 multiprocessing.Queue 或 multiprocessing.Pipe 在进程间传递数据时,底层机制与线程队列截然不同。由于两个进程的虚拟地址互不相通,直接发送内存地址毫无意义(0x7F... 在另一个进程中可能未分配或指向完全不同的数据)。因此必须经历如下五个完整步骤:
- 发起阶段:发送端进程调用
queue.put(obj)。 - 序列化阶段(Pickle dumps):Python 在后台将复杂的堆对象转换为连续的二进制字节流(Byte Stream)。这一步需要遍历对象的属性与嵌套结构,是极度消耗 CPU 算力与内存带宽的操作。
- 内核写入阶段:后台辅助线程(Feeder Thread)调用操作系统的
write()系统调用,将二进制流从用户态拷贝到内核态的匿名管道(Pipe)或本地套接字(UNIX Domain Socket)缓冲区中。 - 内核读取阶段:接收端进程调用
read()系统调用,将管道中的二进制数据流从内核缓冲区拷贝到本进程的用户态内存空间。 - 反序列化阶段(Pickle loads):接收端解释器解析二进制字节流,在自己的私有堆空间中重新分配内存,构造出一个结构相同的全新对象。
多进程传递必须满足对象可序列化(Picklable)。如果试图通过
multiprocessing.Queue 传递打开的数据库连接、文件句柄、Socket 描述符、生成器对象或带有复杂外部闭包的匿名函数(lambda),系统将抛出 PicklingError 或 TypeError: cannot pickle '...' object 异常。
三、通信与同步工具全景及底层实现对比
为了满足不同的协作需求,Python 提供了多种不同层级的并发工具。开发者需要根据数据传递的频率与数据量大小,选择合适的通信原语。
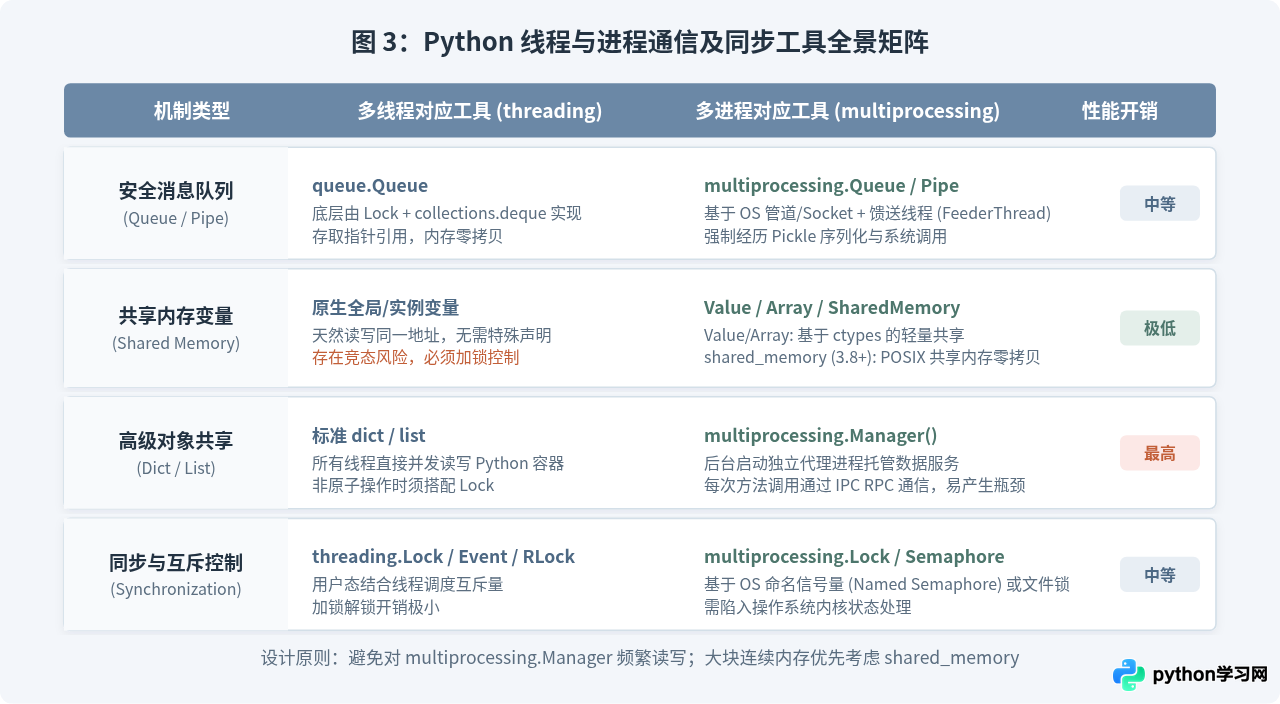
1. 消息通信型:Queue 与 Pipe
queue.Queue:专为多线程设计,线程安全,内存消耗仅为对象指针本身,吞吐量极高。multiprocessing.Queue:多进程安全,内部由操作系统管道、底层锁和一个专用的缓冲区馈送线程组合而成,支持多生产者多消费者模式。multiprocessing.Pipe:返回一对双向连接端(conn1, conn2),开销略低于multiprocessing.Queue,专用于点对点(1 对 1)进程间快速通信。如果只有两个进程协作,Pipe 的吞吐表现明显优于 Queue。
2. 原生共享内存型:Value / Array 与 SharedMemory
如果需要在多进程间高频传递大量数据(例如千万级元素数组或高分辨率图像帧),频繁使用 Queue 触发 Pickle 会瞬间击垮 CPU 并引发垃圾回收停顿。此时必须使用物理层面的共享内存:
multiprocessing.Value / Array:基于 C 语言标准的ctypes结构,在操作系统共享内存区开辟一段连续的固定格式空间(如单个整数、浮点数或定长数组)。底层内置互斥锁,访问速度极快,但仅支持 C 基本数据类型。multiprocessing.shared_memory(Python 3.8+ 新增):这是现代 Python 解决跨进程大数据传输的核心方案。它直接在操作系统的共享内存段(Linux 的/dev/shm或 POSIX 共享内存)申请一块匿名或命名的内存块,各个进程可以通过内存映射(mmap)将其直接挂载到本进程地址空间。与 NumPy ndarray 的buffer协议配合,能够实现真正的跨进程零拷贝数组共享。
以下示例展示了子进程如何直接就地计算父进程分配的 100 万个浮点数矩阵,完全避开序列化开销:
import multiprocessing as mp
from multiprocessing import shared_memory
import numpy as np

def worker_process(shm_name, shape, dtype):
    # 1. 通过共享内存名称附加到现存内存块
    existing_shm = shared_memory.SharedMemory(name=shm_name)

    # 2. 将共享字节缓冲区映射为本地 NumPy 数组(零内存拷贝)
    shared_arr = np.ndarray(shape, dtype=dtype, buffer=existing_shm.buf)

    # 3. 直接在共享内存上进行原地计算
    shared_arr *= 2

    # 4. 关闭本进程对该内存块的句柄
    existing_shm.close()

if __name__ == '__main__':
    # 准备 100 万个元素的测试数组
    data = np.ones((1000, 1000), dtype=np.float64) * 3.5

    # 创建系统级共享内存块
    shm = shared_memory.SharedMemory(create=True, size=data.nbytes)

    # 将 NumPy 数组挂载到共享内存
    shm_arr = np.ndarray(data.shape, dtype=data.dtype, buffer=shm.buf)
    shm_arr[:] = data[:]  # 初始化写入数据

    print(f"子进程处理前,数组均值: {shm_arr.mean()}")

    p = mp.Process(target=worker_process, args=(shm.name, data.shape, data.dtype))
    p.start()
    p.join()

    print(f"子进程处理后,主进程直接读取均值: {shm_arr.mean()}")

    # 必须显式释放与销毁共享内存,避免系统级资源泄露
    shm.close()
    shm.unlink()
子进程处理后,主进程直接读取均值: 7.0
3. 代理容器型:multiprocessing.Manager
Manager() 提供了一种看似最方便的跨进程数据共享方案——它支持跨进程直接读写 list、dict 和 Namespace 等标准 Python 容器。
但其底层代价极其高昂:Manager 实际上是在后台独立运行了一个专门的代理服务器进程(Server Process)。当某个工作进程执行 d['key'] = value 时,该操作并不是直接改写内存,而是通过本地 Socket 触发了一次远程过程调用(RPC)。代理进程收到请求后执行赋值,再将确认结果网络回传。如果工作进程频繁循环读写 Manager 字典,程序性能通常会下降数倍至数十倍。
四、选型指南与工程避坑实践
在实际项目落地时,选用多线程还是多进程、搭配何种通信工具,应当依据计算负载类型与数据流动模式进行科学决策。
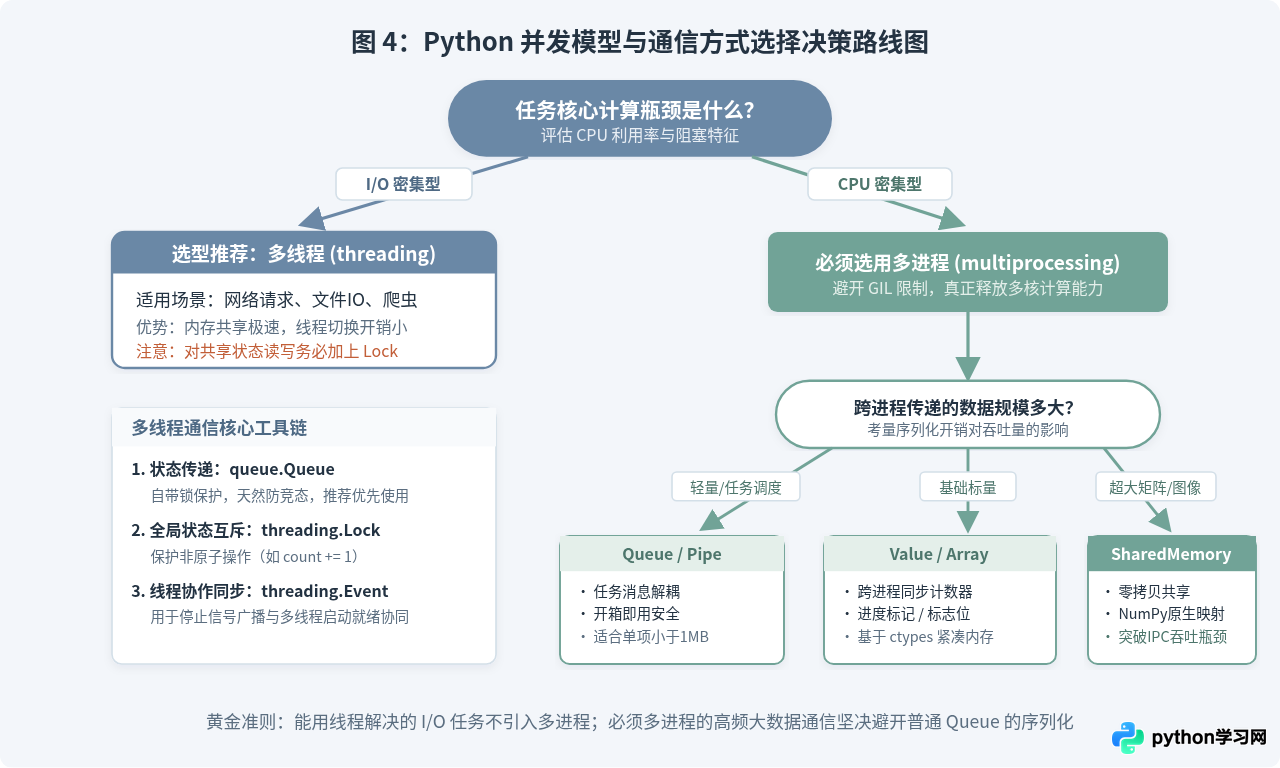
1. 选型四步法决策标准
- 判断算力瓶颈所在:
- I/O 密集型(网络爬虫、文件读取、REST API、数据库高频访问):首选
threading或asyncio。线程启动轻量,内存消耗仅为每个线程几百 KB 至数 MB,各线程间状态共享极其容易。 - CPU 密集型(科学运算、图像编码、机器学习推理、复杂数据解析):必须选用
multiprocessing,以绕过 GIL 充分利用全部物理核心。
- I/O 密集型(网络爬虫、文件读取、REST API、数据库高频访问):首选
- 衡量数据交互频率与体量:
- 传递任务状态、字符串参数、小字典(< 100 KB):使用
multiprocessing.Queue或Pipe,简单易用,可靠性高。 - 只读大配置数据:借助 Unix
fork模式的初始共享特性,或使用multiprocessing.shared_memory。 - 连续大规模数值矩阵(> 10 MB):坚决避免使用 Queue 序列化,直接选用
multiprocessing.shared_memory搭配 NumPy 缓冲区映射。
- 传递任务状态、字符串参数、小字典(< 100 KB):使用
2. 常见工程陷阱与注意事项
- 陷阱一:Queue 的死锁诱因(Feeder 线程未刷新):在向
multiprocessing.Queue塞入大对象后,若主进程过早调用p.terminate()或p.join(),后台的馈送线程可能仍在等待写入底层管道。由于管道缓冲区满且接收端已退出,进程将永久挂起陷入死锁。防范方案是先从队列完全取出数据,再调用queue.close()和queue.join_thread()。 - 陷阱二:误以为多线程有 GIL 就不需要加锁:GIL 仅保证单个 Python 字节码指令的原子性执行,而不保证多条字节码操作的时序安全。例如
count += 1在底层由LOAD_GLOBAL、LOAD_CONST、INPLACE_ADD、STORE_GLOBAL四条指令构成,线程调度可在任意指令间切换。没有threading.Lock保护,累加必然出现数据丢失。 - 陷阱三:SharedMemory 的孤儿资源泄漏:多进程中的共享内存属于操作系统内核管辖资源,不会因 Python 程序的简单崩溃或异常退出而自动回收。在长期运行的服务器中,若未在
finally块中调用shm.unlink(),会导致系统共享内存区(如/dev/shm)被逐渐占满,直到触发No space left on device错误。
3. 核心机制特性速查总结
| 对比维度 | 多线程 (threading) | 标准多进程 (multiprocessing) | 原生共享内存多进程 (SharedMemory) |
|---|---|---|---|
| 内存地址空间 | 单一进程空间,堆内存天然全员共享 | 各进程完全隔离,私有虚拟页表 | 私有页表 + 映射同一块内核共享物理页 |
| 数据传输开销 | 纳秒级(直接解引用对象内存指针) | 毫秒级(经历 Pickle 序列化与管道复制) | 纳秒级(零拷贝直接操作底层内存块) |
| CPU 核心利用 | 受 GIL 限制,单核轮流执行 | 每个进程独占解释器,充分利用多核 | 独占解释器,充分利用多核 |
| 安全控制成本 | 必须借助互斥锁避免脏写与竞态 | 自带物理隔离屏障,数据默认安全 | 需搭配进程锁(multiprocessing.Lock) |
| 崩溃容错性 | 单个线程异常若未捕获,全进程崩溃 | 子进程异常崩溃,主进程依然稳定运行 | 子进程崩溃不影响主进程,但需回收共享段 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















