


为什么Python代码要优先使用内置函数?性能与原理分析
深入分析Python中优先使用内置函数的原因。从CPython的底层C实现、虚拟机字节码调度、动态作用域查找开销以及内存优化等维度,全面解析内置函数的性能优势与底层工作原理。
从一个典型的累加求和案例说起
编写循环累加操作是日常编码中最基础的任务之一。当我们需要对一个包含100万个整数的列表计算总和时,直觉通常有两种写法:使用传统的 for 循环,或者直接调用内置的 sum() 函数。表面上看,二者都是顺序访问每个元素并累加到一个中间变量中,时间复杂度均为 $O(n)$,但在运行耗时上却存在数倍的悬殊。
import timeit

# 定义原生 Python 循环累加
def custom_sum(numbers):
    total = 0
    for num in numbers:
        total += num
    return total

# 准备测试数据:100万个随机整数
setup_code = """
from __main__ import custom_sum
data = list(range(1_000_000))
"""

# 分别计时 50 次取平均时间
t_loop = timeit.timeit("custom_sum(data)", setup=setup_code, number=50) / 50
t_builtin = timeit.timeit("sum(data)", setup=setup_code, number=50) / 50

print(f"原生 for 循环单次耗时: {t_loop * 1000:.2f} ms")
print(f"内置 sum() 单次耗时:     {t_builtin * 1000:.2f} ms")
print(f"性能比率: 内置函数比原生循环快约 {t_loop / t_builtin:.2f} 倍")
内置 sum() 单次耗时: 12.18 ms
性能比率: 内置函数比原生循环快约 3.17 倍
在同等算法复杂度下,相同的机器上运行 sum() 的速度往往是纯 Python 循环的 3 到 5 倍。如果改用 map()、列表推导式、any()、all() 或 min()/max(),也会观察到类似的性能提升现象。这种现象并非偶然优化,而是由 CPython 虚拟机的工作方式决定的。
解释器架构:字节码解释 vs 本地C执行
要理解执行速度的差距,首先需要审视 CPython 执行 Python 代码的具体链路。Python 是一种解释型语言,源代码在执行前首先被词法语法分析器转换为中间字节码(Bytecode),然后再由评估循环(也就是经典的 _PyEval_EvalFrameDefault 函数)逐条解码并分发执行。
使用标准库自带的 dis 模块反编译上述两种方式,能够清晰看到执行机制的本质区别:
import dis

print("=== custom_sum 的字节码 ===")
dis.dis(custom_sum)
2 STORE_FAST 1 (total)
3 4 LOAD_FAST 0 (numbers)
6 GET_ITER
>> 8 FOR_ITER 6 (to 22)
10 STORE_FAST 2 (num)
4 12 LOAD_FAST 1 (total)
14 LOAD_FAST 2 (num)
16 BINARY_OP 0 (+)
18 STORE_FAST 1 (total)
20 JUMP_BACKWARD 7 (to 8)
>> 22 LOAD_FAST 1 (total)
24 RETURN_VALUE
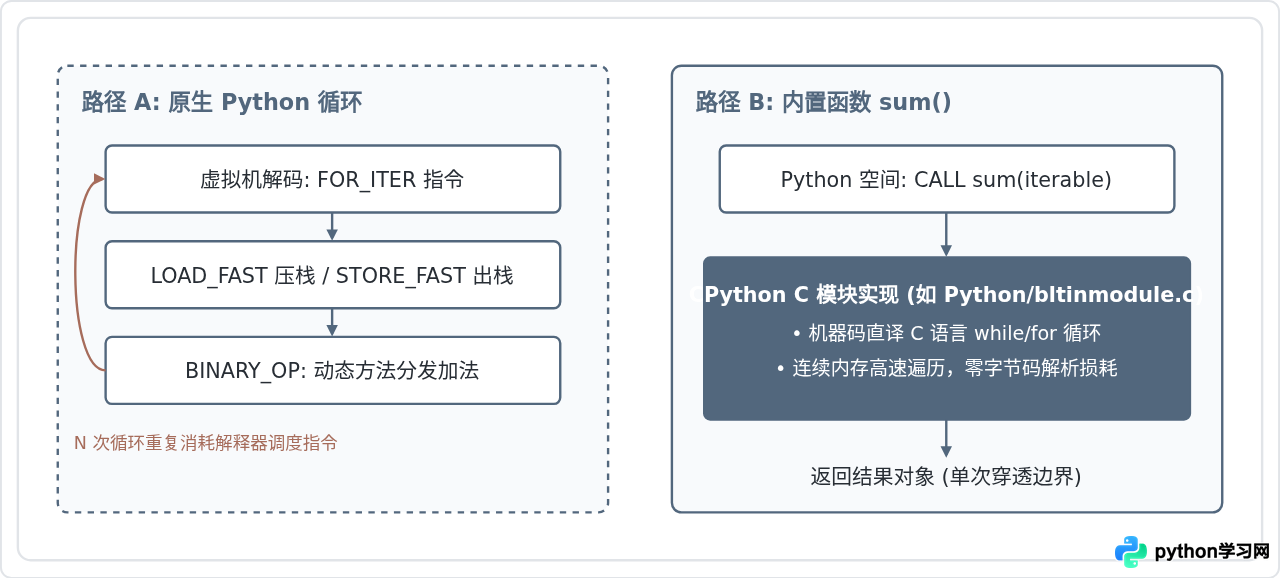
在原生循环中,对于列表中的每一个元素,评估循环都必须严格走完一整套字节码指令周期:FOR_ITER(拉取迭代器并检查越界)、STORE_FAST(将元素绑定到局部变量 num)、LOAD_FAST(读取 total 和 num)、BINARY_OP(执行加法)以及 STORE_FAST(写回结果)。当元素数量达到 100 万时,虚拟机总共要调度几百万次指令跳转和栈顶推拉操作。每次操作都要经历 C 语言级别的 switch-case 分发机制。
相比之下,调用内置函数 sum(data) 时,Python 虚拟机仅在顶层产生两次参数压栈和一个 CALL 指令。随后控制权便直接移交给了由 C 语言编译的本地扩展函数。
深度解构:内置函数更快的四大底层机制
除了规避字节码解释循环之外,内置函数在 CPython 内部还享有多项架构层面的优化,这些共同筑牢了它的性能壁垒。
1. 静态机器码执行与硬件分支预测
Python 内置函数在编译 Python 解释器时,直接被编译为平台相关的本地机器指令(Native Code)。在 C 层面的 while 循环中,CPU 可以充分利用分支预测单元(Branch Predictor)、流水线(Pipelining)以及指令级并行;而在 Python 字节码循环中,每一次调度对于底层硬件来说都是间接分支跳转,不仅破坏了指令流水线,还极易引发 CPU 分支预测失败。
2. 绕过通用对象系统的协议快速通道
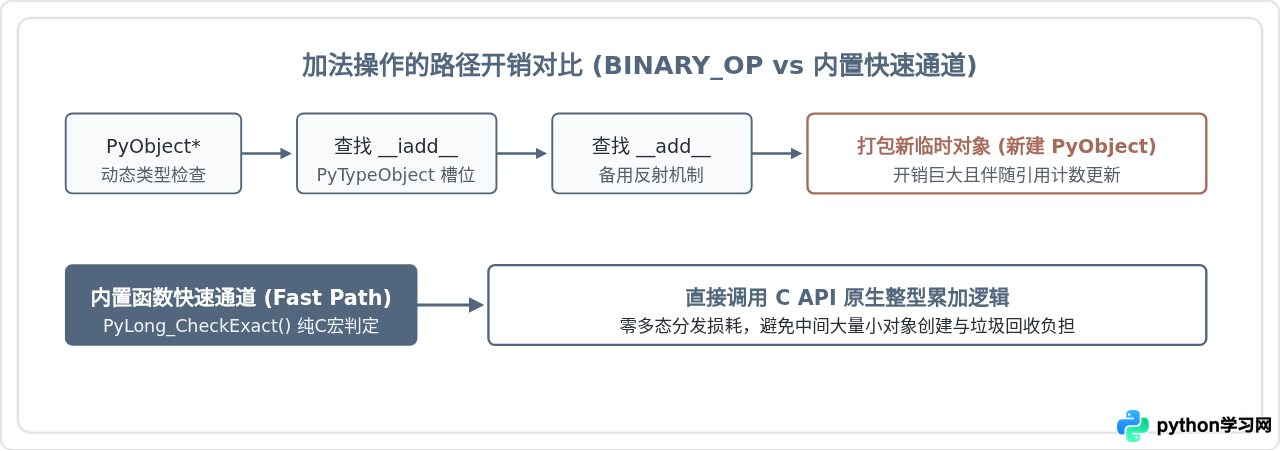
在纯 Python 代码中,进行两个变量相加(total += num),解释器为了遵循鸭子类型(Duck Typing)的灵活性,必须经历一系列通用的检查:确定左操作数类型、查找 __iadd__ 特殊方法;若未定义则回退查找 __add__;若不支持再尝试右操作数的 __radd__。
内置函数在其 C 实现中大量使用了“快速路径(Fast Paths)”。以 sum() 为例,其源码内部直接对常见数值类型(如 long/int 和 float)进行了针对性的快速判断与就地求和,绕过了庞大复杂的面向对象动态分发系统。
3. LEGB 作用域查找链的损耗差异
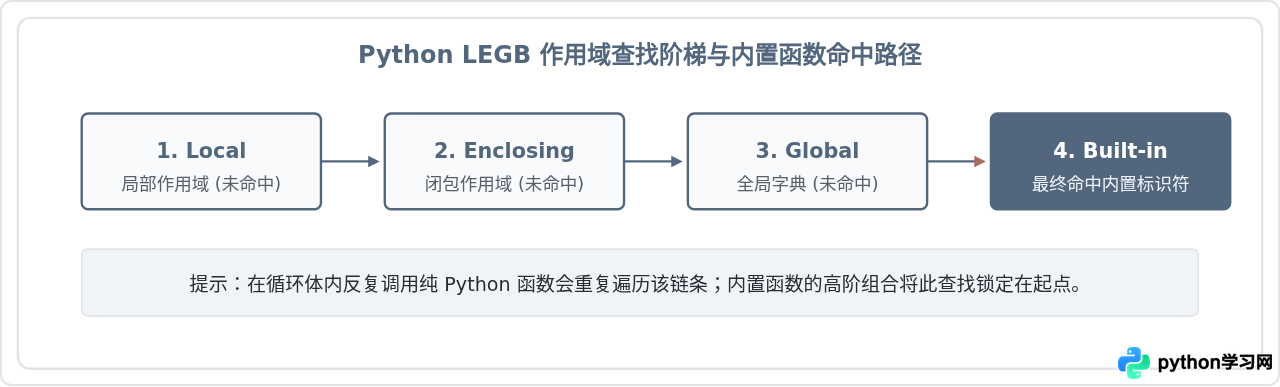
Python 解析变量名遵循 Local → Enclosing → Global → Built-in 的查找顺序规则。每次在 Python 代码中引用一个不在局部命名空间的函数名时,解释器都需要依次检查这些字典。
看下面这个常见的性能反模式:
# 糟糕的写法:在循环体内部重复查找内置函数或全局对象
def process_data(items):
    result = []
    for item in items:
        # 每一次循环都会触发一次对 str 作用域查找
        result.append(str(item))
    return result

# 改进的写法 1:利用内置 map 函数,查找仅发生一次
def process_data_fast(items):
    return list(map(str, items))
在 for item in items 内部执行 str(item) 时,由于 str 位于最外围的 Built-in 命名空间,解释器必须先查局部字典、查全局字典,最后在 builtins 字典中命中。而使用 map(str, items) 时,整个查找过程只在传入参数的瞬间发生一次,随后的数万次调用都在 C 实现的迭代中直接使用预先拿到的函数指针。
4. 内存连续性与缓存亲和力(Cache Locality)
许多内置函数直接支持 C 级别的缓冲区协议(Buffer Protocol)。当对切片、数组或列表执行 bytes()、min()、max() 或 sorted() 时,CPython 可以在底层直接操作连续的内存块,而无需为中间过程创建 Python 包装对象。这使得现代 CPU 的 L1/L2 缓存能够高效预取数据,大大降低了内存延迟。
实际工程中的选型场景与操作建议
明确了内置函数的原理优势后,如何将这些理解转化为高效率的代码?在日常开发中,可以遵循以下四项典型场景的重构模式:
-
聚合与过滤计算: 遇到统计累加、极端值筛选或布尔验证时,坚决用
sum()、min()、max()、any()、all()替代循环。对于布尔检查,内置函数还具备天然的短路求值特性。 -
容器与序列排序: 优先使用内置的
sorted()或列表就地排序方法list.sort()。二者底层均为 Timsort(或更新版本引入的 Powersort),是使用高优化 C 代码实现的混合稳定排序算法,其工程细节远优于用纯 Python 手写的任何排序逻辑。 -
集合与字典构建: 当需要从序列建立映射或排除重复时,直接使用
dict.fromkeys()、set()或字典推导式,而不是显式创建空集合并逐个调用.add()。 -
循环解耦: 善用
zip()和enumerate()。这不仅减少了手动维护下标的潜在越界风险,而且这两个内置类型产生的是惰性 C 迭代器,节约内存开销。
虽然内置函数速度快,但在某些场景下需注意边界条件。例如对海量生成器使用
sum() 时,由于其无法在 C 层面预判序列长度,依然必须逐个拉取元素并产生边界穿透。此外,如果逻辑分支极其繁杂,硬拼 reduce()、map() 和 filter() 可能会让代码晦涩难懂。此时清晰的列表推导式往往是性能与工程可读性兼备的折中解。
全景总结与决策路径
掌握内置函数的优劣势,不仅能够帮助我们写出高效代码,更能建立对 Python 解释器行为的清晰直觉。在绝大多数场景下,追求高性能的第一选择不是引入三方库,而是审视当前代码是否充分激活了 CPython 官方提供的内置能力。
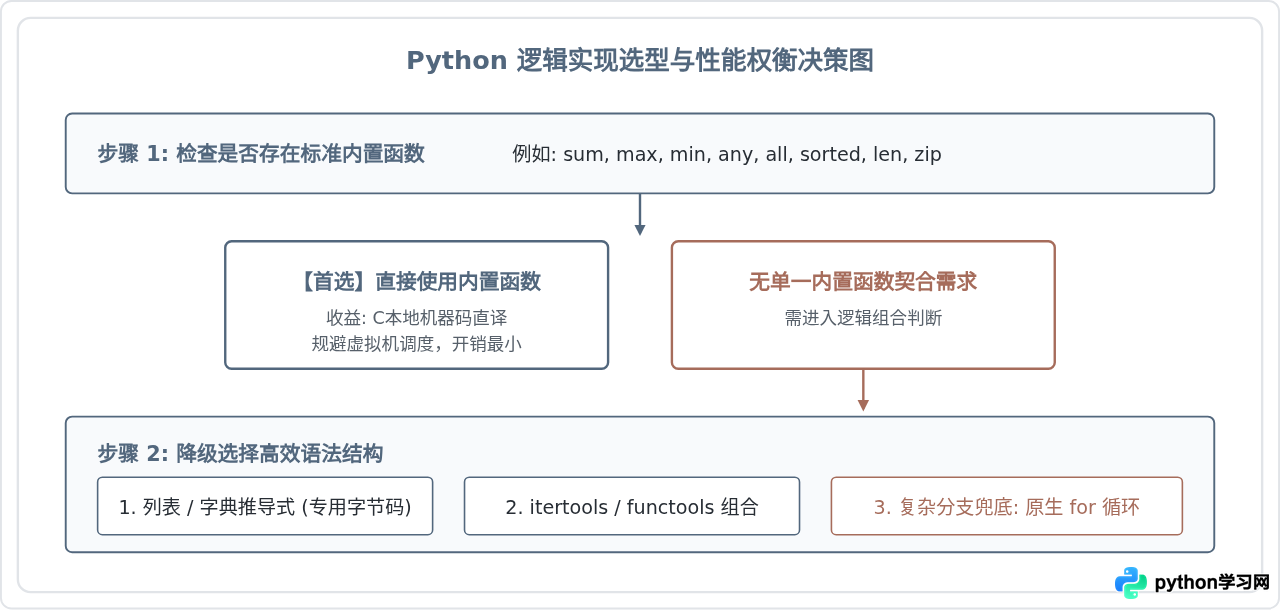
归结起来,Python “优先使用内置函数”并非一句空泛的风格倡议,而是针对解释型语言架构特点而生的高性价比优化策略。通过让底层经过充分工业级检验的 C 机器代码承担密集的运算与遍历循环,我们不仅能保留 Python 语言本身高表达力的敏捷优势,同时也能最大程度榨取系统的底层执行潜能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















