


轻量级Python爬虫脚本库:Requests-HTML与BeautifulSoup应用指南
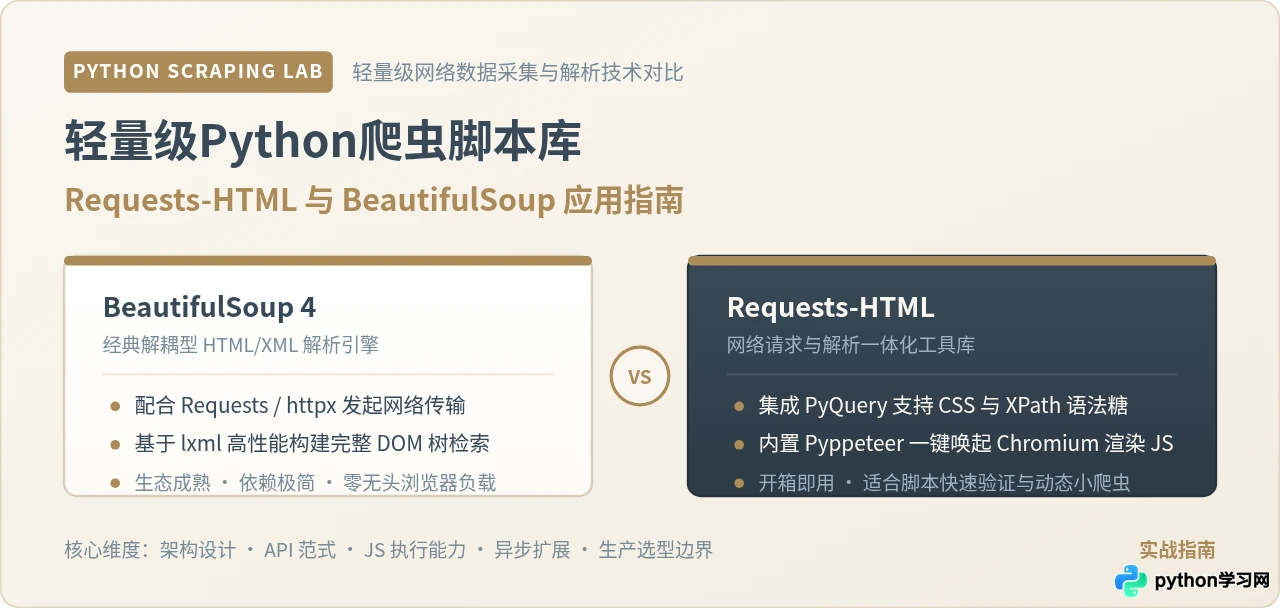
深入对比轻量级Python爬虫库Requests-HTML与BeautifulSoup的架构差异、核心API使用范式、动态渲染能力及生产环境选型依据,助你编写高效稳定的数据抽取脚本。
一、核心架构与设计思想拆解
理解一个库的适用边界,首先要认清其在爬虫流水线中所处的位置。虽然 BeautifulSoup 与 Requests-HTML 常在爬虫讨论中并提,但两者的职责范围与内部构造存在本质差异。
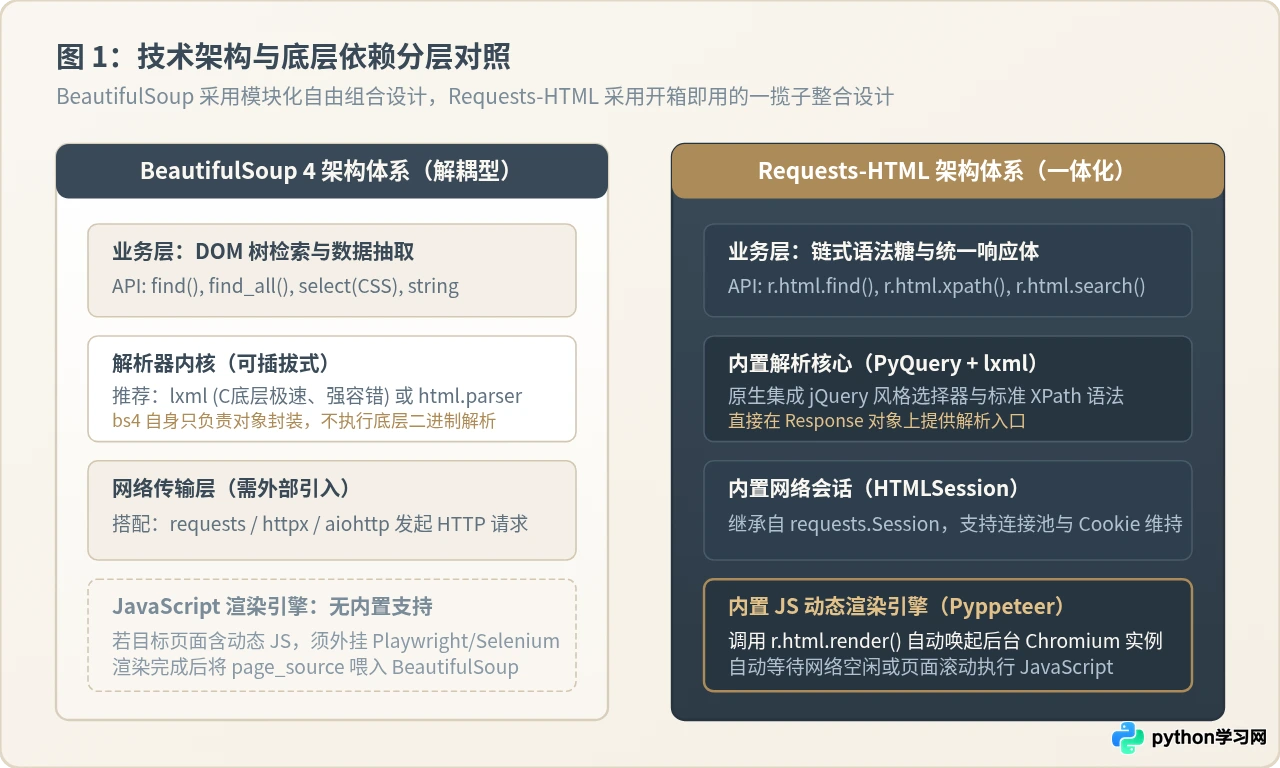
BeautifulSoup 4 严格遵循“单一职责”原则。它本质上只是一个 HTML/XML 文档树解析器与导航工具,本身并不具备任何网络请求或网络通信能力。在实际开发中,开发者必须借助 requests 或 httpx 获取远程 HTML 字符串,再将其传递给 BeautifulSoup 构建内存中的 DOM 节点树。同时,BeautifulSoup 自身也不实现底层的 HTML 语法标记词法分析,而是依赖外部解析库(如 lxml 或 Python 内置的 html.parser)。这种高度解耦的架构带来了极高的灵活性与轻量化优势:只要网络层与解析层各司其职,整个流程的内存占用与资源开销就极低。
Requests-HTML 则采用了“全包一体化”的设计思路。由 Requests 的原作者 Kenneth Reitz 主导设计,它的核心目标是在一行代码内完成“网络请求 + 静态 DOM 解析 + 可选的前端 JS 渲染”。它直接继承自 requests.Session,并将响应对象 Response 扩展为包含 HTML 解析接口的复合实体。其底层静态解析基于 PyQuery(类似 jQuery 的 CSS 选择器实现)和 lxml,动态渲染部分则封装了 pyppeteer,在需要时自动管理无头 Chromium 浏览器实例。
二、BeautifulSoup 实战指南:标准提取范式与工程防御
BeautifulSoup 是 Python 生态中最经典的解析工具之一。要将其稳定应用在日常抓取任务中,关键在于明确解析器的选择逻辑、熟练运用 CSS 选择器以及建立严格的空值安全防御机制。
1. 依赖安装与解析内核选择
在终端中执行以下命令安装必要依赖。请始终显式安装 lxml,避免使用 Python 内置的 html.parser 处理复杂的外部真实网页:
pip install beautifulsoup4 requests lxmlPython 默认的 html.parser 纯由 Python 编写,在处理上万行大体量 HTML 时性能显著落后于 C 语言实现的 lxml。更重要的是,真实网络中的网页常常充斥着标签未闭合、嵌套错乱等不规范代码。lxml 具备极强的容错修复能力,能够自动推断并修复残缺的 DOM 结构,防止解析器因非法标记崩溃或丢失关键节点。
2. 标准解析流程与防御范式
规范的 BeautifulSoup 处理流程包含四个明确步骤:设置带请求头的网络会话、基于 lxml 实例化解析树、使用 CSS 选择器批量获取卡片容器,以及对每个子字段实施空值容错提取。
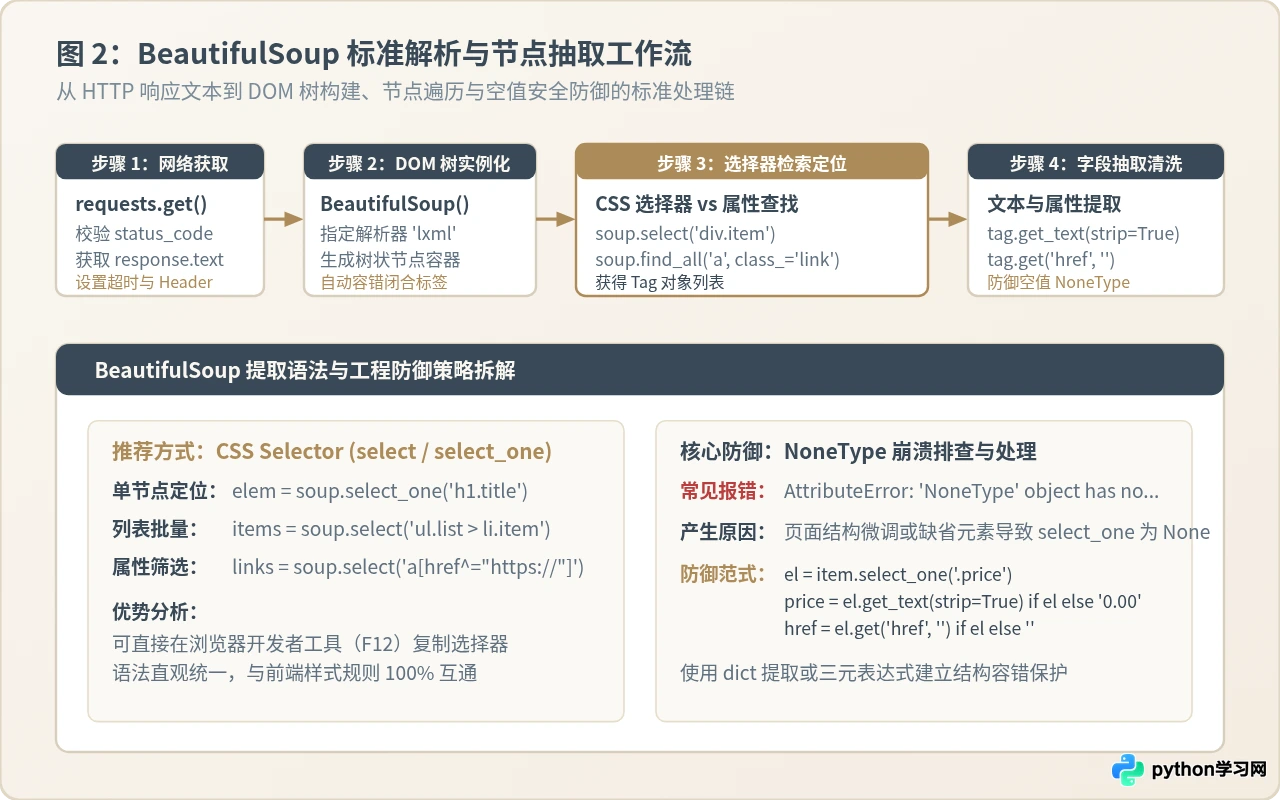
以下为一个完整可执行的脚本示例。代码通过爬取一个具备典型电商/文章结构的模拟数据源,演示如何安全抽取标题、链接与价格字段:
import requests
from bs4 import BeautifulSoup

def scrape_articles_demo():
    # 模拟目标页面 HTML(含规范节点与缺省异常节点)
    sample_html = """
    <div class="catalog">
        <article class="card">
            <h2 class="title"><a href="/post/101">Python 并发编程深入剖析</a></h2>
            <div class="meta">
                <span class="author">李工</span>
                <span class="reads">1,420 次阅读</span>
            </div>
        </article>
        <article class="card">
            <!-- 缺省标题链接的异常卡片 -->
            <h2 class="title">草稿:待发布指南</h2>
            <div class="meta">
                <span class="author">王工</span>
            </div>
        </article>
    </div>
    """

    # 1. 实例化 BeautifulSoup,显式指定 lxml 解析器
    soup = BeautifulSoup(sample_html, 'lxml')

    results = []
    # 2. 定位列表卡片容器
    cards = soup.select('div.catalog > article.card')

    for card in cards:
        # 3. 抽取标题节点(安全判断)
        title_tag = card.select_one('h2.title')
        title_text = title_tag.get_text(strip=True) if title_tag else "无标题"

        # 4. 抽取内部超链接(防御 NoneType 报错)
        link_tag = title_tag.select_one('a') if title_tag else None
        href = link_tag.get('href', '').strip() if link_tag else ""

        # 5. 抽取元数据
        author_tag = card.select_one('.meta .author')
        author = author_tag.get_text(strip=True) if author_tag else "匿名"

        reads_tag = card.select_one('.meta .reads')
        reads = reads_tag.get_text(strip=True) if reads_tag else "0 次阅读"

        results.append({
            "title": title_text,
            "url": href,
            "author": author,
            "reads": reads
        })

    return results

if __name__ == '__main__':
    data = scrape_articles_demo()
    for item in data:
        print(item)
{'title': '草稿:待发布指南', 'url': '', 'author': '王工', 'reads': '0 次阅读'}
在工程实践中,爬虫因改版或缺省数据崩溃的头号原因正是 AttributeError: 'NoneType' object has no attribute 'get'。如上述示例所示,对 select_one() 的结果执行三元条件判断是编写生产级 BeautifulSoup 代码必须遵守的纪律。
三、Requests-HTML 实战指南:静态极速与 JS 动态渲染
Requests-HTML 的诞生主要是为了解决传统爬虫面临的两个痛点:频繁在请求库与解析库之间传递原始文本,以及遇到轻度客户端 JavaScript 渲染页面时不得不额外配置重量级 Selenium 驱动。
1. 依赖安装与 Chromium 初始化
在终端中安装 requests-html:
pip install requests-html请注意:Requests-HTML 首次调用 r.html.render() 时,会自动调用底层的 pyppeteer 从 Google 官方仓库下载无头 Chromium 浏览器二进制包(约 150MB)。如果运行在没有外网直连权限的局域网或受限服务器中,这一步会发生网络超时。可通过预先在机器上配置 PYPPETEER_HOME 环境变量并将 Chromium 解压至对应目录来规避此问题。
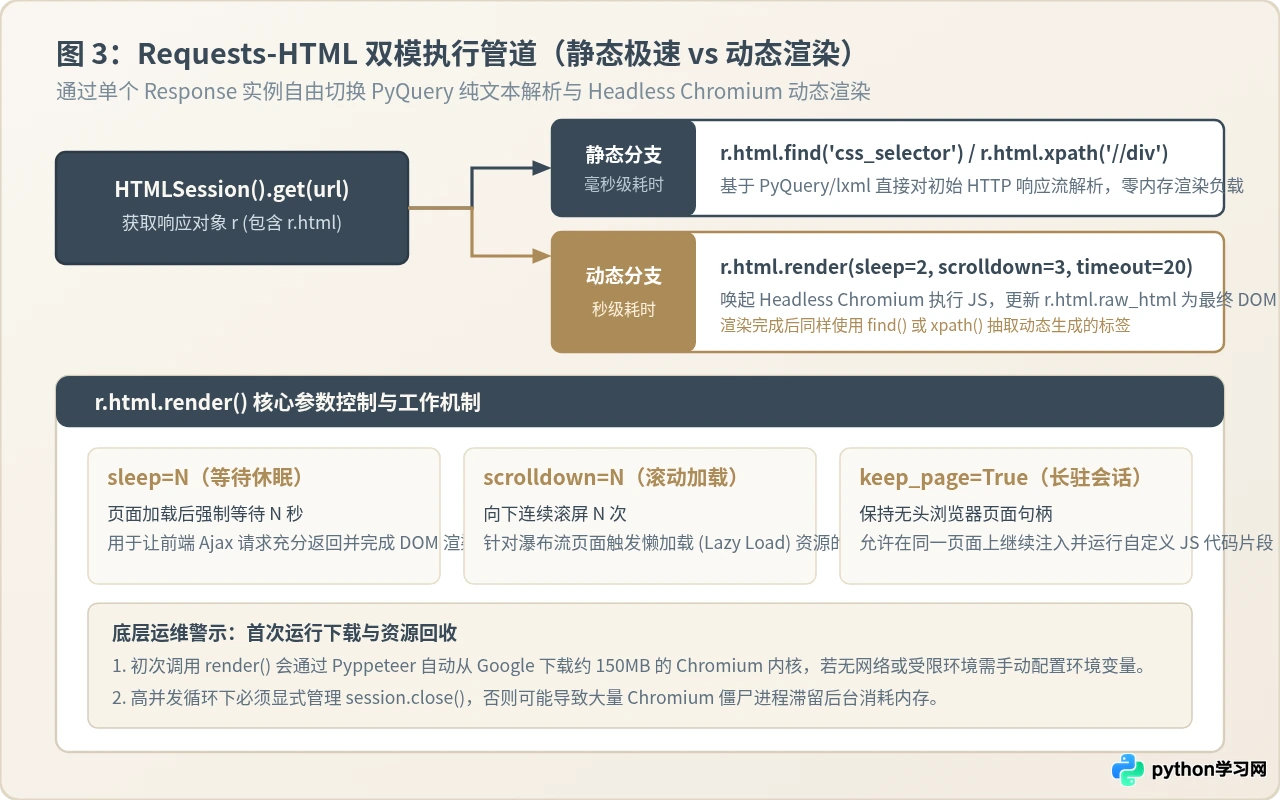
2. 双模处理实战:从静态提取到动态执行
Requests-HTML 允许通过统一的 HTMLSession 发起请求,并在 r.html 上直接混合使用 CSS 选择器与 XPath。当发现目标 DOM 是由前端异步生成的时,仅需调用一次 .render() 即可激活浏览器执行环境:
from requests_html import HTMLSession

def run_requests_html_pipeline():
    session = HTMLSession()

    # 模拟静态与动态双向调用
    # 场景 A:静态极速模式(无需 Chromium,耗时几毫秒)
    url_static = "https://httpbin.org/html"
    try:
        r = session.get(url_static, timeout=10)

        # 1. 使用 CSS 选择器检索单节点 (first=True 类似 select_one)
        heading = r.html.find('h1', first=True)
        if heading:
            print("静态模式标题:", heading.text)

        # 2. 原生支持 XPath 查询
        paragraphs = r.html.xpath('//p')
        print(f"XPath 检测到段落数量: {len(paragraphs)}")

        # 3. 提取所有绝对超链接 (自动补全域名)
        print("页面内部包含的完整链接集合:", r.html.absolute_links)

    except Exception as e:
        print(f"静态请求发生异常: {e}")

    # 场景 B:客户端 JavaScript 动态渲染模式
    # 演示 render 参数调优
    """
    dynamic_url = 'https://example.com/spa-feed'
    resp = session.get(dynamic_url)

    # 关键参数:
    # sleep: 网页加载后额外等待前端 Ajax 响应并挂载 DOM 的时间(秒)
    # scrolldown: 针对无限瀑布流向下滑动滚屏的次数
    # timeout: 浏览器渲染操作的最长等待上限(秒)
    resp.html.render(sleep=2, scrolldown=1, timeout=20)

    dynamic_cards = resp.html.find('.feed-item')
    for card in dynamic_cards:
        print(card.text)
    """

    session.close()

if __name__ == '__main__':
    run_requests_html_pipeline()
XPath 检测到段落数量: 1
页面内部包含的完整链接集合: set()
当在爬虫循环中多次调用 render() 时,由于 Chromium 实例由子进程驱动,未显式调用 session.close() 可能导致无头浏览器进程无法正常退出,从而在后台产生大量孤儿进程并耗尽服务器内存。因此,务必在爬取结束或异常处理块(try...finally)中调用 session.close()。
四、核心维度对比与深度分析
在具体工程落地时,不能仅凭 API 的简洁程度来下定论,必须从解析吞吐量、语法灵活性、异步扩展性以及开源项目的长期健康度等多个维度综合评估。
| 比对维度 | Requests + BeautifulSoup 4 | Requests-HTML | 工程分析与影响 |
|---|---|---|---|
| 依赖重量 | 极轻(依赖包约几 MB) | 较重(含 pyppeteer 及 Chromium 下载) | 在 Docker 镜像构建或无外网服务器部署时,BS4 更加干净可控。 |
| 解析性能 | 极高(搭配 lxml C 底层) | 较高(基于 PyQuery + lxml) | 两者静态解析均基于 lxml,处理纯文本 HTML 性能差异在毫秒级内。 |
| 选择器语法 | CSS 选择器、标签属性函数过滤 | CSS 选择器、原生标准 XPath、模板 search | 若开发习惯高度依赖 XPath,Requests-HTML 开箱即用无需额外适配。 |
| 动态 JS 支持 | 无内置支持(需外挂 Selenium/Playwright) | 内置 r.html.render() |
Requests-HTML 免除了额外安装浏览器驱动的痛苦,非常适合轻量级验证。 |
| 生态维护度 | 极高,全球基石级库,持续更新 | 较低,上游代码近年更新放缓 | Requests-HTML 依赖的 pyppeteer 在新版 Python 中偶有兼容警告,长期生产任务建议谨慎评估。 |
五、选型决策树与场景匹配总结
针对具体项目的选择,可以通过以下明确的工程条件进行判断,避免“杀鸡用牛刀”或“选错工具中途返工”:
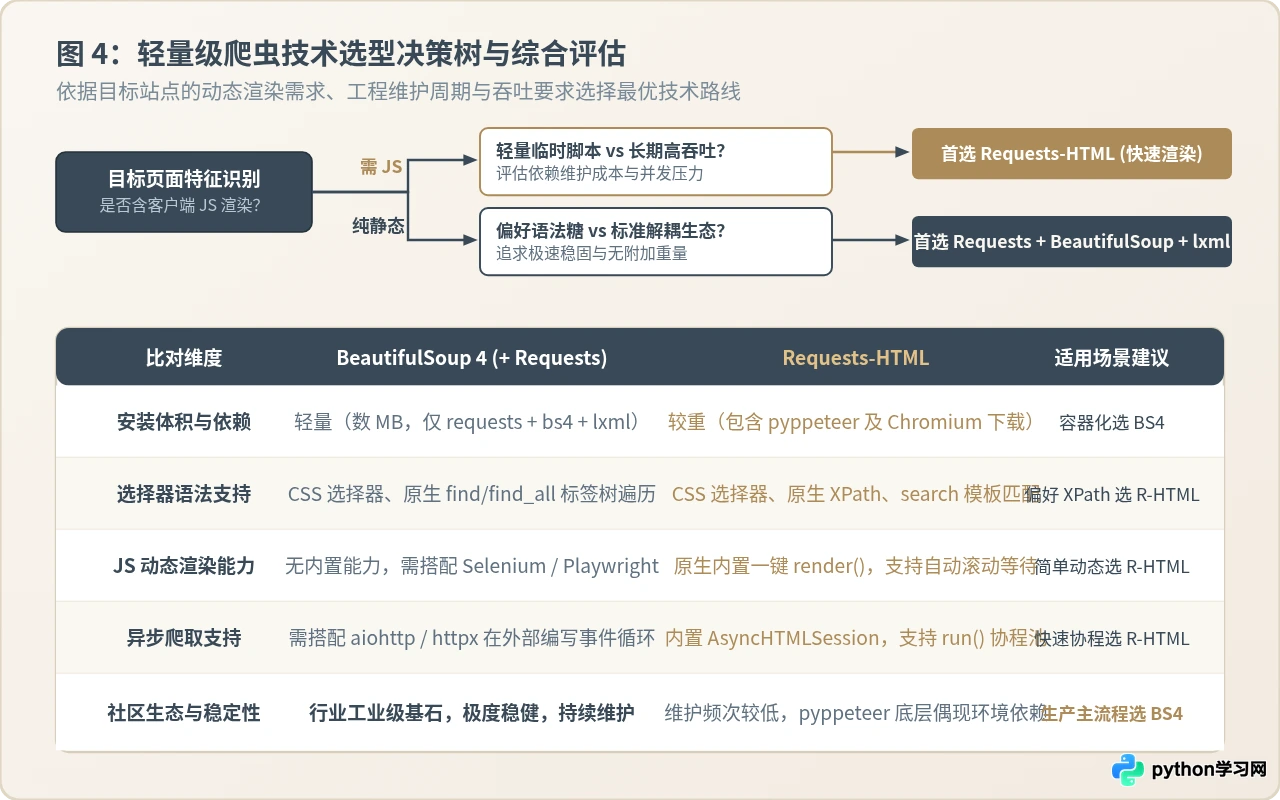
- 优先选择 BeautifulSoup 的场景:
- 目标网站为传统服务端渲染(SSR)页面,页面源码直接包含目标文本。
- 项目需要打包进小型 Docker 镜像,或者部署于严格受限、无法下载无头浏览器的企业内网服务器。
- 项目属于公司的核心生产主流程,对库的长期维护状态、向前兼容性与社区稳定性有极高要求。
- 网络层有复杂的定制需求(例如需要使用
httpx处理 HTTP/2 协议,或使用自定义连接池)。
- 优先选择 Requests-HTML 的场景:
- 个人原型探索、学术研究或小型一次性采集脚本,追求以最少行数的代码快速产出结果。
- 目标页面包含轻度客户端动态渲染(如列表由前端异步渲染),但数据规模不大,无需搭建庞大的 Playwright/Selenium 分布式集群。
- 重度依赖 XPath 语法进行复杂节点定位,同时希望保持 Requests 风格的网络会话管理。
总结而言,在现代 Python 爬虫技术栈中,BeautifulSoup 扮演着不可替代的“专业解析基础件”角色,只要搭配合适的 HTTP 客户端即可胜任绝大多数静态抓取任务;而 Requests-HTML 则是一把趁手的“多功能工兵铲”,在小型轻量脚本与快速验证动态内容的场合展现出极高的开发效率。理清两者的能力边界,根据数据源特征与运维环境合理选用,才是写出高效、健壮爬虫脚本的关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















