


Python中最常用的10个字符串方法及代码示例
本文深入讲解Python中最常用的10个字符串处理方法,包含strip、split、join、replace、find等核心操作的具体代码示例、运行机制解析、边界注意事项与全流程图示。
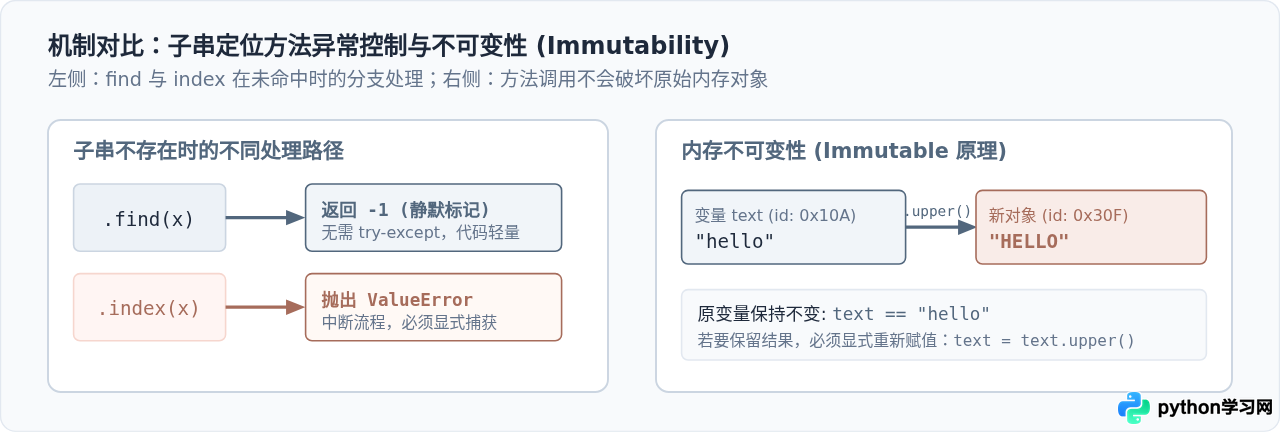
str)是最基础也最频繁处理的数据类型之一。由于Python中的字符串具有不可变性(Immutable),所有字符串方法都不会直接修改原有变量,而是计算并返回一个全新的字符串副本。掌握最常用的10个方法,即可覆盖日常文本清洗、数据分词、内容检索与格式校验中绝大多数任务。
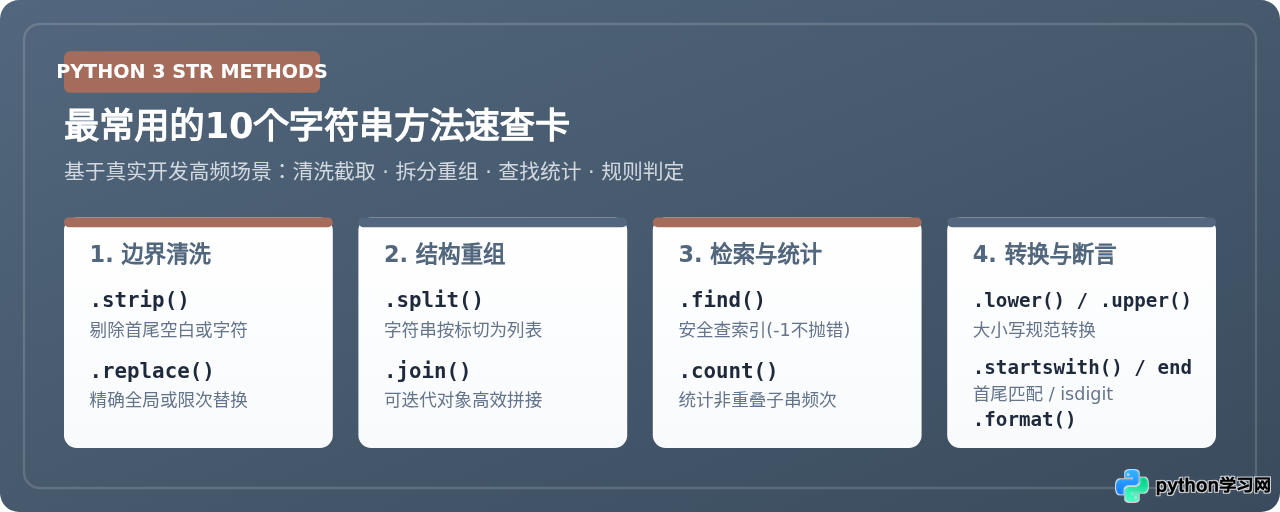
一、文本清洗与边界修剪
1. strip():去除首尾空白字符或指定字符集合
在读取文本文件、接口JSON输入或爬虫抓取网页时,字符串首尾往往伴随着多余的空格、换行符
或制表符 。strip()默认会从两端剔除所有类型的空白字符;也可以通过传入字符集合参数来移除两端指定字符。其衍生方法lstrip()与rstrip()分别仅处理左侧或右侧。
# 基础用法:去除两端不可见空白
raw_input = "  \t  user_admin_01 \n\r "
clean_input = raw_input.strip()
print(f"清洗前: [{raw_input}]")
print(f"清洗后: [{clean_input}]")

# 高阶用法:去除两端特定符号(注意:匹配的是字符集合而非子串)
raw_url = "###https://example.com/api/v1/###"
clean_url = raw_url.strip("#/")
print(f"URL清理: [{clean_url}]")
]
清洗后: [user_admin_01]
URL清理: [https://example.com/api/v1]
strip("abc")并不要求字符串两端按照"abc"的顺序排列,只要首尾字符属于'a'、'b'或'c'中的任意一个,就会持续被剥离,直到遇到第一个非集合内字符为止。
2. replace():精确替换子字符串
str.replace(old, new[, count])用于将字符串中的特定子串替换为新内容。如果指定了可选参数count,则只替换前count次出现,这在处理结构化模板或仅替换首个匹配项时尤为有用。
# 全局替换
template = "2026/10/24 10:00:00"
standard_date = template.replace("/", "-")
print("日期规范化:", standard_date)

# 限制替换次数(仅替换首次)
query_sql = "SELECT id FROM users WHERE id = ? AND status = ?"
single_param_sql = query_sql.replace("?", "1024", 1)
print("部分绑定SQL:", single_param_sql)
部分绑定SQL: SELECT id FROM users WHERE id = 1024 AND status = ?
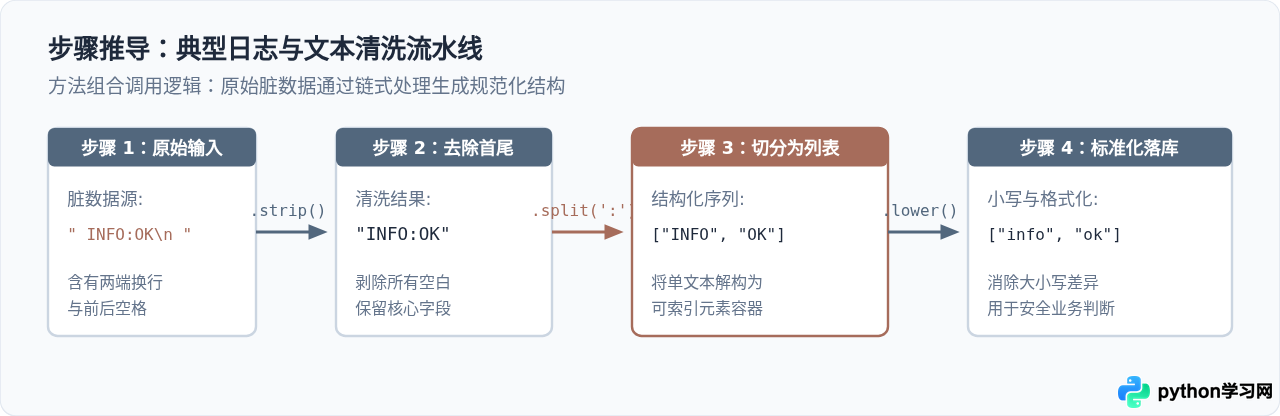
二、结构拆分与容器重组
3. split():按分隔符将字符串拆分为列表
split(sep=None, maxsplit=-1)是文本解析的基石。需要重点区分不传参数与显式传入空格" "的区别:
str.split():默认会将任意连续的空白符(连续空格、制表符、换行符)视作单一分隔符,并自动剔除两端空白。str.split(" "):严格按照单个空格匹配,若遇到连续两个空格,中间会产生空字符串元素""。
sentence = "Python   Java   Rust\tGo\nC++"

# 默认模式:自动合并连续空白
list_default = sentence.split()
print("默认拆分:", list_default)

# 限制拆分次数:取前2个字段,剩余保持整体
log_line = "2026-11-01 12:00:00 [ERROR] Database connection timeout"
log_parts = log_line.split(" ", 3)
print("部分拆分:", log_parts)
部分拆分: ['2026-11-01', '12:00:00', '[ERROR]', 'Database connection timeout']
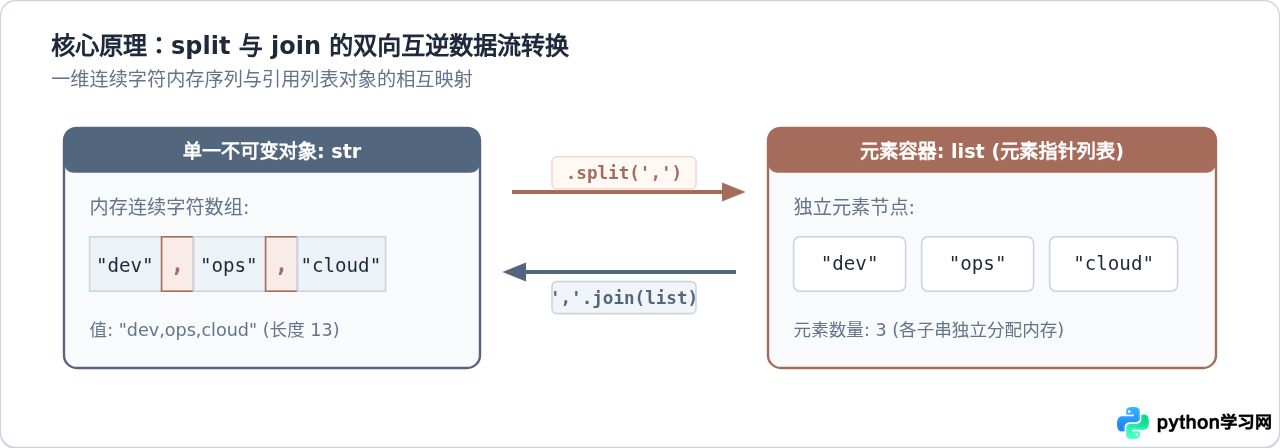
4. join():高效拼接序列元素为新字符串
初学者常误写为 list.join(sep),但在Python中,join()是由分隔符字符串对象调用的:sep.join(iterable)。
在循环中用 += 拼接大量字符串会因为不可变性不断分配新内存并复制数据,导致 \(O(n^2)\) 的时间复杂度;而 join() 预先计算总长度后一次性完成内存分配,效率是 \(O(n)\)。
tags = ["python", "backend", "web-dev", "tutorial"]

# 用连字符拼接
slug = "-".join(tags)
print("URL Slug:", slug)

# 用换行符将多行内容拼接为完整正文
lines = ["Line 1: Initialize", "Line 2: Process", "Line 3: Finished"]
content = "\n".join(lines)
print("拼接结果:\n" + content)
拼接结果:
Line 1: Initialize
Line 2: Process
Line 3: Finished
三、大小写规范与前后缀判定
5. lower() 与 upper():字符串大小写转换
用于实现不区分大小写(Case-Insensitive)的文本比较。常见场景包括用户输入账号比对、文件扩展名校验、HTTP请求头匹配等。
user_input_email = "Admin@Example.COM"
db_stored_email = "admin@example.com"

# 统一转为小写后再进行等值比对
if user_input_email.lower() == db_stored_email.lower():
    print("邮箱匹配成功")

# 转为大写常用于常量标识或日志突出显示
log_level = "warning".upper()
print("日志级别:", log_level)
日志级别: WARNING
补充说明:如果处理包含非西文字符(例如德语 ß 对应大写 SS),更严格的无大小写比对应使用 casefold()。但对于日常绝大多数场景,lower() 已足够高效通用。
6. startswith() 与 endswith():首尾前缀与后缀精准探测
比切片 s[:4] == 'http' 更优雅且具备容错性(切片长度不足时易引发误判)。更强大的是,它们原生支持传入元组(Tuple)一次性匹配多种可能。
filename = "report_2026_q3.pdf"

# 检查单个前缀
is_report = filename.startswith("report_")

# 检查多个可能的扩展名(传入 tuple)
valid_docs = filename.endswith((".pdf", ".docx", ".xlsx"))

print(f"是否为报告文件: {is_report}")
print(f"是否为受支持的文档格式: {valid_docs}")
是否为受支持的文档格式: True
(".png", ".jpg")),如果误传列表 [".png", ".jpg"] 会直接抛出 TypeError: tuple for startswith must only contain str 异常。
四、子串定位与频次统计
7. find():安全查找子串起始索引
str.find(sub[, start[, end]])返回子串在父串中首次出现的字符索引。如果子串不存在,返回 -1。
作为对比,另一个内建方法 index() 在未找到时会直接抛出 ValueError。在无需捕获异常的简单判断逻辑中,find() 通常更加安全和直观。
message = "Connection established from 192.168.1.100 port 8080"

pos = message.find("192.168")
if pos != -1:
    print(f"找到局域网IP,起始索引为: {pos}")
else:
    print("未发现匹配地址")

# 查找不存在的内容
missing_pos = message.find("10.0.0.1")
print(f"未找到时的返回值: {missing_pos}")
未找到时的返回值: -1
8. count():统计子串出现的非重叠次数
str.count(sub[, start[, end]])用于统计指定子串在父串中出现的频次。其统计原则是非重叠(Non-overlapping)计算。
code_snippet = "count = count + 1 if count < max_count else 0"
occurrence = code_snippet.count("count")
print(f"'count' 出现次数: {occurrence}")

# 演示非重叠特性
overlap_test = "aaaa"
print("'aaaa' 中包含 'aa' 的次数:", overlap_test.count("aa"))
'aaaa' 中包含 'aa' 的次数: 2
在上面的示例中,"aaaa"中包含的"aa"结果为2而非3。因为前两个a被第一个匹配消耗后,算法会从第三个a继续向后扫描,不会产生交叉匹配。
五、内容格式判定与模板填充
9. isdigit():校验字符串是否全由纯数字构成
在从表单、配置文件或命令行读取参数时,所有输入最初都以字符串形式存在。在调用 int() 转换前,使用 isdigit() 可以有效规避类型转换异常。
test_cases = ["12345", "12.34", "-50", "3a", ""]

for val in test_cases:
    if val.isdigit():
        print(f"'{val}' -> 可安全转换为整型: {int(val)}")
    else:
        print(f"'{val}' -> 包含非数字或负号/小数点,无法直接通过 isdigit")
'12.34' -> 包含非数字或负号/小数点,无法直接通过 isdigit
'-50' -> 包含非数字或负号/小数点,无法直接通过 isdigit
'3a' -> 包含非数字或负号/小数点,无法直接通过 isdigit
'' -> 包含非数字或负号/小数点,无法直接通过 isdigit
isdigit()对负数符号"-"和小数点"."均返回False,空字符串""同样返回False。若需验证浮点数或负数,建议配合正则或异常捕获机制。
10. format():经典的动态模板格式化
虽然 Python 3.6+ 推出的 f-string(f"Hello, {name}")非常便捷,但 format() 方法在外部模板复用、动态组装 SQL/邮件通知、延迟计算场景中依然不可替代。
# 预定义通知模板(模板与数据分离)
template = "尊敬的 {user},您的验证码为 {code},有效期 {minutes} 分钟。"

# 在不同时机渲染模板
msg_alice = template.format(user="Alice", code="489102", minutes=5)
msg_bob = template.format(user="Bob", code="910234", minutes=10)

print(msg_alice)
print(msg_bob)

# 数字格式化输出控制
data_report = "当前内存占用: {0:.2f} MB ({1:,} 字节)".format(128.4567, 134698240)
print(data_report)
尊敬的 Bob,您的验证码为 910234,有效期 10 分钟。
当前内存占用: 128.46 MB (134,698,240 字节)
六、快速总结与选型速查表
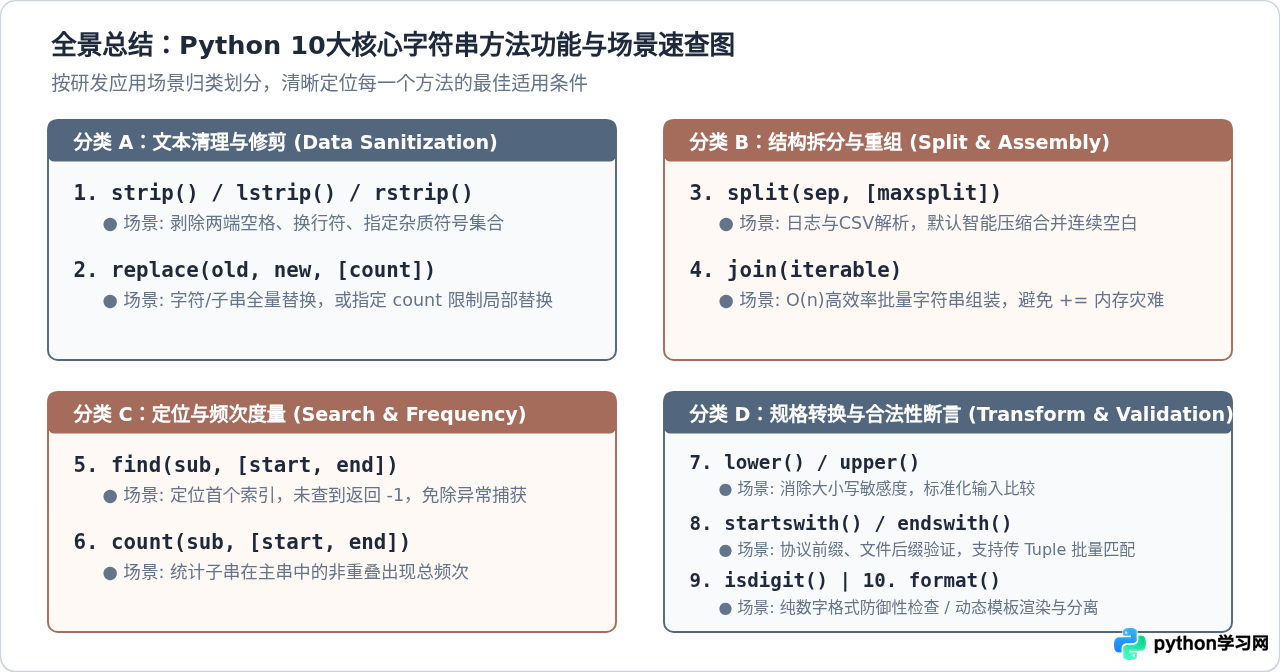
为了方便日常开发随时查阅,下表整理了本文介绍的10个字符串核心方法的签名、核心功能、常见返回值及易错提醒:
| 方法名称 | 典型语法形式 | 核心作用 | 关键注意点 |
|---|---|---|---|
strip() |
s.strip([chars]) |
去除两端空白或字符集合 | 匹配的是字符集合并非子串;原字符串不发生变动 |
replace() |
s.replace(old, new, [count]) |
替换子串内容 | 默认替换全部,传入 count 可限制前 N 次替换 |
split() |
s.split([sep], [maxsplit]) |
拆分成字符串列表 | 不传 sep 时会自动压缩任意连续空白符 |
join() |
sep.join(iterable) |
序列元素高效拼接 | 由分隔符调用,比 += 的循环拼接内存开销小得多 |
lower() / upper() |
s.lower() / s.upper() |
转换全部字符大小写 | 常用于实现忽略大小写的安全文本比对 |
startswith() / endswith() |
s.startswith(prefix) |
前缀 / 后缀匹配 | 多条件匹配时必须传入元组 (a, b),不能传入列表 |
find() |
s.find(sub, [start, end]) |
获取子串首现索引 | 找不到时返回 -1,不会像 index() 一样抛出异常 |
count() |
s.count(sub, [start, end]) |
统计子串出现次数 | 采用非重叠扫描机制(如 "aaaa" 包含 "aa" 为 2 次) |
isdigit() |
s.isdigit() |
校验是否纯数字字符 | 负号、小数点以及空字符串均返回 False |
format() |
template.format(...) |
格式化模板填充 | 适用于模板与数据解耦存储、外部配置文件读取的场景 |
熟练运用上述10个方法,并时刻牢记字符串的不可变性质与返回新对象的原则,能够使你的Python文本处理代码既具备极高的可读性,又拥有出色的运行性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















