


Python列表转集合去重技巧及顺序丢失问题处理
深入解析Python中利用集合(set)对列表去重的原理、时间复杂度与顺序丢失问题,并系统梳理保持元素原有顺序的高效去重方法及不可哈希对象处理策略。
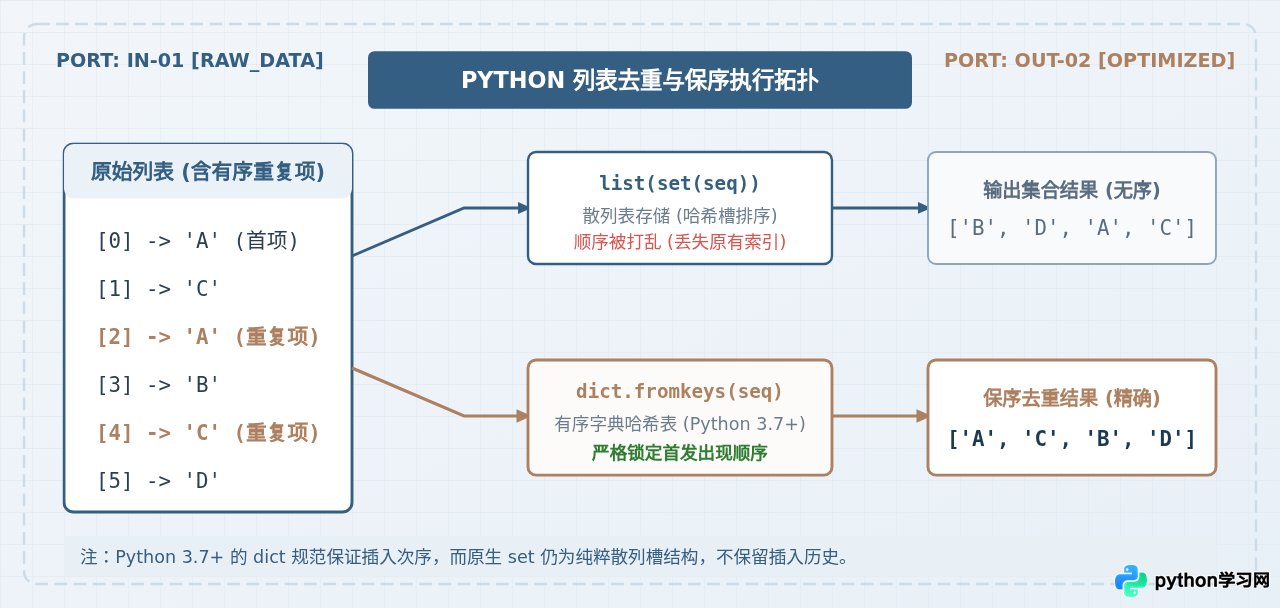
list(set(seq)) 可以在平均 O(n) 的时间复杂度内快速完成列表去重,是处理重复数据最常用的简便写法。但这种方法会直接破坏原有列表的索引顺序,且当列表内包含字典或子列表等不可哈希元素时会抛出异常。针对需要保留原有顺序的业务场景,Python 3.7+ 的标准解法是直接使用 list(dict.fromkeys(seq));对于复杂对象或流式数据,则可以结合集合查找与生成器进行优雅过滤。本文将详细拆解集合去重的底层机制、顺序丢失的深层根源,并给出经过生产验证的保序去重方案。
一、list(set(seq)) 基础去重技巧与哈希机制
集合(set)在 Python 中是一个无序且无重复元素的容器。利用这一天然特性,将列表强制转换为集合,再转换回列表,就能用一行代码剔除所有重复元素:
# 基础列表转集合去重示例
raw_list = ["apple", "banana", "apple", "orange", "banana", "grape"]
dedup_list = list(set(raw_list))

# 示例输出(注意输出元素的相对位置已经改变):
# ['orange', 'banana', 'grape', 'apple']
从算法效率来看,如果采用双重循环或在普通列表中使用 if item not in result 逐项追加,查找操作的时间复杂度为 O(n),整个去重过程的时间复杂度高达 O(n²)。而在 CPython 底层,set 基于散列表(Hash Table)实现,通过对元素计算哈希值直接定位存储槽位,单次插入和查找的平均时间复杂度为 O(1),使得整张列表去重能在 O(n) 时间内完成。
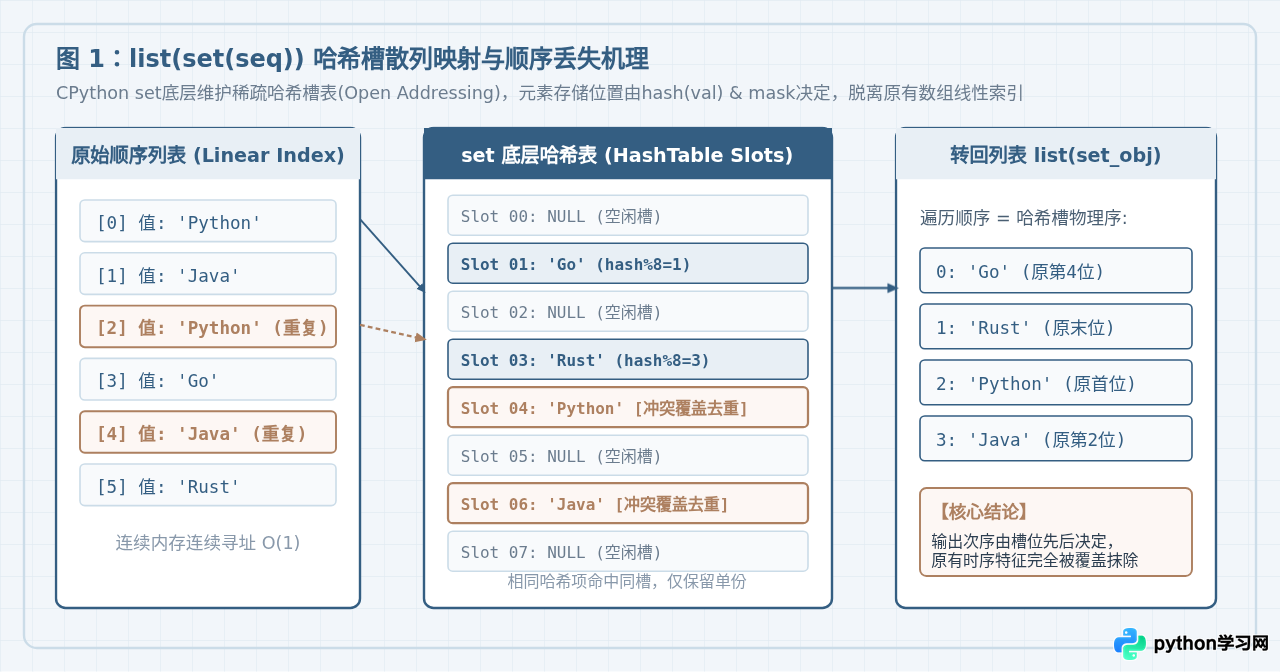
然而,如图 1 所示,底层散列表的哈希槽(Bucket)分布取决于每个元素哈希值的低位掩码,与元素在原始列表中的索引下标毫无关联。当调用 list() 将集合转回列表时,CPython 只是按哈希槽数组的物理先后顺序进行线性迭代,这便导致最终输出的元素次序发生不可控的改变。
二、顺序丢失的根本原因与不可哈希异常
不少开发者会有疑问:既然 Python 3.7+ 已经将普通字典(dict)的插入顺序作为官方语言规范进行了永久保留,为什么集合(set)依然无法保留插入顺序?
其根本原因在于底层数据结构的实现差异。Python 3.7+ 的字典采用了紧凑数组(Compact Hash Table)架构,将存储结构拆分为两部分:一个紧凑的条目数组(Entries Array,按插入顺序紧密追加键值对)和一个稀疏的索引数组(Indices Array,仅存储哈希槽指向条目数组的偏移量)。但是,CPython 的集合类型并没有引入这套双数组机制,而是继续沿用经典的开放寻址稀疏表。这种设计避免了为集合额外维护顺序索引带来的内存开销,但同时也决定了集合本身绝不具备时序记忆能力。
set(seq) 会立即触发 TypeError: unhashable type: 'list' 或 TypeError: unhashable type: 'dict'。
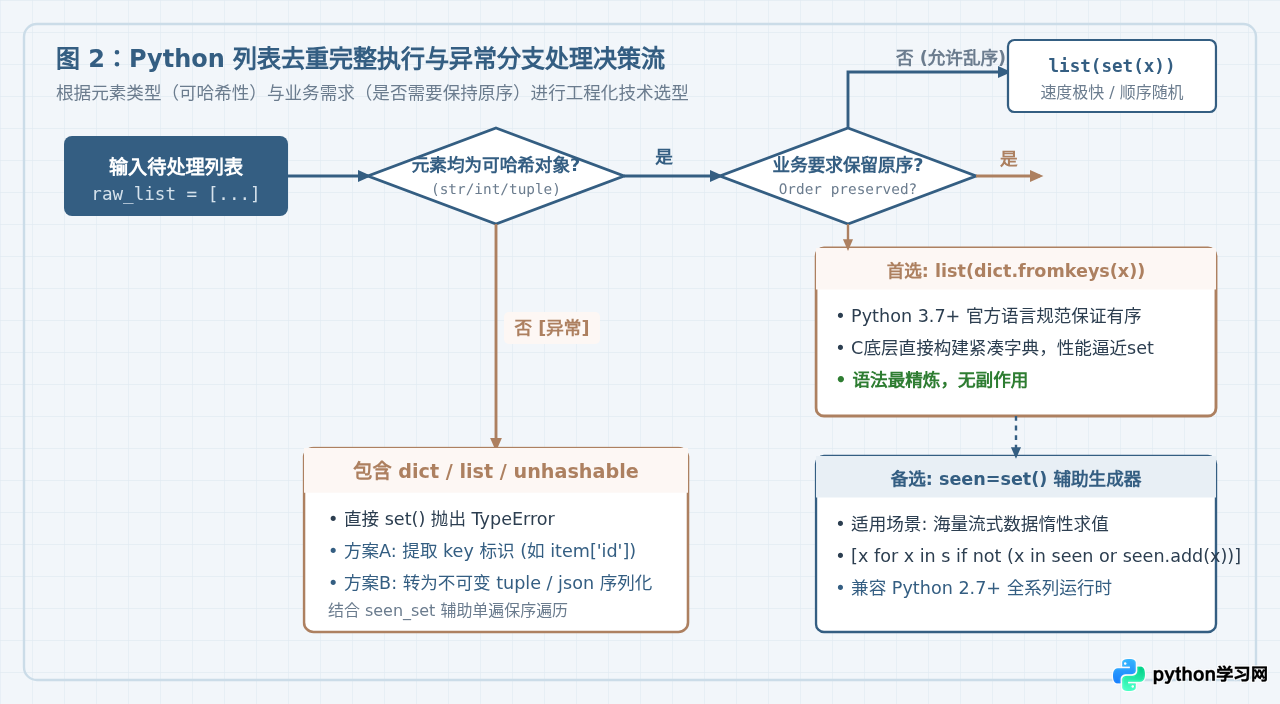
在实际项目(如日志清洗、时间线事件抽取、前端展示数据过滤)中,顺序往往代表着优先级、发生时间或用户浏览逻辑,顺序丢失是不可接受的。如图 2 的决策流程所示,我们需要在明确数据类型与保序要求的前提下,选用合适的技术方案。
三、保留原始顺序的高效去重技巧
技巧 1:最推荐解法 —— list(dict.fromkeys(seq))
在 Python 3.7 及以上版本中,保持列表元素原始顺序的最优去重方式是使用 dict.fromkeys()。由于标准字典保证键的插入顺序,并且键本身天然具有去重特性,将其重新转为列表即可完美兼顾保序与去重:
# Python 3.7+ 标准保序去重写法
raw_scores = [90, 85, 95, 85, 100, 90, 75]
ordered_dedup = list(dict.fromkeys(raw_scores))

# 示例输出(严格保留每个元素第一次出现的位置):
# [90, 85, 95, 100, 75]
该方法完全由 C 底层函数快速执行,无需在 Python 解释器层面运行循环语句,执行耗时与原生的 list(set(seq)) 极为接近,同时代码表达清晰简洁,是标量类型保序去重的首选方案。
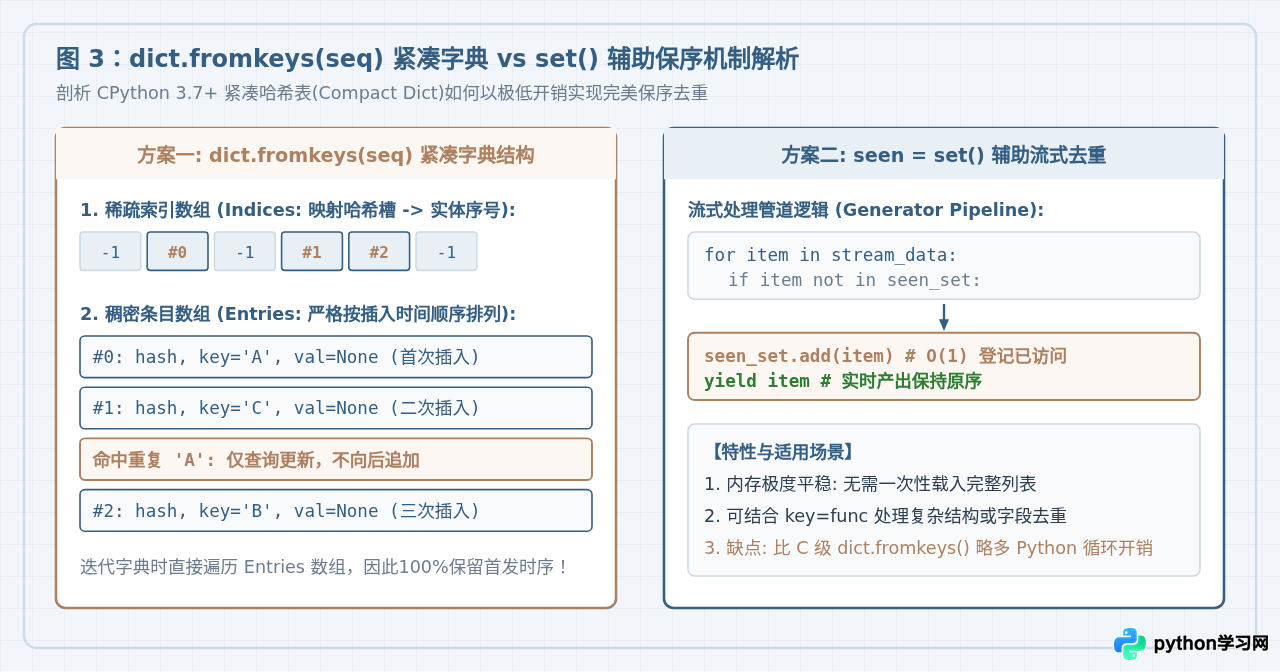
技巧 2:兼顾惰性求值的 set 辅助过滤法
如果面对的是超大规模数据流、生成器管道,或者需要兼容旧版 Python 环境,可以利用辅助集合记录已处理过的元素,配合生成器或列表推导式实现边遍历边去重:
# 方案 A:通用生成器函数(内存友好,适合处理海量流式数据)
def deduplicate_stream(iterable):
    seen = set()
    for item in iterable:
        if item not in seen:
            seen.add(item)
            yield item

# 使用示例
data_stream = ["order_1", "order_2", "order_1", "order_3"]
print(list(deduplicate_stream(data_stream)))
# 示例输出: ['order_1', 'order_2', 'order_3']

# 方案 B:一行推导式技巧(利用 seen.add() 返回 None 的特性)
seen_cache = set()
compact_result = [x for x in data_stream if not (x in seen_cache or seen_cache.add(x))]
# compact_result: ['order_1', 'order_2', 'order_3']
技巧 3:复杂/不可哈希元素(字典列表、嵌套对象)的保序去重
当列表中存放的是字典或自定义业务对象时,无法直接计算哈希。此时可以通过指定 key 函数提取能够唯一标识对象的不可变属性(例如用户 ID 或订单编号):
# 字典列表按特定字段保序去重
users = [
    {"id": 101, "name": "Alice"},
    {"id": 102, "name": "Bob"},
    {"id": 101, "name": "Alice Duplicate"},
    {"id": 103, "name": "Charlie"},
]

def dedupe_by_key(items, key_func):
    seen_keys = set()
    result = []
    for item in items:
        val = key_func(item)
        if val not in seen_keys:
            seen_keys.add(val)
            result.append(item)
    return result

unique_users = dedupe_by_key(users, key_func=lambda u: u["id"])

# 示例输出:
# [{'id': 101, 'name': 'Alice'}, {'id': 102, 'name': 'Bob'}, {'id': 103, 'name': 'Charlie'}]
若需要根据字典的全量内容进行深度去重,则可以先通过 json.dumps(obj, sort_keys=True) 或递归将可变结构转换为元组(tuple)作为指纹记录在辅助集合中,同样可以在保持原序的前提下避免类型异常。
四、各方案技术特征对比与工程选型建议
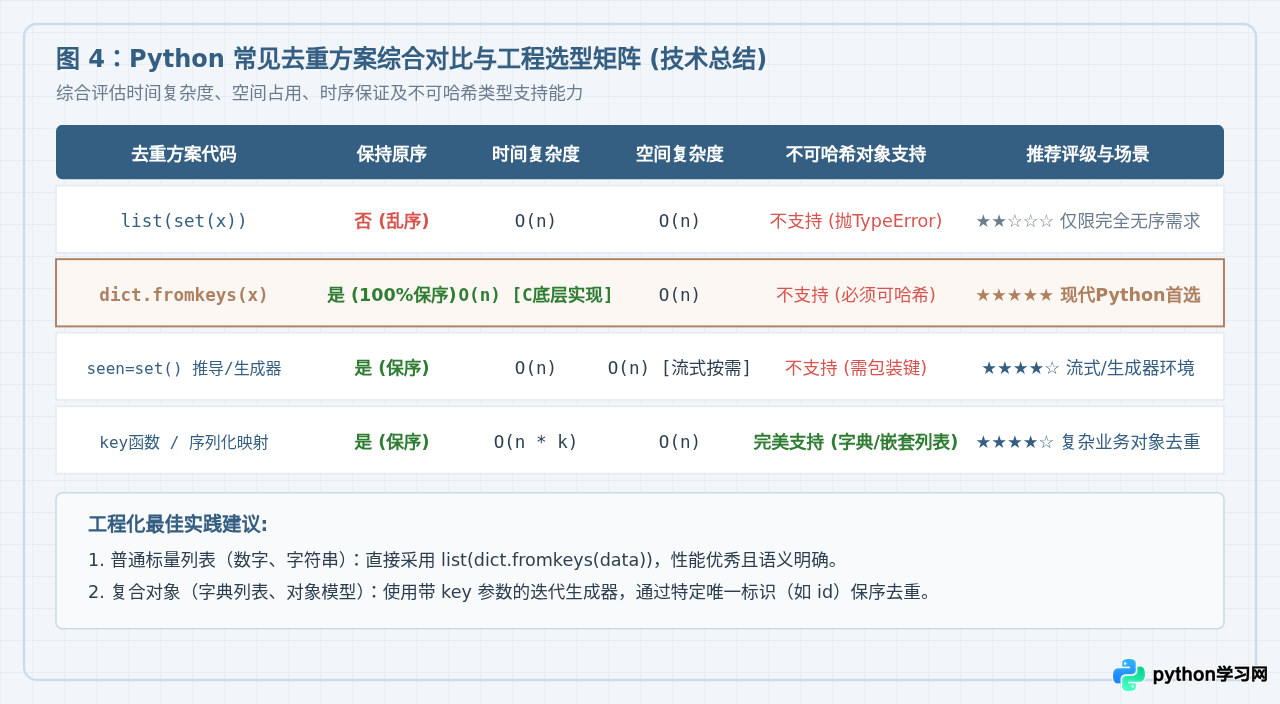
下表总结了 Python 中四种典型去重方案的综合表现与边界约束:
| 技术方案 | 是否保序 | 时间复杂度 | 空间复杂度 | 元素限制 | 工程选型建议 |
|---|---|---|---|---|---|
list(set(x)) |
否 (乱序) | O(n) | O(n) | 需可哈希 | 对顺序完全不敏感的纯数字/字符串去重 |
list(dict.fromkeys(x)) |
是 (完美保序) | O(n) | O(n) | 需可哈希 | Python 3.7+ 生产环境第一首选 |
seen = set() 生成器 |
是 (保序) | O(n) | O(k) | 需可哈希 | 海量流式数据管道、惰性计算场景 |
key提取器 + 辅助集 |
是 (保序) | O(n) | O(n) | 支持任意类型 | 字典列表、ORM模型、嵌套结构去重 |
五、工程实践注意事项与特殊陷阱
-
布尔值与数值的冲突隐患:
在 Python 中,
bool是int的子类,且True == 1,False == 0,两者的哈希值亦完全一致。如果列表中混有数值与布尔值(如[1, True, 0, False]),由于它们被哈希表判定为同一值,去重结果只会保留较早出现的那一个(输出为[1, 0])。若需区分类型,应在 key 函数中增加类型指纹:(type(x), x)。 -
浮点数 NaN 值的不可去重陷阱:
根据 IEEE 754 标准,NaN 与任何值比较(包括其自身)均返回
False。因此列表中的多个float('nan')在经过集合或字典去重时,由于比较失败,不会被剔除,依然全部保留。如需对含 NaN 数据去重,需借助math.isnan()做前置统一规整。 - 内存考量: 无论使用 set 还是 dict,去重过程都需要在内存中额外开辟一块哈希表存储中间键。对于千万级的大数据列表,一次性构建新列表会导致内存瞬间翻倍。此时应优先使用带生成器的惰性方案,分批读取并写入外部缓存或流下游。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















