


怎么用Python将UTF-8文件内容保存为GBK格式
本文详细讲解如何使用 Python 将 UTF-8 编码文件内容转换并保存为 GBK 格式。涵盖标准读写操作步骤、底层数据流转、超出字符集时的 UnicodeEncodeError 应对策略、大文件流式防内存溢出方案及完整验证流程。
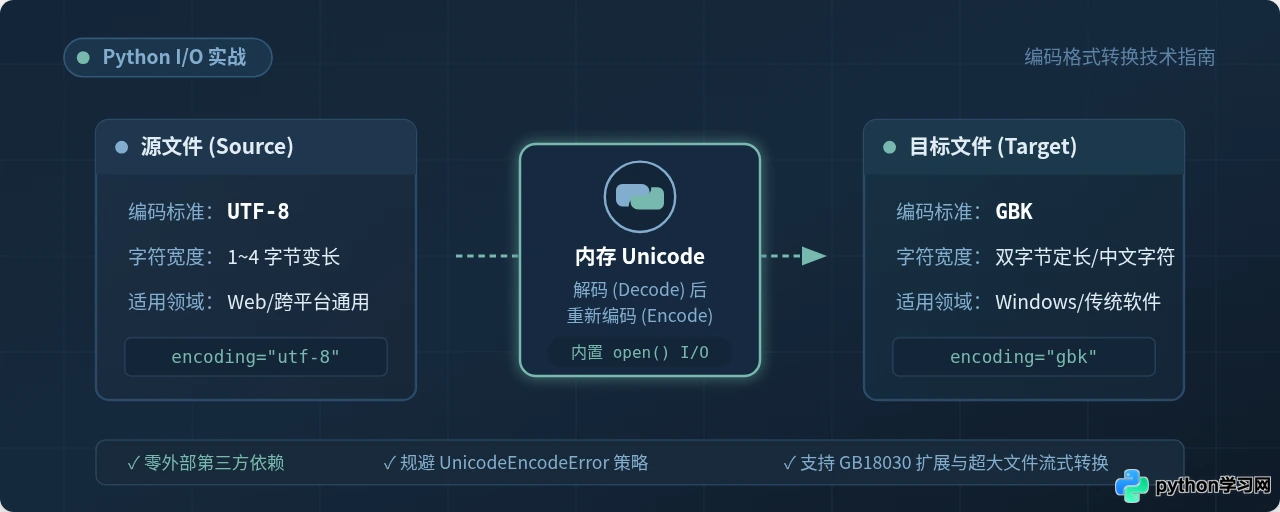
在 Windows 环境下使用某些特定业务系统、工业控制软件或较早版本的 Excel 直接双击打开文本及 CSV 文件时,若文件采用现代通用的 UTF-8 编码,软件界面中常见的中文字符往往会显示为乱码甚至直接报错。导致这一现象的原因是此类软件默认仍采用系统区域编码(在简体中文 Windows 中即为 GBK / CP936 编码表)解析文件内容。解决该问题的核心路径十分直接:利用 Python 内置的 open() 函数,先以 encoding="utf-8" 模式读取源文件内容,再以 encoding="gbk" 模式将其写入目标文件。Python 内部会自动依托运行时的 Unicode 内存模型完成字符解码与二次编码,无需安装任何第三方库即可完成可靠转换。
单文件转码操作步骤与基础代码
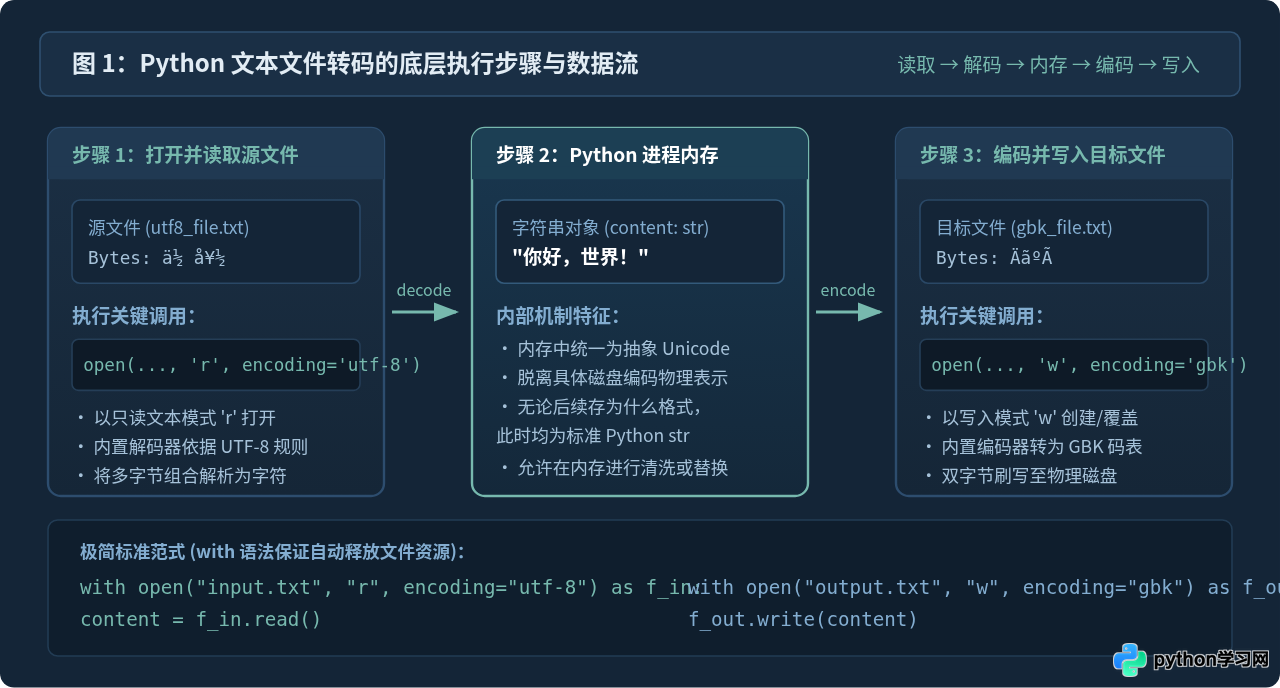
要完成最基础的单文件转码,只需要掌握 Python 文本 I/O 操作的标准范式。在 Python 3 中,文本文件在被读取时会被解码为内存中的抽象字符串对象(str),而在写入磁盘时再根据指定的编码格式重新转化为物理字节流。
假设当前目录下有一个名为 source_utf8.txt 的 UTF-8 编码文件,我们需要将其转换为 target_gbk.txt。以下是完成此任务的标准代码:
# 定义转码函数:读取 UTF-8 并以 GBK 编码输出
def convert_utf8_to_gbk(source_file: str, target_file: str) -> None:
    # 第一步:以只读文本模式 'r' 和 utf-8 编码载入源文件内容
    with open(source_file, "r", encoding="utf-8") as f_in:
        content = f_in.read()

    # 第二步:以写入模式 'w' 和 gbk 编码将内存字符串写入目标文件
    with open(target_file, "w", encoding="gbk") as f_out:
        f_out.write(content)

# 实际调用示例
convert_utf8_to_gbk("source_utf8.txt", "target_gbk.txt")
这段代码中包含两个关键机制:
- 上下文管理器(
with语句):确保文件在读取或写入结束后自动触发close()释放系统文件句柄,即使在读写中途出现意外中断也能避免资源泄露。 - 模式与编码分离:模式参数
"r"与"w"负责操作系统层面的流访问权限控制;encoding参数则驱动 Python 底层的编解码器(Codec)。源文件的 UTF-8 多字节序列经过 Decoder 转换为纯粹的 Unicode 码位,再由 Encoder 映射为 GBK 规范的双字节二进制数据。
处理字符集不兼容:规避 UnicodeEncodeError
在实际转换过程中,很多开发者常会遭遇程序崩溃并抛出如下错误:
产生这一报错的根本原因在于两种编码标准的字符容量存在显著差异:
- UTF-8 是基于 Unicode 标准的变长编码方式,理论上可以表示超过 14 万个全球各语言文字、历史符号以及 Emoji 表情符;
- GBK 是专门面向简体中文及中文标点的双字节编码规范,收录了 21,886 个汉字和图形符号。
当源 UTF-8 文件中包含 Emoji(例如 😀)、部分特殊语种符号(如韩文假名、藏文字符)或未经收录的现代生僻汉字时,GBK 码表中不存在对应的映射位置,Python 默认的严格检查策略就会中断执行。针对这一情况,open() 函数提供了 errors 参数来定义容错行为:
| 策略名称 | 参数写法 | 遇到无法编码字符时的处理方式 | 适用业务场景 |
|---|---|---|---|
| 严格模式(默认) | errors="strict" |
立即抛出 UnicodeEncodeError 中断程序运行 |
财务数据、核心报表等要求零数据丢失的严格场景 |
| 忽略跳过 | errors="ignore" |
静默跳过该字符,不产生报错也不保留该字符 | 不关心缺失字符、仅需要提取可读文本片段的场景 |
| 问号替换 | errors="replace" |
将无法编码的字符统一替换为单字节问号 ? |
日常日志分析、常规文本导出,需保留字符占位 |
| XML实体引用 | errors="xmlcharrefreplace" |
转写为类似 😀 的数字字符实体格式 |
既要满足 GBK 格式存储,又要完全无损保留原始码位 |
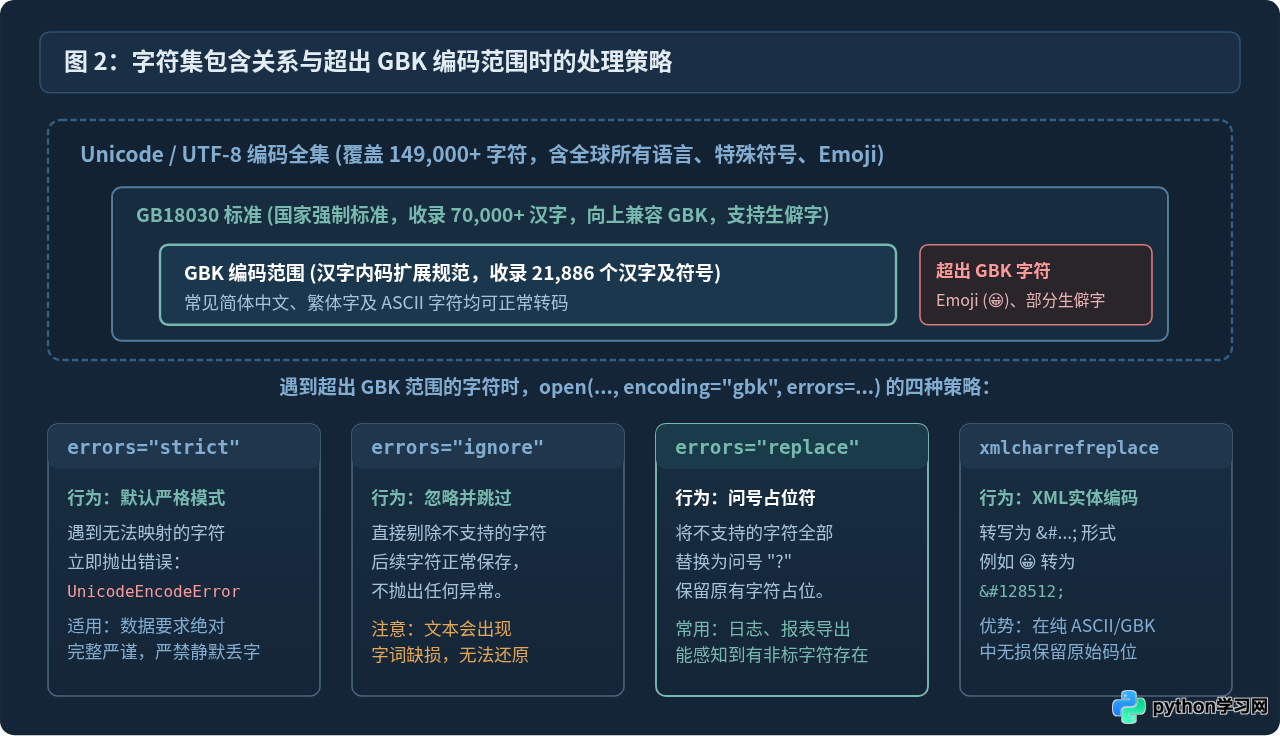
如果目标软件运行在相对较新的 Windows 系统上,通常推荐优先将写入编码设定为 encoding="gb18030"。GB18030 是中国国家强制标准,不仅完全向下兼容 GBK 的所有码位,还收录了 7 万余个汉字,能无损表达绝大多数生僻字,有效避免转码时的字符缺失。
大文件防内存溢出:逐行流式转换实现
前文示例中的 f_in.read() 会将整个文件内容一次性读入系统内存。对于几十 KB 或几 MB 的常规文档,这种方式简洁直观;但当面对几百兆甚至数吉字节(GB)的大型日志文件或超长 CSV 导出数据时,全量载入会导致 Python 进程占用的内存急剧攀升,不仅可能引起系统卡顿换页,更会在内存受限环境或容器中直接触发 MemoryError 甚至被系统 OOM 终止。
为了处理任意体积的文件,应该利用 Python 文件对象的迭代器协议进行逐行流式读写。在流式处理模式下,Python 底层每次只从源文件读取当前行或缓冲区块(Buffer),完成单行转码写盘后立即释放,使得常驻内存始终保持在极低水平:
# 工业级通用流式转码函数:安全支持超大文件
def convert_large_file_utf8_to_gbk(
    source_file: str,
    target_file: str,
    error_strategy: str = "replace"
) -> None:
    # 同时打开读写句柄,利用生成器逐行推流
    with open(source_file, "r", encoding="utf-8") as f_in,          open(target_file, "w", encoding="gbk", errors=error_strategy) as f_out:
        for line in f_in:
            f_out.write(line)

# 运行示例(即便处理 4GB 的日志文件,内存占用也仅有几 MB)
convert_large_file_utf8_to_gbk("server_access.log", "server_access_gbk.log")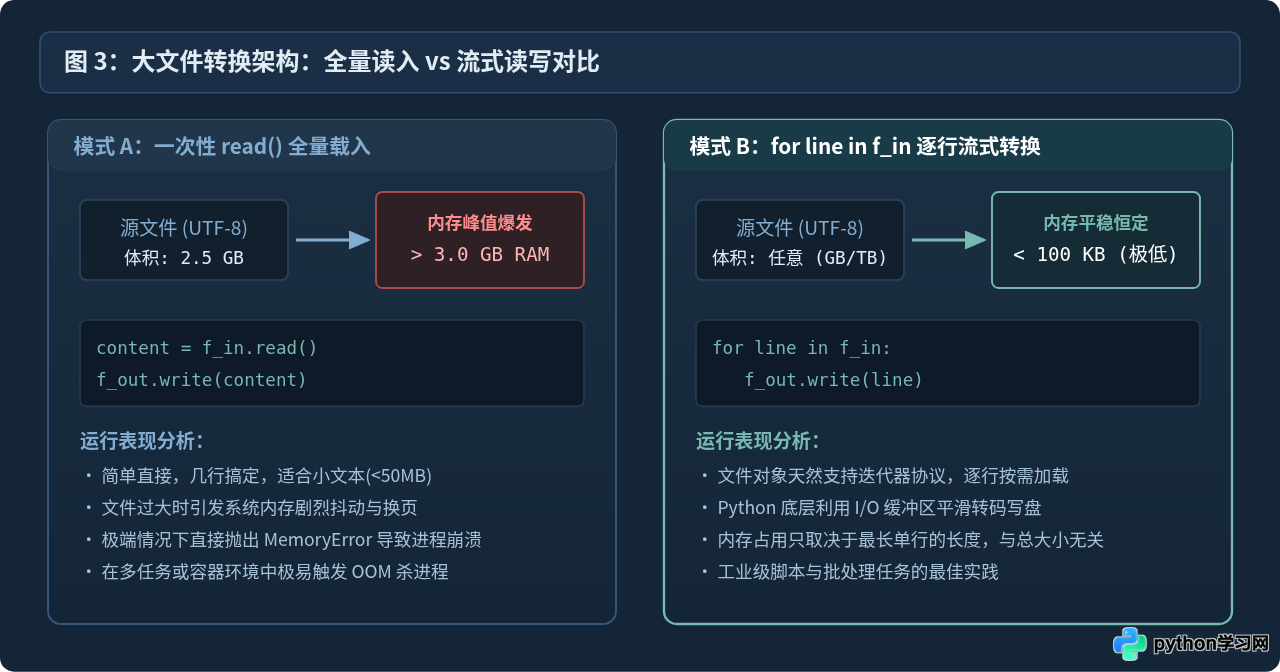
必须注意的常见陷阱与结果验证方法
在实际转码工作中,还有两个细微但高频出现的问题需要提前防范:
1. 源文件带有 UTF-8 BOM 头()
某些 Windows 应用程序保存的 UTF-8 文本会在文件最前列写入三个字节的 BOM(Byte Order Mark)头。如果直接使用 encoding="utf-8" 读取,这三个字节会被解析为不可见字符 并传入内存。当写入 GBK 格式时,如果设置了严格模式就会因无法编码而报错。解决办法是将源文件读取编码改为 encoding="utf-8-sig",Python 会自动识别并剥离开头的 BOM 标记。
2. 切忌在读写中原地覆盖原文件
初学者容易写出 open("data.txt", "r") 读取后紧接着 open("data.txt", "w") 的逻辑。如果此时发生异常,"w" 模式在打开瞬间就会清空源文件,导致原始数据彻底丢失。规范的做法是先写入临时目标文件,待全部流式写入完毕且校验无误后,再使用 os.replace(temp_path, dest_path) 实现原子性覆盖。
3. 如何验证目标文件已是合法 GBK 格式?
文件保存完成后,可以通过以下简短代码进行反向读取校验。如果能够正常无错读出中文字符,说明文件转码成功:
# 验证函数:尝试以 GBK 编码重新读取目标文件开头部分
def verify_gbk_file(file_path: str) -> bool:
    try:
        with open(file_path, "r", encoding="gbk") as f:
            preview = f.read(500)  # 试读前 500 个字符
        print(f"[验证成功] 成功以 GBK 编码解析内容:{preview[:30]}...")
        return True
    except UnicodeDecodeError as e:
        print(f"[验证失败] 文件并非合法的 GBK 格式:{e}")
        return False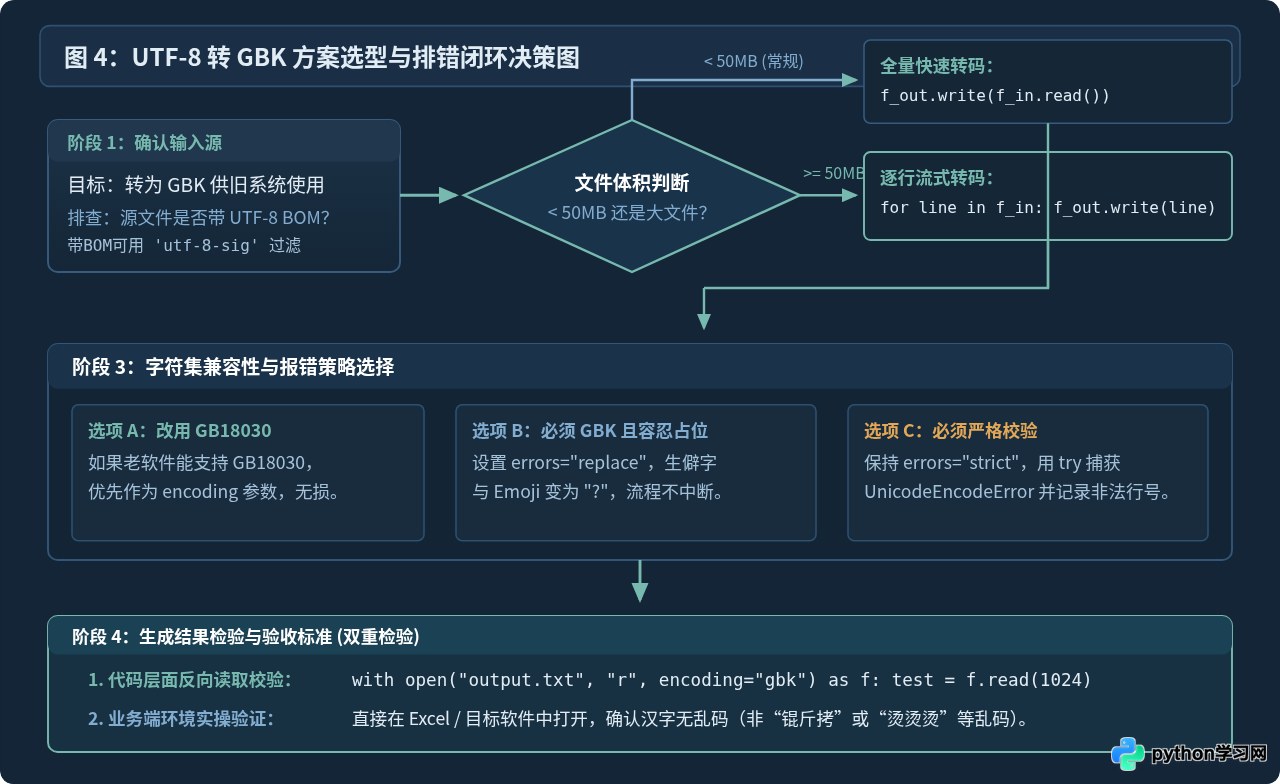
总结
用 Python 将 UTF-8 文件保存为 GBK 格式的核心在于利用语言内置的编解码抽象:通过 open(src, "r", encoding="utf-8") 完成解码,再通过 open(dst, "w", encoding="gbk") 完成重新编码。在常规单文件场景下,标准的 with 语法即可提供稳健支持;面对大规模数据时,采用 for line in f_in 逐行推流能够实现极低的内存开销;而在字符集存在交集之外的 Emoji 或生僻符号时,合理配置 errors="replace" 或改用国家标准 gb18030,能够保障业务流程平稳不中断。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















