


Java和Python的内存管理机制有什么不同?
深入对比Java与Python的内存管理机制:从底层内存布局、对象创建开销、核心回收算法(可达性追踪vs引用计数+循环分代)到内存碎片处理、多线程影响与开发者调优实战。
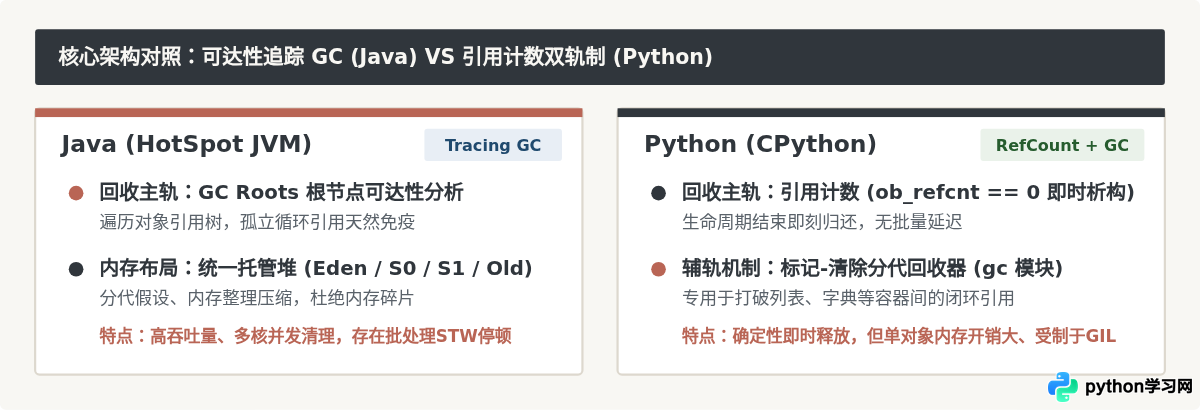
01 内存空间组织:JVM运行时数据区 VS CPython分层内存模型
在探讨如何回收之前,首先需要明确两者在操作系统层面是如何划分和组织内存的。两者的设计出发点截然不同:Java将整块虚拟内存划分为严格的功能区域,而Python在C语言运行时的基础上构建了一个专为小对象优化的多级内存池。
1. Java (JVM HotSpot) 的空间划分
JVM 在启动时通过 -Xms 和 -Xmx 向操作系统申请一块连续的堆内存空间,并严格区分为:
- 堆区 (Heap):所有线程共享。存放所有的对象实例及数组。现代HotSpot虚拟机在逻辑上将其划分为年轻代(Young Generation,包含Eden区和两个Survivor区S0/S1)与老年代(Old Generation)。
- 元空间 (Metaspace):自Java 8起移至本地内存(Native Memory),存放类的元数据、运行时常量池等,不再占用JVM堆,彻底解决了旧版本永久代(PermGen)的
java.lang.OutOfMemoryError: PermGen space问题。 - JVM虚拟机栈与本地方法栈:线程私有。每个方法调用都会压入一个栈帧(Stack Frame),包含局部变量表、操作数栈、动态链接和方法出口。栈上的基本类型和对象引用在方法退出后自动弹栈出栈,开销极小。
2. Python (CPython) 的分层内存池模型
CPython作为C语言编写的解释器,将内存管理划分为4个层次(Layer 0 至 Layer 3):
- Layer 0(OS系统层):由操作系统的虚拟内存管理器通过系统调用(如
malloc、mmap)分配底层连续地址空间。 - Layer 1(Python通用分配器):对标准 C 库函数封装一层薄封装,确保跨平台一致性。
- Layer 2(PyMalloc 小对象专用分配器):Python 的核心优化所在。针对小于或等于 512 字节的小对象(绝大部分Python对象都属于此类),向操作系统批量申请 256KB 的 Arena(竞技场);每个 Arena 切分为 4KB 的 Pool(池);每个 Pool 内部则被切分为固定尺寸的 Block(块,按8字节对齐递增,如8B、16B、...、512B)。这有效避免了海量小对象频繁引发系统级
malloc/free调用带来的系统态切换与内存碎片。 - Layer 3(特定对象缓存层):针对内置类型的自由链表(Free List),例如固定范围的小整数(-5 到 256)全局单例驻留,短字符串驻留(Interning),空元组单例等。
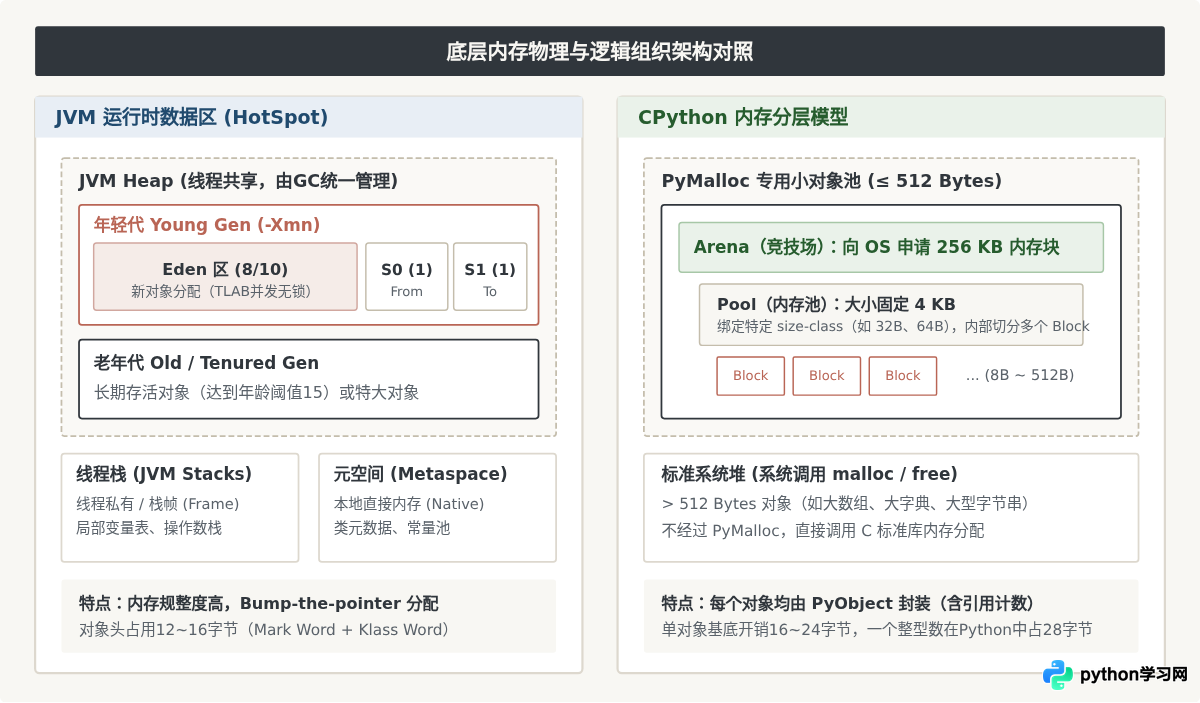
02 对象生命周期与回收机制:本质差异在哪?
理解两种语言内存机制最核心的分水岭在于:“谁来判断对象已经死亡,以及在何时触发物理释放?”
Java 机制:追踪式 GC (Tracing GC) 批处理
Java 对象不记录自己被谁引用了多少次。当一个变量赋值改变或方法结束时,内存中什么都不会立刻发生。只有当 JVM 堆空间耗尽或触发阈值时,垃圾收集器才会启动全局遍历,从活跃的“GC Roots”出发,像画树形图一样寻找所有连通的对象。未连通的即为垃圾。
Python 机制:引用计数 + 循环分代 即时响应
Python 中每一个对象头部都有一个计数器 ob_refcnt。每当有变量指向它、被存入集合或作为实参传递时,计数器 +1;当变量超出作用域、被赋新值或执行 del 时,计数器 -1。一旦归零,其占用的内存立即被析构释放。
1. Python 的阿喀琉斯之踵:循环引用
引用计数极其高效且直观,但它有一个先天的致命缺陷:无法解决循环引用(Reference Cycle)。请看以下代码:
import sys
import gc

class Node:
    def __init__(self, name):
        self.name = name
        self.next = None

# 1. 创建两个节点并互相引用
a = Node("A")
b = Node("B")
a.next = b
b.next = a  # 构成了闭环引用环

# 2. 删除外部名字引用
del a
del b
# 此时对象 A 和 B 在堆中互相持有对方的引用,两者的 ob_refcnt 均为 1!
# 单纯依靠引用计数机制,这两个对象永远不会被释放,造成内存泄漏。
为了解决这个问题,CPython 引入了循环垃圾收集器(Cyclic Garbage Collector,即 gc 模块)。它的运作并非监控所有对象,而是专门针对能够包含其他对象引用的“容器对象”(如 list、dict、set、tuple、自定义类实例)。基本类型(如 int、str、float)无法包含其他对象引用,因此不参与此机制。
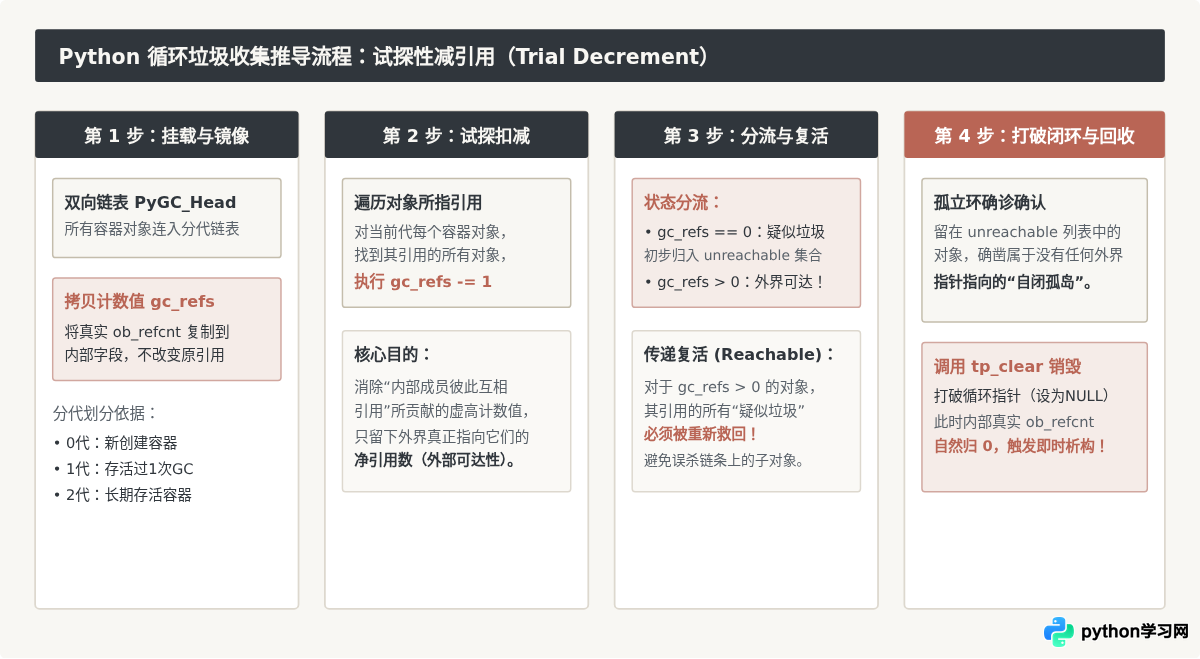
2. Java 的天然免疫:GC Roots 可达性遍历
与 Python 苦心孤诣维护双向链表和试探性减引用不同,Java 在设计上对“循环引用”天生免疫。Java 垃圾回收器根本不在乎对象之间是否打结,它只关注一个事实:从根节点集合(GC Roots)出发,顺着引用链能否找到你?
常见的 GC Roots 包括:
- 当前处于执行状态的线程栈帧中的局部变量和输入参数引用的对象;
- 类中的静态变量(
static引用); - 本地方法栈中 JNI(Java Native Interface)引用的对象;
- Java虚拟机内部的常驻引用(如系统类加载器、异常对象 NullPointerException 等)。
如果对象 A 和对象 B 互相关联,但两个对象与任何活跃的 GC Roots 均无连通路径,在垃圾收集器执行标记阶段时,它们就直接被标记为死亡状态,随后在清理阶段整体抹除。这使得 Java 程序员完全不需要担心写出循环引用导致的内存泄露问题。
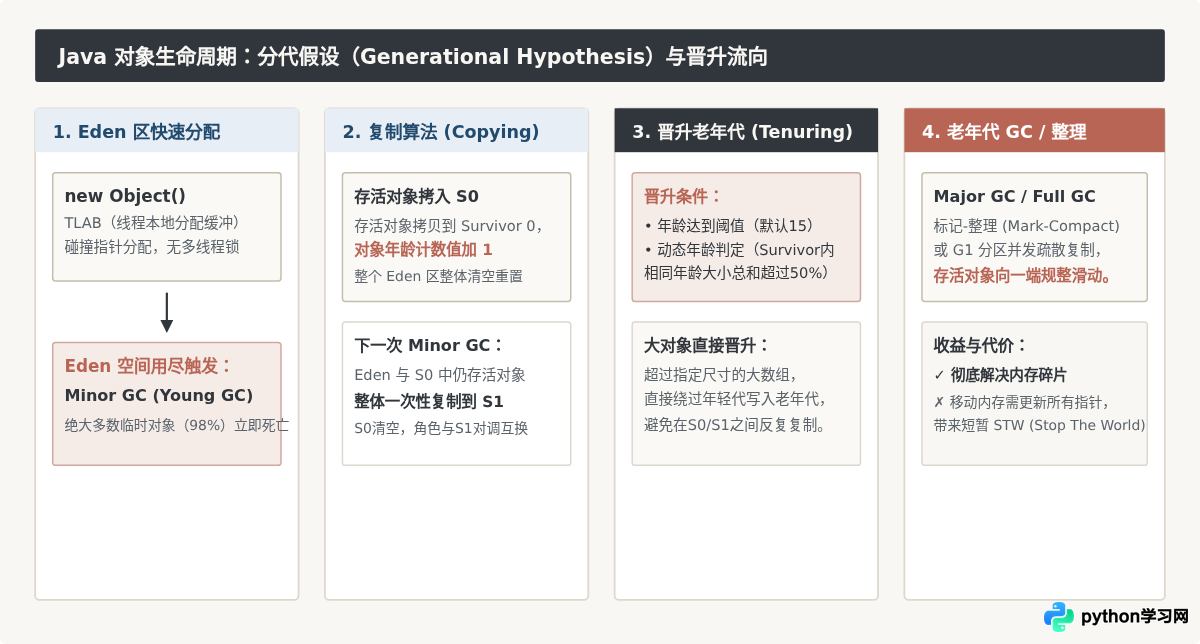
03 内存碎片与空间归还:为什么Python进程常驻内存“只增不减”?
在生产运维实践中,工程师们常常会发现一个有趣的现象:一个处理大规模批量数据的 Python 脚本,在读取并解析完数个 GB 的文件后,即便主动执行了 del data 并调用了 gc.collect(),操作系统的 top 或 htop 指令中该进程的驻留物理内存(RSS)依然居高不下;而 Java 服务在经历一次 Full GC 或 G1 并发周期后,堆内存通常能清晰地收缩。
这是由两者的内存压缩策略与操作系统归还协议决定的:
1. Java 的内存整理机制 (Compaction)
Java 的垃圾收集器(如 Parallel GC、G1 GC 以及最新的 ZGC)大多包含压缩(Compacting)或疏散(Evacuation)步骤:
- 收集器在识别出存活对象后,并不是原地掏空死亡对象(那会留下坑坑洼洼的内存空洞),而是将所有存活对象向堆内存的一端连续滑动拷贝,随后直接将边界指针之后的全部内存一笔清零。
- 这样分配内存时永远可以使用高效的“碰撞指针(Bump the pointer)”。同时,现代 JVM(如 G1 和 ZGC)会在堆内存连续空闲且低于负载阈值时,通过系统调用将未使用的物理页真金白银地归还给操作系统内核。
2. Python PyMalloc 的 Arena 锁定效应
Python 之所以显得“吃内存不还”,原因在于其核心架构 PyMalloc 的设计原则:
- PyMalloc 只有在一整个 256KB 的 Arena(包含 64 个 4KB Pool)中的所有 Block 全部彻底变为空闲时,才会调用 C 库的
free()将这 256KB 归还给系统。 - 如果一个 256KB 的 Arena 中,有 63 个 Pool 已经全部释放,但唯一剩下的 1 个 Pool 里哪怕只有一个 32 字节的 Python 字符串仍然被引用,整座 256KB 的 Arena 就必须继续在物理内存中驻留!
- 这种高密度的“内存空洞(Fragmentation)”导致内存页无法解绑,形成了典型的“逻辑已释放,物理不归还”现象。对于 Python 而言,解决海量数据批处理内存暴涨的最佳实践通常是采用多进程(multiprocessing)架构,让子进程完成批任务后直接退出,由操作系统内核强制连根回收全部物理页。
04 多线程与并发环境下的内存表现
现代计算机均是多核心架构,并发访问内存时的吞吐量表现,进一步放大了 Java 与 Python 机制的差异:
1. Python 的全局解释器锁 (GIL) 与引用计数并发争用
为什么官方 CPython 长年保留 GIL?引用计数本身正是最大阻力之一。
在 CPython 中,任何一个对象的传递、读取、赋值都会引发 ob_refcnt 的增减。如果允许多个线程真正并行执行 Python 字节码,那么每一次对象的简单读取都必须对引用计数器进行原子操作(Atomic operations,如 LOCK CMPXCHG)或加互斥锁。现代 CPU 的缓存一致性协议(MESI)会导致高频修改的计数器在各个核心的 L1/L2 缓存行之间频繁失效、疯狂颠簸(Cache Bounce),导致多线程性能出现断崖式暴跌。GIL 保证了同一时刻只有一个原生线程在修改对象的引用计数值。
在 Python 3.13 试验性的 No-GIL 模式(PEP 703)中,官方引入了 mimalloc 分配器、偏向引用计数(Biased Reference Counting)与延迟引用计数(Deferred Reference Counting),将全局常量和顶层模块对象的计数修改彻底冻结,才艰难打破了这一历史束缚。
2. Java 的线程本地分配缓冲 (TLAB) 与高并发GC
Java 在高并发内存分配上展现了极高的工业级成熟度:
- 分配期零锁竞争:JVM 在 Eden 区为每个新创建的线程预先切分一块独享的私有缓冲区——TLAB (Thread Local Allocation Buffer)。线程内部执行
new时,直接在自己的 TLAB 内通过碰撞指针划分内存,完全无须跨线程同步加锁,极具吞吐优势。 - 多核并行标记与整理:Java 现代收集器(G1、ZGC、Shenandoah)利用多核 CPU 的计算能力,GC 线程与应用业务线程并发交替执行。ZGC 更是通过染色指针(Colored Pointers)和读屏障(Load Barriers),将全局垃圾回收停顿时间压缩到了毫秒(甚至微秒)级别,支持数 TB 级别的堆内存。
05 开发者主动介入与调优对比实操
虽然两门语言都倡导自动内存管理,但在面对高并发、低延迟或大数据量场景时,开发者可以调用的工具箱存在清晰的边界:
| 控制维度 | Java (JVM) 的控制手段与接口 | Python (CPython) 的控制手段与接口 |
|---|---|---|
| 容量硬限制 | -Xms4g -Xmx4g 启动即锁定物理边界,超出抛出 OOM |
无原生内置最大堆限制,依赖操作系统 ulimit 或 cgroups 限制 |
| 显式触发回收 | System.gc()(仅向JVM建议,JVM常直接忽略;可配合 -XX:+DisableExplicitGC 禁用) |
gc.collect()(确定性强制触发对指定代或全部代的循环检测,立即执行) |
| 生命周期监控 | java.lang.ref.WeakReference、PhantomReference、Cleaner 机制 |
sys.getrefcount(obj) 查看计数,weakref 弱引用模块 |
| 收集器选型 | 丰富:-XX:+UseG1GC、-XX:+UseZGC、-XX:+UseParallelGC |
单一内置引擎:只能通过 gc.disable() 关停循环收集器,或 gc.set_threshold() 调整频次 |
| 对象终结陷阱 | finalize() 已被全面废弃,强制使用 AutoCloseable 与 try-with-resources |
__del__() 析构方法;早期版本中循环引用的对象带 __del__ 会导致无法回收,Python 3.4+ PEP 442 改善了销毁顺序 |
Python 实战:监控与精确解除循环引用
在长时间运行的 Python 守护进程中,可以通过 gc 模块排查未被释放的闭环对象:
import gc
import sys

# 1. 临时调紧或查询触发阈值 (默认常为: 700, 10, 10)
# threshold[0] 表示新分配容器数与释放容器数之差达到 700 时,触发 0 代 GC
print("当前分代阈值:", gc.get_threshold())

# 2. 手动启动垃圾收集,并打印回收的不可达对象数量
unreachable_count = gc.collect()
print(f"本次收集清理的孤岛循环引用对象数: {unreachable_count}")

# 3. 使用弱引用避免闭环
import weakref

class Parent:
    def __init__(self):
        self.child = None

class Child:
    def __init__(self, parent):
        # 使用弱引用指向父对象,不增加 parent 的 ob_refcnt!
        self.parent = weakref.ref(parent)
Java 实战:非强引用与显式堆外资源管理
Java 提供了丰富的引用类型(SoftReference 内存不足时回收,WeakReference 只要触发 GC 就回收)以及用于释放堆外 DirectByteBuffer / 数据库连接的确定性范式:
import java.lang.ref.WeakReference;

public class MemoryDemo {
    public static void main(String[] args) {
        // 1. 强引用:只要引用在,JVM 宁可抛出 OOM 也绝不回收
        Object strongObj = new Object();

        // 2. 弱引用:常用于构建缓存(如 WeakHashMap)
        WeakReference<Object> weakRef = new WeakReference<>(strongObj);
        strongObj = null; // 消除唯一的强引用

        // 3. 必须通过 try-with-resources 显式管控外部资源(文件、连接等)
        try (AutoCloseableResource res = new AutoCloseableResource()) {
            res.doWork();
        } catch (Exception e) {
            e.printStackTrace();
        } // 离开大括号立刻确定性执行 close(),杜绝滞后风险
    }
}
06 总结与工程选型建议
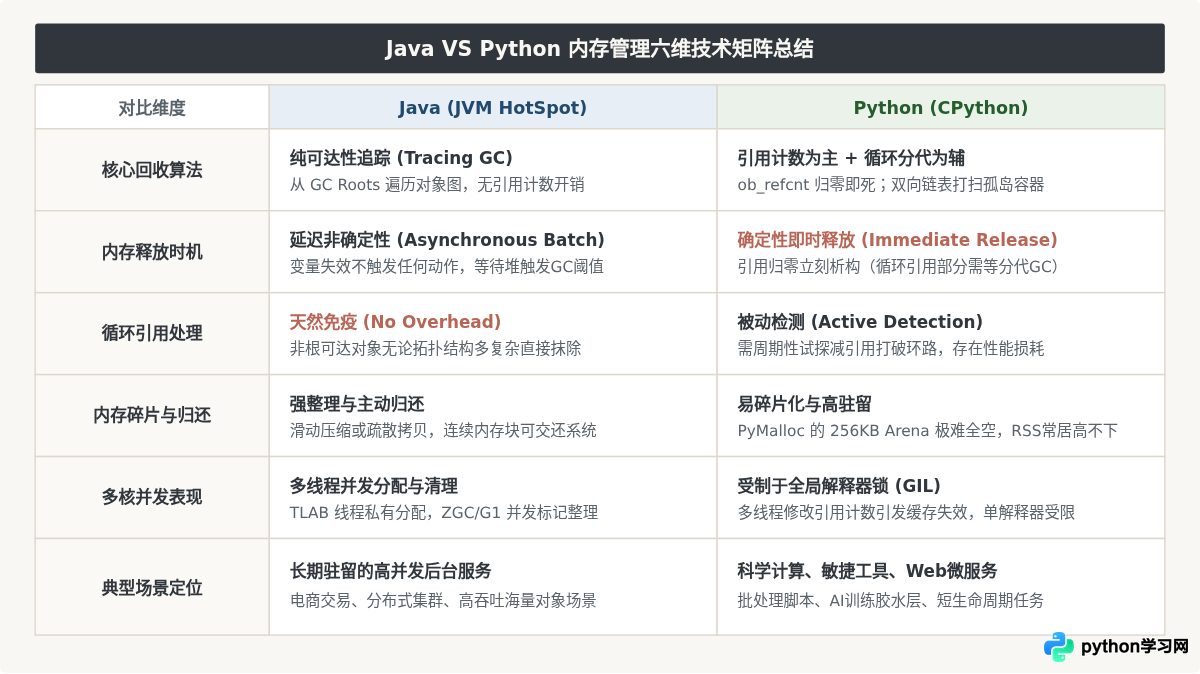
综上所述,Java 和 Python 的内存管理没有绝对的高下之分,而是各自在语言运行时的核心设计目标之间做出的平衡取舍:
Java 选择了“重装甲、高吞吐”的集中管理路线。它将内存管理的所有复杂性全部收口在 JVM 内部。开发者无需分心于对象的生死细节,依靠先进的分代算法、TLAB 并发无锁分配以及内存整理,在处理持续高并发、海量对象分配与长期稳定运行的企业级后端应用时,具备极佳的吞吐量与堆健康度。
Python 选择了“轻量级、确定性即时释放”的务实路线。通过简单的 ob_refcnt 计数器,让大多数非循环对象在生命周期终结时被即刻抹去,免除了后台定时大停顿的困扰。虽然牺牲了一定的单对象空间开销,并为处理循环引用引入了额外的分代检测链表,但这完美契合了其轻量脚本、数据分析胶水层和敏捷开发的工程定位。
在工程实践中,编写 Python 代码时应尽量避免非必要的深度循环嵌套数据结构,对长生命周期的父子关系主动使用 weakref,海量数据批处理优先考虑多进程拆分;而在编写 Java 系统时,则应充分利用 Try-with-Resources 保护堆外系统资源,根据业务吞吐与延迟容忍度合理选配 G1 或 ZGC 收集器,避免大对象直接冲击老年代,以此最大化释放两门语言的底层威力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















