


Python %取模运算实战:怎么判断奇偶数与控制循环索引
深入解析Python百分号%取模运算符的底层计算机制,详述向下整除原理与正负数边界特征,实战演示如何高可靠判断奇偶数、实现环形双向循环索引回绕、周期性批处理及网格坐标映射。
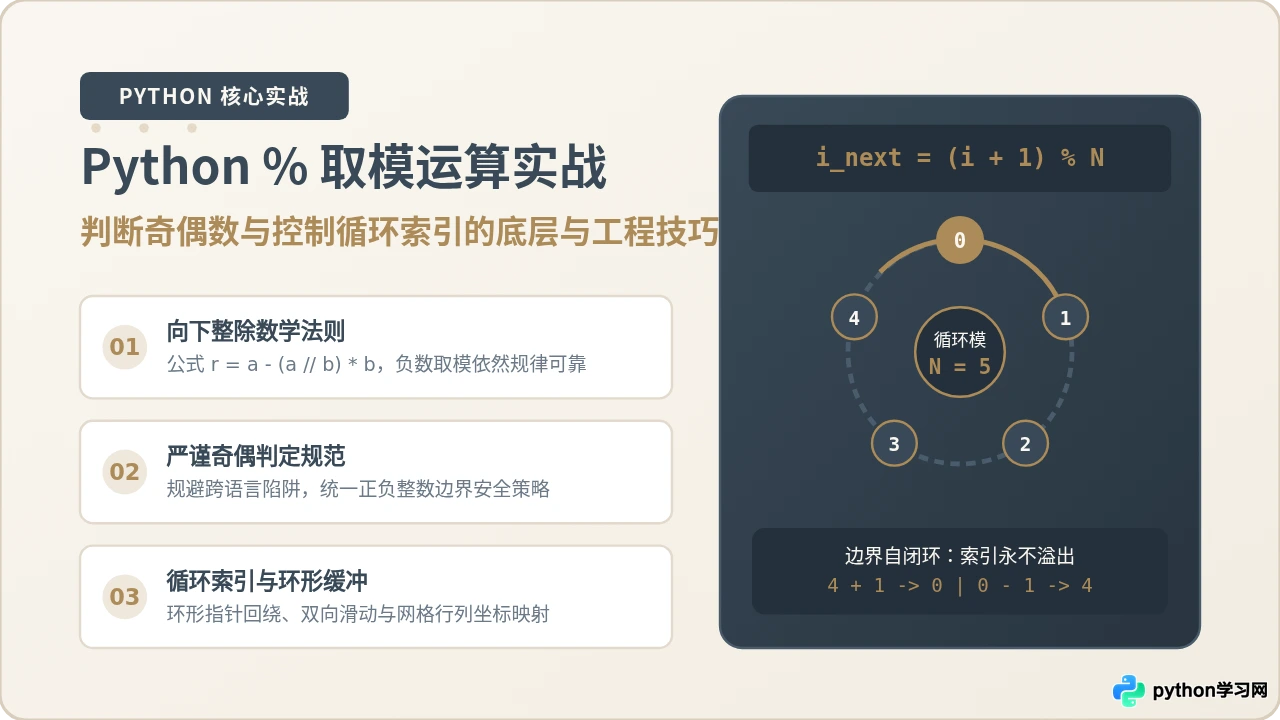
在 Python 开发中,百分号 % 绝不仅是算术课里的“求余数”工具。由于 Python 严格采用“向下整除”(Floored Division)的数学定义,取模运算在处理负数时展现出了高度稳定和规律的非负区间特性。本文将从底层公式推导切入,直接解答如何规避跨语言陷阱精确判定奇偶数,并系统梳理在环形缓冲区、轮询分发、周期任务节流以及二维网格坐标转换中的高频循环控制模式。
一、Python 取模运算的数学本质与向下整除机制
许多开发者在初学编程时,习惯将 % 简单理解为“除法之后的剩余数值”。但在算法和严谨的工程实践中,余数(Remainder)与模(Modulo)并不完全等同。不同编程语言对整除的定义直接决定了取模运算在负数参与时的行为差异。
Python 的官方语言规范中,取模运算 r = a % b 严格绑定整除运算符 //,其数学公式定义为:
# Python 取模与向下整除的根本恒等式
r = a - (a // b) * b
理解这一公式的关键在于 a // b 的取整方向。在 C、C++ 或 Java 等语言中,整数除法采用的是“向零截断”(Truncate towards zero),即 -7 / 3 的结果为 -2。但在 Python 中,// 执行的是向下整除(Floored Division),即始终向数轴的负无穷方向取整:
7 // 3得到2,因此7 - (2 * 3) = 1;-7 // 3向下取整得到-3(因为-2.333...向负无穷方向取整是-3),因此-7 - (-3 * 3) = -7 - (-9) = 2。
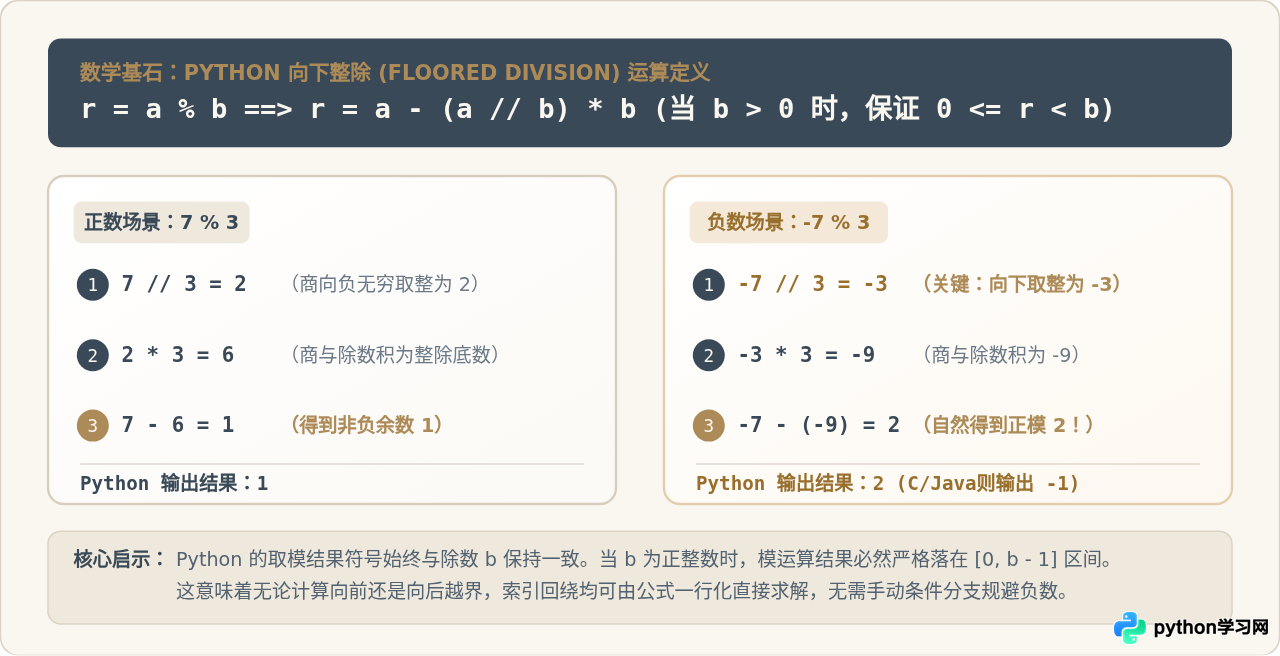
当除数 b > 0 为正整数时,无论被除数 a 是正数还是负数,Python 计算得到的 a % b 必然严格落在闭区间 [0, b - 1] 内,符号始终与除数 b 保持一致。正是这一数学特性,让 Python 在处理数组逆向索引回绕时,完全不需要像其他语言那样手动编写补正判断。
二、实战演练:高可靠判断奇偶数与边界防御
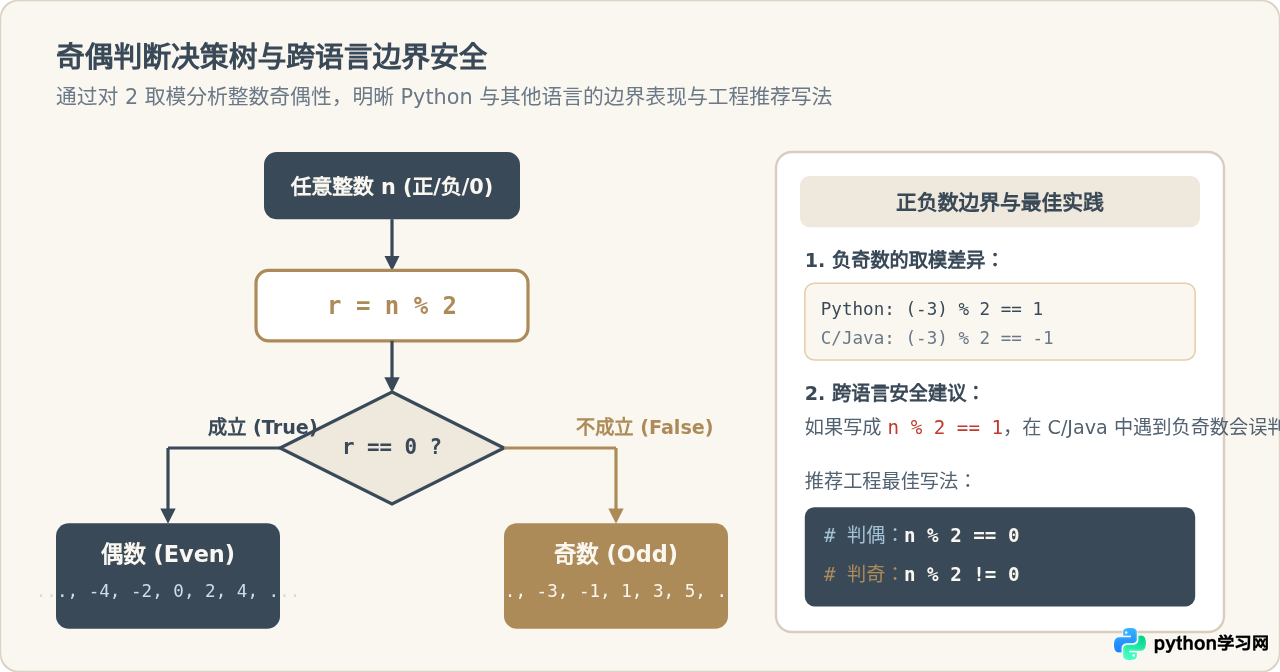
奇偶数判断是编程中最基础的分支逻辑之一。在十进制与二进制运算中,整数除以 2 只有两种可能:能被整除或留下余数 1。利用 % 2 可以直接实现布尔判定。
1. 标准写法与常见误区
在 Python 中,判断整数 n 是否为偶数的标准语句是:
def is_even(n: int) -> bool:
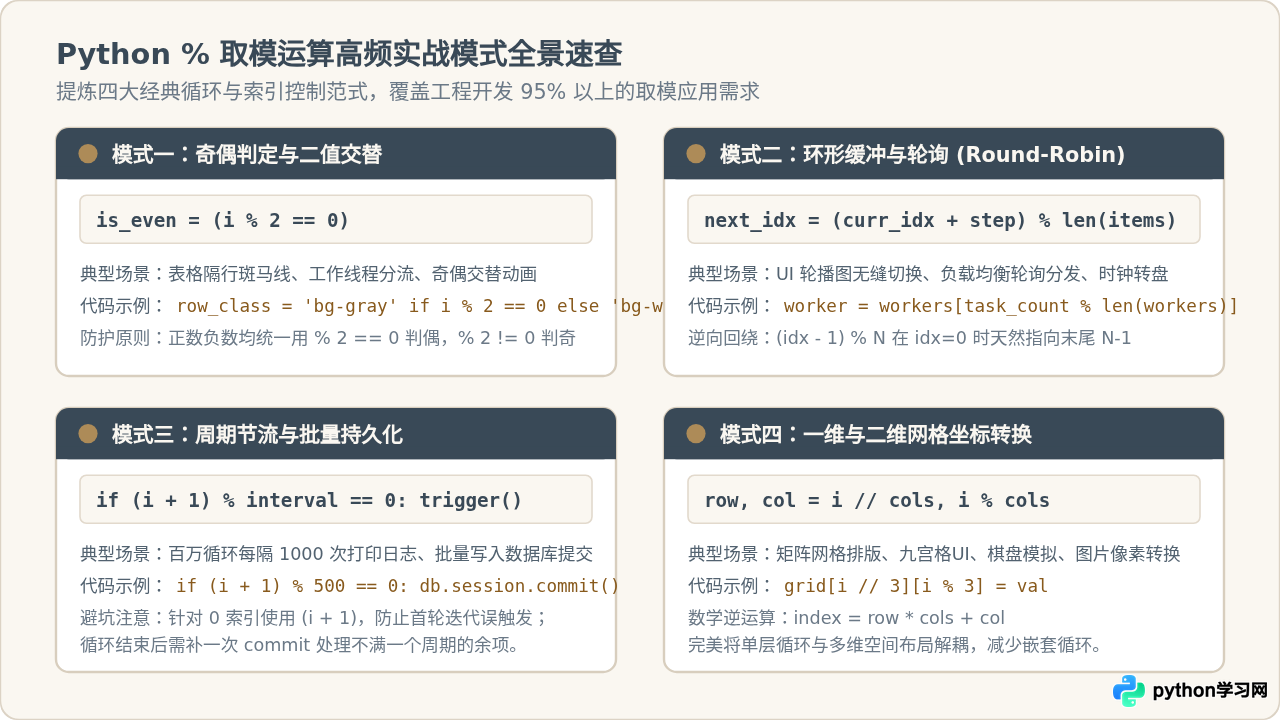
    return n % 2 == 0

def is_odd(n: int) -> bool:
    return n % 2 != 0  # 推荐写法
在许多教学场景中,部分初学者喜欢将奇数判定写成 n % 2 == 1。在 Python 语言环境下,由于 (-3) % 2 计算结果确实是 1,该语句对于负奇数同样能输出 True,不会产生语法错误。
然而,从代码可移植性与工程防御角度考虑,强烈建议统一采用 n % 2 != 0 来判断奇数。原因在于:在 C、C++、Java 或 JavaScript 中,向零截断导致 (-3) % 2 的结果为 -1。如果在这些语言中写 n % 2 == 1,负奇数将全部被判定为 False,从而引发隐藏极深的逻辑缺陷。养成 n % 2 != 0 的习惯能够保证逻辑跨语言完全通用。
2. 实际业务场景:交替样式与列表过滤
在日常开发中,奇偶判断通常结合循环遍历或列表推导式使用。例如为前端数据列表生成隔行变色的斑马纹样式(Zebra Striping):
items = ["苹果", "香蕉", "橙子", "西瓜", "葡萄"]

for index, fruit in enumerate(items):
    # 根据索引奇偶性分配不同的背景色样式类
    row_style = "row-even" if index % 2 == 0 else "row-odd"
    print(f"行 {index} [{row_style}]: {fruit}")
再比如在数据清洗中快速分离偶数与奇数批次:
numbers = [-7, -4, -2, -1, 0, 3, 6, 9]
evens = [x for x in numbers if x % 2 == 0]
odds = [x for x in numbers if x % 2 != 0]

# 示例输出:
# evens -> [-4, -2, 0, 6]
# odds  -> [-7, -1, 3, 9]
在极端追求微秒级性能的底层运算中,部分开发者会使用位与操作 (n & 1) == 0 判定偶数。在 C 语言底层这会对应一条位操作指令。但在 Python 中,解释器的字节码优化与动态类型开销使得两者的实际耗时差异微乎其微。出于团队代码的可读性与直观表达考虑,取模运算符 % 2 依然是绝大多数 Python 项目的首选。
三、实战演练:控制循环索引与环形缓冲区
在软件交互和算法设计中,我们经常遇到“有限容器”与“无限递增步骤”之间的矛盾。例如图片轮播图、轮询任务分配器(Round-Robin Scheduler)或无锁环形队列。如果直接自增索引,很快就会触发 IndexError: list index out of range。
1. 正向回绕:时钟指针模型
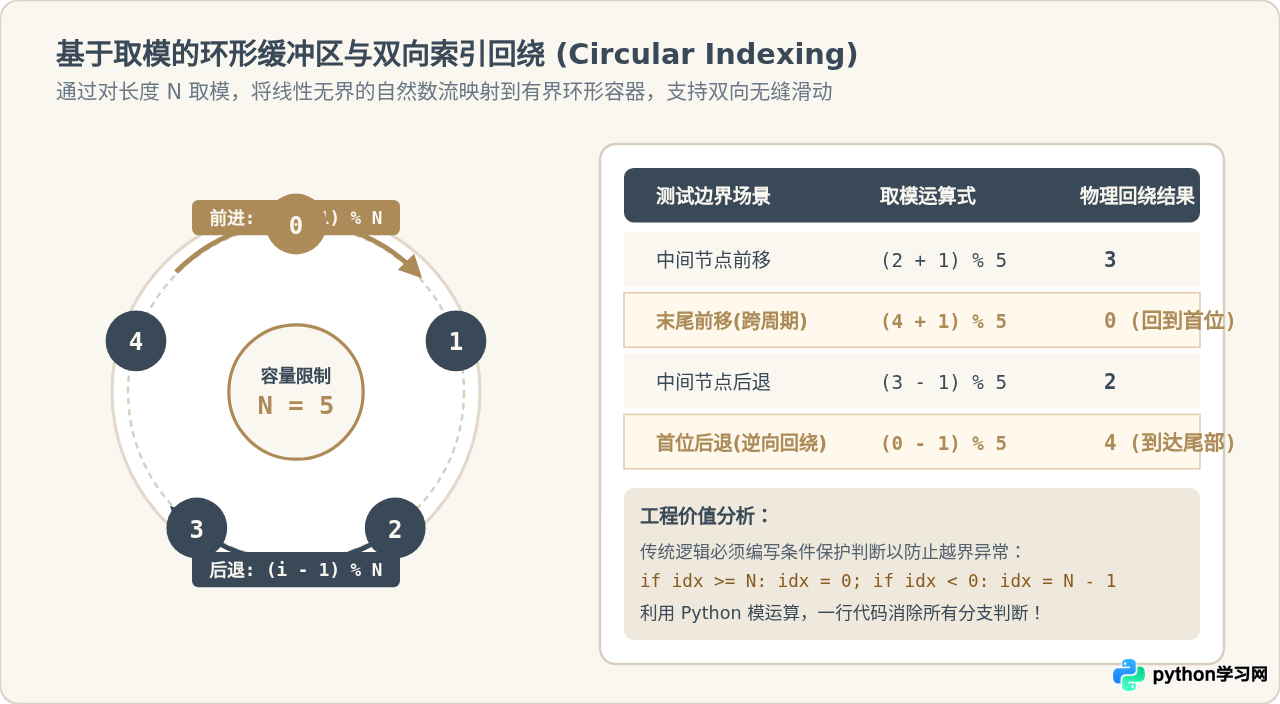
假设列表长度为 N,有效索引范围为 0 至 N - 1。当我们从当前位置 curr_idx 向前移动 1 步时,直接通过对 N 取模即可完成闭环回绕:
next_idx = (curr_idx + 1) % N
当 curr_idx 到达末尾 N - 1 时,(N - 1 + 1) % N = N % N = 0,指针自动回到列表头部。
2. 逆向回绕:Python 取模的杀手级优势
很多开发者在实现“轮播图点击上一页”时,会下意识编写条件分支:
# 繁琐且冗余的分支写法
prev_idx = curr_idx - 1
if prev_idx < 0:
    prev_idx = N - 1
然而在 Python 中,这完全可以缩写为一行取模:
# 优雅的一行化逆向回绕
prev_idx = (curr_idx - 1) % N
我们来验证边界情况:当处于起点 curr_idx = 0 时,计算 (0 - 1) % N = -1 % N。根据前述的向下整除公式:
-1 // N = -1  (因为 -1 / N 介于 -1 与 0 之间,向下取整为 -1)
-1 - (-1 * N) = N - 1
结果精确等于 N - 1,也就是容器的最后一个有效索引!无论向前还是向后跳转任意步长 step,只要执行 (curr_idx + step) % N,Python 都能确保得到一个合法有效的索引。
3. 完整实战:多任务轮询调度器 (Round-Robin)
下面的完整代码演示了如何利用取模控制索引,在固定服务器集群中均匀分发无界任务流:
class ServerCluster:
    def __init__(self, servers: list[str]):
        self.servers = servers
        self.total = len(servers)

    def dispatch_tasks(self, tasks: list[str]):
        for task_id, task_name in enumerate(tasks):
            # 核心:使用 task_id % total 计算指派的服务器索引
            server_index = task_id % self.total
            target_server = self.servers[server_index]
            print(f"任务 [{task_name}] -> 分发至节点 {target_server} (索引 {server_index})")

cluster = ServerCluster(["Node-A", "Node-B", "Node-C"])
sample_tasks = ["支付核验", "图片压缩", "邮件推送", "短信验证", "日志归档"]
cluster.dispatch_tasks(sample_tasks)
示例输出(无溢出异常,天然均匀交替):
任务 [支付核验] -> 分发至节点 Node-A (索引 0)
任务 [图片压缩] -> 分发至节点 Node-B (索引 1)
任务 [邮件推送] -> 分发至节点 Node-C (索引 2)
任务 [短信验证] -> 分发至节点 Node-A (索引 0)
任务 [日志归档] -> 分发至节点 Node-B (索引 1)
四、进阶扩展:周期节流与二维网格坐标转换
除了直接作为容器指针,取模运算在循环控制中还有两个极为高频的衍生技巧:周期性任务节流与空间坐标解耦。
1. 循环节流与批量持久化 (Chunking / Batching)
在处理数十万行文件或爬虫抓取时,不可能每处理一行就写入一次磁盘或提交一次数据库事务。此时可以通过取模控制执行频率:
batch_size = 500
buffer = []

for i in range(1250):
    buffer.append(i)

    # 注意:针对 0 索引使用 (i + 1),避免在 i=0 时误触发
    if (i + 1) % batch_size == 0:
        print(f"触发持久化提交:已完成 {i + 1} 条数据处理")
        buffer.clear()

# 循环结束后处理尾部不足一个周期的剩余数据
if buffer:
    print(f"尾部补丁提交:处理剩余 {len(buffer)} 条数据")
    buffer.clear()
2. 一维索引与二维网格坐标的相互映射
在图形渲染、棋盘游戏开发或 UI 九宫格布局中,数据通常以一维数组形式存储在内存中。如果已知网格的列数 cols,我们可以利用整除 // 和取模 % 一行代码完成坐标映射:
| 变换方向 | 数学公式 | Python 代码实现 |
|---|---|---|
| 一维索引 -> 二维行列 | row = i / cols (向下整除), col = i mod cols | row, col = i // cols, i % cols |
| 二维行列 -> 一维索引 | i = row * cols + col | i = row * cols + col |
这种映射完全避免了多层 for 循环嵌套,让代码逻辑更加平铺扁平。
五、注意事项与常见陷阱排查
在享受取模运算便利性的同时,有两处细节需要特别警惕:
-
除数不能为零(ZeroDivisionError):当
b == 0时,执行a % b会直接抛出ZeroDivisionError: integer division or modulo by zero。如果取模的除数来源于外部输入或动态容器长度(如i % len(lst)),务必前置判断容器非空。 -
浮点数取模的精度偏差:Python 支持浮点数取模(如
7.5 % 2.1),其底层依然遵循a - (a // b) * b。但由于 IEEE 754 浮点二进制表示的固有误差,计算可能出现微小的精度飘移(例如0.3 % 0.1并不精准等于0.0,而是类似于0.09999999999999998)。在金融结算或高精度数值比对中,应避免直接使用%,建议使用decimal.Decimal或math.isclose进行判定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















