


Python for循环中range(len)获取索引与元素的方法
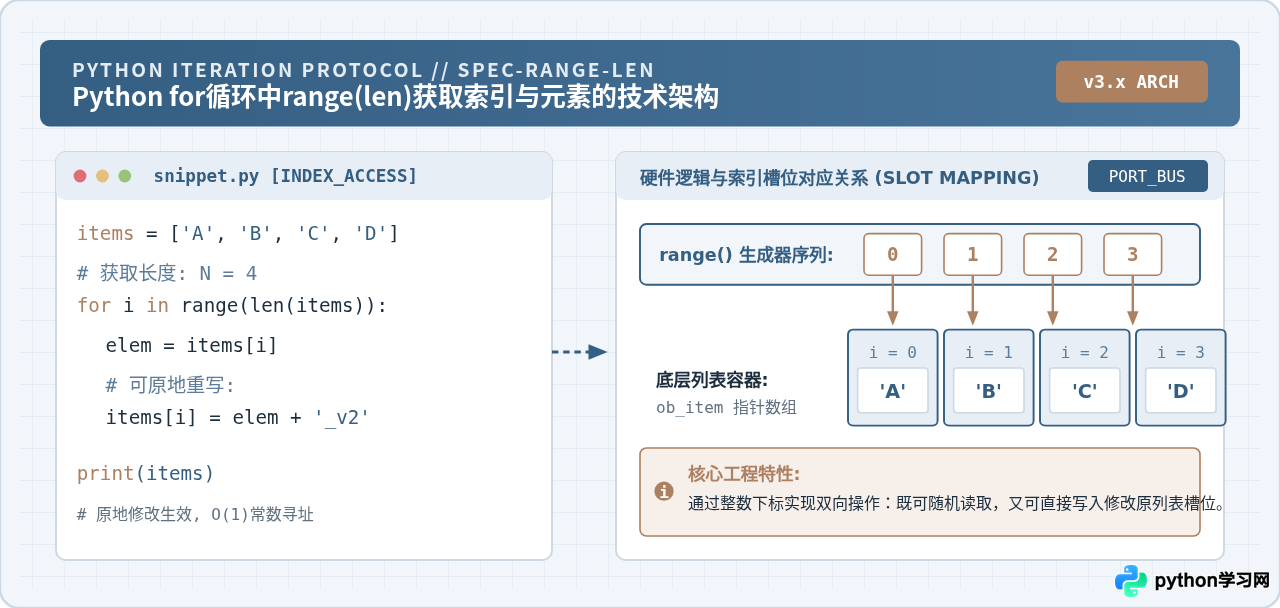
全面解析在Python for循环中使用range(len)获取索引与元素的核心语法、执行机制、内存寻址原理、典型应用场景及避坑指南。
range(len(sequence)) 构造从 0 到 N-1 的整数序列,进而在循环体内通过下标 sequence[i] 获取对应的元素值。该方法不仅能同时获得当前下标与对应数据,更是对原列表进行原地修改(In-place Mutation)与相邻元素相对寻址的关键手段。
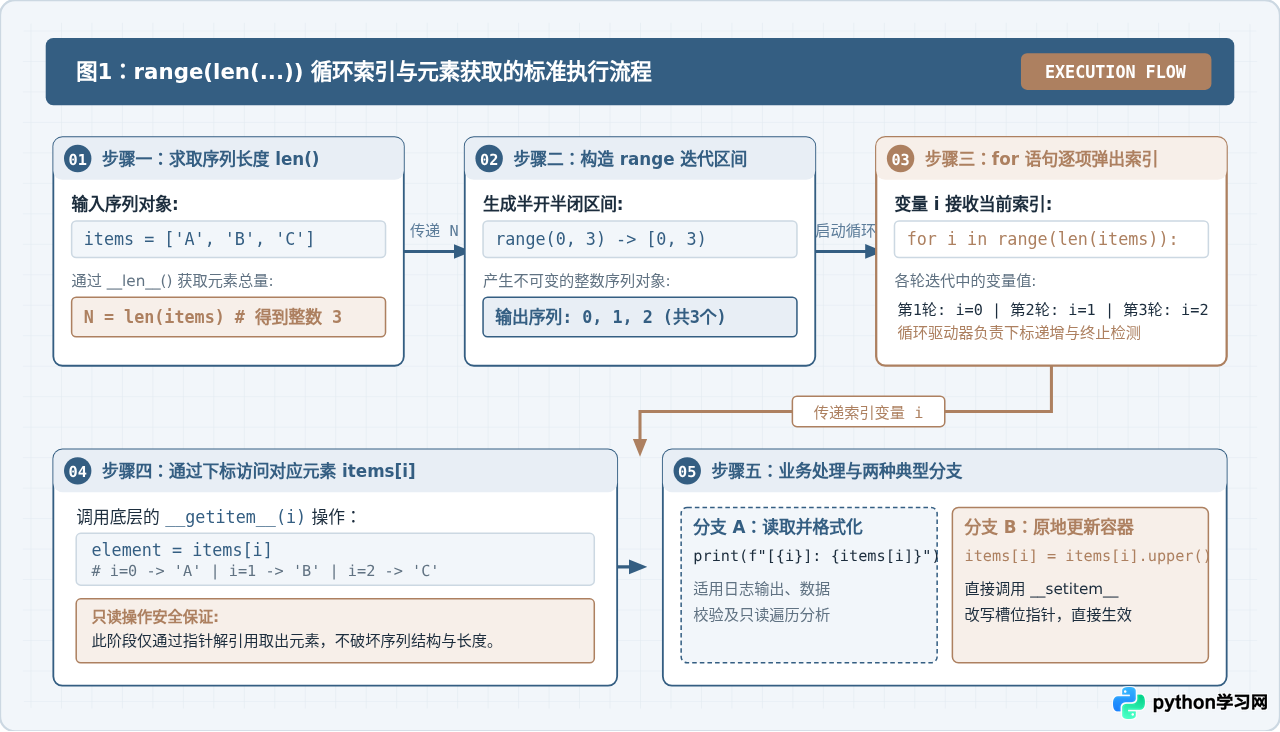
一、range(len(...)) 的基本语法与执行步骤
当编写循环逻辑时,range(len(...)) 实际上是将 Python 两个内建函数 len() 与 range() 进行嵌套调用。该语句由外及内的标准写法如下:
# 基础语法结构
sequence = ["apple", "banana", "cherry", "date"]

for i in range(len(sequence)):
    element = sequence[i]
    print(f"索引: {i}, 元素: {element}")
示例输出:
索引: 0, 元素: apple
索引: 1, 元素: banana
索引: 2, 元素: cherry
索引: 3, 元素: date
这一过程在 Python 解释器内部被严格分解为四个离散步骤:
- 求取序列长度:解释器首先计算
len(sequence),调用序列对象的__len__()魔法方法,快速返回整数长度N(本例中为 4)。 - 生成索引范围:将长度
N传入range(N),生成一个从0开始、到N-1结束的左闭右开不可变整数序列[0, 1, 2, 3]。 - 迭代循环驱动:
for语句作为循环驱动器,在每一轮迭代中从 range 序列中按序取出一个整数,并赋值给循环变量i。 - 随机下标寻址:在循环体内部,通过下标运算符
sequence[i]触发__getitem__(i)操作,从内存中取出对应槽位保存的对象引用。
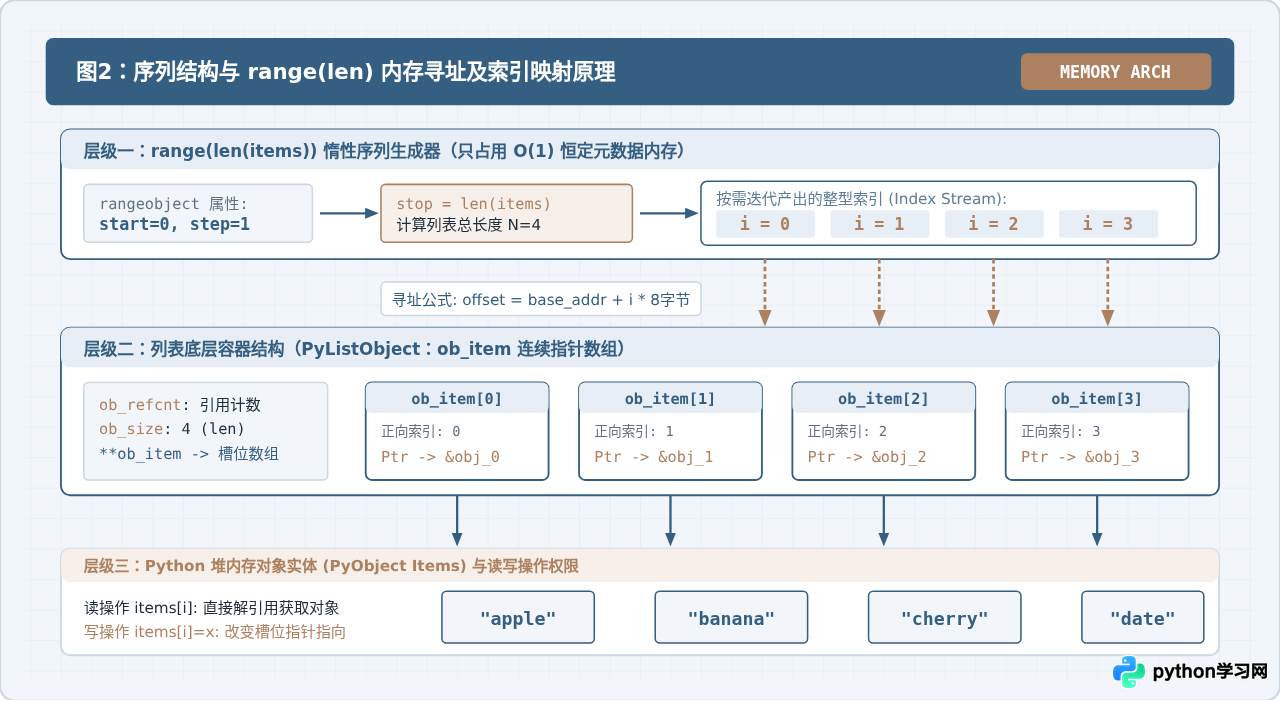
二、原理解析:索引映射与序列内存寻址机制
深入理解 range(len(...)) 的运行机制,有助于写出兼顾安全性与执行效率的代码。Python 的标准序列类型(如 list)在 CPython 底层表现为 PyListObject 结构体,其内部维护了一个连续的指针数组 ob_item。
1. len() 与 range() 的时间与空间复杂度
许多初学者担心每次循环是否会重复计算序列长度。在 Python 中,len(sequence) 并非通过遍历统计元素个数,而是直接读取结构体中已记录的 ob_size 字段,因此 len() 的耗时为常数时间 O(1)。
此外,Python 3 中的 range() 是一个惰性计算对象,仅在实例化时保存 start、stop 和 step 三个数值元数据。无论序列包含 10 个元素还是 1000 万个元素,range() 占用的内存空间都是恒定的 O(1),不会预先在内存中分配庞大的整型列表。
2. 内存下标偏移与随机访问
当执行 sequence[i] 时,CPython 依据首地址偏移公式 Target_Address = Base_Address + i * sizeof(PyObject*) 直接计算内存物理地址,从而在 O(1) 复杂度下完成快速寻址。这一硬件级的数组索引机制,使得下标访问非常高效。
三、典型应用场景与实用代码模式
尽管 Python 提供了直接遍历(for x in seq)以及带有计数的 enumerate(),但在以下四大典型工程场景中,range(len(...)) 具有不可替代的作用。
场景一:按索引原地修改列表元素(In-place Mutation)
如果需要在循环内部直接修改原列表的值,直接迭代 for item in items: item = new_val 是完全无效的。因为循环变量 item 只是指向当前对象的一个局部临时指针,对 item 重新赋值仅仅改变了该临时变量的指向,无法触及列表容器的槽位。
利用 range(len(...)) 获取的索引,可以通过 items[i] = new_value 触发 __setitem__,直接更新底层指针数组的槽位:
# 原地修改列表元素示例:将所有水果名称首字母大写
fruits = ["apple", "banana", "cherry"]

for i in range(len(fruits)):
    # 直接修改原列表槽位
    fruits[i] = fruits[i].capitalize()

print("修改后的列表:", fruits)
示例输出:
修改后的列表: ['Apple', 'Banana', 'Cherry']
场景二:相邻元素比较与滑动窗口计算
在金融数据分析、时序计算或算法问题中,经常需要将当前元素与前一个或后一个元素进行比对(例如计算股票涨跌差值、波峰检测)。通过索引运算,可以便捷地引用 sequence[i - 1] 或 sequence[i + 1]:
# 计算相邻数据的日增长量
prices = [100, 105, 103, 110, 115]

# 从索引 1 开始计算与前一天的差值
for i in range(1, len(prices)):
    diff = prices[i] - prices[i - 1]
    trend = "上涨" if diff > 0 else "下跌"
    print(f"第 {i} 天: 当前价格 {prices[i]}, 较前日{trend} {abs(diff)} 元")
场景三:步长跳跃与倒序反向遍历
range() 支持指定步长 step,这使得按奇偶间隔访问、跳跃采样或从尾部向前逆序遍历变得极其简练:
letters = ['A', 'B', 'C', 'D', 'E', 'F']

# 1. 步长遍历:每隔一个元素访问一次
print("--- 步长为 2 遍历 ---")
for i in range(0, len(letters), 2):
    print(f"偶数索引 {i}: {letters[i]}")

# 2. 逆序遍历:从最后一个有效索引倒序回退到 0
print("--- 逆序反向遍历 ---")
for i in range(len(letters) - 1, -1, -1):
    print(f"倒序索引 {i}: {letters[i]}")
注意:逆序遍历时,start 必须为 len(letters) - 1(因为最大下标是 N-1),stop 必须设定为 -1(才能包含索引 0),步长 step 设定为 -1。
四、常见陷阱与注意事项
使用 range(len(...)) 能够获得完全的底层控制权,但也要求开发者自行管理边界与数据一致性。以下是四个必须规避的代码陷阱:
1. 循环体内增删元素导致 IndexError 或漏项
len(sequence) 仅在循环启动前求值一次。如果循环体内部调用了 sequence.pop(i)、del sequence[i] 或 sequence.append(),序列的实际长度已经发生变化,而外层的 range 迭代器依然会按原定步数输出到旧的 N-1。此时极易抛出 IndexError: list index out of range,或因元素位移造成漏项。
规范做法:若需根据条件过滤元素,优先使用列表推导式 [x for x in seq if condition],或使用倒序删除。
2. 相对寻址越界(IndexError)
当执行 seq[i + 1] 时,若外层循环遍历到 i = len(seq) - 1,则 i + 1 会超出最大合法索引。必须将外层范围缩减为 range(len(seq) - 1)。
3. 空列表的执行表现
若输入为空列表 empty_list = [],len(empty_list) 返回 0,则 range(0) 不会产出任何数值。for 循环将安全地直接跳过,不会触发任何报错,这保证了空输入的鲁棒性。
4. 适用对象限制
range(len(...)) 依赖通过整数下标取值。该方法仅适用于支持随机访问的序列类型(如 list、tuple、str、bytes),不能直接作用于无序容器(如 set、dict)或生成器迭代器,否则会抛出 TypeError: 'set' object is not subscriptable。
五、与其他遍历方式的对比机制
在 Python 中,遍历序列主要有三种经典模式:直接元素遍历、enumerate() 计数包装 以及 range(len) 索引遍历。了解它们底层的设计意图有助于精准选型。
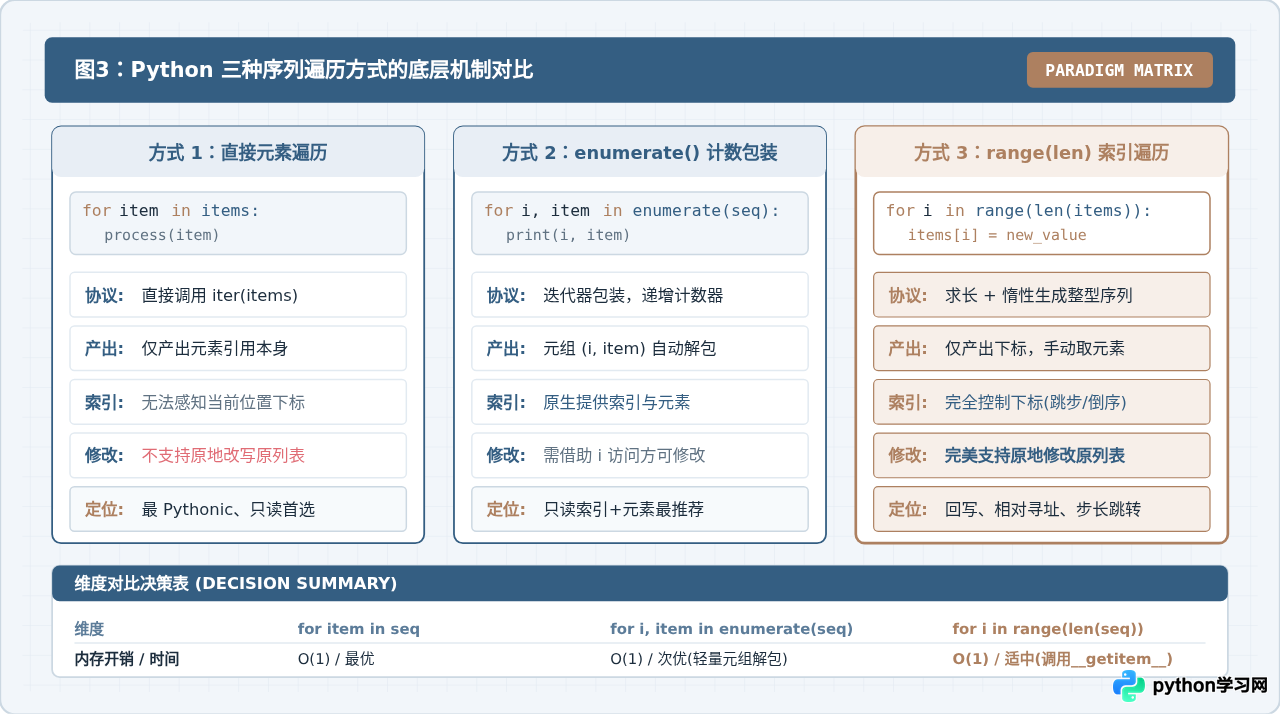
| 遍历方式 | 标准语法示例 | 底层产出机制 | 支持原地修改 | 最适业务场景 |
|---|---|---|---|---|
| 直接元素遍历 | for item in seq: |
直接调用 __next__() 返回元素指针引用 |
否(仅局部变量) | 仅需消费元素内容,无需关心元素位置 |
| enumerate 遍历 | for i, item in enumerate(seq): |
内部计数器递增,产出轻量元组 (i, item) |
部分(需借助 i 回写) | 推荐首选:同时读取索引与数据,只读展示 |
| range(len) 遍历 | for i in range(len(seq)): |
产生纯整数索引,通过 seq[i] 随机寻址 |
完全支持 | 原地更新列表、相邻元素滑窗、多序列同步修改 |
六、决策指导与实践总结
为了让代码兼顾 Pythonic 风格与执行效率,可以参考下面的决策流程图选择最恰当的遍历结构:
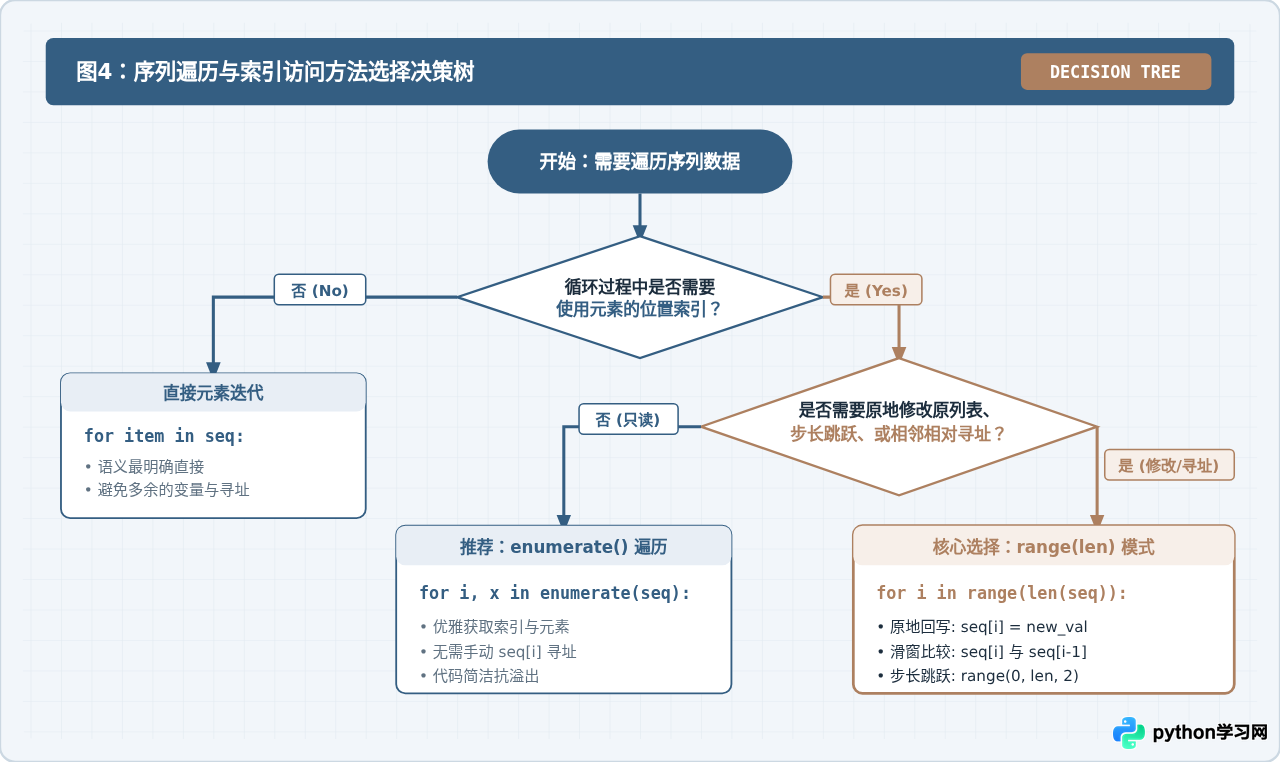
总结为三条简洁的选型原则:
- 原则 1(纯数据读取):若只需要读取元素本身,直接采用
for item in sequence:,语法最干净,性能开销最小。 - 原则 2(只读索引展示):若需要打印序号或根据位置做条件分支,但不需要改写原列表,优先选择
for i, item in enumerate(sequence):。 - 原则 3(原地改写或步长寻址):若必须对原列表槽位进行重写赋值(
sequence[i] = ...)、进行跳步遍历(step != 1)或进行相邻下标差分计算,坚决选用for i in range(len(sequence)):。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















