


Python内置difflib实现字符串模糊匹配的方法
深入解析Python标准库difflib实现字符串模糊匹配的核心方法与底层原理,系统讲解SequenceMatcher与get_close_matches的工程应用、Gestalt算法机制、与编辑距离的区别及性能优化策略。
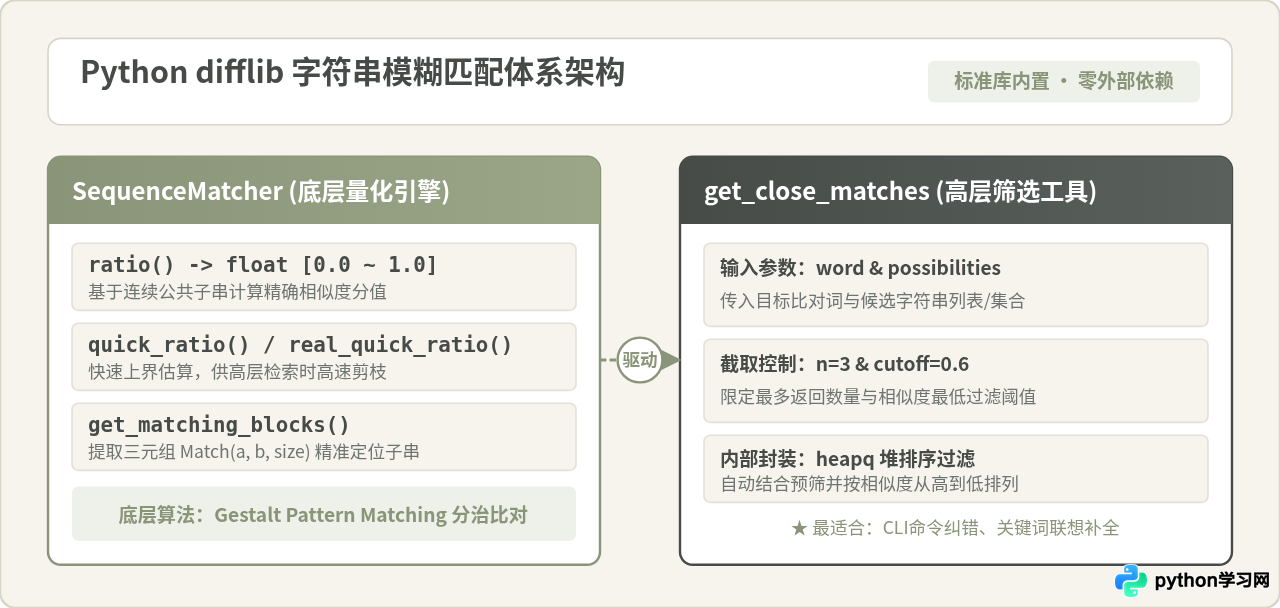
difflib 模块便能提供成熟的模糊匹配方案。模块的核心能力由两个层级构成:底层依托 SequenceMatcher 类度量任意两个序列的精确相似分值;上层通过实用函数 get_close_matches 实现基于阈值的候选列表筛选与降序截取。掌握其匹配算法与参数细节,可以在保持代码零外部依赖的同时,高效解决常见的字符串容错需求。
一、快速候选词筛选:get_close_matches 的实战用法
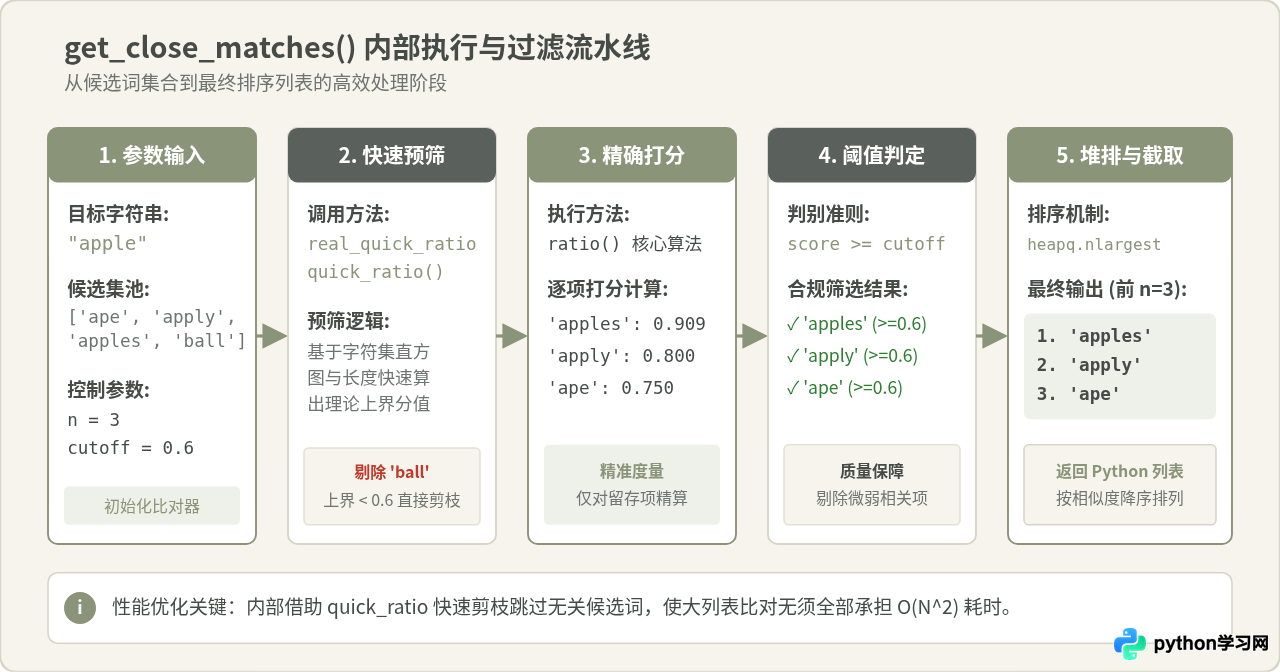
当需要从一组已知的候选字符串列表中,找出与用户输入最为接近的一项或多项内容时,最直接的方法是调用 difflib.get_close_matches。该函数在内部整合了相似度度量与堆排序,能够在单次调用中完成过滤与截断。
1. 函数原型与参数说明
函数的完整调用签名如下:
difflib.get_close_matches(word, possibilities, n=3, cutoff=0.6)- word:目标字符串,即需要进行匹配比对的原始输入文本。
- possibilities:候选字符串序列,通常为包含合法命令、关键词、文件名或标签的列表或集合。
- n:返回结果的最大数量,默认值为 3。返回列表中的候选项严格按照相似度从高到低排列。
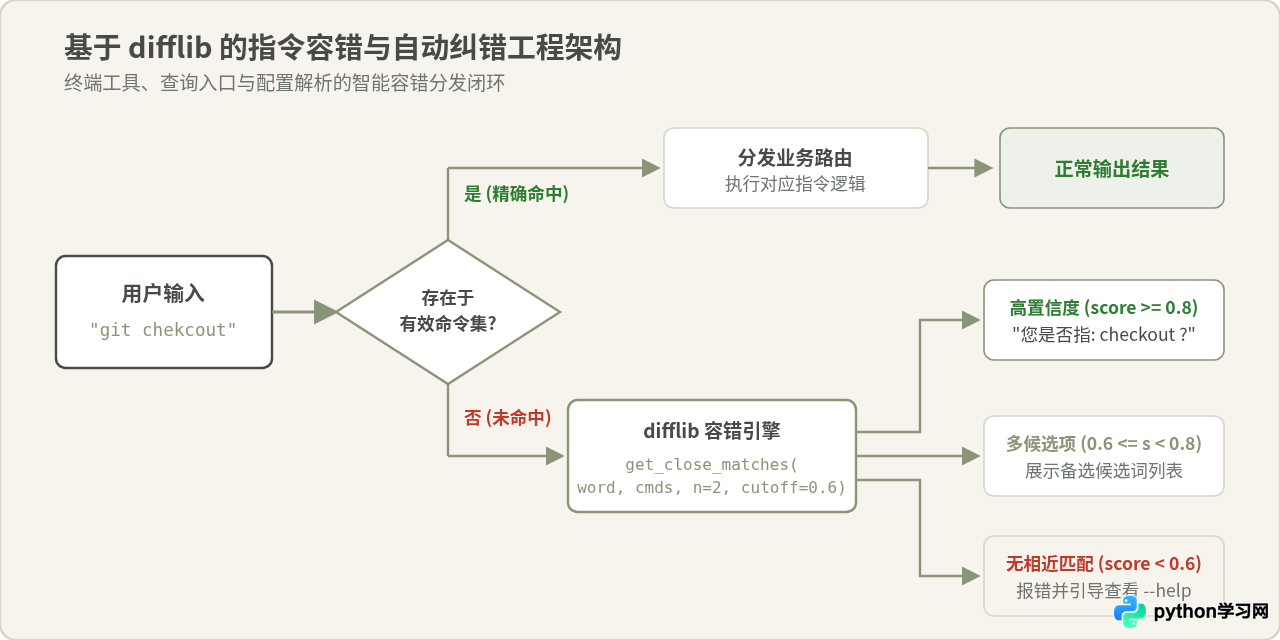
- cutoff:相似度截断阈值,取值范围为 0.0 到 1.0 之间的浮点数,默认值为 0.6。相似度得分低于此阈值的候选词将被直接舍弃。
2. 基础示例:命令行拼写容错
在终端工具开发中,用户经常会产生轻微的按键拼写失误。例如将 checkout 误输入为 chekcout。以下代码演示了如何提取最接近的候选命令:
import difflib

# 合法指令池
commands = ["status", "commit", "checkout", "cherry-pick", "branch", "clone"]

# 用户输错的命令
user_input = "chekcout"

# 获取最接近的合法指令
matches = difflib.get_close_matches(user_input, commands, n=2, cutoff=0.6)

print(f"输入指令: {user_input}")
print(f"匹配结果: {matches}")
运行结果示例:
输入指令: chekcout
匹配结果: ['checkout']
在上述执行过程中,checkout 与 chekcout 的内部比对分值达到 0.93,远高于默认的 0.6 阈值,因此被准确捕获并作为首选结果返回。
3. cutoff 阈值调节的工程权衡
很多人容易将 cutoff=0.6 字面理解为“允许输入错 40% 的字符”,但实际上该阈值代表的是 Gestalt 模式匹配算法的综合相似度评分。阈值的设定直接决定了系统的召回率(Recall)与准确率(Precision):
- 阈值偏高(如 0.8 ~ 0.9):对差异极度敏感。仅在输入与目标只有单字微调或末尾字符缺失时才能命中。优点是结果极准、极少出现无关干扰,缺点是稍有错位就会返回空列表。
- 阈值偏低(如 0.3 ~ 0.4):过度容忍差异。哪怕是较短的不相干词汇,只要碰巧重合几个字母也可能进入推荐列表,容易给用户造成困惑。
- 推荐区间(0.6 ~ 0.7):适合绝大多数日常人机交互与配置容错场景,既能容忍偶发笔误,又能有效阻断噪音。
二、核心度量机制:SequenceMatcher 的原理与计算
get_close_matches 底层完全依赖 difflib.SequenceMatcher 类。若需要对两个具体文本进行精确打分、比较差异幅度或自定义复杂的过滤管线,应当直接操作 SequenceMatcher。
1. 基础评分调用与 ratio() 方法
from difflib import SequenceMatcher

s1 = "apple"
s2 = "apples"
s3 = "apply"
s4 = "banana"

# 计算两串之间的相似度比率
ratio_1_2 = SequenceMatcher(None, s1, s2).ratio()
ratio_1_3 = SequenceMatcher(None, s1, s3).ratio()
ratio_1_4 = SequenceMatcher(None, s1, s4).ratio()

print(f"'{s1}' vs '{s2}': {ratio_1_2:.4f}")
print(f"'{s1}' vs '{s3}': {ratio_1_3:.4f}")
print(f"'{s1}' vs '{s4}': {ratio_1_4:.4f}")
运行结果示例:
'apple' vs 'apples': 0.9091
'apple' vs 'apply': 0.8000
'apple' vs 'banana': 0.1818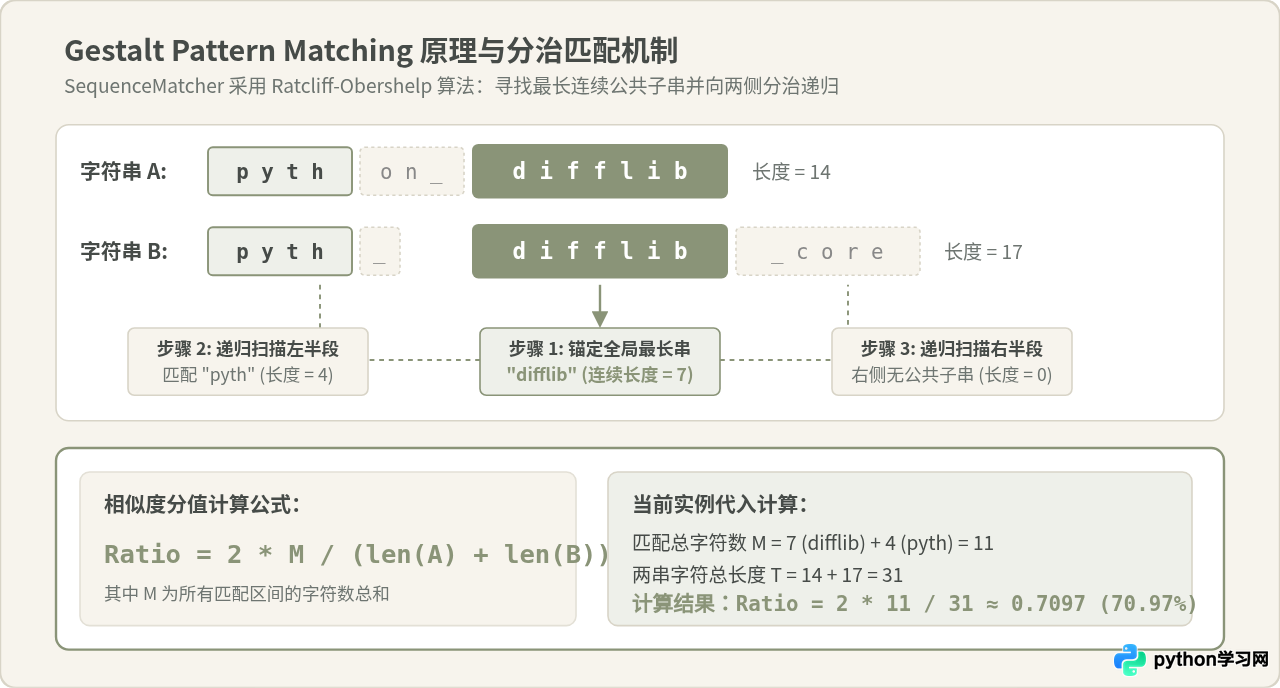
2. Gestalt Pattern Matching 算法与公式推导
SequenceMatcher 采用的是 Ratcliff 与 Obershelp 在 1988 年提出的 Gestalt Pattern Matching(完形模式匹配)算法。其核心思路不是逐字符比对,而是以连续公共子串为锚点进行分治递归:
- 寻找最长公共子序列(LCS):在待比对的序列 $A$ 与序列 $B$ 中,找出一段长度最大的连续相同字符块,将其作为锚点。
- 分治递归比对:以该锚点为界,将序列 $A$ 与 $B$ 分别切分为锚点左侧子串与锚点右侧子串。随后对左侧部分和右侧部分分别递归执行步骤 1,找出次级的最长公共块。
- 累计匹配长度:将各层递归中找到的所有匹配块的字符数累加,得到匹配总字符数 $M$。
- 计算相似度比率:代入标准公式:
Ratio = 2 * M / (len(A) + len(B))
许多初学者常把 difflib.ratio() 误当成基于 Levenshtein 距离(编辑距离)的算法。这种混淆看似合理,因为两者输出的分值都在 0 到 1 之间,且面对常见拼写笔误时给出的相对排序往往一致。
但两者的内在逻辑有本质差异:编辑距离关注的是从字符串 $A$ 变成 $B$ 所需的最少单字符操作步数(插入、删除、替换);而 Gestalt 算法关注的是最长连续公共块。
例如对比 "apple inc" 与 "inc apple"(词序翻转):在编辑距离视角下,这需要连续删除并在另一端插入整个单词,操作步数极多,折算后的相似度通常跌至 0.3 左右;但在 difflib 视角下,算法能分别完整识别出 "apple"(5 字符)和 "inc"(3 字符)两个完整块,总匹配字符达 8,最终得分在 0.8 以上。因此,面对调换词序或长块重排时,difflib 具有天然的亲和度。
三、进阶控制:噪声过滤与精准匹配块定位
在实际工程应用中,原始文本往往包含干扰字符(如多余空格、换行符或特殊标点),或者需要了解两串文字具体是在哪个位置重合。SequenceMatcher 提供了专门的接口用于处理这些细节。
1. 使用 isjunk 参数过滤干扰字符
初始化 SequenceMatcher 时,可以通过 isjunk 参数传入一个判断函数。当算法扫描连续块时,被标记为 junk 的字符将不会被选为最长匹配块的起点:
from difflib import SequenceMatcher

text_a = "hello world"
text_b = "hello   world"

# 默认情况下比对(空格计入匹配块判断)
matcher_default = SequenceMatcher(None, text_a, text_b)

# 显式忽略空格字符
matcher_ignore_space = SequenceMatcher(lambda x: x == " ", text_a, text_b)

print(f"默认比对分值: {matcher_default.ratio():.4f}")
print(f"忽略空格分值: {matcher_ignore_space.ratio():.4f}")
需要特别注意:isjunk 仅作用于“寻找最长连续公共块”的探索阶段。在最后执行 Ratio = 2*M / (len(A)+len(B)) 计算时,原字符串中包含的空格依然会计入分母总长度。因此,若业务要求彻底无视空格或特定标点,应在比对前对字符串执行预处理切除(如 s.replace(" ", ""))。
2. autojunk 参数的潜在陷阱
在 Python 中,SequenceMatcher 的构造函数默认包含参数 autojunk=True。当序列长度大于等于 200 且某个字符在序列中出现的频率超过 1% 时,算法会自动将该字符列为垃圾噪音。
这一机制设计的初衷是为了避免在比对包含大量重复字符(如多行缩进空格、常见 HTML 标签符号)的长文档时长久卡顿。然而,如果在对长文本或特定结构化数据进行比对时发现某些明明相同的字符段被诡异忽略,应当显式声明 autojunk=False 关闭该自动优化。
3. 定位具体匹配区间:get_matching_blocks()
若需要高亮显示两个文本相同的部分,或者需要提取公共片段在各自字符串中的起始下标,可调用 get_matching_blocks() 方法:
from difflib import SequenceMatcher

a = "difflib_fuzzy_match"
b = "python_difflib_matching"

matcher = SequenceMatcher(None, a, b)
blocks = matcher.get_matching_blocks()

for block in blocks:
    if block.size > 0:
        matched_str = a[block.a : block.a + block.size]
        print(f"匹配片段: '{matched_str}' | A位置: {block.a}..{block.a + block.size} | B位置: {block.b}..{block.b + block.size} | 长度: {block.size}")
运行结果示例:
匹配片段: 'difflib_' | A位置: 0..8 | B位置: 7..15 | 长度: 8
匹配片段: 'match' | A位置: 14..19 | B位置: 15..20 | 长度: 5
返回结果由 Match(a, b, size) 命名元组组成,末尾会附加一个 size=0 的哨兵元素代表结束。这为开发文本高亮比对插件或重构分析提供了底层数据支撑。
四、适用边界与性能考量
标准库 difflib 的最大优势在于开箱即用、跨平台且无需引入第三方依赖。但在生产系统架构中,必须清晰认识其计算模型的时间复杂度边界。
1. 复杂度与性能瓶颈
Gestalt 算法在最坏情况下的时间复杂度为 $O(N^3)$,在典型文本情况下的平均复杂度接近 $O(N^2)$。当字符串长度超过数千字符,或者候选列表 possibilities 达到万级以上时,纯 Python 实现的循环比对会导致显著的 CPU 耗时与延迟。
虽然 get_close_matches 内部先通过 real_quick_ratio() 与 quick_ratio() 快速计算理论上界以过滤大部分候选词,但在大规模词库面前,这种纯内存线性扫描依然难以满足毫秒级的实时响应需求。
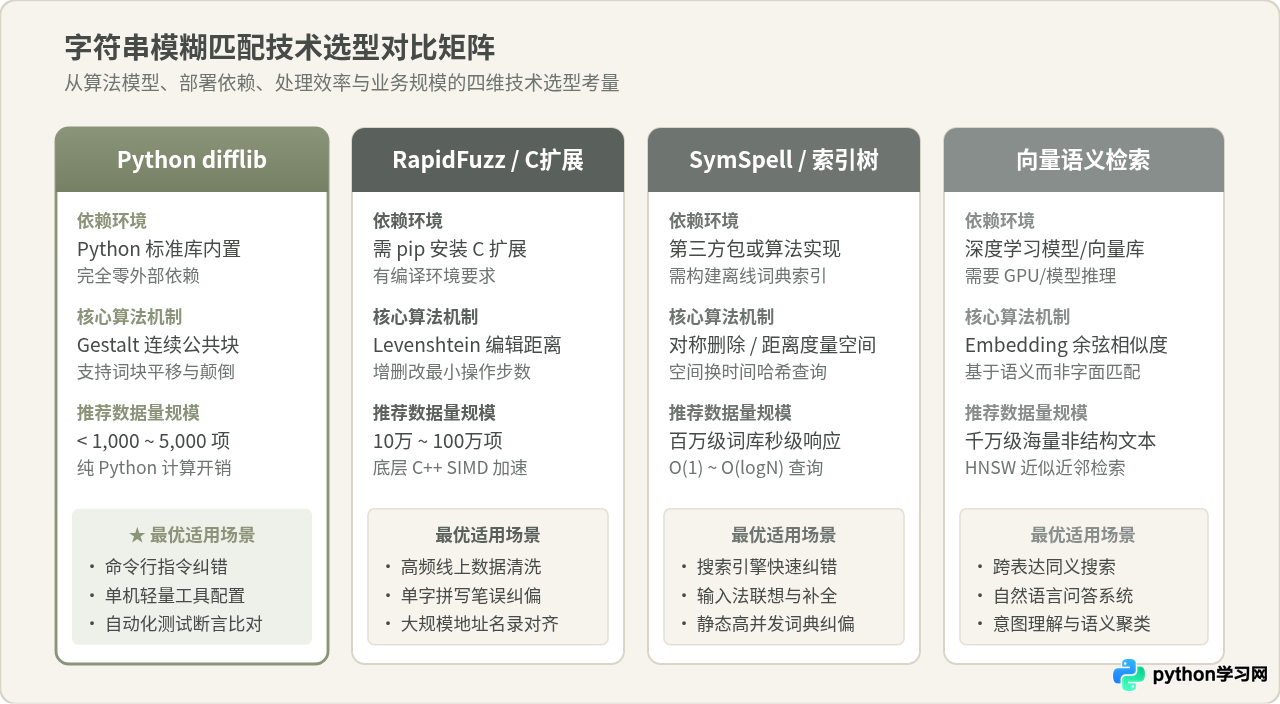
2. 技术选型决策指南
| 技术方案 | 依赖状态 | 算法机制 | 推荐规模 | 核心适用场景 |
|---|---|---|---|---|
| Python difflib | 标准库内置 | Gestalt 连续公共子串 | < 5,000 项 | CLI指令纠错、单机配置容错、测试断言 |
| RapidFuzz / Levenshtein | 需 pip 安装 | 编辑距离 (C++ SIMD加速) | 10万 ~ 百万级 | 高并发数据清洗、单字拼写笔误纠偏 |
| SymSpell / BK-Tree | 第三方包/自定义 | 对称删除索引 / 度量空间 | 百万级词典 | 搜索引擎实时纠错、输入法词条推荐 |
| Vector Embedding | 模型推理/向量库 | 高维稠密向量余弦相似度 | 千万级语义库 | 跨语义同义检索、意图理解与问答系统 |
五、工程实践总结
在实际 Python 开发中,采用 difflib 进行模糊匹配建议遵循以下工程原则:
- 快速检索首选 get_close_matches:常规的关键词匹配无需手动实例化
SequenceMatcher,使用封装好的高层函数可利用内置剪枝与堆排序大幅精简业务代码。 - 阈值合理配置:默认的
cutoff=0.6是大量交互场景的经验折中值。若业务容错要求较松可调低至 0.5,若要求极度严格建议调高至 0.75。 - 长文本比对注意 autojunk:当比对文本超过 200 字符且具有特定模式时,务必注意默认开启的
autojunk是否对公共字符产生了误杀。 - 明晰规模边界:对于千级以内的交互字典,
difflib是最佳的轻量化选择;当面对超大词典或海量高并发请求时,应及时迁移至带索引的专用搜索方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















