


Python字符串截取方法对比:切片、split与正则表达式适用场景
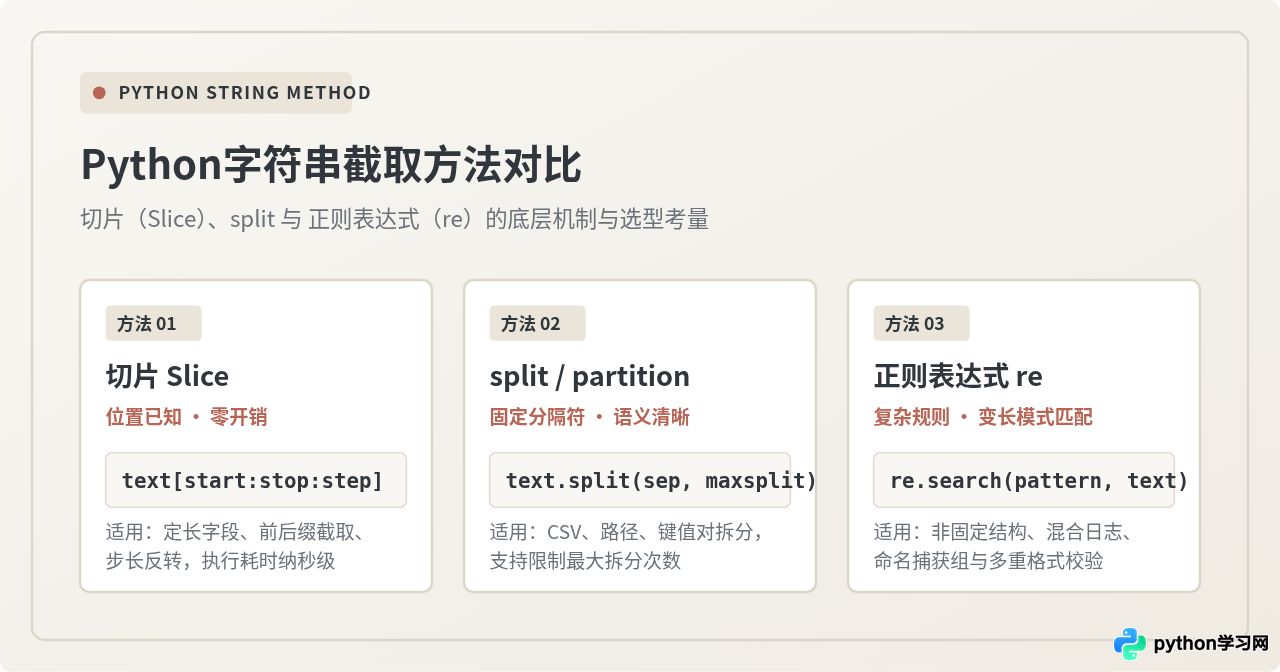
深入对比 Python 字符串截取的三大核心方案:切片(Slice)、split 与正则表达式(re 模块)。从语法机制、底层性能到边界容错与选型决策,结合完整可运行的代码示例与系统原理图,指导你在不同场景下选择最优雅高效的截取方式。
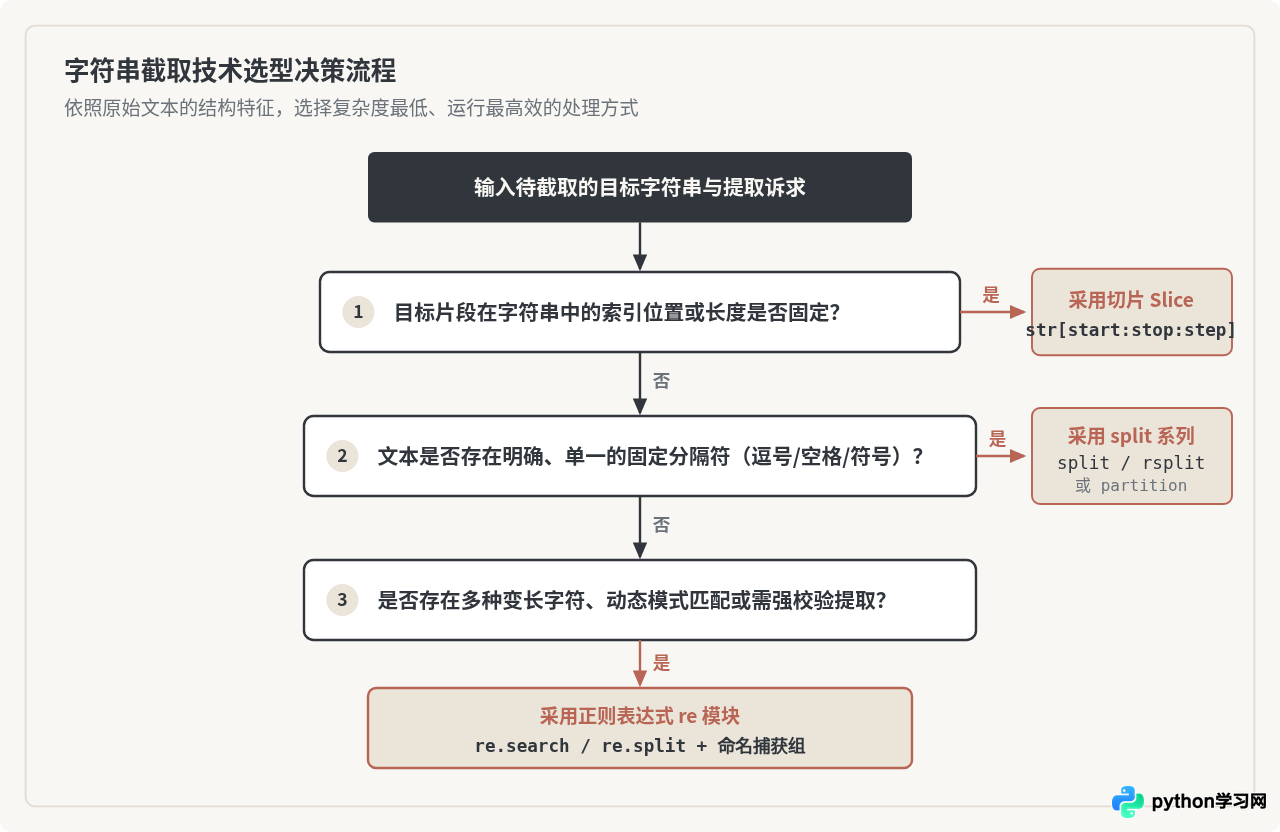
一、选型第一准则:基于数据结构特征决定处理路径
很多开发者在面对字符串截取需求时,容易陷入“无论什么场景都先写个正则表达式”或“为了简便连续写多个 split 链式调用”的误区。实际上,Python 字符串在底层是连续的只读字符内存对象,不同的截取方式其内部开销和可维护性差异极大。
选择截取方案的核心依据并不在于“功能多强”,而在于原始文本特征与预期输出结构是否匹配:
- 定长或定位置数据:如身份证前6位、固定前缀代码、日期前4位。这类场景无需扫描字符内容,切片可以在纳秒级直接完成内存指针偏移。
- 具有明确分隔符的数据:如 CSV 文件逗号、URL 路径斜杠、配置文件的等号。这类场景使用
split()或partition()能以最直接的语义表达拆分意图。 - 模式变长与复杂规则校验:如混杂无规则空白的服务器日志、非结构化文本中的邮箱提取、多重格式的手机号匹配。此时必须依赖
re模块的有限状态自动机进行模式匹配。
二、切片(Slicing):位置已知时的极致性能首选
切片是 Python 语言最核心的语法特性之一。当目标字段在字符串中的起始位置、结束位置或间隔步长已知时,切片是性能最高且语义最紧凑的选择。
1. 语法形式与正负索引机制
切片的基础语法为 str[start:stop:step],其核心规则遵循左闭右开区间(即包含 start 对应的字符,但不包含 stop 对应的字符)。若省略参数,start 默认为 0,stop 默认为字符串末尾,step 默认为 1。
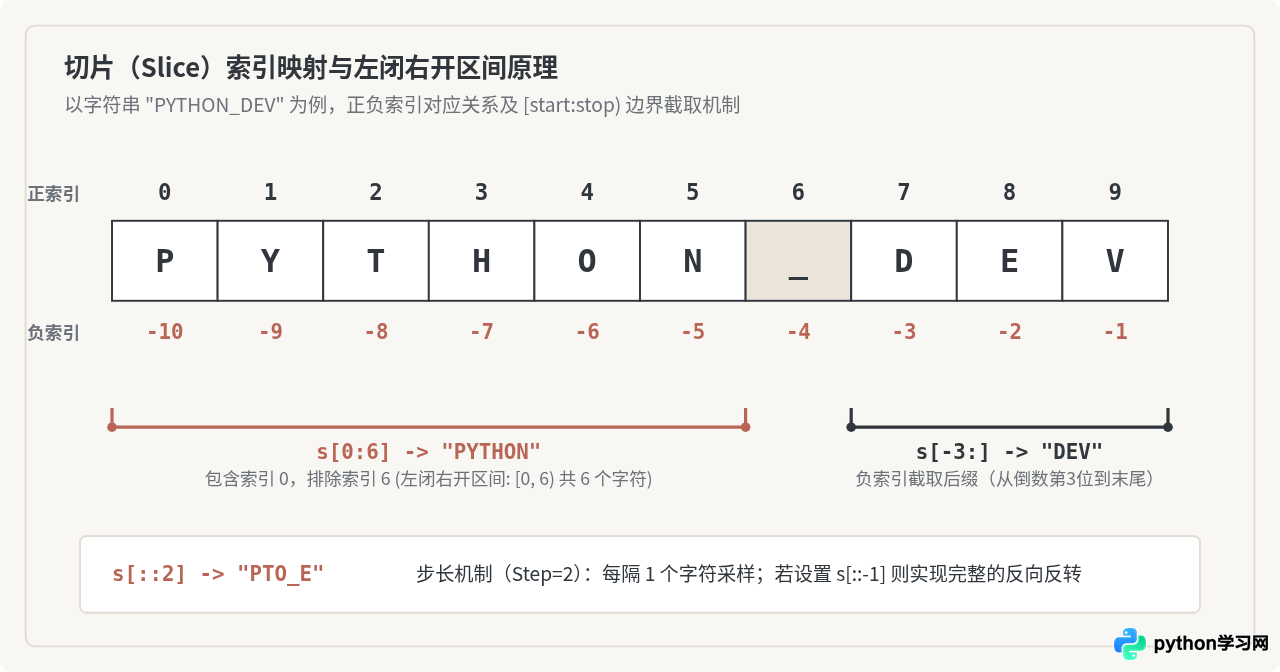
在 Python 中,每个字符同时拥有非负索引(从 0 开始向右递增)与负数索引(从 -1 开始向左递减)。利用负数索引,可以无需计算 len() 即可直接截取末尾片段:
# 示例:利用切片完成固定位置截取
raw_code = "ORDER_20261031_CN_9842"

# 1. 截取固定前缀(前5个字符)
prefix = raw_code[0:5]

# 2. 截取中间日期部分(索引 6 到 14)
date_part = raw_code[6:14]

# 3. 使用负索引截取末尾 4 位订单尾号
tail_id = raw_code[-4:]

# 4. 利用步长进行反转
reversed_tail = tail_id[::-1]

print("前缀:", prefix)
print("日期:", date_part)
print("尾号:", tail_id)
print("反转尾号:", reversed_tail)
日期: 20261031
尾号: 9842
反转尾号: 2489
2. 切片的边界安全性与底层开销
许多初学者容易混淆单字符索引访问与切片访问的区别:在 Python 中,单字符索引(如 text[99])若超出字符串长度会抛出 IndexError;但切片操作(如 text[99:120])是越界容错的。如果切片范围超出实际字符串长度,Python 会静默截断为实际可用的边界,完全不会引发异常:
text = "PYTHON"

# 索引越界会报错:text[10] -> IndexError: string index out of range
# 但切片越界安全返回:
part1 = text[2:100]   # 自动截断到末尾,返回 "THON"
part2 = text[50:100]  # 超出起始位置,安全返回空字符串 ""

print(repr(part1), repr(part2))
Python 字符串(PyUnicodeObject)切片是由 CPython 内置的 C 循环直接完成内存复制。因为不涉及模式编译、语法状态机或任何字符串内部遍历匹配,切片单次耗时通常仅为 30 到 50 纳秒,是所有截取手段中执行最快的。
三、split 与 partition:基于固定标识的高效拆解
当文本各字段长度不固定,但存在稳定出现的字符(如逗号、空格、下划线、斜杠)作为边界时,str.split()、str.rsplit() 与 str.partition() 是最符合 Pythonic 风格的解决方案。
1. str.split() 的关键参数细节
str.split(sep=None, maxsplit=-1) 包含两个至关重要的参数:
- sep 参数的行为差异:若显式传入
sep=' ',Python 仅按单个空格拆分;若保持默认sep=None,Python 会将任意连续的空白字符(包括空格、制表符 - maxsplit 限制拆分次数:当只需要前 N 个字段或最后 1 个字段时,合理使用
maxsplit能有效避免无谓的全量列表分配。
# 1. 默认 sep=None 自动合并多余空白
raw_text = "  data_pipeline    worker_01    RUNNING  "
fields = raw_text.split()  # 忽略前后空格,合并中间多余空白

# 2. 限制最大拆分次数 maxsplit
log_entry = "2026-10-31 11:00:00|WARN|Database connection timeout on replica 2"
date_part, time_part, level, message = log_entry.replace("|", " ").split(" ", 3)

# 3. 从右向左拆分 rsplit(例如提取文件拓展名)
filename = "archive.backup.tar.gz"
base_name, extension = filename.rsplit(".", 1)

print("多余空白自动处理:", fields)
print("提取消息主体:", message)
print("文件后缀:", extension)
提取消息主体: Database connection timeout on replica 2
文件后缀: gz
2. str.partition() 的独特优势
当只需要将字符串分为“前段、分隔符、后段”三部分(例如解析 key=value 或 host:port)时,str.partition(sep) 往往比 split() 更安全、更快:
partition()始终返回一个严格包含 3 个元素的元组:(head, sep, tail)。- 即使分隔符不存在,它也不会报错,而是返回
(original_str, '', ''),极大减轻了后续解包时的数组越界风险。
configs = ["timeout=30", "debug_mode=True", "no_equal_sign"]

for item in configs:
    key, sep, val = item.partition("=")
    if sep:
        print(f"配置键: {key} -> 值: {val}")
    else:
        print(f"无效键值项: {key}")
配置键: debug_mode -> 值: True
无效键值项: no_equal_sign
四、正则表达式(re 模块):变长模式与复杂校验的利器
当待截取的字符串不具备固定字符位置,也不具备单一确定的分隔符,甚至需要同时完成格式有效性验证时,标准库的 re 模块是无可替代的工具。
1. 正则捕获组与命名捕获组的结构化提取
正则表达式不仅能匹配文本,更通过圆括号 () 定义“捕获组”,或者使用 (?P<name>...) 定义“命名捕获组”。这使得截取不仅具备容错性,还能直接将截取结果转化为具备明确语义的字典数据。
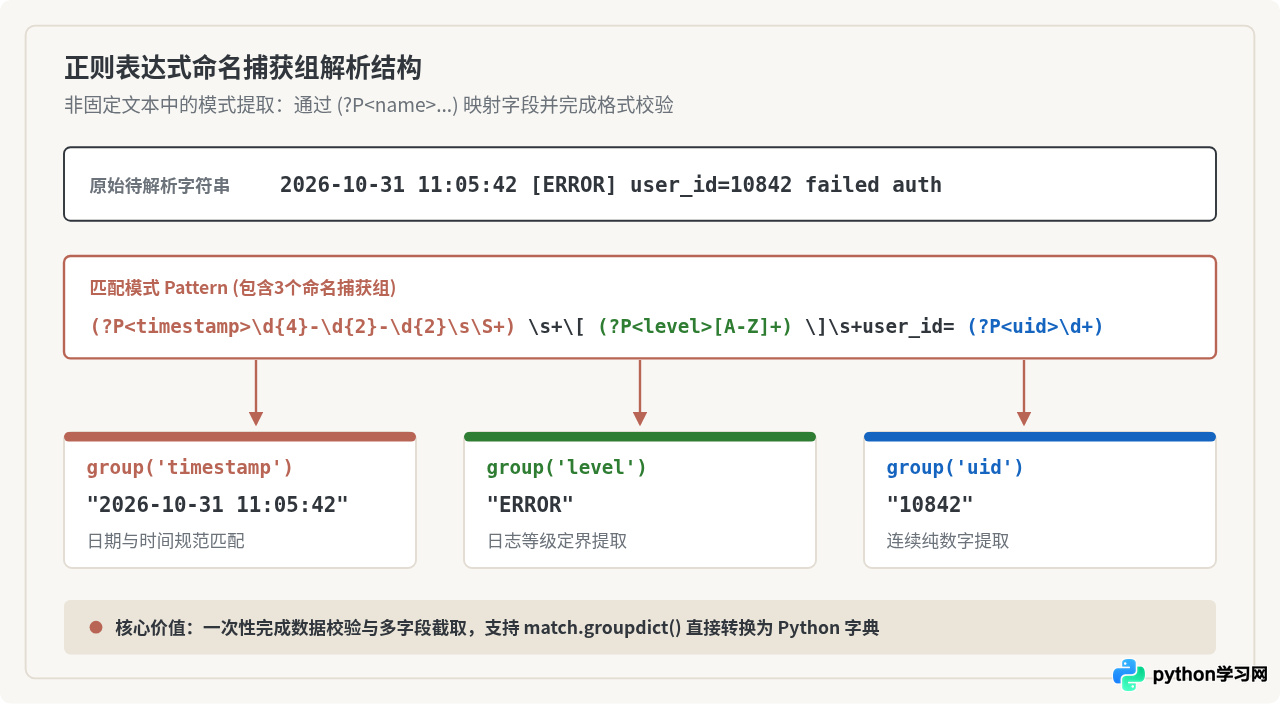
import re

# 示例:解析复杂格式日志
log_line = '2026-10-31 11:05:42 [ERROR] user_id=10842 failed auth'

# 定义包含命名捕获组的模式
pattern = re.compile(
    r'(?P<timestamp>\d{4}-\d{2}-\d{2}\s\S+)\s+'
    r'\[(?P<level>[A-Z]+)\]\s+'
    r'user_id=(?P<uid>\d+)'
)

match = pattern.search(log_line)

if match:
    # 1. 依名称截取单独字段
    timestamp = match.group("timestamp")
    level = match.group("level")
    uid = match.group("uid")
    print(f"提取字段: 时间={timestamp}, 级别={level}, 用户={uid}")

    # 2. 一次性导出为字典
    print("字典对象:", match.groupdict())
else:
    print("未匹配到合法日志格式")
字典对象: {'timestamp': '2026-10-31 11:05:42', 'level': 'ERROR', 'uid': '10842'}
2. 使用 re.split() 处理多重不规则分隔符
常规的 str.split() 只能接受单一固定的字符串作为分隔符。如果文本中同时混杂分号、冒号、逗号以及若干空格,使用 re.split() 可以一次性完成清理与拆分:
import re

# 包含分号、逗号、冒号及不定量空格的不规范字符串
messy_data = "apple, banana;  orange:grape ; melon"

# 匹配 [逗号/分号/冒号] 以及其后跟随的零个或多个空格
clean_items = re.split(r'[,;:]\s*', messy_data)

print("多重分隔符清洗结果:", clean_items)
与切片的安全截断不同,re.search() 在未能匹配成功时返回 None。如果未做有效性检查直接调用 match.group(1),程序将立即抛出 AttributeError: 'NoneType' object has no attribute 'group'。因此,在生产环境中涉及正则表达式截取时,必须先进行 if match: 判定,或使用海象运算符 if (match := pattern.search(text)):。
五、多维度横向对比与选型决策矩阵
为了在工程架构与日常脚本中做出合理的权衡,下表从执行性能、模式灵活性、代码维护成本与异常风险四个维度对三类方法进行对比总结:
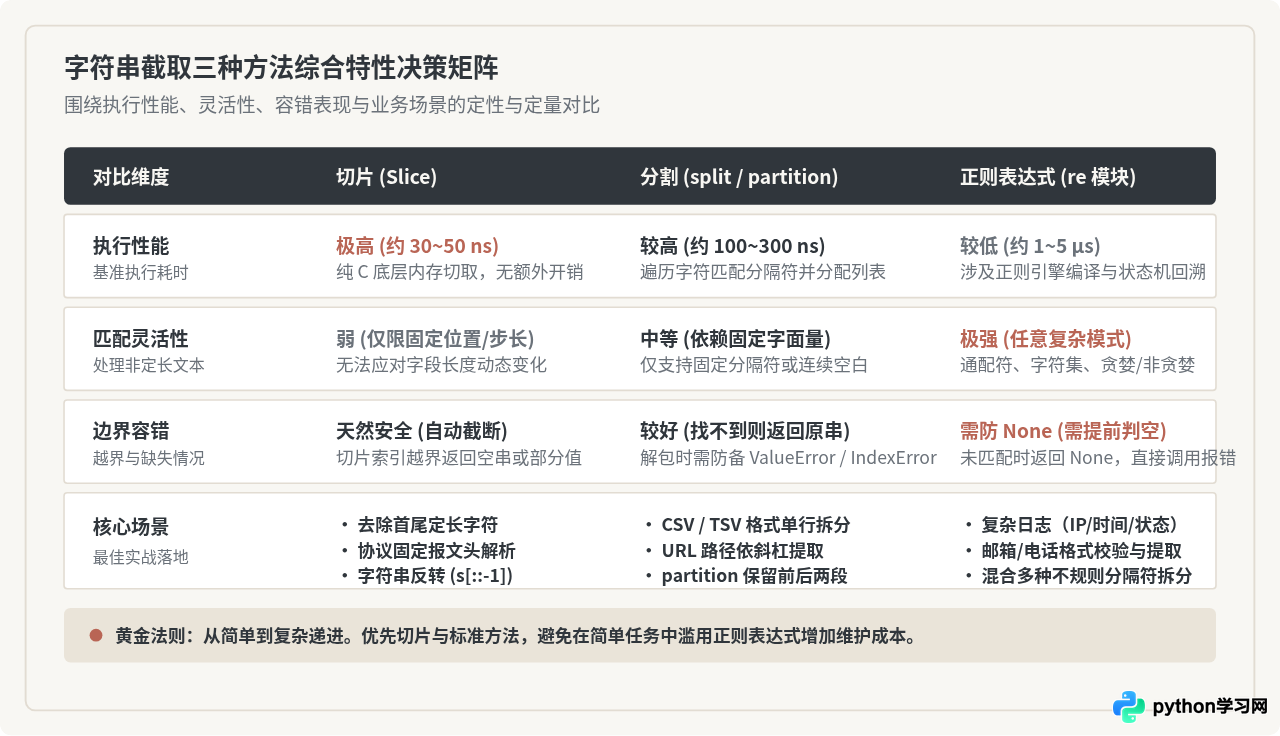
| 评估指标 | 切片(Slice) | 分割(split / partition) | 正则表达式(re 模块) |
|---|---|---|---|
| 耗时量级 | 30 ~ 50 纳秒(极致) | 100 ~ 400 纳秒(极快) | 1 ~ 5 微秒(较重,受回溯影响) |
| 内存开销 | 仅构造新字符串对象,零额外容器 | 构造中间列表(partition 为三元组) | 构造 Match 状态对象与捕获元组 |
| 定位依据 | 字符偏移量(Offset / Index) | 字面量分隔字符(Delimiter) | 抽象元字符与规则模式(Pattern) |
| 容错机制 | 索引越界自动截断,不报错 | 找不到分隔符返回原串,需防解包越界 | 匹配失败返回 None,必须防范 AttributeError |
| 可读性与维护 | 简洁直观,但位置写死(Magic Number) | 极佳,符合日常直觉 | 较晦涩,复杂模式需配合文档与注释维护 |
常见业务场景速查表
- 场景 1:提取固定格式文件名前缀或版本尾号
推荐使用切片(如text[:10]或text[-4:])。在固定协议头、定长流水号解析中,切片兼具最高性能与极简代码。 - 场景 2:解析 URL 路径、标准 CSV 行、简单键值对
推荐使用split()或partition()。如果只需要第一项或最后一项,务必搭配maxsplit=1或rsplit(..., 1)。 - 场景 3:提取字符串中的所有数字、邮箱、IP 地址或非结构化日志
推荐使用正则表达式。利用re.findall()或预编译的re.compile()配合命名捕获组,一次性完成验证与提取。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















