


Python3使用正则表达式提取字符串中的中文内容

发布时间:2026-10-13 |
4人浏览过
本文介绍如何在Python3中利用正则表达式从混合字符串中精准提取中文字符。通过定义包含Unicode范围的匹配模式,并结合re模块的findall方法,实现过滤非中文内容并返回结果数组的功能。
具体实现代码如下所示:
# -*- coding: utf-8 -*-
import re
#过滤掉除了中文以外的字符
str = "hello,world!!%[545]你好234世界。。。"
str = re.sub("[A-Za-z0-9\!\%\[\]\,\。]", "", str)
print(str)

#提取字符串里的中文,返回数组
pattern="[\u4e00-\u9fa5]+"
regex = re.compile(pattern)
results = regex.findall("adf中文adf发京东方")
print(results)
执行上述代码后的打印结果如下:
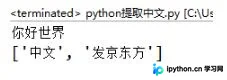
以上就是本文关于Python3利用正则表达式提取字符串中中文内容的完整分享。希望上述内容能为读者提供有效的参考,同时也欢迎大家继续支持本站以获取更多技术资讯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















