


Python输入输出内置函数:input、print与open的基础应用与注意事项
系统讲解Python标准输入输出与文件操作内置函数input、print与open的语法细节、参数机制、类型转换、缓冲刷新及生产避坑指南。
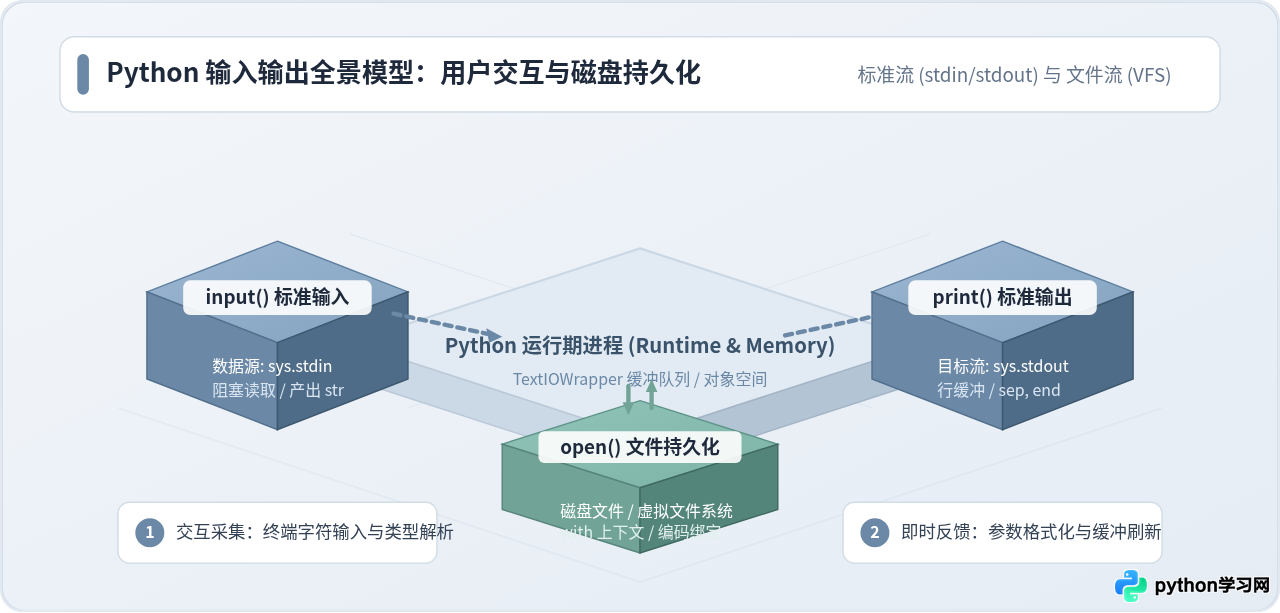
input() 负责接纳来自控制台终端的用户击键并转化为字符串;print() 负责把运行期数据以格式化文本形式推送到标准输出流;而 open() 则负责打开与磁盘持久化介质的通道。本文紧扣这三个内置函数的标准语法、参数控制、底层缓冲与类型转换逻辑,给出具体用法、代码示例与工程开发中的注意事项。
一、print() 函数:标准输出的格式化与流控制
print() 是 Python 中使用频率最高的输出函数。它的职责是将一个或多个对象转换成字符串,并写入指定的文本流(默认为控制台终端 sys.stdout)。理解它的基础应用不仅在于输出一行文字,更在于灵活运用其内置的可选命名参数。
1. 完整函数签名与参数定义
print(*objects, sep=' ', end='\n', file=None, flush=False)
*objects:位置参数,表示要打印的一个或多个对象。如果传入多个对象,print()会依次调用每个对象的str()方法将其转为字符串。sep:字符串,表示多个对象之间的分隔符,默认为单个空格' '。end:字符串,表示全部对象输出完毕后追加的结尾字符,默认为换行符'\n'。file:流对象,指定输出的目标载体,必须是拥有write(string)方法的对象,默认为sys.stdout。flush:布尔值,是否强制刷新流缓冲区,默认为False。
2. 核心应用场景与代码演示
在实际编写脚本时,可以通过调整 sep 和 end 避免冗余的字符串拼接,并利用 flush 控制命令行交互体验:
# 1. 调整分隔符 sep
print("2026", "10", "31", sep="-")
print("usr", "local", "bin", sep="/")

# 2. 控制末尾字符 end(实现同行连续输出)
for i in range(1, 4):
    print(f"步骤 {i}", end=" -> ")
print("完成")

# 3. 实时刷新 flush(常用于进度条或等待提示)
import time
print("正在校验凭证...", end="", flush=True)
time.sleep(0.5)
print(" 通过!")
usr/local/bin
步骤 1 -> 步骤 2 -> 步骤 3 -> 完成
正在校验凭证... 通过!
3. print() 的重要注意事项与易错点
print() 会造成严重的 I/O 阻塞。处理大量数据时,应优先采用批量聚合、日志抽样或格式化缓冲写入。
print() 会自动调用对象的 __str__() 方法。若需要查看精确的数据类型、转义字符或调试结构(例如区分空字符串 "" 与包含空格的字符串 " "),应显式使用 print(repr(obj)) 或 f-string 调试语法 print(f"{obj=}")。
print(..., file=f),必须确保文件对象 f 处于打开且可写状态。若在 with 语句块外部继续向 f 打印,将直接抛出 ValueError: I/O operation on closed file.。
二、input() 函数:控制台交互与类型安全防御
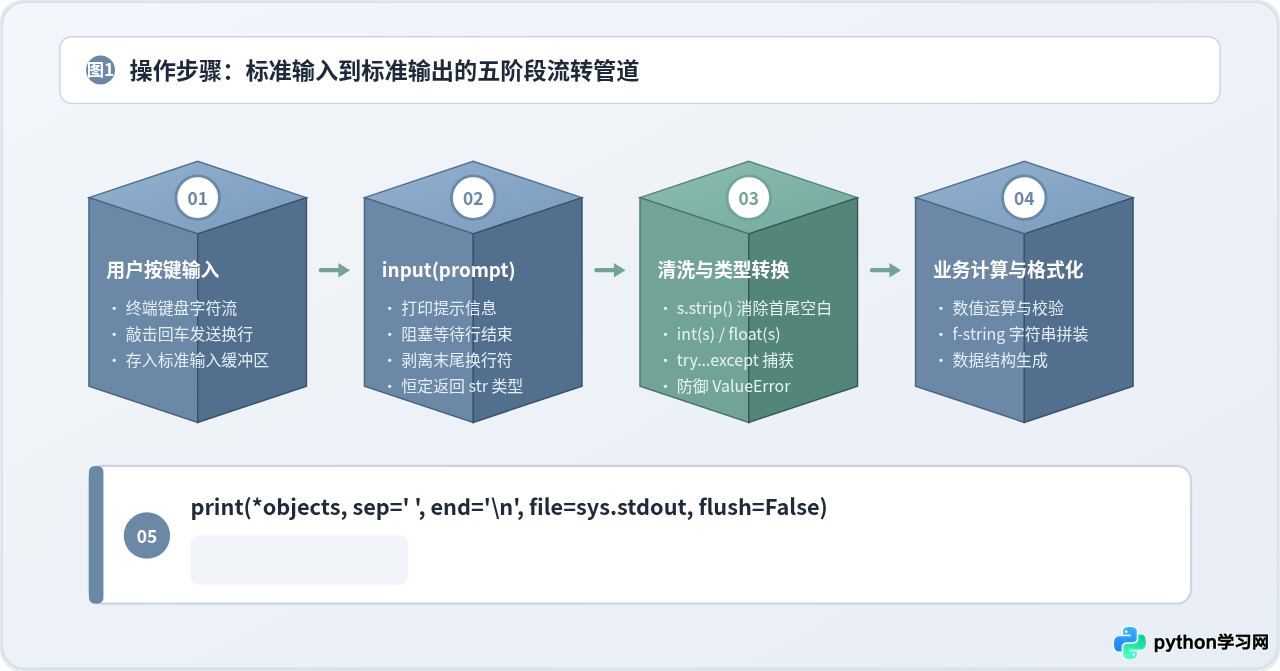
input() 是实现终端命令行人机交互的标准方式。它会在标准输出流打印提示信息,挂起程序执行并等待用户在键盘输入一整行文本,直到检测到回车换行符。
1. 核心运行机制
无论用户在键盘上输入的是数字、字母、符号还是留空,input() 返回的数据类型永远是字符串(str),并且会自动剥离最后的换行符
。
2. 类型转换与输入清洗模式
正因为 input() 仅产出字符串,若不进行类型显式转换,在后续逻辑中极易引发逻辑错误或隐蔽 Bug:
- 加法运算陷阱:
a = input(); b = input(); print(a + b)输入10和20时,输出不是30而是字符串拼接1020。 - 布尔转换陷阱:输入
0或False时,bool(input())的结果依然是True,因为任何非空字符串转换成布尔值都为真。
def get_user_age():
    while True:
        raw_val = input("请输入您的年龄: ").strip()  # 1. 消除前导与末尾多余空白
        if not raw_val:
            print("输入不能为空,请重新输入。")
            continue
        try:
            age = int(raw_val)                     # 2. 显式类型转换
            if 0 <= age <= 120:
                return age
            print("年龄数值超出合理范围(0-120),请重新输入。")
        except ValueError:                         # 3. 捕获非法字符转换异常
            print(f"无效输入 '{raw_val}',年龄必须由纯数字组成!")

# 单行录入多个数值的标准写法
# 假设用户输入:10 20 30
nums_input = "10 20 30"  # 模拟 input("请输入三个整数并用空格分隔: ")
a, b, c = map(int, nums_input.split())
print(f"解析成功: a={a}, b={b}, c={c}, 总和={a + b + c}")
3. input() 的关键注意事项
python script.py < empty.txt)运行时,如果读到了输入流的末尾而没有任何后续数据,input() 会直接抛出 EOFError: EOF when reading a line。编写通用脚本时需结合 try...except EOFError 或改用命令行参数(如 argparse / sys.argv)。
input() 会在控制台上直接回显用户按键。在涉及密码、访问令牌等敏感凭据录入时,应改用标准库 getpass.getpass("请输入密码: "),避免凭据在屏幕上暴露。
三、open() 函数:文件持久化与资源安全管理
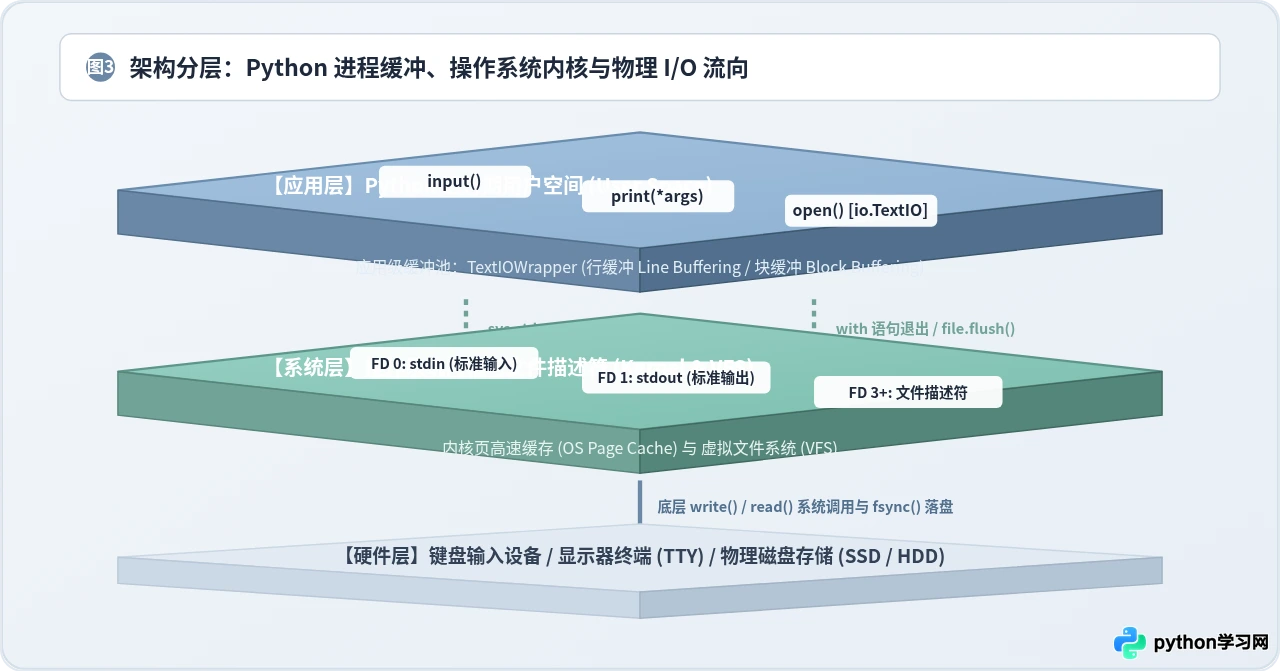
程序内存中的变量随进程终止而消亡,而持久化数据必须写入外存文件。open() 函数正是操作系统与 Python 文件对象(io.TextIOWrapper 或 io.FileIO)之间建立文件描述符连接的桥梁。
1. 完整函数签名与常用参数
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None)
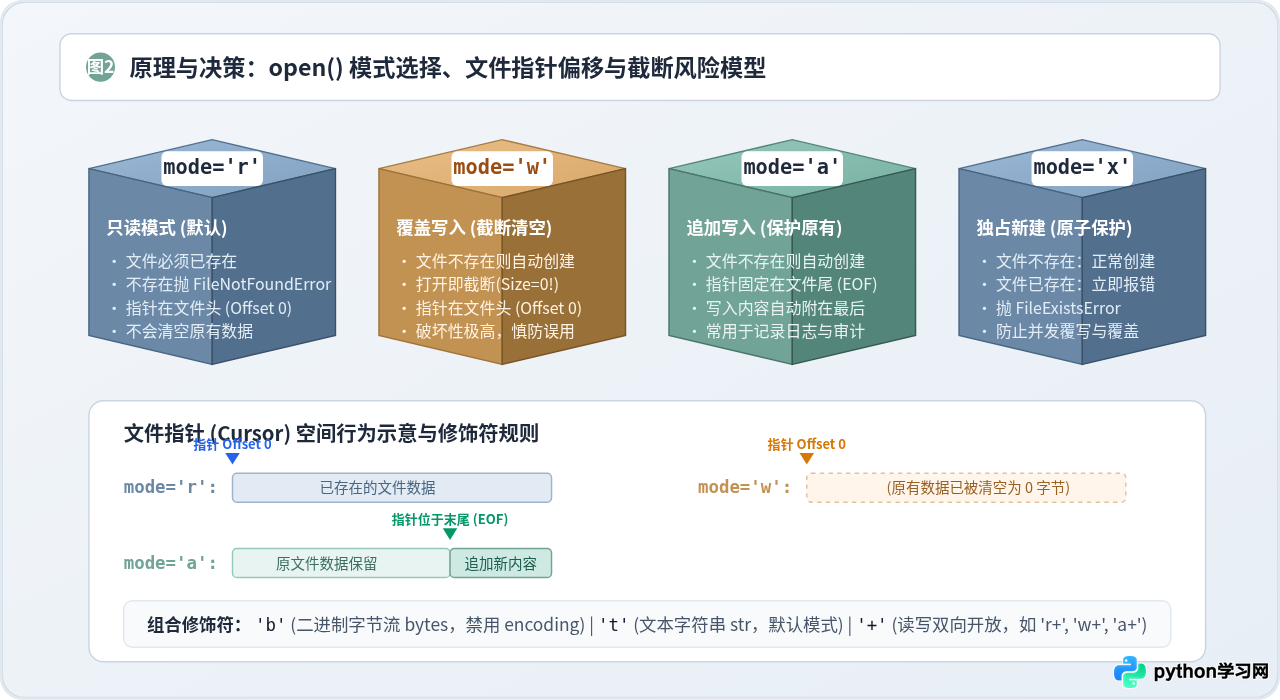
file:文件路径(字符串或pathlib.Path对象)。mode:打开模式,决定了读写权限、指针位置及是否截断文件。encoding:文本模式下的字符编码集。在中文环境下强烈建议始终显式传入encoding='utf-8'。errors:编码解码异常处理策略(如'strict'、'ignore'、'replace')。newline:换行符转换控制(None会启用通用换行模式,自动将\r\n转换为\n)。
2. 打开模式(mode)详细行为对比
| 模式字符 | 权限行为 | 文件不存在时的处理 | 文件已存在时的行为 | 初始指针偏移 |
|---|---|---|---|---|
'r' |
只读(默认模式) | 抛出 FileNotFoundError |
正常打开读取 | 文件开头(Offset 0) |
'w' |
只写 | 自动创建新文件 | 立即截断清空(Size 降为 0) | 文件开头(Offset 0) |
'a' |
追加写入 | 自动创建新文件 | 保留原有内容,写操作强制置于末尾 | 文件结尾(EOF) |
'x' |
独占新建写入 | 创建新文件并写入 | 抛出 FileExistsError |
文件开头(Offset 0) |
'+' |
读写双向开放(修饰符) | 依主模式(r/w/a)而定 | 依主模式(r/w/a)而定 | 依主模式(r/w/a)而定 |
'b' |
二进制模式(修饰符) | 操作原始 bytes 数据,此时不得传入 encoding 参数 |
保持原始字节流 | 依主模式而定 |
3. 上下文管理器 with 语句的必要性
早期代码常出现 f = open(...) 并在最后调用 f.close()。这种做法存在致命隐患:一旦中间发生异常,f.close() 将被跳过,导致操作系统文件描述符(File Descriptor)泄露,且部分留在缓冲区的数据可能无法落盘。
因此,Python 官方与工业界统一推行上下文管理器模式(with open(...) as f:)。无论块内正常返回还是发生致命未捕获异常,Python 的垃圾回收与运行时都能保证自动调用 f.__exit__() 确定性关闭文件。
import os

file_path = "app_metric.log"

# 1. 安全写入数据(显式声明 UTF-8 编码)
with open(file_path, mode="w", encoding="utf-8") as f:
    f.write("timestamp,metric,value\n")
    f.write("2026-10-31 12:00:00,cpu_load,42.5\n")
    f.write("2026-10-31 12:01:00,cpu_load,45.1\n")

# 2. 内存友好的流式读取(直接迭代文件对象,严禁无限制使用 read())
with open(file_path, mode="r", encoding="utf-8") as f:
    header = f.readline().strip()
    print(f"表头解析: {header}")
    for line_idx, line in enumerate(f, start=1):
        print(f"数据行 {line_idx}: {line.strip()}")

# 3. 追加写入日志
with open(file_path, mode="a", encoding="utf-8") as f:
    f.write("2026-10-31 12:02:00,cpu_load,39.8\n")
数据行 1: 2026-10-31 12:00:00,cpu_load,42.5
数据行 2: 2026-10-31 12:01:00,cpu_load,45.1
4. open() 的核心注意事项与陷阱
encoding 参数,Python 会使用平台默认编码(通过 locale.getpreferredencoding() 获取)。在 Linux/macOS 上默认通常为 utf-8,而在中文 Windows 系统上默认往往是 cp936(GBK)。这会导致同一份包含中文的代码在开发机正常运行,部署到 Windows 生产机后立刻抛出 UnicodeDecodeError: 'gbk' codec can't decode byte...。因此,凡处理文本文件,必须显式指明 encoding="utf-8"。
f.read() 和 f.readlines() 会将整个文件内容一次性加载至内存。处理几百兆或数吉字节的日志文件时,会直接占满可用内存导致系统崩溃。正确做法是利用文件迭代器 for line in f: 进行行流式处理,每次内存中仅保留当前单行数据。
f.writelines(list_of_strings) 只会按原样写入列表中的各个元素,不会自动插入 \n。如果列表中的字符串末尾没有自带换行符,写入文件后所有数据会挤在同一行。如需换行,应通过生成器表达式补充:f.writelines(f"{item}\n" for item in data)。
四、协同应用:三函数联动实战工作流
在实际生产工具开发中,input、print 与 open 常常组合构成一条完整的命令行工作流:由 input 交互采集并清洗用户数据,经业务验证后通过 open 安全持久化至外部存储,最后通过 print 向用户呈现结构化反馈与审计结果。
import sys
from datetime import datetime

CONFIG_FILE = "system_profile.txt"
AUDIT_LOG = "profile_audit.log"

def prompt_record():
    print("=== 系统用户配置录入终端 ===")

    # 1. 使用 input() 采集并校验字段
    username = input("请输入用户名 (仅字母数字): ").strip()
    if not username.isalnum():
        print(f"错误: 用户名 '{username}' 包含非法字符,终止操作。", file=sys.stderr)
        return False

    role_input = input("请分配权限等级 [1:只读, 2:运维, 3:管理员]: ").strip()
    role_map = {"1": "ReadOnly", "2": "Operator", "3": "Admin"}
    if role_input not in role_map:
        print("错误: 无效的角色代码。", file=sys.stderr)
        return False
    role_name = role_map[role_input]

    # 2. 使用 open() 持久化保存(安全追加)
    now_str = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    with open(CONFIG_FILE, mode="a", encoding="utf-8") as f:
        f.write(f"{username}:{role_name}\n")

    with open(AUDIT_LOG, mode="a", encoding="utf-8") as f_audit:
        # 3. 将 print() 定向到审计文件
        print(f"[{now_str}] 成功登记用户 {username},角色等级 {role_name}", file=f_audit)

    # 4. 控制台即时反馈
    print("-" * 32)
    print("登记状态", "已同步磁盘", sep=" -> ")
    print(f"配置已写入: {CONFIG_FILE}")
    return True

if __name__ == "__main__":
    prompt_record()
五、避坑总结清单
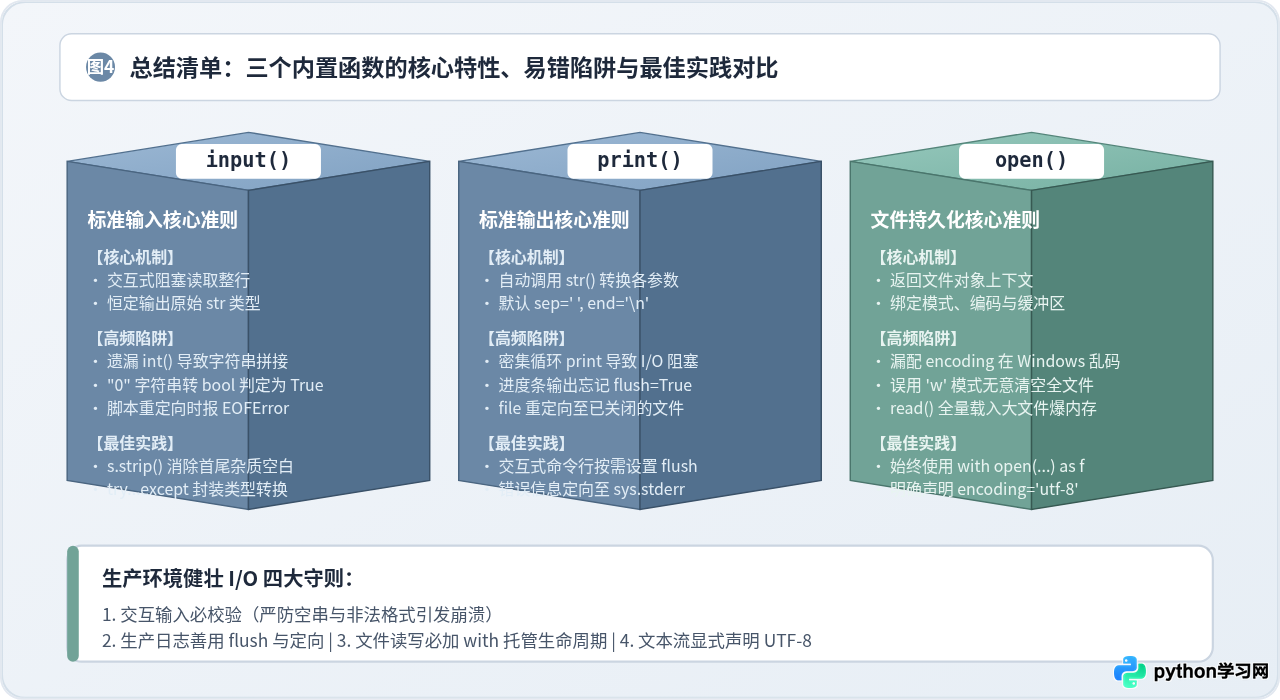
为了在日常开发中编写出健壮、可靠且跨平台的代码,可依据以下检查清单快速审视项目中的 I/O 代码:
- 针对 input():始终铭记其返回类型为
str;接收数值输入时必须包裹try...except ValueError并在前后调用.strip();对于批量脚本处理,注意捕获EOFError。 - 针对 print():明确
sep与end的控制边界;有高频刷新或即时进度需求时,配置flush=True;高并发或海量数据场景避免滥用print(),报错信息定向输出到sys.stderr。 - 针对 open():绝对杜绝脱离
with的裸调模式;文本操作必须显式指定encoding="utf-8";对未知大小的文件遍历坚持使用for line in f:;对已有文件写入时仔细确认'w'、'a'、'x'的选择,严防数据被截断清空。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















